

ArtykułyAkta nr 1950-2026
Historia AI w timelapse
Na przełom czeka się latami. Premiera jest co 25 godzin. 76 lat sztucznej inteligencji na jednej osi, która przyspiesza razem z historią.
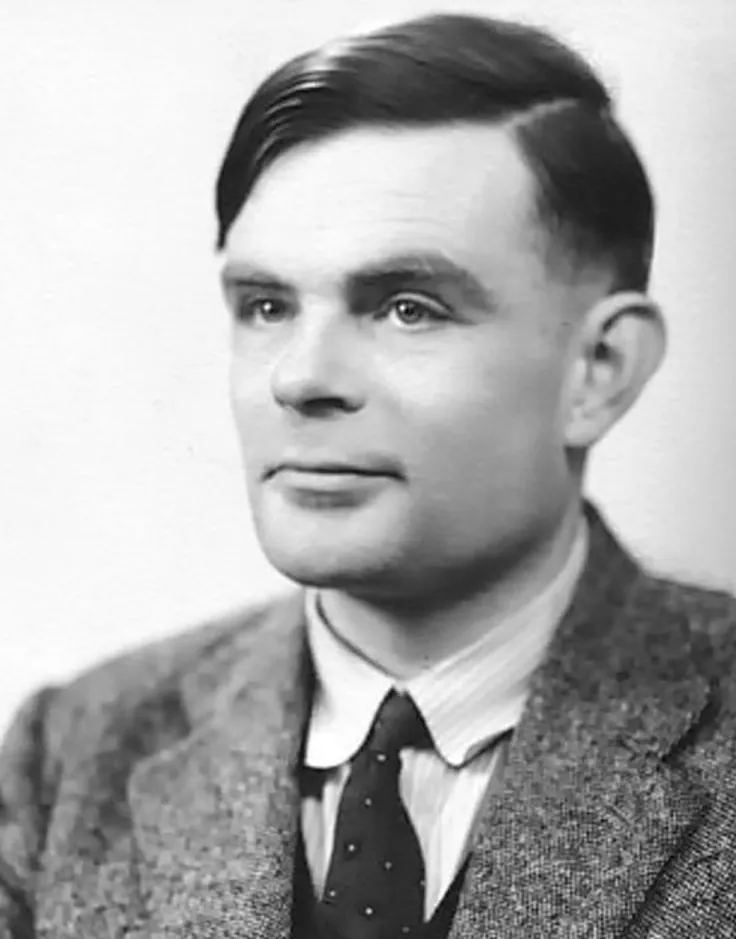
1951
Od 19 czerwca do 14 listopada 2026 opisałem na promptowym 141 premier modeli i funkcji AI. Wychodzi jedna na 25 godzin. Po pytaniu Alana Turinga „czy maszyny mogą myśleć?” na następny krok trzeba było czekać sześć lat. Ułożyłem 76 lat tej historii na jednej osi, od artykułu z 1950 roku po premiery z tego tygodnia, i policzyłem, co naprawdę przyspieszyło.
Oś poniżej przewija się sama po wciśnięciu przycisku: dekady, potem lata, miesiące i tygodnie. Każdy punkt da się kliknąć. Daty i cytaty sprawdziłem w źródłach pierwotnych, a czego nie udało się potwierdzić, wypisuję na końcu. Stan na 14 listopada 2026.
skala osi: tygodnie
214 z 214 punktów
ostatni punkt: Praxis-1
Kliknij punkt na osi albo wciśnij „Odtwórz timelapse”.
Oś ma pięć odcinków o różnej skali: najpierw jedna kreska to dekada, na końcu tydzień. Duże romby to przełomy z mojej listy, małe kwadraty to premiery. Przesuwaj oś palcem, suwakiem albo strzałkami.
nośnik: maszynopis
011950-1956
Pytanie i jedno lato
W październiku 1950 roku brytyjski kwartalnik filozoficzny Mind drukuje tekst matematyka Alana Turinga. Nie ma w nim programu ani maszyny. Jest pytanie.
„Proponuję rozważyć pytanie: czy maszyny mogą myśleć?”
Turing od razu zamienia je na coś, co da się sprawdzić: grę, w której człowiek przez klawiaturę próbuje odróżnić maszynę od drugiego człowieka. A kończy zdaniem, które pasuje do każdego roku z tej historii.
„Widzimy tylko niewielki kawałek drogi przed sobą, ale widzimy na nim mnóstwo rzeczy do zrobienia.”
Na mojej osi po tym punkcie jest pusto przez prawie pięć lat. Następny ma datę 31 sierpnia 1955. Czterech naukowców, John McCarthy z Dartmouth College, Marvin Minsky z Harvardu, Nathaniel Rochester z IBM i Claude Shannon z Bell Telephone Laboratories, pisze prośbę o pieniądze na letnie spotkanie. Dartmouth College podaje dziś, że to w tym dokumencie ukuto nazwę „artificial intelligence”.
Najciekawsze w tej propozycji jest to, ile czasu autorzy dają sobie na robotę.
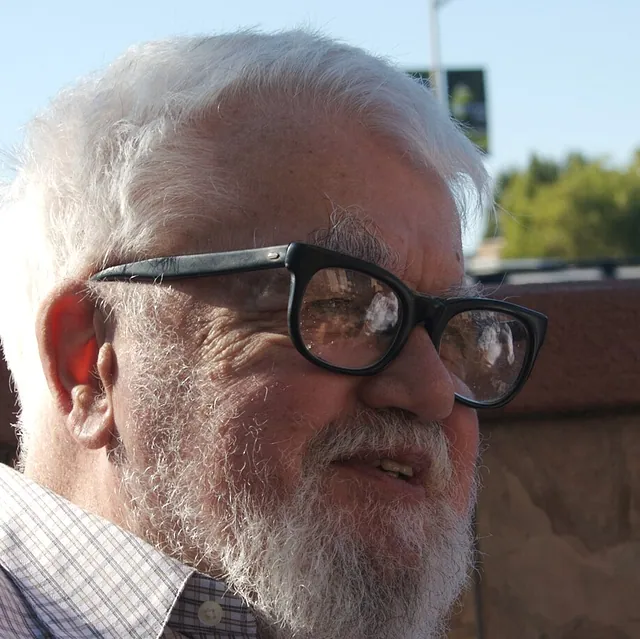
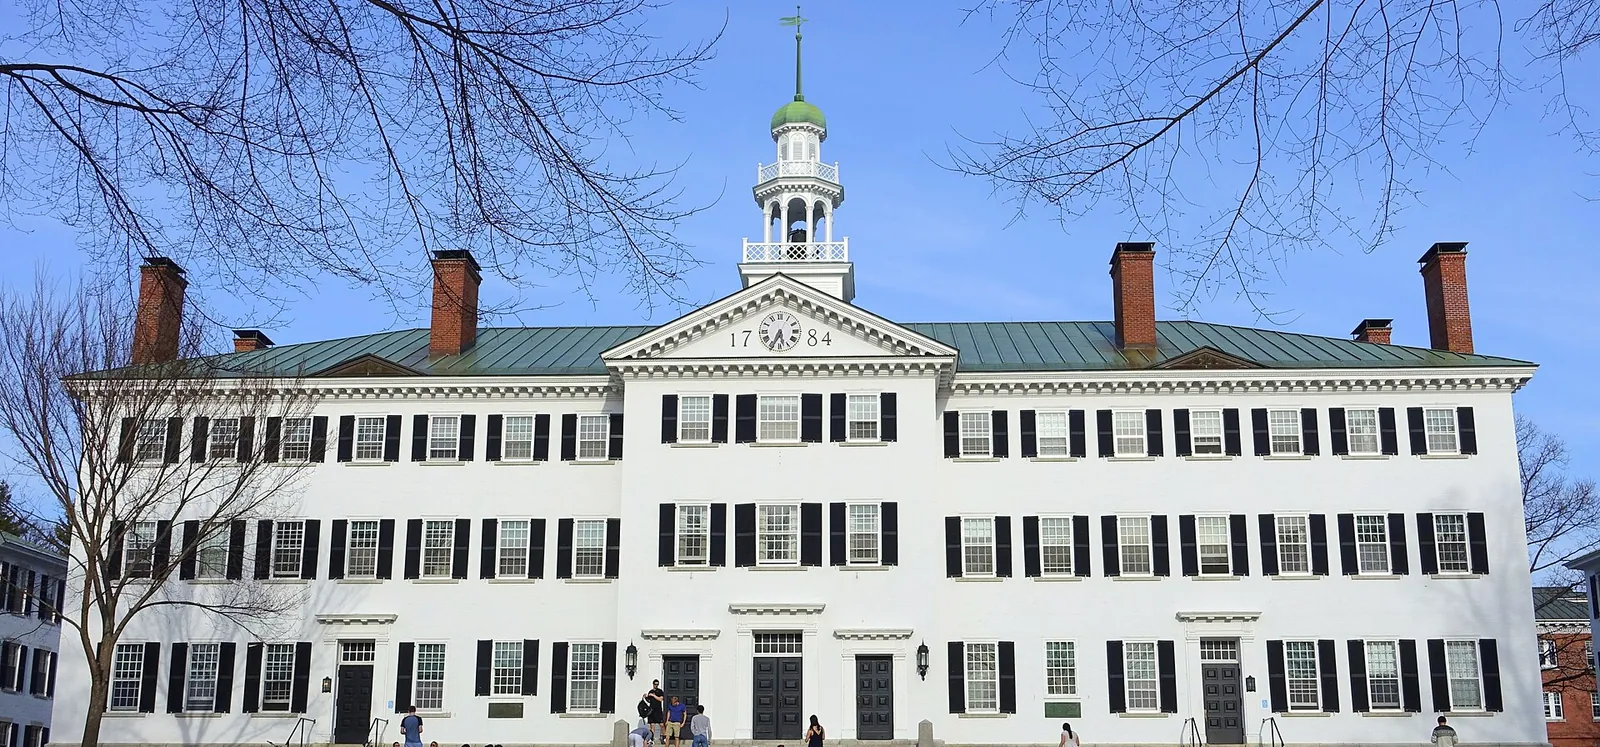
„Proponujemy, aby latem 1956 roku w Dartmouth College w Hanoverze w stanie New Hampshire dziesięć osób przez dwa miesiące prowadziło badania nad sztuczną inteligencją.”
Dwa miesiące, dziesięć osób. Na liście zadań: nauczyć maszyny używać języka, tworzyć pojęcia, rozwiązywać problemy zarezerwowane dla ludzi i poprawiać same siebie. I zdanie, które po 70 latach czyta się z uśmiechem:
„Sądzimy, że w jednym lub kilku z tych problemów można osiągnąć znaczący postęp, jeśli starannie dobrana grupa naukowców popracuje nad nimi razem przez jedno lato.”
Spotkanie odbyło się w 1956 roku. Dartmouth College nazywa je narodzinami dziedziny. Dokładnych dni początku i końca w źródłach uczelni nie znalazłem, więc na osi stoi sam rok.
Zapamiętaj to tempo: od pytania Turinga do pierwszego spotkania ludzi, którzy chcą na nie odpowiedzieć, mija sześć lat. I zapamiętaj optymizm. Wróci jeszcze kilka razy.
021957-1973
Wielkie obietnice
14 listopada 1957 roku, dokładnie 69 lat przed dniem, w którym to piszę, Herbert Simon wygłasza przemówienie na bankiecie Amerykańskiego Towarzystwa Badań Operacyjnych w Pittsburghu. Tekst, podpisany razem z Allenem Newellem, wychodzi drukiem w lutym 1958 w piśmie Operations Research pod tytułem „Heuristic Problem Solving: The Next Advance in Operations Research”. Datę i miejsce potwierdza przypis wydawcy.
W podręcznikach to przemówienie słynie z przepowiedni, że w ciągu dziesięciu lat komputer zostanie szachowym mistrzem świata. Uczciwie: pełnego tekstu nie przeczytałem, bo wydawca trzyma go za płatną bramką, więc dokładnego zdania nie cytuję. Jeśli przepowiednia brzmiała tak, jak się ją powtarza, pomyliła się o trzy dekady. Do Deep Blue jeszcze dojdziemy.
Rok 1958 to perceptron. Psycholog Frank Rosenblatt opisuje w Psychological Review model sieci, która uczy się rozpoznawać wzory, zamiast dostawać gotowe reguły. Marynarka USA pokazuje maszynę zbudowaną według tego pomysłu: Mark I Perceptron, który po treningu rozpoznaje litery alfabetu.
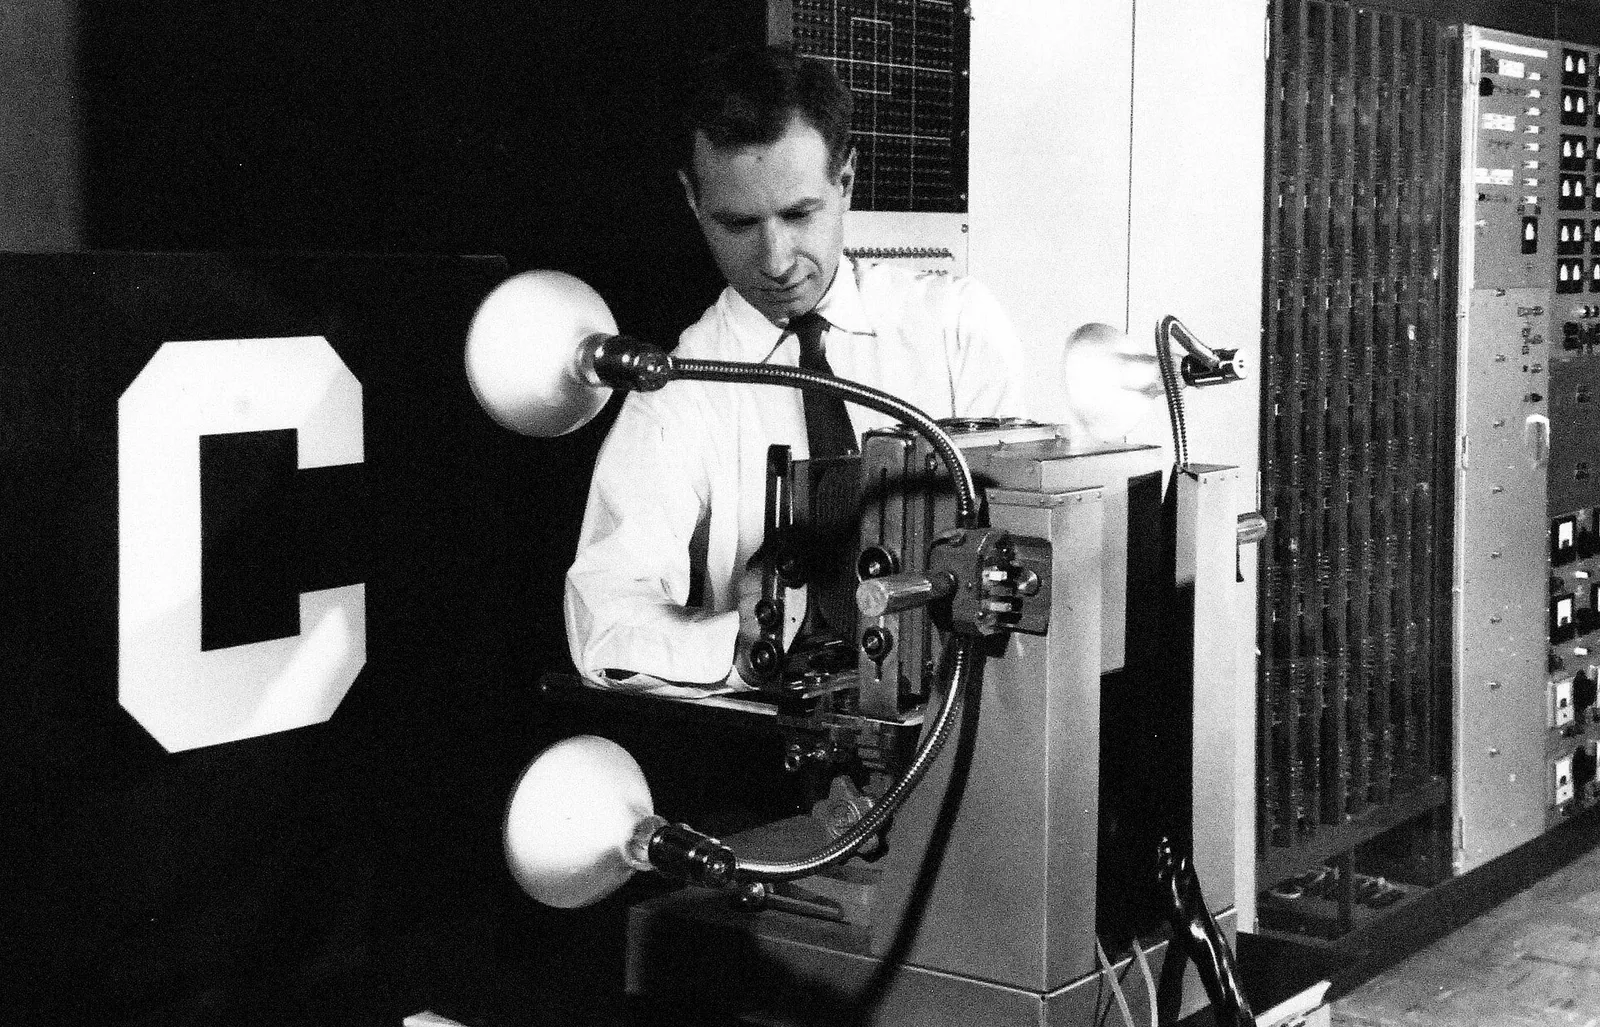
W styczniu 1966 Joseph Weizenbaum publikuje w Communications of the ACM opis programu ELIZA, który prowadzi rozmowę na klawiaturze w języku naturalnym. Jeśli chcesz zobaczyć, co z tego wyrosło, zajrzyj do mojego tekstu o tym, czym jest chatbot.
A potem przychodzi rachunek. Brytyjska Rada Badań Naukowych zamawia u matematyka Jamesa Lighthilla niezależną ocenę całej dziedziny. Raport jest datowany na lipiec 1972, a wychodzi na początku 1973 roku.
„W żadnej części tej dziedziny dotychczasowe odkrycia nie przyniosły tak wielkiego wpływu, jaki wtedy obiecywano.”
Archiwum brytyjskiego ośrodka obliczeniowego w Chilton, które przechowuje raport, opisuje skutek krótko: ogromna utrata zaufania do AI w brytyjskim świecie akademickim, razem z instytucją, która dawała pieniądze. Trwała prawie dekadę. Następną dużą próbę podjęto dopiero po przeglądzie z września 1982.
Policz: od obietnicy „jedno lato” do raportu „nic z tego” minęło 17 lat. Tak wygląda pierwsza lekcja tej historii. Obietnice przychodzą szybciej niż wyniki.
nośnik: terminal
031974-1996
Zimy
Przewiń timelapse na lata 70. i 80. Zobaczysz najdłuższą pustą przestrzeń na całej osi. Między ELIZĄ ze stycznia 1966 a kolejnym przełomem z mojej listy mija ponad 20 lat. Po drodze jest jeden punkt: raport, który mówi, że to nie działa.
O tym okresie mówi się „zimy AI”: lata, w których od dziedziny odpłynęły zaufanie i pieniądze. Piszę o tym ostrożnie, bo poza raportem Lighthilla i opisem z Chilton nie mam do zim źródła pierwotnego. Samo określenie „AI winter” miało paść na konferencji AAAI w 1984 roku, ale archiwum pisma AI Magazine blokuje automatyczne pobieranie i tego nie sprawdziłem. Dlatego zim nie zaznaczam na osi jako punktów. Widać je jako brak punktów.
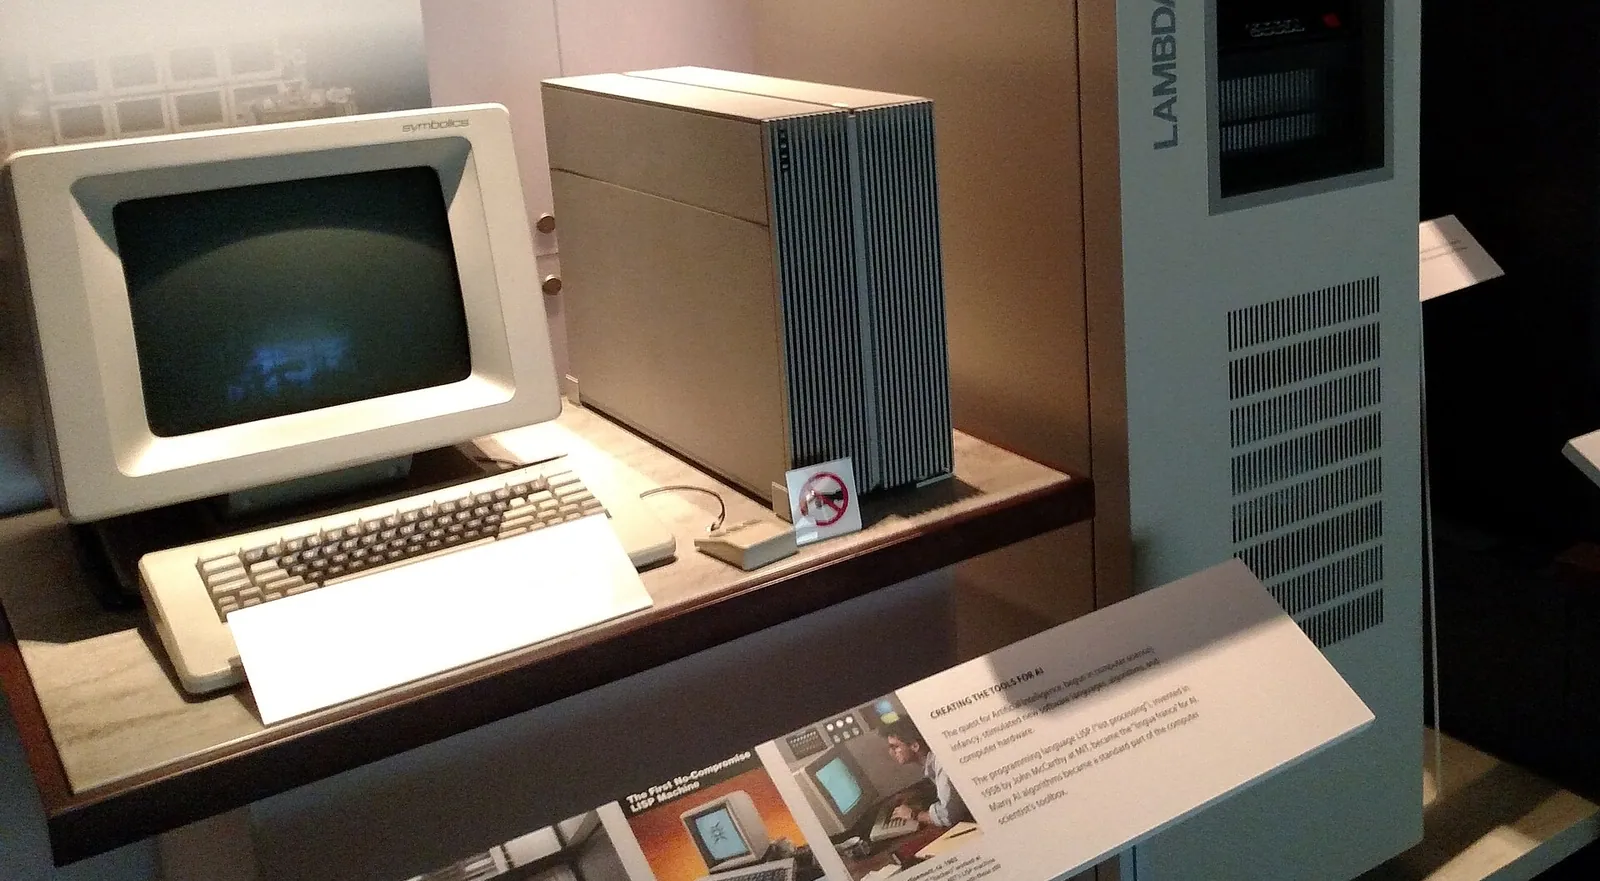
W środku tej ciszy dzieje się rzecz, która okaże się ważniejsza niż wszystkie obietnice lat 50. 9 października 1986 tygodnik Nature drukuje cztery strony pod tytułem „Learning representations by back-propagating errors”. Autorzy: David Rumelhart, Geoffrey Hinton i Ronald Williams. Redakcja dostała tekst 1 maja, przyjęła 31 lipca.
To jest przepis na uczenie sieci, które mają warstwy ukryte między wejściem a wyjściem. Sieć robi błąd, błąd wędruje wstecz przez warstwy i każde połączenie dostaje poprawkę. Perceptron z 1958 roku tego nie umiał. Każdy duży model, o którym piszę na promptowym, uczy się dziś właśnie tak. O jednym z autorów mam osobny tekst: kim jest Geoffrey Hinton.
W 1986 roku nikt nie robi z tego premiery. Nie ma konferencji prasowej, nie ma wersji 2.0 po trzech miesiącach. Jest praca w piśmie naukowym, która poczeka 26 lat, aż komputery i zbiory danych do niej dorosną. To druga lekcja: przełom i premiera to dwie różne rzeczy. Przełom bywa cichy.
041997-2011
Maszyna wygrywa, ale nie tak, jak obiecano
W maju 1997 roku w Equitable Center w Nowym Jorku komputer IBM Deep Blue gra rewanż z mistrzem świata Garrim Kasparowem. Rok wcześniej, w lutym 1996 w Filadelfii, wygrał pierwszą partię, ale cały mecz przegrał 2:4. Teraz Kasparow wygrywa pierwszą partię, Deep Blue drugą, trzy kolejne kończą się remisem. Szóstą wygrywa maszyna. Wynik: 3,5:2,5.
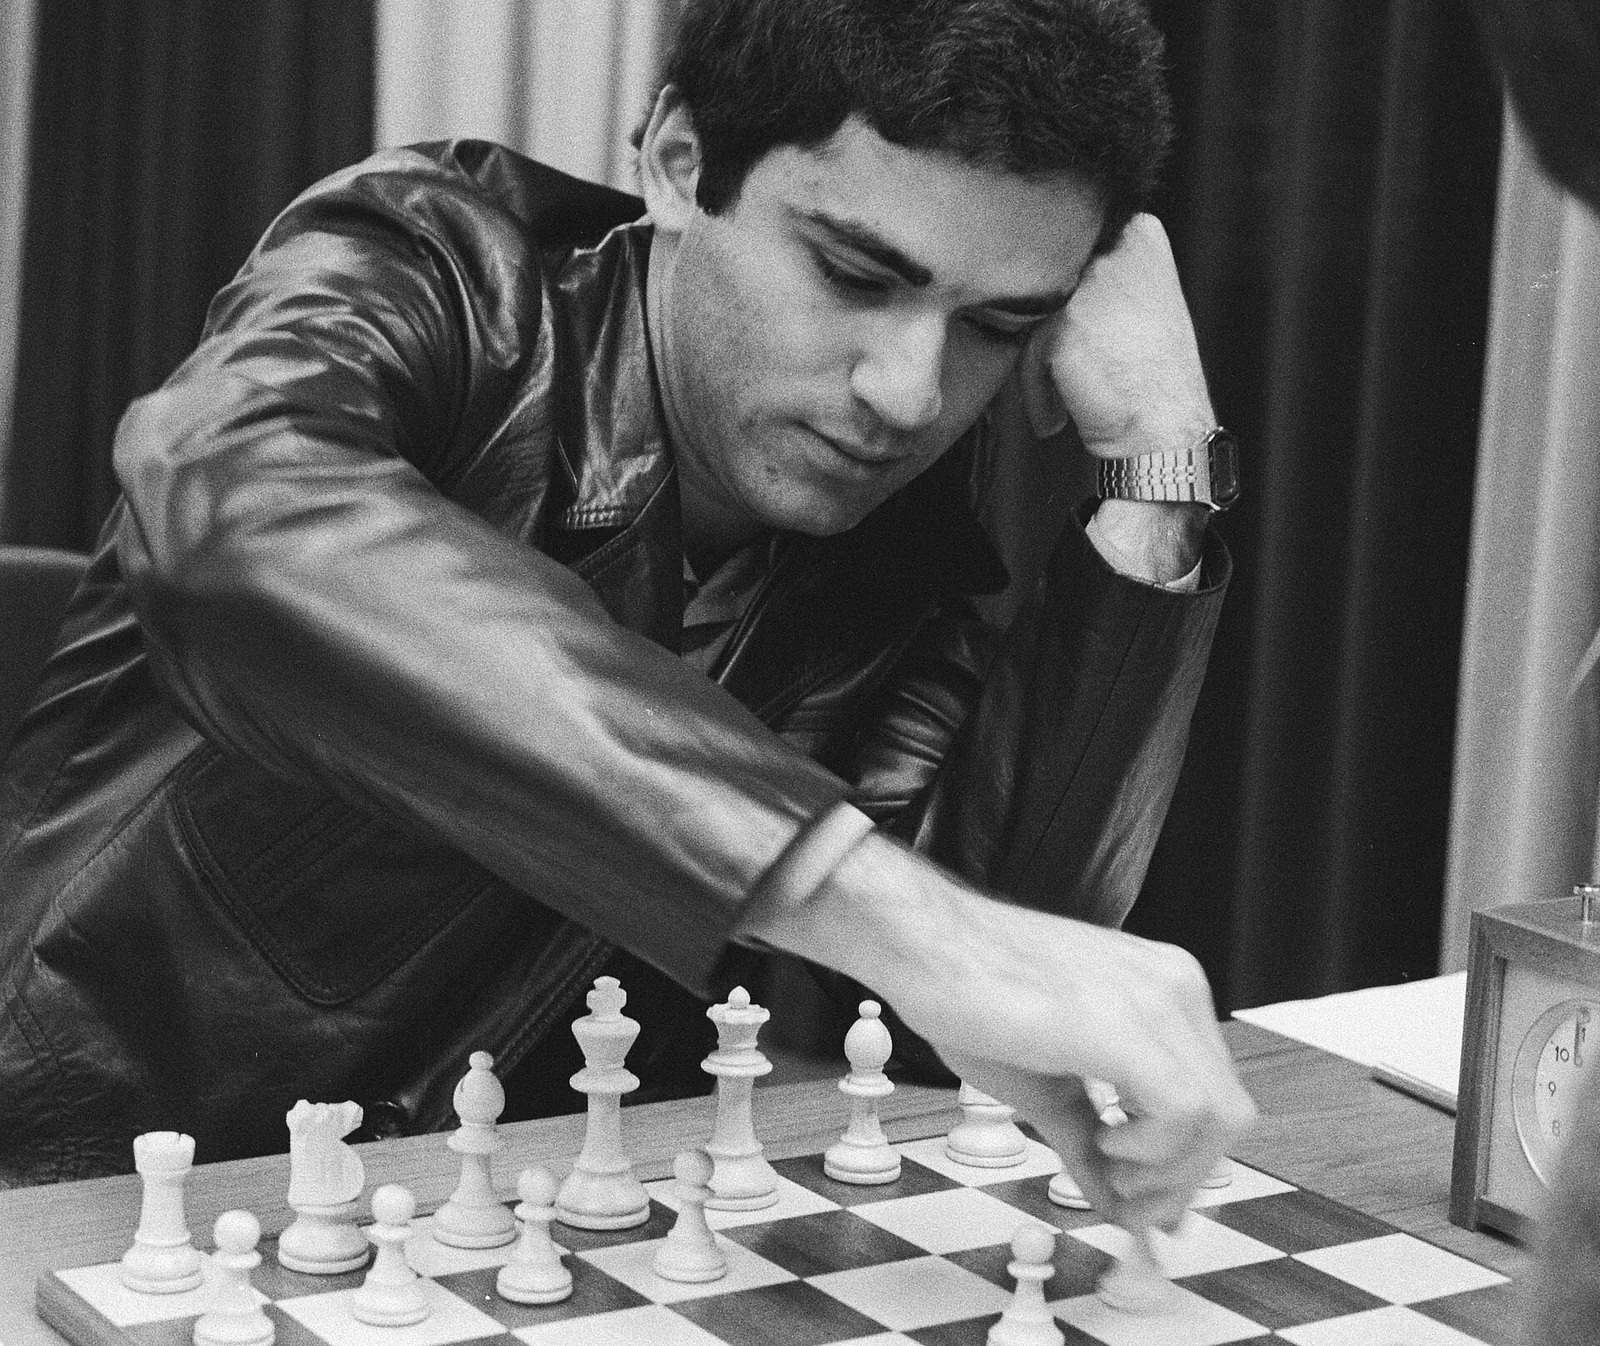
IBM podaje, jak to zrobił: 32 procesory i 200 milionów pozycji szachowych ocenianych w każdej sekundzie. Sam nazywa to siłą obliczeniową „brute force”. Deep Blue nie nauczył się szachów. Policzył je.
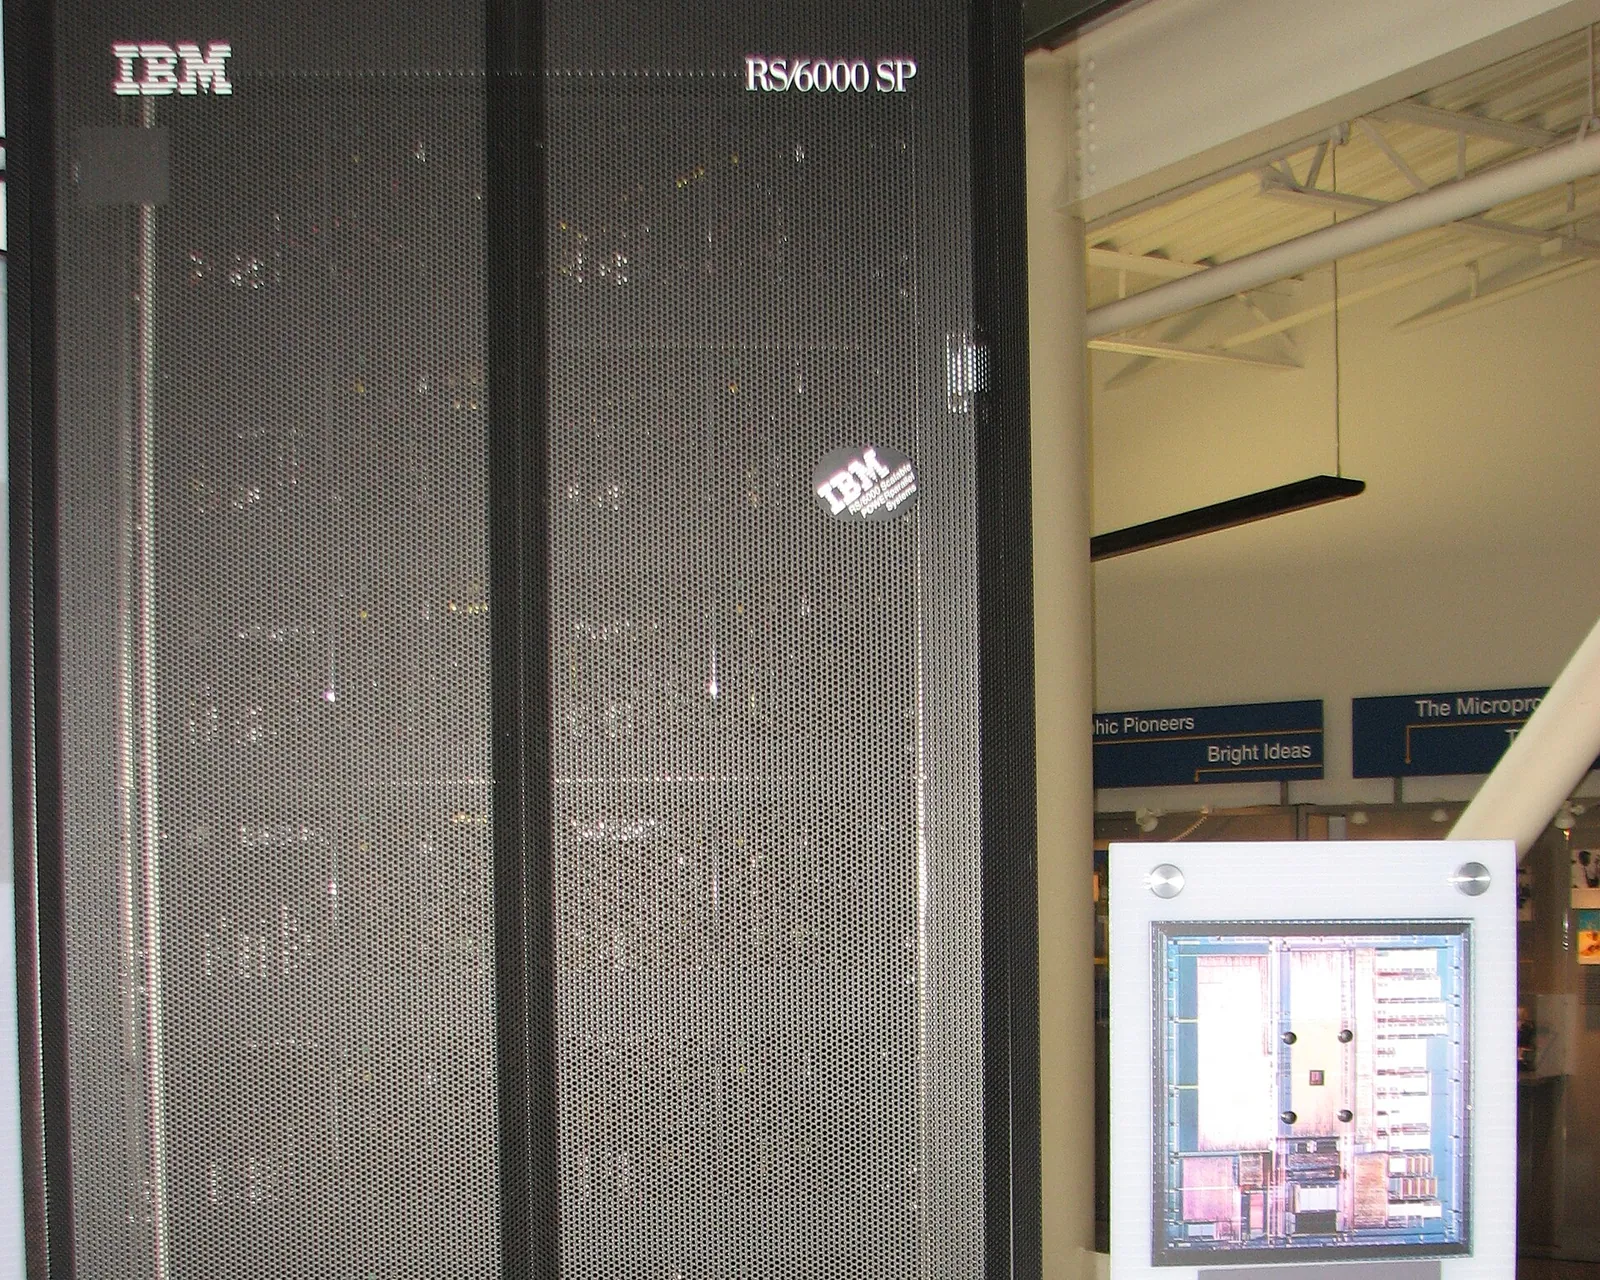
Jeśli przepowiednia z 1957 roku mówiła o dziesięciu latach, to spełniła się po czterdziestu. I spełniła się inaczej, niż marzyli autorzy propozycji z Dartmouth. Oni chcieli maszyn, które tworzą pojęcia i poprawiają same siebie. Dostali kalkulator, który wygrywa w jedną grę.
Prawdziwy ciąg dalszy toczy się obok, bez kamer. W listopadzie 1998 Yann LeCun, Léon Bottou, Yoshua Bengio i Patrick Haffner publikują w Proceedings of the IEEE dużą pracę o sieciach uczonych gradientowo, które czytają odręczne pismo. A w czerwcu 2009 zespół z Princeton pokazuje ImageNet: zbiór, który w chwili publikacji ma 3,2 miliona opisanych zdjęć w 5247 kategoriach. Metoda jest od 1986 roku. Teraz jest też na czym ją ćwiczyć. Brakuje już tylko mocy.
nośnik: edytor kodu
052012-2016
Dwie karty graficzne
Moc przychodzi ze sklepu z częściami do gier. W 2012 roku trzej badacze z Toronto, Alex Krizhevsky, Ilya Sutskever i Geoffrey Hinton, ten sam Hinton z pracy z 1986 roku, zgłaszają sieć neuronową do konkursu rozpoznawania obrazów ImageNet.
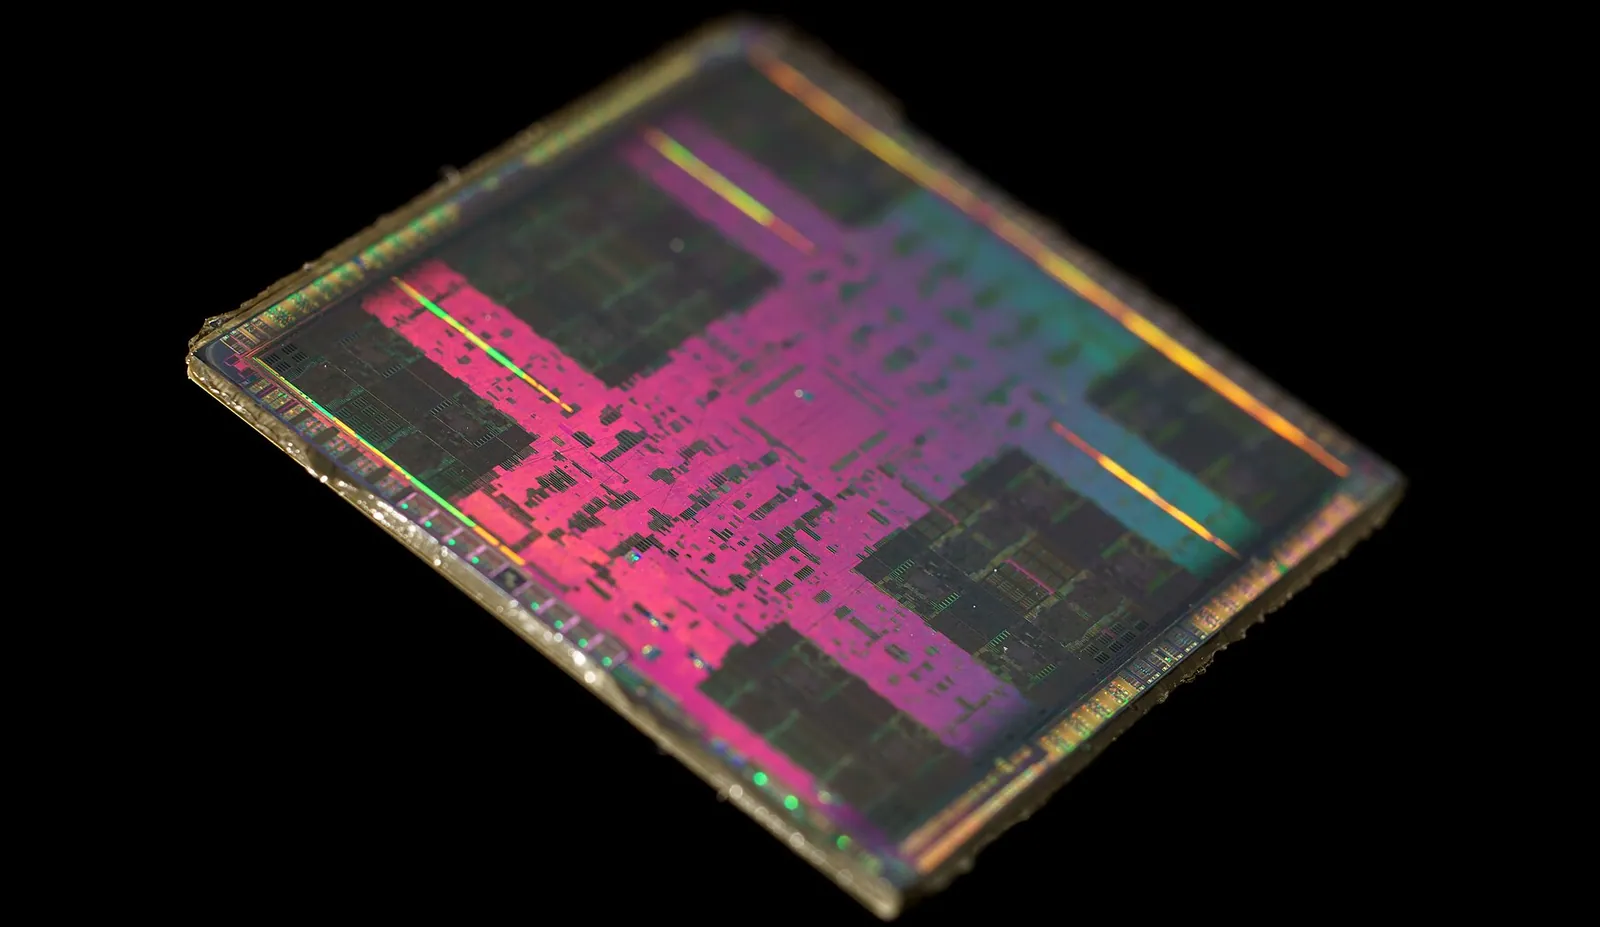
„Zgłosiliśmy też wariant tego modelu do konkursu ILSVRC-2012 i uzyskaliśmy zwycięski błąd top-5 na poziomie 15,3%, wobec 26,2% drugiego najlepszego zgłoszenia.”
Prawie 11 punktów procentowych przewagi nad drugim miejscem. Sieć ma 60 milionów parametrów i 650 tysięcy neuronów. Autorzy piszą wprost, że jej rozmiar ogranicza głównie pamięć kart graficznych i cierpliwość do czekania na wynik. Uczyli ją na 1,2 miliona zdjęć przez pięć do sześciu dni na dwóch kartach GTX 580. Dwie karty dla graczy zamiast superkomputera. O tym, co da się dziś uruchomić na domowym sprzęcie, piszę w przewodniku lokalne AI.
Od Deep Blue do tej sieci mija 15 lat. Od niej do następnego przełomu już tylko cztery. Coś się zmienia.
10 czerwca 2014 Ian Goodfellow z zespołem zgłasza pracę o sieciach GAN: jedna sieć tworzy obrazy, druga ocenia, czy wyglądają na prawdziwe. To początek drogi do dzisiejszych generatorów obrazu. A 27 stycznia 2016 Nature publikuje pracę zespołu DeepMind o programie, który gra w go.
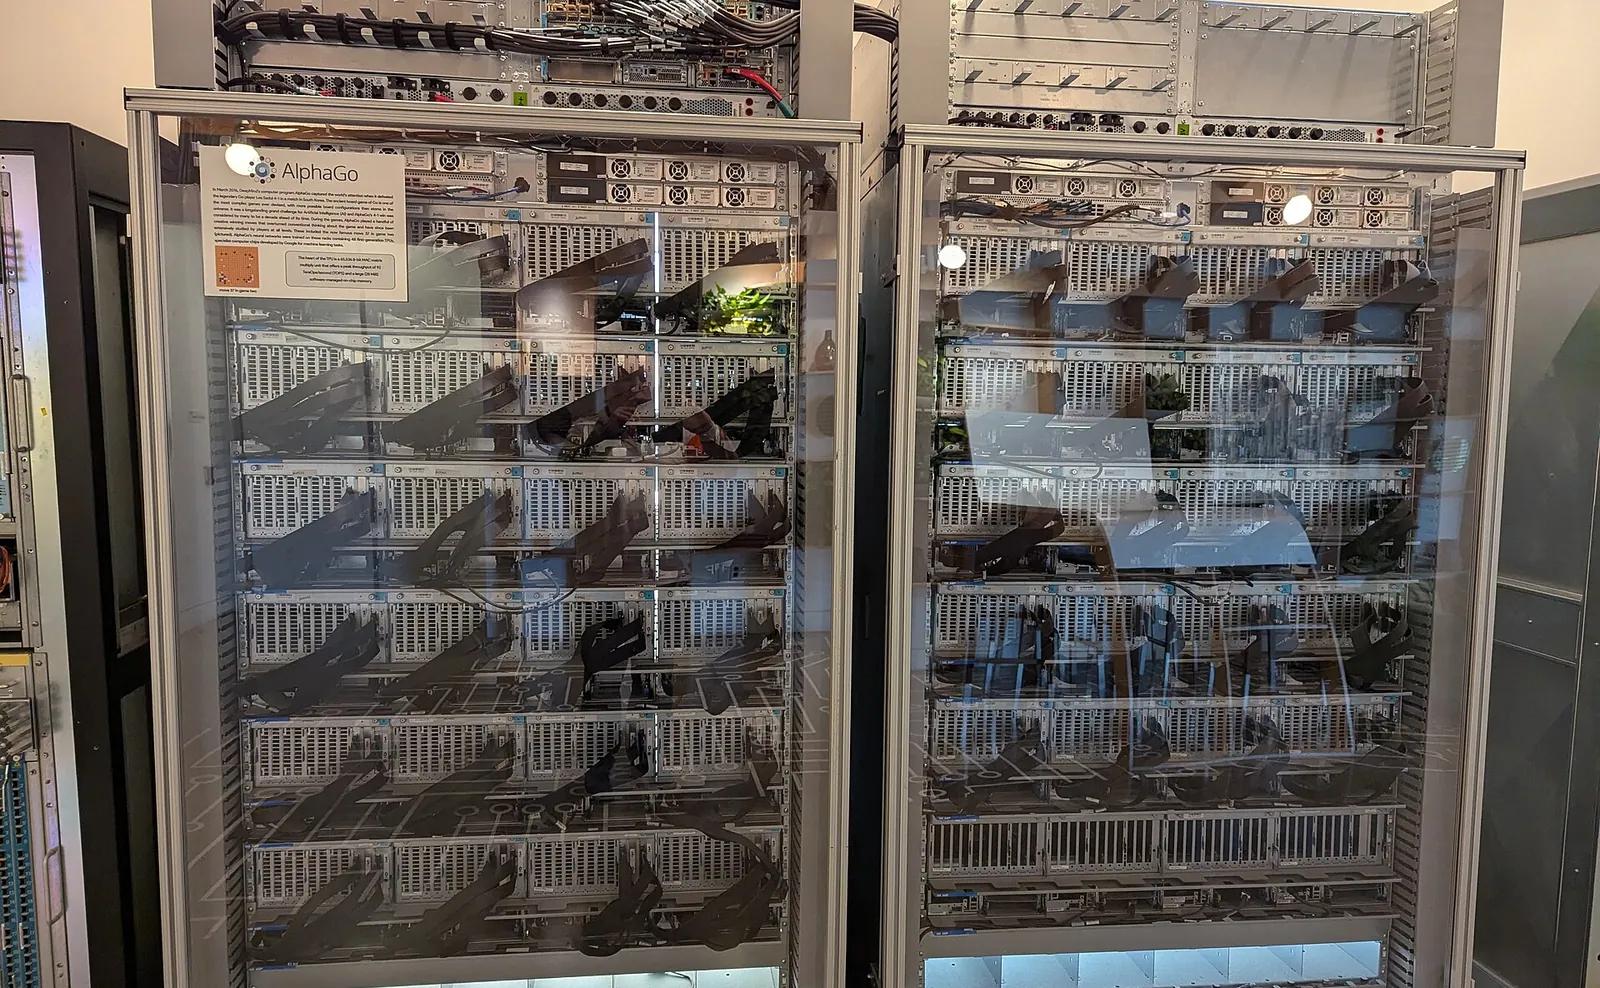
W marcu 2016 w Seulu AlphaGo wygrywa z Lee Sedolem, zdobywcą 18 tytułów mistrza świata, 4:1. DeepMind podaje, że mecz oglądało ponad 200 milionów ludzi i że w drugiej partii program zagrał ruch, który człowiek wybrałby raz na dziesięć tysięcy razy.
„Myślałem, że AlphaGo opiera się na rachunku prawdopodobieństwa i że to tylko maszyna. Ale kiedy zobaczyłem ten ruch, zmieniłem zdanie. AlphaGo z pewnością jest kreatywne.”
To jest różnica wobec 1997 roku. Deep Blue liczył pozycje. AlphaGo nauczył się grać i zagrał ruch, który według DeepMind podważył wieki tradycji tej gry. O szefie zespołu, który to zbudował, przeczytasz w tekście kim jest Demis Hassabis.
062017-2022
Jedna praca i pięć lat rozpędu
12 czerwca 2017 roku na serwerze arXiv pojawia się praca ośmiorga autorów pod tytułem, który brzmi jak żart: „Attention Is All You Need”, czyli „wystarczy uwaga”.
„Proponujemy nową, prostą architekturę sieci, Transformer, opartą wyłącznie na mechanizmach uwagi, całkowicie bez rekurencji i splotów.”
Litera T w nazwach GPT i ChatGPT to właśnie ten Transformer. Na tej architekturze działają dziś duże modele językowe. Jak to działa w środku, tłumaczę w tekście co to jest LLM. Tu ważne jest co innego: zobacz, co dzieje się z osią czasu po tym punkcie.
11 czerwca 2018: OpenAI pokazuje pierwszy model GPT. 11 października 2018: zespół Google zgłasza BERT. 14 lutego 2019: GPT-2, którego pełnej wersji OpenAI na początku nie wydaje z obawy przed nadużyciami. 28 maja 2020: GPT-3 ze 175 miliardami parametrów, a dwa tygodnie później API, przez które każdy programista może go użyć. 30 listopada 2020: DeepMind ogłasza, że AlphaFold rozwiązał problem zwijania białek, otwarty od 50 lat. 5 stycznia 2021: DALL·E rysuje obrazy z opisu. 29 czerwca 2021: GitHub Copilot dopisuje kod.
Przez 67 lat, od Turinga do Transformera, mam na osi 15 punktów. Przez następne pięć i pół roku: 11. Dlatego oś w timelapse ma zmienną skalę. Gdyby dekada zajmowała wszędzie tyle samo miejsca, punkty z ostatnich lat zlałyby się w jedną plamę.
Rok 2022 jest już gęsty. 6 kwietnia DALL·E 2. 22 sierpnia Stability AI wydaje publicznie Stable Diffusion, generator obrazu, któremu wystarcza 6,9 GB pamięci karty graficznej. 21 września OpenAI udostępnia Whispera, który zamienia mowę na tekst. I wreszcie 30 listopada.
„Wytrenowaliśmy model o nazwie ChatGPT, który prowadzi interakcję w formie rozmowy.”
Jedno suche zdanie i dopisek, że w czasie podglądu badawczego korzystanie jest darmowe. Technicznie to nie był największy skok w tej historii. OpenAI pisze w tym samym komunikacie, że ChatGPT to dostrojony model z serii GPT-3.5. Zmieniło się opakowanie: okno rozmowy, które każdy umie obsłużyć. Od tego dnia AI przestaje być tematem dla badaczy i staje się produktem. A produkty mają premiery.
nośnik: okno czatu
072023-2025
Miesiące
14 marca 2023, 104 dni po ChatGPT, OpenAI wydaje GPT-4. Tego samego dnia Anthropic przedstawia Claude’a. Dwie duże premiery jednego dnia: w całej wcześniejszej historii na mojej osi nie zdarzyło się to ani razu. Od teraz będzie się zdarzać regularnie.
Reszta 2023 roku: 18 lipca Meta wydaje Llamę 2 z otwartymi wagami, 20 września OpenAI zapowiada DALL·E 3, 6 grudnia Google przedstawia Gemini. Rok 2024 dokłada nowe rodzaje. 15 lutego Sora, czyli wideo do minuty z opisu. 4 marca Claude 3. 21 marca Suno v3 i piosenki. 13 maja GPT-4o, jeden model do tekstu, obrazu i głosu. 12 września o1, model, który przed odpowiedzią dłużej „myśli”. 22 października Anthropic daje Claude’owi myszkę i klawiaturę: funkcja nazywa się computer use i od niej zaczyna się u mnie pasek „agent”.
W październiku 2024 historia zatacza koło. Nagrodę Nobla z fizyki dostają John Hopfield i Geoffrey Hinton.
„za fundamentalne odkrycia i wynalazki, które umożliwiają uczenie maszynowe z użyciem sztucznych sieci neuronowych”
Dzień później Nobel z chemii: połowa dla Davida Bakera za komputerowe projektowanie białek, połowa dla Demisa Hassabisa i Johna Jumpera z Google DeepMind za przewidywanie ich struktury. Czyli za AlphaFolda z 2020 roku. Zwróć uwagę na daty. Komitet noblowski nagradza w 2024 roku badania nad sieciami neuronowymi prowadzone od lat 80. i system z 2020. Przełomy dojrzewają latami, nawet gdy premiery lecą co tydzień.
Rok 2025 to już rytm, który znasz. 20 stycznia DeepSeek-R1 z Chin, z otwartymi wagami. 23 stycznia Operator, agent OpenAI klikający w przeglądarce. 24 lutego Claude 3.7 Sonnet i Claude Code. 25 marca dwie premiery jednego dnia: obrazy w GPT-4o i Gemini 2.5. 20 maja Veo 3, wideo z dźwiękiem. 22 maja Claude 4. 7 sierpnia GPT-5. 26 sierpnia model obrazu Google znany jako nano-banana. 29 września Claude Sonnet 4.5, 30 września Sora 2. 18 listopada Gemini 3, 24 listopada Claude Opus 4.5, 11 grudnia GPT-5.2.
To są lata, w których promptowy zaczyna te premiery opisywać na bieżąco. Punkty na osi prowadzą do tekstów z tamtych dni: o GPT-5, o Claude 4, o GPT-5.2.
Mam jeden sposób, żeby to tempo zmierzyć bez sporu o to, co jest ważne. Biorę tylko pełne generacje, czyli zmianę pierwszej cyfry w nazwie, i liczę dni między komunikatami producentów.
Ile dni dzieli pełne generacje modeli
OpenAI potrzebowało 877 dni, żeby przejść od GPT-4 do GPT-5, i 392, żeby dojść do GPT-6. Anthropic: 444 i 383. Google: 371, 342 i 316. Trzy firmy, ten sam kierunek i podobny wynik: pełna generacja wychodzi dziś mniej więcej raz na rok, odrobinę szybciej niż poprzednia. Rok, nie tydzień. Zapamiętaj tę liczbę, bo za chwilę zderzę ją z kalendarzem.
082026
Tygodnie
Pierwsze półrocze 2026 odtwarzam z komunikatów firm. 5 lutego: Claude Opus 4.6 i GPT-5.3-Codex tego samego dnia. 17 lutego Claude Sonnet 4.6, 19 lutego Gemini 3.1 Pro, 26 lutego Nano Banana 2. 5 marca GPT-5.4. 2 kwietnia Gemma 4. 14 kwietnia Midjourney V8.1, 16 kwietnia Claude Opus 4.7, 21 kwietnia ChatGPT Images 2.0, 23 kwietnia GPT-5.5, 24 kwietnia podgląd DeepSeek-V4. Pięć premier w jedenaście dni.
I jedna rzecz, która w tej historii jest nowa. 26 kwietnia 2026 OpenAI wyłącza produkt Sora. Od pierwszej zapowiedzi minęło 801 dni. Wcześniej punkty na osi tylko przybywały. Teraz zaczynają też znikać.
19 maja Google otwiera serię Gemini 3.5 i pokazuje Gemini Omni. 28 maja Claude Opus 4.8. 9 czerwca Claude Fable 5 i Mythos 5, do których Anthropic po trzech dniach zawiesza dostęp i przywraca go 1 lipca.
Od 19 czerwca nie muszę już niczego odtwarzać, bo mam własny pomiar. Kalendarz premier AI na promptowym układa się sam z moich tekstów: automat czyta każdy nowy wpis, sprawdza, czy opisuje premierę modelu albo dużej funkcji, i wpuszcza ją na listę tylko wtedy, gdy tekst ma link do oficjalnej strony producenta. Stan na 14 listopada 2026: 141 premier w 149 dni.
141 premier w 149 dni. Jedna kratka to jeden dzień
05 i więcej premier
Dotknij dnia, żeby zobaczyć, co wtedy wyszło. Najgęstszy dzień: 29 września, 9 premier.
Kilka liczb z tej siatki. Dni z co najmniej jedną premierą: 72. Dni bez żadnej: 77. Z 140 odstępów między kolejnymi premierami 108 to zero dni albo jeden dzień. Najgęstszy dzień to 29 września: 9 premier, z czego 7 od jednej firmy, OpenAI. Najdłuższa cisza trwała 7 dni, od 16 września do 22 września. Tydzień bez premiery to w 2026 roku rekord spokoju.
Co wychodzi? Tekst, czyli modele językowe: 50. Agenci: 22. Wideo: 18. Obraz: 12. Dźwięk: 9. Reszta, 30 pozycji, to modele pogody, robotyki, szeregów czasowych i funkcje, których nie da się wcisnąć w pięć szuflad. Najwięcej premier ma Google: 38. Na drugim miejscu jest OpenAI: 16.
Dwa zastrzeżenia, żebyś nie wziął tych liczb za więcej, niż są. Po pierwsze, to jest miara tego, co opisałem, a nie wszystkiego, co wyszło na świecie. Automat przejrzał 1 801 wpisów, znalazł w nich 220 tekstów o premierach i 76 odrzucił, bo nie miały linku do oficjalnego źródła. Prawdziwa liczba premier jest wyższa. Po drugie, data w kalendarzu to dzień mojego tekstu, zwykle ten sam albo następny po ogłoszeniu.
09Wniosek
Przyspieszyły premiery, nie przełomy
Zostawiłem na koniec wykres, dla którego powstał ten tekst. Na jednej osi są trzy rzeczy, które zwykle wrzuca się do jednego worka z napisem „AI przyspiesza”.
Odstęp od poprzedniego: przełomy, generacje, premiery
przełomy z mojej listypełne generacje GPT, Claude i Geminipremiery w moim kalendarzu, średnia miesiąca
Najedź albo dotknij punktu, żeby zobaczyć, co dzieli jaki odstęp.
Przełomy. Wybrałem ich 11: Turing, Dartmouth, perceptron, ELIZA, wsteczna propagacja, Deep Blue, sieć z ImageNet 2012, AlphaGo, Transformer, GPT-3 i ChatGPT. To moja lista i możesz się z nią kłócić. Odstępy między nimi w latach: 6; 2; 8; 21; 11; 15; 4; 1,2; 3 i 2,5. Mediana to 4,7 roku. Cztery ostatnie odstępy mają średnio 2,6 roku. Czyli tak, po 2012 roku przełomy przychodzą szybciej niż w czasach zim. Ale wciąż liczy się je w latach.
I teraz najważniejsze. Od ChatGPT minęło 1 445 dni, czyli prawie cztery lata. Na mojej liście nie ma po nim dwunastego przełomu. Kandydaci są: modele rozumujące z 2024 roku, agenci, wideo z dźwiękiem. Każdy z nich to jednak rozwinięcie Transformera z 2017 i okna czatu z 2022, a nie nowy pomysł tej rangi. Jeśli mam rację, obecna przerwa jest już dłuższa niż każdy z czterech poprzednich odstępów.
Generacje. Pełna zmiana numeru u trzech największych firm: 316 do 392 dni w ostatniej rundzie. Mniej więcej rok. Skraca się, ale o tygodnie, nie o rzędy wielkości.
Premiery. Jedna na 25 godzin w moim kalendarzu. To jest ta linia, która spadła na samo dno wykresu.
Między górną a dolną linią są trzy rzędy wielkości. I to jest moja teza: historia AI przyspieszyła głównie na dole. Dramatycznie skrócił się czas między produktami: wersjami, wariantami, trybami, podglądami i udostępnieniami tego samego modelu w kolejnym miejscu. Czas między pomysłami, które zmieniają wszystko, skrócił się z dekad do kilku lat i tam na razie stoi.
Autorzy propozycji z Dartmouth pomylili się, bo wzięli pytanie za harmonogram. Dziś łatwo o błąd odwrotny: wziąć harmonogram premier za postęp. Kiedy w jeden dzień wychodzi dziewięć rzeczy, a w najspokojniejszym tygodniu półrocza nie wychodzi nic, to nie znaczy, że nauka ruszyła i stanęła. To znaczy, że działy produktowe mają swoje kalendarze.
Co z tego dla Ciebie? Trzy praktyczne rzeczy, których sam się trzymam.
- Nie musisz gonić każdej premiery. Przy tempie jednej na dobę i tak nie zdążysz. Większość pozycji z kalendarza to nowa wersja czegoś, co już masz. Sprawdzaj te, które dotyczą narzędzia, którego używasz co tydzień.
- Pełna generacja wychodzi raz w roku. Jeśli coś dziś nie działa w Twoim zadaniu, sensowny horyzont na „spróbuję jeszcze raz” to kilka miesięcy, nie kilka dni.
- Przełomu nie poznasz po premierze. Współautor pracy z 1986 roku dostał Nobla w 2024. Transformer w dniu publikacji był jedną z wielu prac o tłumaczeniu maszynowym. Rzeczy naprawdę ważne długo wyglądają niepozornie.
Turing skończył swój tekst zdaniem o krótkim kawałku drogi, na którym widać mnóstwo do zrobienia. Po 76 latach to dalej najlepszy opis sytuacji. Zmieniło się tylko to, że dziś ten kawałek drogi ma swój kalendarz. Prowadzę go tutaj: Kalendarz premier AI. A jeśli wolisz wiedzieć, co ma dopiero wyjść, zajrzyj do Kalendarza AI.
Jak liczyłem
Oś ma 214 punktów. 73 z lat 1950-2026 (do 9 czerwca) wybrałem ręcznie i każdy sprawdziłem w źródle pierwotnym: w publikacji naukowej, w metadanych wydawcy albo w komunikacie firmy na jej własnej stronie. 141 kolejnych, od 19 czerwca do 14 listopada 2026, pochodzi z Kalendarza premier AI promptowego.
- Gdy źródło podaje tylko rok albo miesiąc, na osi stoi środek tego okresu, a w opisie punktu sam rok albo miesiąc. Dotyczy to między innymi Dartmouth (1956), perceptronu (1958), Deep Blue (maj 1997), sieci z 2012 roku i AlphaGo (marzec 2016).
- Odstępy między przełomami liczę z tych dat, więc przy starszych punktach mają dokładność do kilku miesięcy. Przy odstępach rzędu lat to nie zmienia obrazu.
- Lista przełomów i lista premier sprzed czerwca 2026 to mój wybór, a nie spis kompletny. Dlatego nie porównuję liczby punktów z lat 2023-2025 z liczbą z kalendarza. Porównuję odstępy między pełnymi generacjami, bo te da się policzyć bez wybierania.
- Cytaty tłumaczyłem sam. Pod każdym jest brzmienie oryginału.
Czego nie potwierdziłem: dokładnego zdania z przemówienia Simona z 1957 roku (tekst za płatną bramką), dni spotkania w Dartmouth, dnia meczu Deep Blue i dni meczu AlphaGo (IBM i DeepMind podają miesiąc), daty ogłoszenia wyników konkursu ImageNet 2012, pochodzenia określenia „zima AI” oraz daty otwartej bety Midjourney z 2022 roku, której przez to nie ma na osi.
Cała oś w jednej liście: 214 punktów
Pogrubiona kreska z lewej oznacza przełom z mojej listy. Nazwy prowadzą do tekstów na promptowym, „źródło” do publikacji albo komunikatu producenta.
- Turing pyta, czy maszyny mogą myśleć źródłoinne
- Propozycja z Dartmouth źródłoinne
- Lato w Dartmouth źródłoinne
- Bankiet w Pittsburghu źródłoinne
- Perceptron Rosenblatta źródłoobraz
- ELIZA źródłotekst
- Raport Lighthilla źródłoinne
- Wsteczna propagacja błędu źródłoinne
- Deep Blue wygrywa z Kasparowem źródłoinne
- LeNet czyta cyfry źródłoobraz
- ImageNet źródłoobraz
- AlexNet źródłoobraz
- Sieci GAN źródłoobraz
- AlphaGo wygrywa z Lee Sedolem źródłoinne
- Transformer źródłotekst
- GPT-1 źródłotekst
- BERT źródłotekst
- GPT-2 źródłotekst
- GPT-3 źródłotekst
- AlphaFold 2 źródłoinne
- DALL·E źródłoobraz
- GitHub Copilot źródłotekst
- DALL·E 2 źródłoobraz
- Stable Diffusion źródłoobraz
- Whisper źródłodźwięk
- ChatGPT źródłotekst
- Claude źródłotekst
- GPT-4 źródłotekst
- Llama 2 źródłotekst
- DALL·E 3 źródłoobraz
- Gemini 1.0 źródłotekst
- Sora (zapowiedź) źródłowideo
- Claude 3 źródłotekst
- Suno v3 źródłodźwięk
- GPT-4o źródłotekst
- Claude 3.5 Sonnet źródłotekst
- o1-preview źródłotekst
- Nobel z fizyki za sieci neuronowe źródłoinne
- Nobel z chemii za białka źródłoinne
- Computer use źródłoagent
- Sora dla użytkowników źródłowideo
- Gemini 2.0 źródłotekst
- Veo 2 źródłowideo
- DeepSeek-R1 źródłotekst
- Operator źródłoagent
- Claude 3.7 Sonnet i Claude Code źródłoagent
- Gemini 2.5 źródłotekst
- Obrazy w GPT-4o źródłoobraz
- Veo 3 źródłowideo
- Claude 4 źródłotekst
- GPT-5 źródłotekst
- Gemini 2.5 Flash Image źródłoobraz
- Claude Sonnet 4.5 źródłotekst
- Sora 2 źródłowideo
- Gemini 3 źródłotekst
- Claude Opus 4.5 źródłotekst
- GPT-5.2 źródłotekst
- Claude Opus 4.6 źródłotekst
- GPT-5.3-Codex źródłoagent
- Claude Sonnet 4.6 źródłotekst
- Gemini 3.1 Pro źródłotekst
- Nano Banana 2 źródłoobraz
- GPT-5.4 źródłotekst
- Gemma 4 źródłotekst
- Midjourney V8.1 źródłoobraz
- Claude Opus 4.7 źródłotekst
- ChatGPT Images 2.0 źródłoobraz
- GPT-5.5 źródłotekst
- DeepSeek-V4 (podgląd) źródłotekst
- Koniec Sory źródłowideo
- Gemini 3.5 Flash i Gemini Omni źródłotekst
- Claude Opus 4.8 źródłotekst
- Claude Fable 5 i Mythos 5 źródłotekst
- GLM-5.2 - Zhipu AItekst
- Daybreak - OpenAIinne
- CUGA Apps - IBMagent
- Gemini 3.5 Flash (computer use) - Googleagent
- GPT-5.6 (wersja zapoznawcza) - OpenAItekst
- Google Finance - Googletekst
- Midjourney 8.2 (podgląd) - Midjourneyobraz
- VibeThinker-3B - Sinatekst
- Gemini (spersonalizowane generowanie obrazów) - Googleobraz
- Kernels - Hugging Faceinne
- Nemotron V3 Data Atlas - Nvidiainne
- Muse Spark 1.1 (API) - Metatekst
- Siri AI - Appleagent
- Google Vids (cyfrowe awatary) - Googlewideo
- Kimi K3 - Moonshot AItekst
- Claude Opus 5 - Anthropictekst
- Cosmos 3 Edge - Nvidiainne
- Gemini 3.6 Flash - Googletekst
- Meta AI (dostęp do kalendarza i codzienne briefingi) - Metaagent
- Gemini 3.5 Flash Cyber - Googletekst
- LFM2.5-Encoders - Liquid AItekst
- OlmoEarth Platform - Allen Institute for AIinne
- Lyria 3.5 - Googledźwięk
- Gemini Robotics ER 2 - Googleinne
- FLUX 3 (ograniczony dostęp) - Black Forest Labswideo
- LFM2.5-2.6B - Liquid AItekst
- WeatherNext 2 - Googleinne
- Cloudflare OS - Cloudflareagent
- GPT-5.6 Luna - OpenAItekst
- Kitesurf (beta) - Cloudflareagent
- Google Ads i Google Analytics AI - Googleagent
- Magpie TTS - Nvidiadźwięk
- OlmoEarth - Allen AIobraz
- SL2T - Googlewideo
- Gemini 3.7 Flash - Googletekst
- Grok 4.6 - xAItekst
- Google Search (funkcje edukacyjne) - Googletekst
- LFM2.5 (Q4_0) - Liquid AItekst
- Origin - Cursorinne
- Agent OS - Binanceagent
- LFM2.5-DSpark - Liquid AItekst
- SIMA 2 - Googleagent
- Ox Alpha - Nieznanatekst
- Granite 4.2 - IBMtekst
- Granite Speech 5.0 Turbo CTC - IBMdźwięk
- Gemini 3.5 Transcribe - Googledźwięk
- Gemini (agentowe rozumienie wideo) - Googlewideo
- Google Pics - Googleobraz
- Atlas - World Labswideo
- Fairwind - Googleagent
- Gemini 3.8 Flash - Googletekst
- TSFM (Early Access) - IBMinne
- NeoMME - Hcompanyinne
- WeatherNext 3 - Googleinne
- GPT-6 Astra - OpenAItekst
- AlphaGenome Atlas - Googleinne
- Multiverse Computing 8B - Multiverse Computingtekst
- Granite Time Series PatchTST-FM-r2 - IBMinne
- NVIDIA Synthetic Video Detector - Nvidiawideo
- S1 - Skild AIinne
- Portable Computer (Windows) - Perplexityagent
- Gemini 3.8 Live - Googledźwięk
- Claude Opus 5.5 / GPT-6 (Sol, Luna) - Anthropictekst
- Gemini 3.8 TTS - Googledźwięk
- Gemini 3.8 Live with Live Avatar - Googlewideo
- LFM2.5-VL-DSpark - Liquid AIobraz
- Gemini na Androidzie - Googleagent
- Holo4 - H Companyagent
- Agents API (computer use) - OpenAIagent
- ChatGPT Space - OpenAIinne
- Claude Sonnet 5.5 - Anthropictekst
- Codex w chmurze - OpenAIagent
- Kumo Tabular - Nvidiainne
- OpenAI Dots - OpenAIagent
- Sign in with ChatGPT - OpenAIinne
- Ultrafast - OpenAItekst
- Wtyczki w ChatGPT - OpenAIagent
- FLUX 3 Image - Black Forest Labsobraz
- Ideogram 4.5 - Ideogramobraz
- AstaBrief - Allen Institute for AItekst
- Gemini 4 Argon - Googletekst
- Griffin - Tavuswideo
- EmbeddingGemma 2 - Googleinne
- Falcon Emirati - TIItekst
- Mistral Large 4 (public preview) - Mistral AItekst
- Nano Banana 2.1 - Googleobraz
- d1 (otwarte wagi) - Liquid AIinne
- Claude Haiku 5.5 - Anthropictekst
- GPT-6 - OpenAItekst
- Vidu Q4 Preview - Shengshuwideo
- Gemini agent (prywatna wersja testowa) - Googleagent
- Odyssey-3 - Odysseywideo
- Playground - Googleinne
- Step 5 Preview (OpenRouter) - StepFuntekst
- Agnes-Video-2.0-MoE (otwarte wagi) - Sapiens AIwideo
- Gemini 4 Argon (API dla wszystkich) - Googletekst
- Gemini 4 Argon for Robotics - Googleinne
- LFM2.5-24B-A2B - Liquid AItekst
- HiRO-ACEv2 - Allen Institute for AIinne
- ZWID - ZWIDwideo
- Granite Switch 4.1 - IBMinne
- Kling 4.0 (dla wszystkich) - Kuaishouwideo
- MAI-Base-2 - Microsofttekst
- DeepSeek V4.1 Flash 1017 - DeepSeektekst
- Muse Spark Open - Metatekst
- basal-omni-1.0-ultra - Remek Kinastekst
- d1-ultra - Liquid AItekst
- Cosmos3-H-Dreams - Nvidiawideo
- FLUX 3 Max - Black Forest Labswideo
- Nemotron 3.5 Super VL - Nvidiaobraz
- basal 2.2 - Remek Kinastekst
- ChatGPT Slides - OpenAIinne
- GPT-Live-1.1 - OpenAIdźwięk
- Grok Voice 3.0 - xAIdźwięk
- Kling 4.0 (fal.ai) - Kuaishouwideo
- AlphaEarth Foundations - Googleinne
- Claude Code Review - Anthropicagent
- Deep Review - Googletekst
- 1Password for Agents - 1Passwordagent
- Kimi K3.1 Pro - Moonshot AItekst
- Genie 4 - Googlewideo
- Apple Creator Studio - Appleinne
- Gemini 4 Carbon - Googletekst
- LFM3 - Liquid AIinne
- Nemotron 3.5 Transcribe - Nvidiadźwięk
- Opera WebAI - Operainne
- Mistral Large 4 (otwarte wagi) - Mistral AItekst
- Style Sketch - Metaobraz
- GPT-6 Cyber - OpenAItekst
- Claude Fable 5.2 i Mythos 5.2 - Anthropictekst
- Muse Ember - Metatekst
- Seedream 5.5 - ByteDanceobraz
- Bielik 11B v3.1 - SpeakLeashtekst
- Businesses in ChatGPT - OpenAIinne
- Gemini for healthcare - Googleagent
- MiniMax H3-Image - MiniMaxobraz
- Qwen4-Max (preview) - Alibabatekst
- Gemini 4 Hydrogen - Googletekst
- Seedance 2.5 Flash - ByteDancewideo
- Claude for Manufacturing - Anthropicagent
- Praxis-1 - Runwayinne
Źródła
- A. M. Turing, „Computing Machinery and Intelligence”, Mind, t. LIX, nr 236, październik 1950, s. 433-460 - doi.org
- J. McCarthy, M. L. Minsky, N. Rochester, C. E. Shannon, „A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence”, 31.08.1955 (archiwum J. McCarthy’ego, Stanford) - www-formal.stanford.edu
- Dartmouth College, „Artificial Intelligence (AI) Coined at Dartmouth” - home.dartmouth.edu
- H. A. Simon, A. Newell, „Heuristic Problem Solving: The Next Advance in Operations Research”, Operations Research 6(1), 1958 (metadane i przypis wydawcy) - doi.org
- F. Rosenblatt, „The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain”, Psychological Review 65(6), 1958 - doi.org
- J. Weizenbaum, „ELIZA - A Computer Program For the Study of Natural Language Communication Between Man and Machine”, Communications of the ACM 9(1), 1966 - doi.org
- J. Lighthill, „Artificial Intelligence: A General Survey”, Science Research Council, 1973 (archiwum Chilton Computing) - chilton-computing.org.uk
- D. Rumelhart, G. Hinton, R. Williams, „Learning representations by back-propagating errors”, Nature 323, 9.10.1986 - nature.com
- IBM, „Deep Blue” (IBM Heritage) - ibm.com
- Y. LeCun i in., „Gradient-based learning applied to document recognition”, Proceedings of the IEEE 86(11), 1998 - doi.org
- J. Deng i in., „ImageNet: A Large-Scale Hierarchical Image Database”, CVPR 2009 - wordnet.cs.princeton.edu
- A. Krizhevsky, I. Sutskever, G. Hinton, „ImageNet Classification with Deep Convolutional Neural Networks”, NIPS 2012 - papers.nips.cc
- I. Goodfellow i in., „Generative Adversarial Networks”, arXiv:1406.2661 - arxiv.org
- Google DeepMind, „AlphaGo”; D. Silver i in., Nature 529, 27.01.2016 - deepmind.google
- A. Vaswani i in., „Attention Is All You Need”, arXiv:1706.03762 - arxiv.org
- T. Brown i in., „Language Models are Few-Shot Learners”, arXiv:2005.14165 - arxiv.org
- OpenAI, „Introducing ChatGPT”, 30.11.2022, oraz komunikaty o GPT-1, GPT-2, API, DALL·E, Whisper, GPT-4, GPT-4o, o1, Sora, Operator, GPT-5, GPT-5.2-5.5 i GPT-6 Astra - openai.com
- Anthropic, komunikaty o modelach Claude z lat 2023-2026 - anthropic.com
- Google i Google DeepMind, komunikaty o Gemini, Veo, AlphaFold, Gemmie i Nano Banana z lat 2020-2026 - blog.google
- Stability AI, „Stable Diffusion Public Release”, 22.08.2022 - stability.ai
- The Nobel Prize, komunikaty prasowe z 8 i 9.10.2024 (fizyka i chemia) - nobelprize.org
- Meta, GitHub, Suno, DeepSeek, Midjourney: komunikaty i dokumentacja producentów, adresy przy punktach osi
Zdjęcia i grafiki
- Alan Turing, portret z 29 marca 1951 r.. Autor: Elliott & Fry, domena publiczna, Wikimedia Commons.
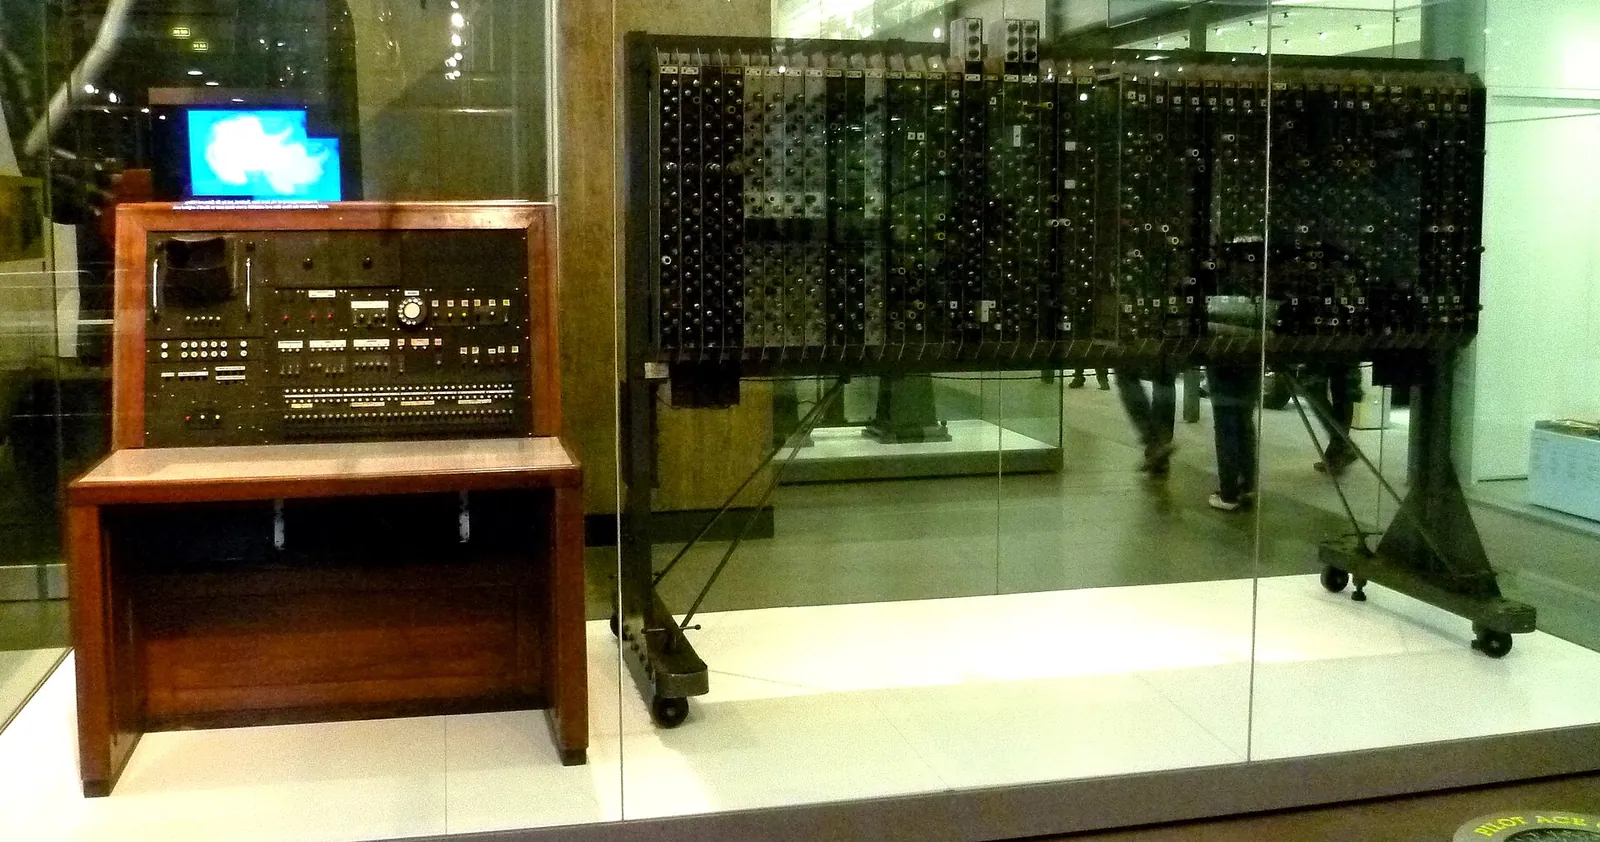
- Komputer Pilot ACE w Science Museum w Londynie (kadr). Autor: Philafrenzy, CC BY 2.0, Wikimedia Commons.
- Dartmouth Hall, Dartmouth College, Hanover (kadr). Autor: Daderot, CC0, Wikimedia Commons.
- Mark I Perceptron, fotografia marynarki USA (kadr). Autor: National Museum of the U.S. Navy, domena publiczna, Wikimedia Commons.
- Maszyny lispowe Symbolics 3620 i LMI Lambda (kadr). Autor: Jason Riedy, CC BY 2.0, Wikimedia Commons.
- Deep Blue, komputer IBM (kadr). Autor: Erik Pitti, CC BY 2.0, Wikimedia Commons.
- Garri Kasparow na turnieju Interpolis w Tilburgu, 2 października 1981 r. (kadr). Autor: Marcel Antonisse / Anefo, Nationaal Archief, CC0, Wikimedia Commons.
- Układ GF110 z karty GeForce GTX 580 (kadr). Autor: Fritzchens Fritz, CC0, Wikimedia Commons.
- Wycofana z użytku szafa serwerowa AlphaGo (kadr). Autor: Immigrant laborer, CC0, Wikimedia Commons.
- Lee Sedol, 2016 r. (kadr). Autor: LG Electronics, CC BY 2.0, Wikimedia Commons.
- Geoffrey Hinton podczas wykładów noblowskich, 8 grudnia 2024 r. (kadr). Autor: Jay Dixit, CC BY-SA 4.0, Wikimedia Commons.
- John McCarthy, 2006 r. (kadr). Autor: null0 (Flickr), CC BY 2.0, Wikimedia Commons.
- Oś czasu, wykresy i wyliczenia: promptowy.com.


