

Benchmarkiprzewodnik · 11 tekstów
Arena modeli AI po polsku: porównaj odpowiedzi 37 modeli obok siebie
Odpowiedzi Claude, GPT-6, Gemini, Groka, DeepSeeka, Qwena i modeli lokalnych na te same 9 zadań po polsku, obok siebie i z oceną sędziów.
Spis treści 7
Teksty w tym temacie 11
- Arena tygodnia: 2-7 października 2026 - Mistral Large 4 w rankingu
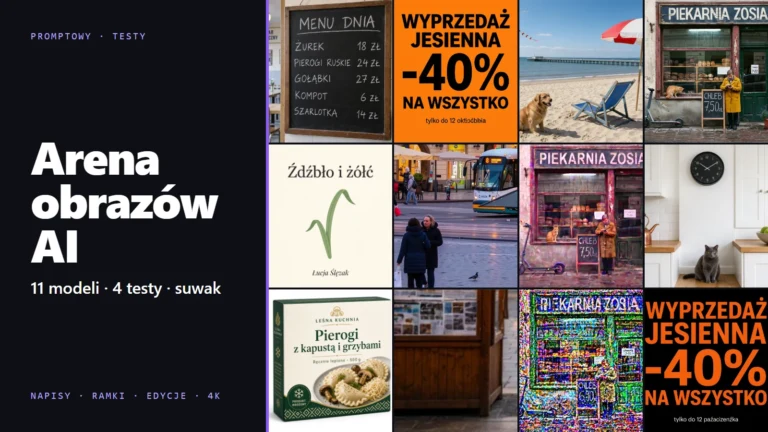
- Arena generatorów obrazów AI: porównaj 12 modeli w moich testach
- Qwen-Image-2.1 kontra zamknięte modele: 4 testy na RTX 4090
- FLUX 3 pod lupą: 4K kontra 6 modeli
- Kompozycja z ramek: FLUX 3 kontra 5 modeli
- 5 zmian jednym poleceniem: FLUX 3 kontra 6 modeli
- 10 edycji pod rząd: Ideogram 4.5 vs 7 modeli
- Polskie napisy: Ideogram 4.5 vs 8 modeli
- 7 lokalnych modeli AI po polsku: test na RTX 4090 kontra chmura
👁 386 przeczytań
Arena to porównanie 37 modeli AI po polsku na tych samych 9 zadaniach: wybierasz zadanie i dwa modele, a obok siebie widzisz ich surowe odpowiedzi i ocenę sędziów. Średnio najlepiej wypada Claude Opus 5.5 (8,94 na 10), tuż za nim GPT-6 Astra (8,78) i GPT-6 Sol (8,76). W arenie jest 30 modeli z chmury, od Claude, GPT-6 i Gemini 4 Argon po Groka, DeepSeeka i Qwena, oraz 7 uruchamianych lokalnie, w tym Bielik 11B i Gemma 4.
Rankingi mówią, który model wygrywa. Tu sprawdzisz dlaczego: kto pisze naturalnie, kto tłumaczy słowo w słowo, kto zmyśla dane, a kto przekracza limit słów. Odpowiedzi pochodzą z mojego Laboratorium i nikt ich nie poprawiał.
Arena: porównaj odpowiedzi
Polecenie, które dostały wszystkie modele
Ranking w tym zadaniu
Jak czytać arenę
- Zakładki u góry to 9 zadań: artykuł na bloga, opis produktu, odpowiedź na skargę klienta, post na LinkedIn, opowiadanie, 10 tytułów SEO, streszczenie w 5 punktach, wyjaśnienie inflacji dziecku i tłumaczenie newslettera. Pod zakładkami jest pełne polecenie, które dostał każdy model.
- Model A i model B wybierasz z list. Na starcie stoją Claude Opus 5.5 i GPT-6 Astra.
- Ranking pod odpowiedziami pokazuje ocenę sędziów w wybranym zadaniu. Kliknięcie modelu wstawia go jako model B.
- Ocena 0-10 to średnia z trzech kryteriów (poprawność języka, naturalność, wykonanie polecenia), uśredniona po trzech sędziach.
Kto prowadzi i co zmienia się co tydzień
Ranking niżej porównuje stan areny z poprzednim tygodniem: kto doszedł, kto awansował i kto spadł. Ostatnia zmiana w danych to 13 października 2026, kiedy doszedł Gemini 4 Argon. Średnia z jego 9 zadań to ok. 7,6, czyli 13. miejsce wśród modeli z chmury, mimo że w moim osobnym teście pisania w Laboratorium zdobył 81,8 pkt na 100.
// arena tygodnia · 7-12 października 2026
Kto wszedł, kto awansował, kto spadł
Porównanie stanu Areny z 7.10 i 12.10.2026: 36 modeli (tydzień wcześniej 33), ranking 29 modeli w chmurze według średniej oceny sędziów z 9 zadań.
- nowyMuse Wonder8. miejsce, średnia 8,13, Laboratorium 87,0 pkt
- nowyClaude Haiku 5.512. miejsce, średnia 7,76, Laboratorium 76,8 pkt
- nowyStep 5 Preview21. miejsce, średnia 6,62, Laboratorium 65,4 pkt
- nikt nie awansował
- ▼ 3Mistral Large 4 (bez rozumowania)19. → 22. miejsce, wyprzedzony przez nowe modele
- ▼ 3GLM-5.320. → 23. miejsce, wyprzedzony przez nowe modele
- ▼ 3GLM-5.3 (tylko Z.AI)21. → 24. miejsce, wyprzedzony przez nowe modele
- ▼ 3Claude Haiku 4.522. → 25. miejsce, wyprzedzony przez nowe modele
- ▼ 3Llama 4 Maverick23. → 26. miejsce, wyprzedzony przez nowe modele
- ▼ 3Muse Glimmer 30B24. → 27. miejsce, wyprzedzony przez nowe modele
- i 13 więcej w tabeli niżej
| # | Model | Średnia 0-10 | Laboratorium |
|---|---|---|---|
| 1. | =Claude Opus 5.5 | 8,94 | 90,1 |
| 2. | =GPT-6 Astra | 8,78 | 85,3 |
| 3. | =GPT-6 Sol | 8,76 | 86,4 |
| 4. | =GPT-6.1 Sol | 8,57 | 85,8 |
| 5. | =GPT-6 Luna | 8,40 | 82,8 |
| 6. | =Claude Fable 5.1 | 8,36 | 83,9 |
| 7. | =Claude Sonnet 5.5 | 8,28 | 80,4 |
| 8. | nowyMuse Wonder | 8,13 | 87,0 |
| 9. | ▼ 1Gemini 3.8 Flash | 8,09 | 79,4 |
| 10. | ▼ 1Kimi K3 | 8,02 | 78,5 |
Pełny ranking: 29 modeli w chmurze
| # | Model | Średnia 0-10 | Laboratorium |
|---|---|---|---|
| 11. | ▼ 1Qwen 3.8 Max | 7,77 | 75,9 |
| 12. | nowyClaude Haiku 5.5 | 7,76 | 76,8 |
| 13. | ▼ 2DeepSeek V4 Pro | 7,57 | 74,1 |
| 14. | ▼ 2Gemini 3.1 Pro | 7,56 | 77,8 |
| 15. | ▼ 2Grok 4.7 | 7,49 | 77,4 |
| 16. | ▼ 2MiMo-V2.6-Pro | 7,11 | - |
| 17. | ▼ 2DeepSeek V4.1 Flash | 7,09 | 72,9 |
| 18. | ▼ 2Claude Sonnet 5 | 7,00 | 71,9 |
| 19. | ▼ 2Mistral Large 4 | 6,95 | 69,2 |
| 20. | ▼ 2Muse Spark 1.3 | 6,79 | - |
| 21. | nowyStep 5 Preview | 6,62 | 65,4 |
| 22. | ▼ 3Mistral Large 4 (bez rozumowania) | 6,50 | 65,6 |
| 23. | ▼ 3GLM-5.3 | 6,36 | 64,4 |
| 24. | ▼ 3GLM-5.3 (tylko Z.AI) | 6,21 | - |
| 25. | ▼ 3Claude Haiku 4.5 | 5,61 | 59,2 |
| 26. | ▼ 3Llama 4 Maverick | 5,59 | 62,9 |
| 27. | ▼ 3Muse Glimmer 30B | 5,50 | - |
| 28. | ▼ 3Mistral Medium 3.5 | 5,13 | 68,0 |
| 29. | ▼ 3Llama 4 Scout | 4,87 | - |
Modeli wydanych po 13 października, takich jak GPT-6.1 Terra (26.10) czy Gemini 4 Carbon (28.10), w arenie jeszcze nie ma. Jak Terra pisze po polsku na tle Sola i Luny, sprawdziłem osobno w teście GPT-6.1 Terra vs Sol vs Luna.
Jak testowałem
- Modele z chmury dostały polecenia przez OpenRouter, z tym samym ustawieniem rozumowania (low) i domyślną temperaturą. Jedna próba na zadanie.
- Modele lokalne (oznaczone „lokalnie”) działały na moim RTX 4090 przez llama.cpp. Oceniali je ci sami sędziowie, ale w osobnej rundzie, w której byli średnio o ok. 3,5 pkt łagodniejsi. Ich oceny porównuj więc ostrożnie.
- Sędziami były Claude Opus 5.5, GPT-6 Sol i Gemini 3.1 Pro. Odpowiedzi dostawały pod losowymi kodami, bez nazw modeli.
- Dwa modele (Mistral Large 4 i Step 5 Preview) mają odpowiedzi w 8 zadaniach z 9, dlatego w opisie produktu jest 35 modeli zamiast 37.
Co widać po lekturze
Czołówka pisze bardzo podobnie. Claude Opus 5.5, Fable 5.1, GPT-6 Astra i Luna różnią się głównie stylem, a nie poprawnością, i różnica między pierwszym a siódmym modelem to niecałe 0,7 punktu.
Najwięcej różnic jest w limitach i warunkach. Słabsze modele przekraczają liczbę słów albo gubią zakaz, na przykład „bez słowa PKB” w wyjaśnieniu inflacji. Modele lokalne do 30 mld parametrów radzą sobie z prostymi tekstami, ale w opowiadaniu i tłumaczeniu widać kalki z angielskiego i błędy odmiany. Najlepszy z nich, Gemma 4 12B, ma średnią 6,63, Bielik 11B v3 6,08.
Ocena w arenie i wynik w Laboratorium to dwa różne testy, więc nie zawsze się pokrywają. Muse Wonder ma w Laboratorium 87,0 pkt i 2. miejsce, a w arenie dopiero 8. (8,13). Pełny ranking pisania, quiz z polszczyzny i korektę tekstu znajdziesz w Laboratorium, a podsumowanie razem z danymi o wyszukiwaniach i cenach w raporcie AI w Polsce za wrzesień 2026. Generatory obrazów porównasz w osobnej arenie generatorów obrazów.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Najczęstsze pytania
Który model AI najlepiej pisze po polsku?
W arenie Claude Opus 5.5 ze średnią 8,94 na 10, przed GPT-6 Astra (8,78) i GPT-6 Sol (8,76). W Laboratorium też prowadzi Opus 5.5 (90,1 pkt), a drugi jest Muse Wonder (87,0).
Ile modeli jest w arenie?
37: 30 z chmury i 7 uruchamianych lokalnie na RTX 4090. Stan danych na 13 października 2026.
Czy tańsze modele piszą dużo gorzej?
Zależy od zadania. Gemini 3.8 Flash (8,09) i Claude Haiku 5.5 (7,76) są tanie, a w prostych tekstach trzymają poziom bliski czołówce. Różnicę widać w dłuższych formach i w zadaniach z twardymi warunkami.
Czy odpowiedzi były poprawiane?
Nie. To surowy tekst, który zwrócił model, razem z błędami.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła
- Odpowiedzi i oceny: moje Laboratorium, 9 zadań, 37 modeli, dane areny z 13.10.2026
- Średnie ocen policzone z danych areny (9 zadań, trzech sędziów), 30.10.2026
- Wyniki pisania po polsku: Laboratorium promptowego, stan na 18.10.2026
Sprawdzone: 30.10.2026
Link do Kimi jest partnerski: jeśli kupisz przez niego, serwis dostaje prowizję, a Ty płacisz tyle samo. Nie wpływa to na treść, także tam, gdzie piszę krytycznie.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Premium · ByteDance chce własnych procesorów. TikTokowa firma buduje zaplecze dla wojny modeliByteDance ma rozwijać własne procesory CPU, żeby uniezależnić infrastrukturę AI od cen i niedoborów chipów. To kolejny sygnał, że wojna modeli...
 Premium · Nowe SEO już nie jest pod Google. Sklepy zaczynają walczyć o widoczność w odpowiedziach sztucznej inteligencjiNowe SEO koncentruje się na widoczności w odpowiedziach AI, a nie tylko w Google. Sklepy walczą o polecenia od sztucznej inteligencji.
 CapCut · CapCut Free vs Pro - wszystko, co musisz wiedzieć przed wyborem odpowiedniej wersjiArtykuł porównuje wersje CapCut Free i Pro, pomagając wybrać odpowiednią opcję do edycji wideo. CapCut to popularny edytor wideo stworzony przez...
- przelomowy.plLaboratorium AutoDNA w Szanghaju: agenci AI sami prowadzą eksperymenty z DNA
- generatornia.plSuno cena 2026: plany, limity pobrań i prawa autorskie
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI
- jutropis.plKE konsultuje formularz oceny wpływu AI na prawa podstawowe