

NVIDIA Kumo Tabular - nowy model do predykcji na danych tabelarycznych
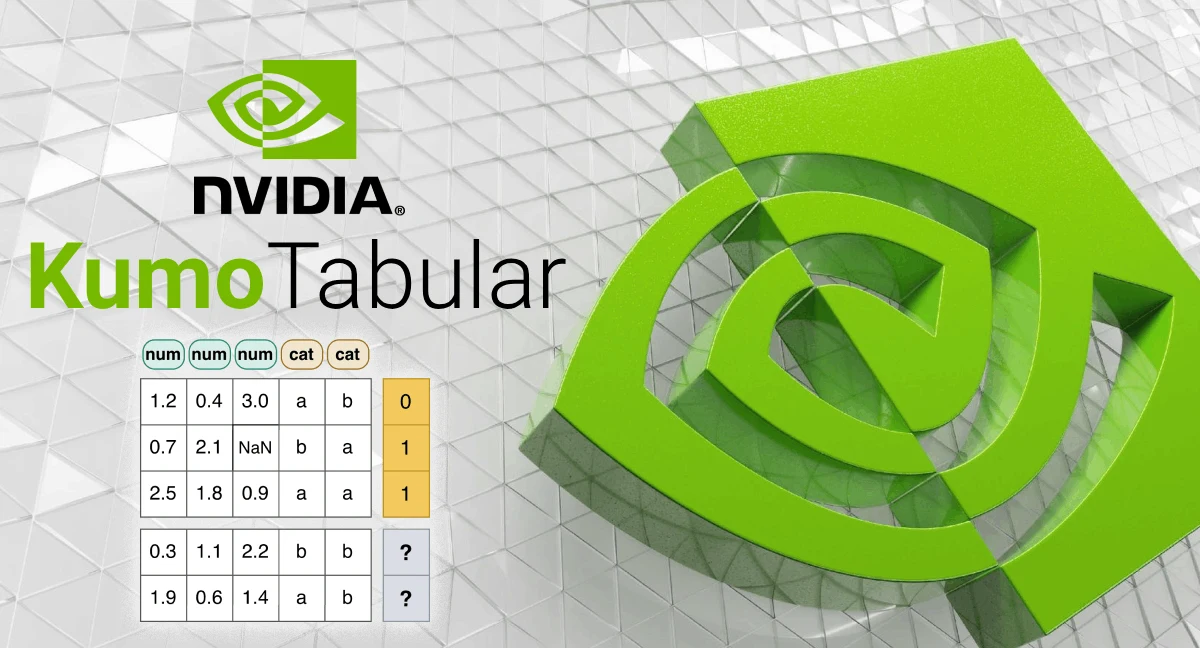
NVIDIA opublikowała Kumo Tabular - model do predykcji na danych tabelarycznych, który według benchmarków wyznacza nowe optimum między dokładnością a wydajnością obliczeniową.
Ten news ukazał się 7 min po komunikacie źródła.
👁 179 przeczytań
NVIDIA opublikowała Kumo Tabular - model do predykcji na danych tabelarycznych, który firma pozycjonuje jako nowe optimum między dokładnością wyników a efektywnością obliczeniową. Ogłoszenie pojawiło się na blogu Hugging Face.
Dane tabelaryczne - ustrukturyzowane zbiory w formacie wierszy i kolumn - to jeden z dominujących formatów w zastosowaniach przemysłowych, od finansów po opiekę zdrowotną. Dotychczas najlepsze rezultaty osiągały metody gradientowego boostingu, takie jak XGBoost czy LightGBM, które przez lata stawiały wysoko poprzeczkę dla modeli opartych na sieciach neuronowych. Kumo Tabular ma być odpowiedzią na ten problem - NVIDIA twierdzi, że model osiąga wyniki, które przesuwają tzw. accuracy-efficiency frontier, czyli kompromis między jakością predykcji a kosztem obliczeniowym.
Model wpisuje się w szerszy projekt Kumo, który NVIDIA rozwija z myślą o uczeniu maszynowym na danych relacyjnych i grafowych. Kumo Tabular koncentruje się na scenariuszach predykcyjnych, gdzie kluczowe jest szybkie działanie przy zachowaniu wysokiej dokładności - co czyni go kandydatem do wdrożeń produkcyjnych wymagających niskich opóźnień.
Publikacja na Hugging Face oznacza, że model jest dostępny dla szerokiego grona badaczy i praktyków. To istotny krok, bo benchmarki na danych tabelarycznych bywają w środowisku ML traktowane sceptycznie - społeczność będzie mogła samodzielnie zweryfikować deklarowaną przewagę nad klasycznymi metodami.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · RAG nie wyczyści za ciebie brudnych danychRAG stał się dla wielu firm wymówką, żeby nie sprzątać własnego bałaganu w danych - i właśnie dlatego tak wiele wdrożeń kończy się rozczarowaniem.
 Newsy · ETH Zurich skopiował 100 petabajtów danych NASA na szwajcarski superkomputerSzwajcarski ETH Zurich przeniósł około 100 petabajtów publicznie dostępnych danych klimatycznych NASA na superkomputer w Lugano - częściowo z obawy...
 Publicystyka · Kto po Huangu? Nvidia zależy od jednego człowieka i to jest problem większy niż aferaZarząd Nvidii w niedzielę ufał prezesowi, w środę według WSJ przygotowywał jego odwołanie. Piszę o tym, dlaczego firma warta biliony nie ma planu na...
- przelomowy.plModele AI domyślają się, że ktoś czyta ich rozumowanie. Preprint testuje 5 modeli
- dygot.plOkulary Samsunga i Google z Gemini XR już są. Wyglądają jak zwykłe, a widzą wszystko
- generatornia.plŚwiąteczne zdjęcie AI: 10 stylów od choinki po śnieżną kulę
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm