Modele decyzyjne AI: Clef, Strands Decider i mój test po polsku
Model decyzyjny wybiera odpowiedź z listy zamiast pisać tekst. Clef, Clef-flash, Strands Decider 2B i Kev - licencje, ceny, wymagania i test na polskich zgłoszeniach.
👁 113 przeczytań
- Clef-flash i Strands Decider 2B przypisały dział poprawnie w 30 na 30 polskich zgłoszeń, z medianą czasu decyzji odpowiednio 112 ms i 135 ms na RTX 4090.
- Cloudflare Clef (27B) kosztuje 0,24 USD za milion tokenów wejścia, Clef-flash (9B) - 0,09 USD, a Strands Decider 2B działa lokalnie bez opłat za hosting.
- Model decyzyjny nie generuje tekstu, lecz zwraca prawdopodobieństwo dla każdej opcji z podanej listy, co pozwala ustawić próg np. 0,8 do automatycznej obsługi bez udziału człowieka.
Model decyzyjny to model AI, który nie pisze tekstu, tylko wybiera odpowiedź z listy, którą mu podajesz, i mówi, na ile jest pewny. Zamiast „to zgłoszenie dotyczy chyba płatności” dostajesz platnosci: 0,97, a Twój kod sam decyduje, co z tym zrobić. 1 października 2026 Cloudflare wypuścił otwarte modele Clef i Clef-flash, a AWS tego samego dnia Strands Decider 2B. Sprawdziłem oba na swoim RTX 4090 na 30 polskich zgłoszeniach klientów.
Stan na 5 października 2026
- Cloudflare Clef (27B, na bazie Qwen3.8-27B) i Clef-flash (9B, na bazie Qwen3.5-9B) - licencja Apache-2.0, wagi na Hugging Face, hosting w Workers AI za 0,24 i 0,09 USD za milion tokenów wejścia.
- Strands Decider 2B od AWS - Apache-2.0, wagi, dane treningowe i skrypty są publiczne, działa nawet na CPU.
- Kev 1.0 (Jared Palmer) - rodzina otwartych modeli 0,8B-27B, tylko angielski.
- Wszystkie trzy mówią tym samym API co Jev od TypeSafe (System One), który 15 września otworzył tę kategorię.
- Mój test: Clef-flash i Strands Decider przypisały dział poprawnie w 30 na 30 polskich zgłoszeń, w medianie 112 i 135 ms na decyzję.
Co to jest model decyzyjny
Zwykły model językowy (LLM) generuje tekst słowo po słowie. Nawet jeśli każesz mu odpowiedzieć jednym słowem albo JSON-em, on nadal pisze, tylko krócej. Model decyzyjny działa inaczej:
- Dostaje stan - tekst zgłoszenia, JSON z danymi zamówienia, a w przypadku Clef także obrazek.
- Dostaje pytania z zamkniętą listą odpowiedzi: „który dział?” z opcjami
platnosci,dostawa,zwrot… - Przelicza stan raz i dla każdej dozwolonej opcji zwraca prawdopodobieństwo. Nie ma generowania, nie ma parsowania, nie ma szansy, że odpowie opcją spoza listy.
Wszystkie modele z tej rodziny używają trzech typów pytań, które spopularyzował Jev od TypeSafe:
| Typ | Co pytasz | Co dostajesz |
|---|---|---|
choice | Wybierz jedną opcję z listy | wybraną opcję, pewność i rozkład prawdopodobieństw |
noul | Tak czy nie? | prawdopodobieństwo „tak” od 0 do 1 |
score | Oceń na skali (np. brak wpływu, mały, duży, krytyczny) | oczekiwany poziom, pewność i rozkład |
Najważniejsza praktyczna różnica: liczba, którą dostajesz, jest prawdopodobieństwem policzonym przez model, a nie tekstem „jestem pewny na 90%”, który LLM może napisać zupełnie na wyczucie. Dzięki temu da się ustawić prosty próg: powyżej 0,8 automat działa sam, poniżej zgłoszenie idzie do człowieka.
Do czego się nadaje (a do czego nie)
Dobre zastosowania:
- Routing zgłoszeń - który dział, czy pilne, jaki język, czy klient grozi odejściem.
- Moderacja - czy komentarz łamie regulamin, czy to spam, czy obrazek nadaje się do publikacji (Clef obsługuje obrazy).
- Klasyfikacja dokumentów - typ faktury, kategoria kosztu, czy umowa zawiera klauzulę X.
- Wybór narzędzia w agencie - zamiast pytać duży model „którą funkcję wywołać?”, pytasz model decyzyjny o wybór z listy narzędzi (więcej o samym mechanizmie w tekście o function calling).
- Bramki w agentach - czy odpowiedź agenta spełnia kryteria, czy trzeba eskalować do człowieka, którym modelem obsłużyć zapytanie.
Złe zastosowania:
- pisanie, streszczanie, tłumaczenie, czat, kod - model decyzyjny nie wygeneruje ani jednego zdania,
- pytania otwarte („co klient ma na myśli?”) - jeśli nie podasz listy opcji, nie ma z czego wybierać,
- trudne rozumowanie wieloetapowe - autorzy Strands Decider piszą wprost, że model jest wyraźnie słabszy od modeli rozumujących w złożonych problemach.
W praktyce model decyzyjny siedzi obok LLM-a: on podejmuje setki małych, szybkich rozstrzygnięć, a duży model pisze odpowiedź tam, gdzie trzeba tekstu. Jak zbudować agenta, w którym takie elementy się łączą, pokazuję w przewodniku Agenci AI od zera.
Modele decyzyjne w październiku 2026
| Model | Autor | Rozmiar i baza | Licencja | Gdzie |
|---|---|---|---|---|
| Jev | TypeSafe | nie podano | zamknięte wagi | API TypeSafe (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (55 GB) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (19 GB) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + pointer head | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/3.8) | Apache-2.0 | Hugging Face, GitHub |
| Decisions API | OpenAI | model Luna | zamknięty | ograniczony podgląd, bez cennika |
Wszystkie otwarte modele z tabeli są zgodne z API System One, czyli z formatem żądań Jeva (POST /v1/systemone, pola state i questions). Ten sam kod klienta zadziała z każdym z nich - zmieniasz tylko adres i nazwę modelu. O Decisions API od OpenAI pisałem przy okazji Agents API.
Cloudflare Clef i Clef-flash
Clef bierze zamrożony model Qwen, przepuszcza przez niego wejście raz (tylko tzw. prefill, bez generowania) i oddaje ukryte stany do małej sieci, którą Cloudflare nazywa joint schema head. Ta głowa ocenia wszystkie opcje wszystkich pytań naraz i może przy tym zestawiać pytania ze sobą. Według Cloudflare to pierwszy model z tej rodziny z enkoderem obrazu i z oknem 64 tys. tokenów. Szczegóły premiery i wyniki z benchmarków opisałem w newsie Cloudflare Clef: otwarty model decyzyjny, a sam Cloudflare jako firmę - w przewodniku Cloudflare.
Amazon Strands Decider 2B
Najmniejszy z otwartych modeli. AWS zostawił z Qwen3.5-2B-Base sam „tors”, wyrzucił głowicę językową i dołożył głowę wskaźnikową, która ma nieco ponad milion parametrów. Do tego adapter LoRA rangi 16. Na Hugging Face jest checkpoint strands-decider-2B-hobson-v19, a obok niego dane treningowe i skrypty. Według autorów mediana opóźnienia to około 115 ms na RTX 3090 i 153 ms na MacBooku z M3. Wynik na publicznym JevBench: 167 z 231 zadań (72,3%).
Kev 1.0
Kev to projekt Jareda Palmera (twórcy m.in. Formika i Turborepo): cztery rozmiary od 0,8B do 27B, LoRA i głowa wskaźnikowa na Qwen3.5/Qwen3.8, licencja Apache-2.0. Implementuje publiczne API System One, więc SDK TypeSafe działa z lokalnym serwerem Kev bez zmian. Model jest trenowany i walidowany tylko po angielsku, a wersja 9B według karty modelu zajmuje około 22 GB pamięci karty. Kev nie wszedł do mojego testu - opisuję dlaczego niżej.
Ceny i wymagania sprzętowe
| Model | Hosting | Cena | Lokalnie |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef | 0,24 USD / mln tokenów wejścia | 55 GB wag w bf16, na 24 GB tylko po kwantyzacji (oficjalnej nie ma) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash | 0,09 USD / mln tokenów wejścia | 19 GB wag, u mnie 18,3 GB VRAM w szczycie |
| Strands Decider 2B | brak hostingu, własny serwer | 0 USD (koszt sprzętu i prądu) | 4,4 GB pobrania, u mnie 3,8 GB VRAM; CPU i Mac też |
| Kev-9B | brak hostingu | 0 USD | ok. 22 GB według autora |
| Jev | API TypeSafe | 0,042 USD / mln tokenów wejścia, wyjście bez opłat | nie da się |
Workers AI ma darmowy przydział 10 000 „neuronów” dziennie w planie Free i Paid. Clef kosztuje 21 818 neuronów za milion tokenów wejścia, a Clef-flash 8182, więc darmowo wychodzi dziennie około 458 tys. tokenów dla Clef i około 1,2 mln dla Clef-flash. Krótkie zgłoszenie z dwoma pytaniami to u mnie około 150-250 tokenów, czyli kilka tysięcy decyzji dziennie za darmo. Potrzebne jest konto Cloudflare - ja go do testu nie zakładałem, więc wersję hostowaną znam tylko z dokumentacji.
Mój test: 30 polskich zgłoszeń na RTX 4090
Napisałem 30 zgłoszeń, jakie trafiają do sklepu internetowego albo firmy z SaaS-em: płatności, dostawa, zwroty, konto, awarie i sprzedaż, po 5 na dział. Część celowo bez polskich znaków, z literówkami albo na granicy dwóch działów (np. „zwrotu pieniędzy dalej nie ma” to zwrot czy płatność?). Każdy model dostał to samo zadanie: dział (6 opcji) i czy sprawa wymaga reakcji jeszcze dziś. Modele decyzyjne pytałem natywnym API, a LLM-y przez Ollamę albo OpenRouter z wymuszonym schematem JSON i temperaturą 0.
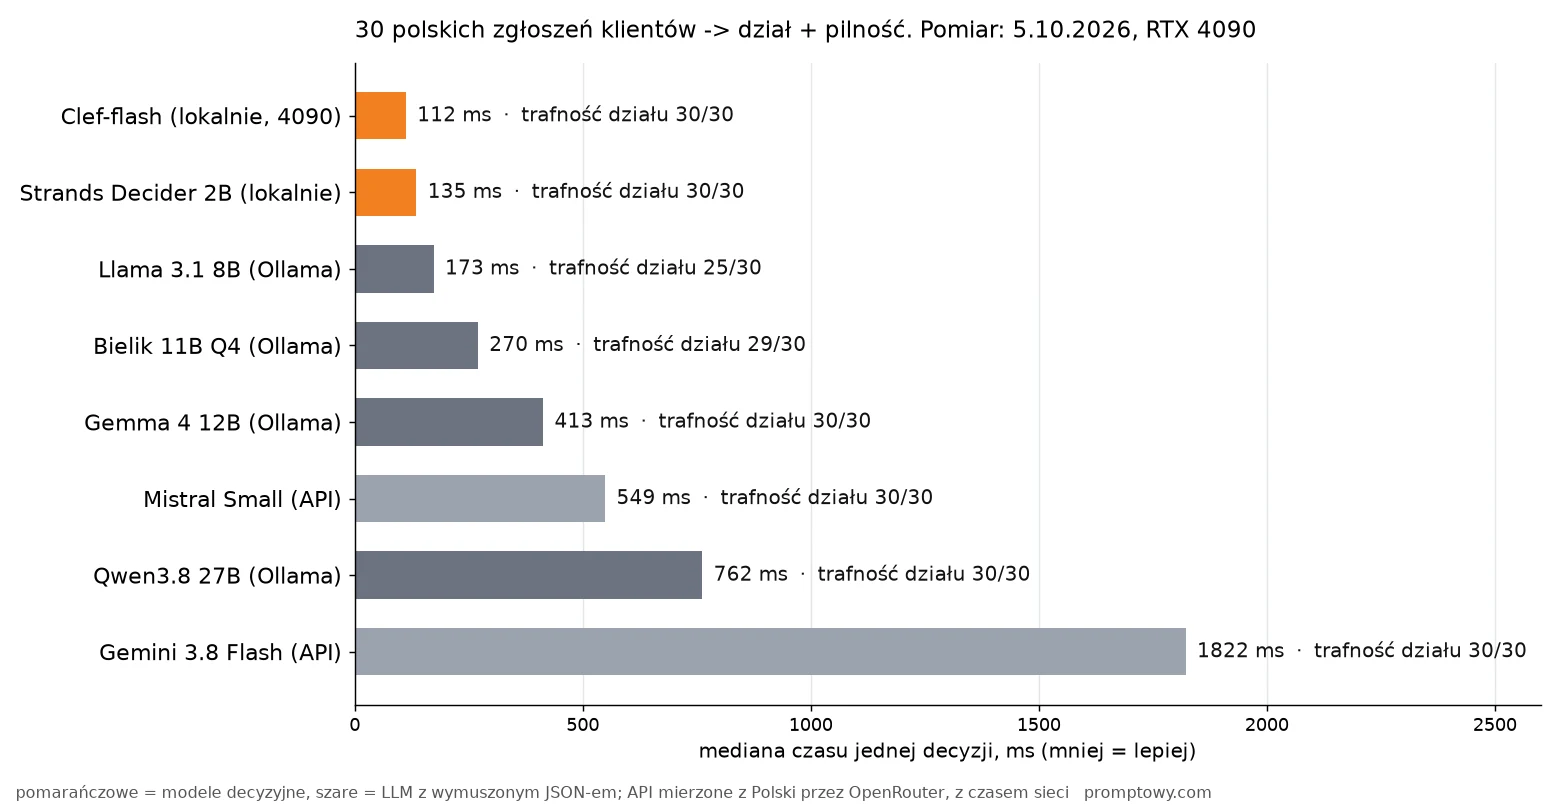
| Model | Dział (PL) | Pilność (PL) | Mediana czasu | Pamięć |
|---|---|---|---|---|
| Clef-flash (lokalnie) | 30/30 | 26/30 (28/30 przy progu 0,95) | 112 ms | 18,3 GB VRAM |
| Strands Decider 2B (lokalnie) | 30/30 | 24/30 (26/30 przy progu 0,4) | 135 ms | 3,8 GB VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | plik 4,9 GB |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | plik 6,7 GB |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | plik 7,0 GB |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | plik 16 GB |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Co z tego wynika:
- Dział to za łatwe zadanie, żeby rozstrzygnąć ranking. 6 z 8 modeli trafiło 30/30. Na 30 zgłoszeniach różnica jednego błędu to szum. Słabo wypadła tylko Llama 3.1 8B (25/30) - myliła fakturę ze sprzedażą i reklamację ekspresu z awarią.
- Szybkość jest realną przewagą. Clef-flash na tej samej karcie odpowiadał 3,7 razy szybciej niż Gemma 4 12B i prawie 7 razy szybciej niż Qwen3.8 27B, który ma prawie identyczną bazę jak duży Clef. A to i tak bez zoptymalizowanych kerneli (flash-linear-attention i causal-conv1d nie instalują się łatwo na Windowsie, więc biblioteka transformers liczyła warstwy liniowej uwagi w wolniejszej wersji referencyjnej).
- Próg trzeba dobrać na swoich danych. Strands Decider po polsku zaniżał prawdopodobieństwa pilności: żadne zgłoszenie nie przekroczyło 0,5, więc przy domyślnym progu nie oznaczył nic jako pilne. Kolejność była jednak sensowna i przy progu 0,4 wynik rósł do 26/30. Clef-flash odwrotnie: przy 0,5 dawał 4 fałszywe alarmy, przy 0,95 tylko 2 błędy.
- Polski działa, choć modele trenowano głównie po angielsku. Te same zgłoszenia przetłumaczone na angielski nie dały lepszych wyników: Clef-flash miał 29/30, Strands 29/30 (oba pomyliły się na zmianie planu w trakcie okresu rozliczeniowego).
- Pilność jest subiektywna. Oznaczyłem jako pilne 6 zgłoszeń (awaria 502, włamanie na konto, podwójne obciążenie…). Prawie wszystkie modele uznały za pilne także płatność BLIK-iem, która nie zaksięgowała się w panelu. Można się z nimi zgodzić.
Koszt testu: 0 zł za modele lokalne i około 0,04 USD na OpenRouterze za 180 zapytań do Mistrala i Gemini. Gemini 3.8 Flash nie pozwala wyłączyć rozumowania, więc działał z najniższym poziomem, stąd czas około 1,8 s. Skrypty i zgłoszenia mam lokalnie i powtórzę test przy następnych wersjach.
Dlaczego nie przetestowałem dużego Clef i Kev
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Clef 27B waży 55 GB w bf16. Nie zmieści się na 24 GB bez kwantyzacji, a Cloudflare nie wydał wersji skwantyzowanej. Model ma własną głowę i własny kod (
joint_schema_model.py), więc nie ruszy w Ollamie ani w llama.cpp z pliku GGUF. Teoretycznie da się go załadować w 4 bitach przez bitsandbytes, ale to już byłby inny model niż ten, który ocenia Cloudflare. - Kev-9B potrzebuje osobnej bazy Qwen3.5-9B-Base (kolejne ok. 19 GB pobrania), a ja ustawiłem sobie limit 40 GB na ten test. Poza tym autor sam deklaruje tylko język angielski.
- Workers AI wymaga konta Cloudflare, którego nie zakładałem na potrzeby testu.
Model decyzyjny czy LLM ze structured output
To samo zadanie da się zrobić zwykłym LLM-em, któremu każesz zwrócić JSON zgodny ze schematem (opisałem to w tekście Structured output: jak zmusić AI do odpowiedzi w JSON). Kiedy co wybrać:
| Model decyzyjny | LLM + structured output | |
|---|---|---|
| Odpowiedź spoza listy | niemożliwa z konstrukcji | wykluczona przy ścisłym schemacie, ale parser może się wyłożyć (patrz model zwraca zły JSON) |
| Pewność | prawdopodobieństwo dla każdej opcji | brak albo liczba „wymyślona” przez model |
| Wiele pytań naraz | prawie bez dodatkowego czasu | każde pole to kolejne wygenerowane tokeny |
| Uzasadnienie | brak | może dopisać, dlaczego |
| Trudne rozumowanie | słabiej | lepiej, zwłaszcza modele rozumujące |
| Koszt w chmurze | płacisz tylko za wejście | wejście + wyjście (+ tokeny rozumowania) |
Moja zasada: jeśli odpowiedź jest z zamkniętej listy, a decyzji jest dużo (setki dziennie i więcej), zaczynam od modelu decyzyjnego. Jeśli potrzebuję uzasadnienia albo odpowiedź zależy od wielu kroków rozumowania - LLM. Najlepiej działa połączenie: model decyzyjny rozstrzyga pewne przypadki, a niepewne (poniżej progu) przekazuje do dużego modelu albo człowieka.
Jak zacząć w 10 minut
- Zainstaluj Pythona 3.10+ i PyTorch z CUDA (bez karty NVIDIA też zadziała, tylko wolniej).
pip install strands-decider- to najmniejszy model, ok. 4,4 GB do pobrania.- Zadaj pierwsze pytanie z wiersza poleceń:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \ --state "Pobraliście mi opłatę dwa razy za ten sam abonament" \ --choice "Który dział?=platnosci,dostawa,zwrot,konto,awaria,sprzedaz" \ --noul "Czy sprawa jest pilna?" - Gdy działa, uruchom serwer HTTP (
strands-decider serve ... --port 8000) i wysyłaj żądania w formacie System One. Serwer nasłuchuje tylko na 127.0.0.1 i nie ma uwierzytelniania - do produkcji dołóż własną warstwę. - Jeśli masz 24 GB VRAM, przełącz się na Clef-flash:
snapshot_download("Cloudflare/clef-flash")i funkcjasystemone()z dołączonego pliku. Format żądania zostaje ten sam.
Jeśli nie masz własnego serwera z GPU, zostaje Workers AI albo API TypeSafe. Model lokalnie na zwykłym komputerze uruchomisz też przez Ollamę, ale tylko klasyczne LLM-y - modele decyzyjne mają własne głowy i potrzebują Pythona z transformers.
Dla kogo to jest
- Tak: sklepy i firmy z helpdeskiem, które chcą automatycznie rozdzielać zgłoszenia; zespoły budujące agentów, w których jest dużo małych decyzji; moderacja treści i obrazów; każdy, kto dziś płaci za duży model tylko po to, żeby odpowiedział „tak” albo „nie”.
- Nie: jeśli potrzebujesz tekstu, rozmowy albo kodu; jeśli decyzji jest kilka dziennie (wtedy wygoda dużego modelu wygrywa); jeśli nie masz kilkudziesięciu oznaczonych przykładów, na których ustawisz progi.
Najczęstsze pytania
Czym jest model decyzyjny AI?
To model, który zamiast generować tekst wybiera odpowiedź z podanej listy i zwraca prawdopodobieństwo dla każdej opcji. Obsługuje trzy typy pytań: wybór z listy (choice), tak/nie (noul) i ocenę na skali (score).
Co to jest Cloudflare Clef?
Rodzina otwartych modeli decyzyjnych Cloudflare z 1 października 2026: Clef (27B, na Qwen3.8-27B) i Clef-flash (9B, na Qwen3.5-9B). Licencja Apache-2.0, wagi na Hugging Face, hosting w Workers AI. Obsługują tekst, JSON, obrazy i wideo, okno 64 tys. tokenów.
Czy Clef jest darmowy?
Wagi tak (Apache-2.0, także komercyjnie). W Workers AI płacisz 0,24 USD (Clef) albo 0,09 USD (Clef-flash) za milion tokenów wejścia, z darmowym przydziałem 10 000 neuronów dziennie, co daje około 458 tys. albo 1,2 mln tokenów.
Czy modele decyzyjne działają po polsku?
W moim teście tak: Clef-flash i Strands Decider 2B przypisały dział poprawnie w 30 na 30 polskich zgłoszeń. Słabiej z kalibracją - prawdopodobieństwa po polsku bywały przesunięte, więc próg trzeba ustawić na własnych przykładach. Kev deklaruje tylko angielski.
Jaki komputer potrzebny do uruchomienia Clef lokalnie?
Clef-flash potrzebował u mnie 18,3 GB pamięci karty, więc wystarczy RTX 3090, 4090 lub 5090. Pełny Clef (55 GB w bf16) wymaga karty klasy H100/H200 albo kwantyzacji, której oficjalnie nie ma. Strands Decider 2B mieści się w niecałych 4 GB i działa też na procesorze i Macu. Więcej o pamięci w tekście ile VRAM potrzeba.
Czym różni się model decyzyjny od function calling?
Function calling to sposób, w jaki LLM generuje wywołanie funkcji z argumentami. Model decyzyjny może zrobić tę część, która polega na wyborze narzędzia z listy, ale argumentów tekstowych nie wygeneruje. W agentach często używa się obu: decyzyjny wybiera, LLM wypełnia szczegóły.
Czy Strands Decider da się używać komercyjnie?
Tak. Model, kod i dane treningowe są na licencji Apache-2.0, a model bazowy Qwen3.5-2B-Base również jest na Apache-2.0. Dołączony serwer nie ma uwierzytelniania, więc w produkcji trzeba go schować za własną bramką.
Co to jest Jev i System One?
Jev to model decyzyjny firmy TypeSafe, udostępniony 15 września 2026 przez API, a System One to format tego API (stan + nazwane pytania + typowane odpowiedzi). Clef, Kev i Strands Decider są z nim zgodne. Więcej w tekście TypeSafe i model Jev.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła
- Cloudflare: Introducing Clef (1.10.2026)
- Cloudflare/clef i Cloudflare/clef-flash na Hugging Face
- Cennik Workers AI
- Strands Agents: Introducing Strands Decider 2B (1.10.2026) i karta modelu
- Kev na GitHubie i jaredpalmer/kev-9b
- Własny test: 5 października 2026, RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18, Ollama.
Sprawdziłem: 5 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym