Laboratorium Promptowe: niezależne testy AI po polsku
16 modeli, 13 zadań, ślepi sędziowie i surowe dane do pobrania. Seria własnych testów AI po polsku z jawnym kosztem: pierwsza edycja za 6,12 USD.
👁 119 przeczytań
- W pierwszej edycji Laboratorium Promptowego z 26 września 2026 roku najlepiej po polsku pisał Claude Opus 5.5, który zdobył 90,1 punktu na 100.
- Cały test 16 modeli kosztował 6,12 USD: 3,19 USD za odpowiedzi modeli, 2,75 USD za oceny sędziów i 0,18 USD za nieudane próby.
Laboratorium Promptowego to seria własnych, powtarzalnych testów modeli AI po polsku: te same polecenia dla wszystkich, ślepi sędziowie, jawny koszt i surowe dane do pobrania. Pierwsza edycja z 26 września 2026 roku objęła 16 modeli i 13 zadań: pisanie, korektę i quiz o Polsce. Tu zbieram wyniki, zasady i wcześniejsze testy redakcji.
W skrócie
W pierwszej edycji najlepiej po polsku pisał Claude Opus 5.5 (90,1 pkt na 100), a najlepszy stosunek wyniku do ceny miał GPT-6 Luna (82,8 pkt za 0,002 USD za 9 zadań). W trudnej korekcie komplet 30 z 30 zrobiło 8 modeli (Opus 5.5, Fable 5.1 i Grok 4.7 bez żadnej zmiany ponad wzorzec), a quiz o Polsce bezbłędnie rozwiązało 10 z 16 modeli. Cały test kosztował 6,12 USD. Seria jest dla osób, które wybierają model do pracy po polsku i chcą liczb zamiast deklaracji producentów. Nie zastąpi testu na własnych tekstach, bo każde zadanie model wykonał raz.
Czym jest Laboratorium Promptowego
Benchmarki producentów mierzą zwykle angielski, matematykę i kod. Polszczyzna, czyli fleksja, interpunkcja, idiomy i polskie realia, rzadko jest w nich osobną kategorią. Laboratorium ma tę lukę wypełniać pomiarami, które każdy może sprawdzić: polecenia, odpowiedzi, oceny i skrypty trafiają do paczki z danymi.
Pierwsza edycja dotyczyła pisania. Wyniki rozbiłem na cztery teksty:
 01Ranking AI do pisania po polsku: 16 modeli, 9 zadań i ślepa ocenaClaude Opus 5.5 wygrał z wynikiem 90,1, ale GPT-6 Luna zrobiła 9 zadań za mniej niż grosz. Pełna tabela, cytaty z odpowiedzi i dokładna metodologia.Czytaj →
 02Który AI najlepiej poprawia polski tekst? Test korekty 16 modeli22 łatwe i 30 trudnych błędów: pleonazmy, bynajmniej, półtorej roku. Trzy modele zrobiły komplet bez zbędnych zmian, jeden zamieniał słowa na synonimy.Czytaj →
 03Czy AI zna Polskę? 94 pytania i 14 pułapek dla 16 modeli10 z 16 modeli bez błędu, 4 dały się złapać na prezydenta, którego nie było, a w jednym pytaniu nieaktualny okazał się nasz klucz. Wszystkie pomyłki.Czytaj →
 0414 tysięcy tokenów myślenia nad opisem czajnika: gdy AI myśli za długoQwen 3.8 Max myślał 14 460 tokenów nad opisem czajnika, Mistral trzy razy oddał pustą odpowiedź. Ile to kosztuje, ile trwa i jak się bronić w API.Czytaj →
Zasady
- Te same polecenia i ustawienia. Wszystkie modele dostają identyczny tekst polecenia przez OpenRouter, z tym samym poziomem rozumowania (w pierwszej edycji effort=low) i domyślną temperaturą. Pustą odpowiedź powtarzam z wyższym limitem i piszę o tym wprost.
- Ślepi sędziowie. Odpowiedzi oceniają trzy modele z różnych firm. Każdy widzi je pod losowymi kodami, w innej kolejności, a ocenę sędziego z tej samej firmy co oceniany model odrzucam.
- Automat obok sędziów. Długość, format, zakazane słowa, dosłowne kalki, liczby spoza materiału źródłowego i pauzy liczy skrypt, a nie model.
- Surowe dane. Odpowiedzi, oceny z uwagami sędziów i skrypty są dostępne w paczce 2026-09-pisanie-po-polsku.zip.
- Jawny koszt. Pierwsza edycja: 3,19 USD odpowiedzi modeli, 2,75 USD oceny sędziów, 0,18 USD nieudane próby.
- Jawne poprawki. Gdy klucz się myli, poprawiam go, przeliczam wszystkie odpowiedzi i piszę o tym. Po pierwszej edycji klucz zmienił się w 3 miejscach: najniższy punkt Polski (Marzęcino według GUS z 2022 roku) oraz zapisy „5-osobowy” i „założyłem kurtkę”, poprawne według Poradni Językowej PWN.
Najważniejsze wyniki pierwszej edycji
| Test | Najlepiej | Najsłabiej | Ciekawostka |
|---|---|---|---|
| Pisanie, 9 zadań | Claude Opus 5.5, 90,1 pkt | Claude Haiku 4.5, 59,2 pkt | GPT-6 Luna na 5. miejscu za 0,002 USD |
| Korekta, 22 i 30 błędów | 8 modeli z kompletem 30/30, w tym Opus 5.5, Fable 5.1 i Grok 4.7 bez zmian ponad wzorzec | Claude Sonnet 5 i Claude Haiku 4.5, po 23/30 | Sonnet 5 zamieniał słowa na synonimy mimo zakazu |
| Quiz o Polsce, 94 pytania | 10 modeli bez błędu | Claude Haiku 4.5, 13 pomyłek | 4 modele podały nazwisko prezydenta, którego nie było |
| Rozumowanie | GLM-5.3: 211 tokenów na 13 zadań | Mistral Medium 3.5: 54 275 tokenów | Qwen 3.8 Max: 14 460 tokenów nad opisem czajnika |
Wcześniejsze testy redakcji
Zanim powstała seria, testowaliśmy modele pojedynczo, zwykle w dniu premiery i na mniejszej liczbie zadań. Te teksty zostają jako punkt odniesienia:
 01Który model AI pisze najlepiej po polsku? Zmierzyłem dziesięć. Zwycięzca kosztuje 32 razy mniej niż drugi zwycięzcaNowszy test (26 września 2026): 16 modeli, 9 zadań pisarskich i ślepa ocena trzech sędziów z różnych firm. Wygrał Claude Opus 5.5,…Czytaj →
 02Test polszczyzny modeli AI - czerwiec 2026. Autorski benchmarkBenchmarki mierzą matematykę i kod - nikt nie mierzy polszczyzny. Autorski test: 10 identycznych zadań po polsku, te same kryteria, ocena redakcyjna. Pierwsza edycja.Czytaj →
 03Chińskie modele AI po polsku: test 5 modeli, trzy nie oddały ani słowaPięć nowych modeli z Chin, jedno polecenie po polsku. Trzy myślały, aż skończył się limit - Qwen liczył w myślach każde słowo po kolei.Czytaj →
 04GPT-6 Sol po polsku: 60 zdań od „Sądzę, że”. Test 4 modeli na jednym poleceniuFormalnie nie złamał żadnej reguły. Praktycznie napisał tekst, którego nikt nie doczyta. Najlepsza lekcja o pisaniu poleceń w tym roku.Czytaj →
 05Claude Opus 5.5 po polsku: test na tym samym poleceniu co Opus 5Oba modele zdały twarde reguły. Różnica wyszła gdzie indziej: w czasie, koszcie i tym, jak często model przyznaje się do niewiedzy.Czytaj →
 06GPT-6 Sol czy Claude Opus 5.5? Premiery z 22 września na tych samych zadaniachWyszły tego samego dnia. Różnica w cenie okazała się większa niż różnica w jakości - ale nie we wszystkim.Czytaj →
 07Test modeli AI 16.09.2026: 7 modeli, 4 zadania, pełne wynikiPrzebieg z 16.09.2026: 7 modeli, te same 3 zadania (redakcja bez zmiany liczb, tabela z PDF, kod PESEL w piaskownicy) plus test kontekstu. Komplet zaliczyło 5 z 7. Pełne prompty i surowe odpowiedzi do wglądu.Czytaj →
 08Który model AI pisze najlepiej po polsku? Benchmark: 5 generatorów kontra „Zażółć gęślą jaźń”Pięć generatorów obrazów, trzy polskie zadania i pangram „Zażółć gęślą jaźń". GPT Image 2 i Nano Banana 2 bez błędu, chińskie modele wpadają w hiperkorekcję ogonków.Czytaj →
Osobno są pomiary wąskich zjawisk: zmyślania, wiedzy o przepisach, długiego kontekstu i kosztu wyższego trybu rozumowania. Jest też przegląd oficjalnych benchmarków Claude Opus 5.5.
 01Zapytałem cztery modele o pisarza, który nie istnieje. Rok temu dostałby biografięCztery zmyślone polskie rzeczy, cztery fakty z pułapką i faktura do policzenia co do grosza. GPT-6 Astra, Fable 5.1 i Opus 5 nie zmyśliły nic, a różnice sprowadziły się do zerwanych połączeń. Gemini wypadł z testu z powodu, który warto znać.Czytaj →
 02Co chatboty wiedzą o AI Act? Test 9 modeli: 8 podaje nieaktualne terminyTylko jeden model odpowiedział poprawnie na wszystkie pytania - ten z wyszukiwarką. Reszta podaje terminy sprzed lipca 2026.Czytaj →
 03Modele obiecują milion tokenów kontekstu. Sprawdziłem na trzech procentach i dwa poległyKażdy producent chwali się dziś oknem kontekstu na milion tokenów. Brzmi to jak obietnica, że można wrzucić modelowi całą książkę i pytać…Czytaj →
 04GPT-6 Astra: Wysoki vs Ultra. Ten sam wynik, ponad 3 razy więcej tokenów24 uruchomienia, sześć własnych łamigłówek i pełny audyt tokenów. Wysoki i Ultra osiągnęły ten sam wynik, ale różniły się czasem i zużyciem.Czytaj →
 05Jedenaście poprawek, jedenaście razy zmieniło się coś jeszczeZastrzeżenie na wstępie, bo zmienia sens całego tekstu: wbudowane narzędzie graficzne OpenAI nie ujawnia identyfikatora modelu. Dokumentacja opisuje je jako GPT Image…Czytaj →
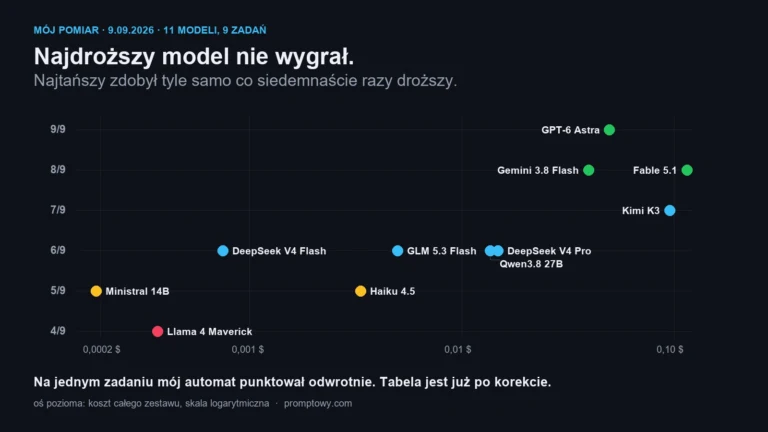 06Zbudowałem test dla jedenastu modeli AI. Na jednym zadaniu test się pomylił, a modele miały racjęZbudowałem test dla jedenastu modeli: dziewięć zadań z kodu, tłumaczenia i trzymania się instrukcji, każde sprawdzane automatycznie, żeby nie oceniać gustem. Po…Czytaj →
 07Claude Opus 5.5 benchmarki: pełna tabela 9 testów i przypisy, których nikt nie tłumaczyWygrywa z Fable 5.1 we wszystkich dziewięciu testach, ale producent sam zastrzega, że w praktyce różnica jest mniejsza. Wyjaśniam dlaczego.Czytaj →
Co dalej
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Kolejne edycje planuję w tym samym schemacie, z nowymi zadaniami:
- Tłumaczenia - dłuższe teksty z angielskiego i na angielski, terminologia branżowa, idiomy i rejestr.
- Streszczenia dokumentów - umowy, raporty i notatki, z liczeniem faktów pominiętych i dopisanych.
- Kod po polsku - zadania programistyczne opisane po polsku, komentarze i dokumentacja w polszczyźnie.
Każda edycja dostanie te same zasady, jawny koszt i paczkę z danymi. To plan redakcji, bez ustalonych terminów.
Najczęstsze pytania
Co to jest Laboratorium Promptowe?
Seria własnych testów modeli AI po polsku prowadzona przez promptowy.com. Wszystkie modele dostają te same polecenia, odpowiedzi oceniają anonimowo trzej sędziowie z różnych firm, a surowe dane są do pobrania.
Który model AI jest najlepszy po polsku?
W pierwszej edycji z 26 września 2026 roku w pisaniu wygrał Claude Opus 5.5 z wynikiem 90,1 na 100. Drugi był GPT-6 Sol (86,4), trzeci GPT-6 Astra (85,3).
Czy test jest sponsorowany?
Nie. Koszt pierwszej edycji, 6,12 USD za zapytania do modeli i sędziów przez OpenRouter, pokryła redakcja.
Czy mogę sprawdzić wyniki sam?
Tak. Paczka zawiera wszystkie odpowiedzi modeli, oceny sędziów z uwagami, klucze do korekty i quizu oraz skrypty, które liczą ranking.
Źródła i data sprawdzenia
Dane pierwszej edycji: własny test redakcji z 26 września 2026 roku, 16 modeli przez OpenRouter, 208 odpowiedzi, oceny sędziów Claude Opus 5.5, GPT-6 Sol i Gemini 3.1 Pro, pomiary automatyczne i metodologia w skryptach run.py, auto.py, sedziowie.py i ranking.py. Surowe dane są dostępne na życzenie oraz w paczce: 2026-09-pisanie-po-polsku.zip. Przeliczenia po kursie NBP 3,857 zł za 1 USD. Sprawdzone 26 września 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Który model AI najlepiej pisze po polsku według niezależnych testów?
Według pierwszej edycji Laboratorium Promptowego z 26 września 2026 roku najlepszy był Claude Opus 5.5 z wynikiem 90,1 na 100. Na drugim miejscu znalazł się GPT-6 Sol (86,4 pkt), a na trzecim GPT-6 Astra (85,3 pkt).
Jak działają ślepi sędziowie w Laboratorium Promptowego?
Odpowiedzi oceniają trzy modele z różnych firm, które widzą je pod losowymi kodami i w innej kolejności. Ocena sędziego z tej samej firmy co oceniany model jest odrzucana, co ma wykluczyć stronniczość.
Ile modeli zaliczyło korektę na pełny komplet punktów?
Komplet 30 na 30 punktów w zadaniu korekty uzyskało 8 modeli, w tym Claude Opus 5.5, Fable 5.1 i Grok 4.7, które nie wprowadziły żadnej zmiany ponad wzorzec. Najsłabiej wypadły Claude Sonnet 5 i Claude Haiku 4.5, które zdobyły po 23 na 30 punktów.
Czy mogę pobrać surowe dane z testu Laboratorium Promptowego?
Tak, surowe dane są dostępne w paczce o nazwie 2026-09-pisanie-po-polsku.zip. Paczka zawiera odpowiedzi modeli, oceny sędziów z uwagami, klucze do korekty i quizu oraz skrypty liczące ranking.
Podobne tematy na Promptowym
