Analiza danych z Opus 5.5: sprawdziłem 44 twierdzenia modelu
Dałem Opusowi 5.5 wyniki 16 modeli w CSV. Policzył korelacje bez kodu, znalazł błąd w metodologii testu i pomylił się raz na 44 twierdzenia.
👁 114 przeczytań
- Opus 5.5 poprawnie zweryfikował 43 z 44 sprawdzonych twierdzeń, a jedyna pomyłka dotyczyła licznika 14 zamiast 15 przebiegów z pauzami.
- Jedno zapytanie trwało 4 minuty 36 sekund i kosztowało 0,645 USD (2,49 zł), z czego 68% tokenów wyjścia poszło na myślenie.
- Model bez uruchamiania kodu obliczył korelację Pearsona jako 0,18 i Spearmana jako 0,20, co zgadza się z wynikami pandas do trzeciego miejsca po przecinku.
Analiza danych z Opus 5.5 to test, który zrobiłem na prawdziwym zbiorze: wynikach naszego Laboratorium, w którym 16 modeli pisało po polsku. Dałem modelowi dwa pliki CSV i zadanie jak dla analityka w firmie: wnioski, anomalie, korelacja kosztu z jakością, rekomendacja i kod do wykresów. Potem porównałem z danymi 44 twierdzenia z jego odpowiedzi. Zgodne było 43, a jedna z „hipotez” trafiła w błąd, który sam popełniłem w metodologii testu.
W skrócie
Jedno zapytanie trwało 4 min 36 s i kosztowało 0,645 USD (2,49 zł), z czego 68% tokenów wyjścia poszło na myślenie. Korelacje Pearsona (0,18) i Spearmana (0,20) policzył bez uruchamiania kodu i zgadzają się z pandas do trzeciego miejsca po przecinku. Skrypt do wykresów zadziałał bez poprawek. Jedyna pomyłka: 14 zamiast 15 przebiegów w jednym z liczników. To dobry analityk do pierwszego przejścia przez dane, ale nie tani: ta jedna analiza kosztowała 2,6 raza więcej niż wszystkie 9 zadań pisania Opusa w Laboratorium.
Dane i zadanie
Źródłem są wyniki Laboratorium Promptowego z 26 września 2026, opisane szerzej w tekście o tym, który AI najlepiej pisze po polsku. Z pliku rankingu zrobiłem modele.csv (16 wierszy, 19 kolumn: wynik, oceny sędziów, reguły, koszt, czas), a z pomiarów automatycznych zadania.csv (234 wiersze: 18 modeli razy 13 zadań, z tokenami, czasem i powodem zakończenia). Komentarzy sędziów nie dałem, żeby model pracował wyłącznie na liczbach.
Opusa wywołałem przez OpenRouter, poziom wysiłku medium, limit 32 000 tokenów wyjścia. Poniżej pełne polecenie, pod nim w zapytaniu była treść obu plików CSV (łącznie 15,6 KB).
Jesteś analitykiem danych. Poniżej dwa pliki CSV z testu 16 modeli językowych na zadaniach pisania po polsku (wrzesień 2026).

Słownik kolumn:
- modele.csv: jeden wiersz = jeden model. wynik_pisanie (0-100) = 70% średnia ocen sędziów (skala 1-10) + 20% reguly_proc + 10% higiena (kara za pauzy i „watę”). sedziowie_srednia, poprawnosc, naturalnosc, wykonanie = oceny sędziów 1-10. reguly_proc = % spełnionych twardych reguł z poleceń. pauzy_na_1000_slow = długie myślniki na 1000 słów. wata = liczba pustych fraz. korekta_* i quiz_* = liczba poprawnych odpowiedzi (maksimum w nazwie kolumny). puste_pierwsza_proba = ile odpowiedzi przyszło puste przy pierwszej próbie. koszt_pisanie_usd i czas_pisanie_s = suma dla 9 zadań pisania (T1-T9).
- zadania.csv: jeden wiersz = model × zadanie (13 zadań, w tym 2 modele lokalne z prefiksem lok_, które nie mają ocen sędziów). koniec = powód zakończenia generowania, tokeny_myslenia puste = model nie raportuje.

Zadanie:
1. Podaj 5 najważniejszych wniosków, każdy z konkretnymi liczbami z danych.
2. Wskaż anomalie i podejrzane wartości w danych (co mogło zafałszować wynik).
3. Oceń związek koszt-jakość: policz korelację (Pearson i Spearman) między koszt_pisanie_usd a wynik_pisanie dla 16 modeli i zinterpretuj ją. Wskaż modele najlepsze w stosunku jakości do ceny.
4. Rekomendacja dla polskiej firmy, która co miesiąc generuje ok. 2000 tekstów marketingowych i mail: który model jako główny, który jako tani zapasowy, i ile to kosztuje miesięcznie przy obecnych kosztach (przyjmij, że 1 tekst ≈ 1/9 kosztu koszt_pisanie_usd).
5. Napisz jeden skrypt w Pythonie (pandas + matplotlib), który wczytuje modele.csv i zadania.csv z bieżącego katalogu i zapisuje DWA wykresy PNG: (a) wykres punktowy koszt vs wynik_pisanie z podpisanymi modelami (oś kosztu logarytmiczna), (b) wykres wybranej przez Ciebie zależności z zadania.csv, która najlepiej pokazuje jedną z anomalii. Polskie podpisy osi. Skrypt ma działać bez zmian.

Odpowiadaj po polsku. Liczby podawaj tylko takie, które wynikają z danych albo z Twoich obliczeń; jeśli coś szacujesz, napisz to wprost.
Ile to kosztowało i trwało
| Pomiar | Wartość |
|---|---|
| Czas odpowiedzi | 276,4 s |
| Tokeny wejścia | 12 457 |
| Tokeny wyjścia | 29 742, w tym 20 274 myślenia (68%) |
| Koszt z rozliczenia OpenRoutera | 0,6447 USD (2,49 zł) |
| Długość odpowiedzi | 17,7 tys. znaków: 5 wniosków, 13 anomalii, rekomendacja, skrypt na 107 linii |
Samo myślenie kosztowało około 0,41 USD (20 274 tokeny po 20 USD za milion). Model przed odpowiedzią sam sprawdził spójność plików: zsumował koszty zadań i porównał z kolumną zbiorczą, a ze składników wyniku odtworzył wzór na „higienę”. Wyszło mu 100 minus 4 punkty za każdą pauzę na 1000 słów minus 5 za każdą frazę waty i to jest dokładnie wzór z naszego skryptu rankingu, którego nie widział. Oznaczył go uczciwie jako szacunek.
Sprawdziłem 44 twierdzenia z odpowiedzi
Każdą liczbę, którą dało się policzyć z plików, przeliczyłem osobnym skryptem w pandas. Wybór z 44 pozycji:
| Twierdzenie modelu | Model podał | Dane |
|---|---|---|
| Korelacja Pearsona koszt-wynik | 0,18 | 0,183 |
| Korelacja Spearmana (z sumą kwadratów różnic rang 542) | 0,20 | 0,203, suma 542 |
| Pearson bez Mistrala | 0,47 | 0,468 |
| Front Pareto (nikt tańszy i lepszy) | Luna, Sol, Opus | Luna, Sol, Opus |
| Qwen, zadanie T2: tokeny myślenia i udział w koszcie | 14 460, 51% | 14 460, 51,3% |
| Ucięta odpowiedź DeepSeek V4.1 Flash w T2 | 6000 tokenów, 70 słów | 6000, 70 |
| Koszt 2000 tekstów miesięcznie na Opusie | 55,09 USD | 55,09 USD |
| Modele lokalne, spełnione reguły | Bielik 19/26, Gemma 25/26 | 19/26, 25/26 |
| Przebiegi T9 z co najmniej 2 pauzami | 14 z 18 | 15 z 18 |
Jedyna rozbieżność dotyczy licznika w anomalii o myślnikach w tłumaczeniu i nie zmienia wniosku. Wszystkie korelacje policzył w tekście, bez narzędzia do wykonywania kodu, i trzymały się wyniku z pandas. Pełna lista z danymi źródłowymi leży w katalogu testu. O tym, jak Opus zachowuje się, gdy liczby w danych brakuje, pisałem osobno w teście czy Claude Opus 5.5 zmyśla liczby.
Najlepsze znalezisko: błąd w moim własnym teście
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Z 13 anomalii najciekawsza była trzecia. Model zauważył, że dwie odpowiedzi ucięto dokładnie na 6000 tokenach, a jednocześnie Qwen w tym samym zadaniu skończył normalnie przy 14 852 tokenach, a Mistral w mailu przy 11 172. Postawił hipotezę: ponowienia po pustej odpowiedzi szły z innym limitem, i powiązał to z kolumną pustych pierwszych prób. Zaznaczył, że dane tego nie rozstrzygają.
Sprawdziłem w kodzie Laboratorium. Domyślny limit dla tych zadań to 6000 tokenów, a powtórki szły z podniesionym limitem. Cztery odpowiedzi powyżej 6000 tokenów to dokładnie te cztery, które przy pierwszej próbie przyszły puste. Wniosek dla rankingu: DeepSeek V4.1 Flash i Mistral w dwóch zadaniach pracowali przy niższym limicie niż modele z powtórką. To opinia redakcji: różnica rzędu 1-2 punktów nie zmienia kolejności w czołówce, ale przy kolejnej edycji limit powinien być jeden dla wszystkich.
Były też spostrzeżenia na wyrost. Model napisał, że „nie znamy tożsamości sędziów”, więc możliwe jest faworyzowanie własnej firmy. W Laboratorium sędzia nie ocenia modeli swojego producenta, ale tej informacji nie było w danych, więc zastrzeżenie było zasadne.
Kod do wykresów: zadziałał bez zmian
Skrypt uruchomiłem lokalnie w Pythonie 3.13 z matplotlib 3.11. Pierwsze uruchomienie przerwał brak biblioteki pandas na moim komputerze, co nie jest winą modelu, bo wymienił ją w nagłówku. Po instalacji skrypt przeszedł za pierwszym razem w 2,6 s, zapisał oba pliki PNG i wypisał te same korelacje, które model podał w tekście, plus trzecią (0,15 dla logarytmu kosztu).
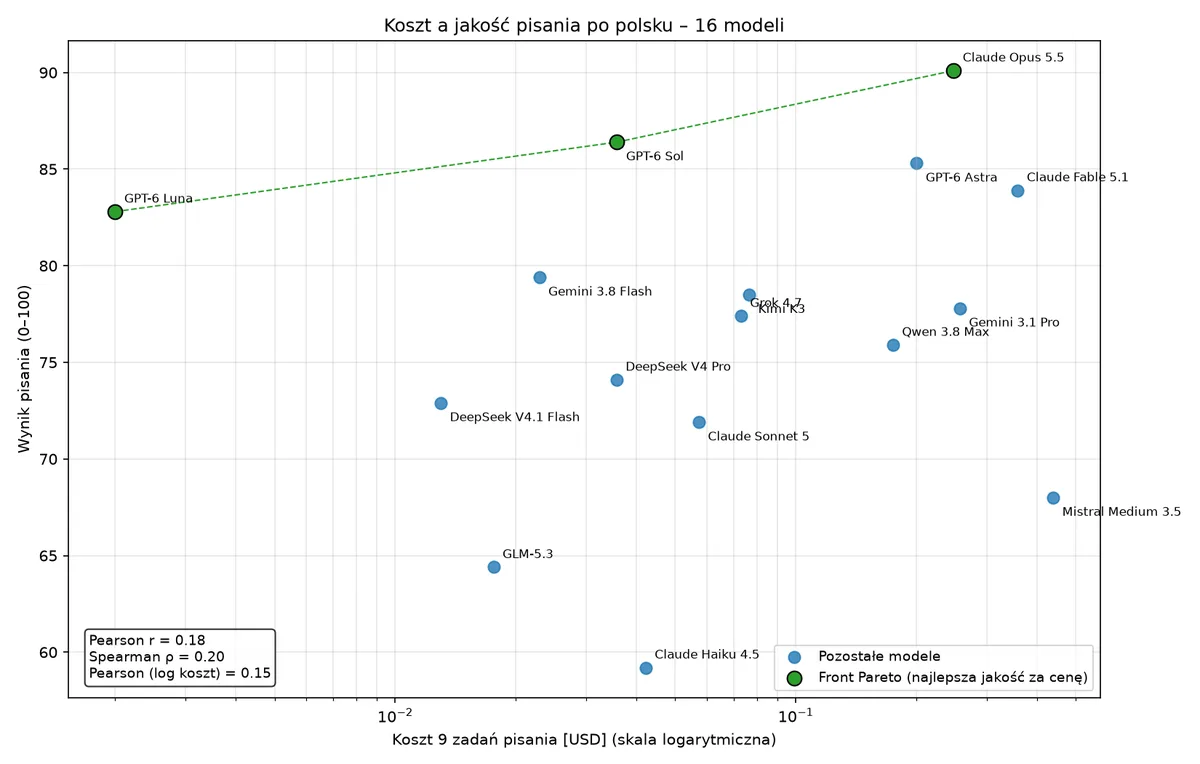
Drugi wykres model wybrał sam: tokeny wyjścia kontra liczba słów w gotowym tekście. Dobrze pokazuje dwie rzeczy naraz, czyli ucięte odpowiedzi na linii 6000 tokenów i zadania, w których model spalił ponad 7000 tokenów na tekst długości 43-182 słów.
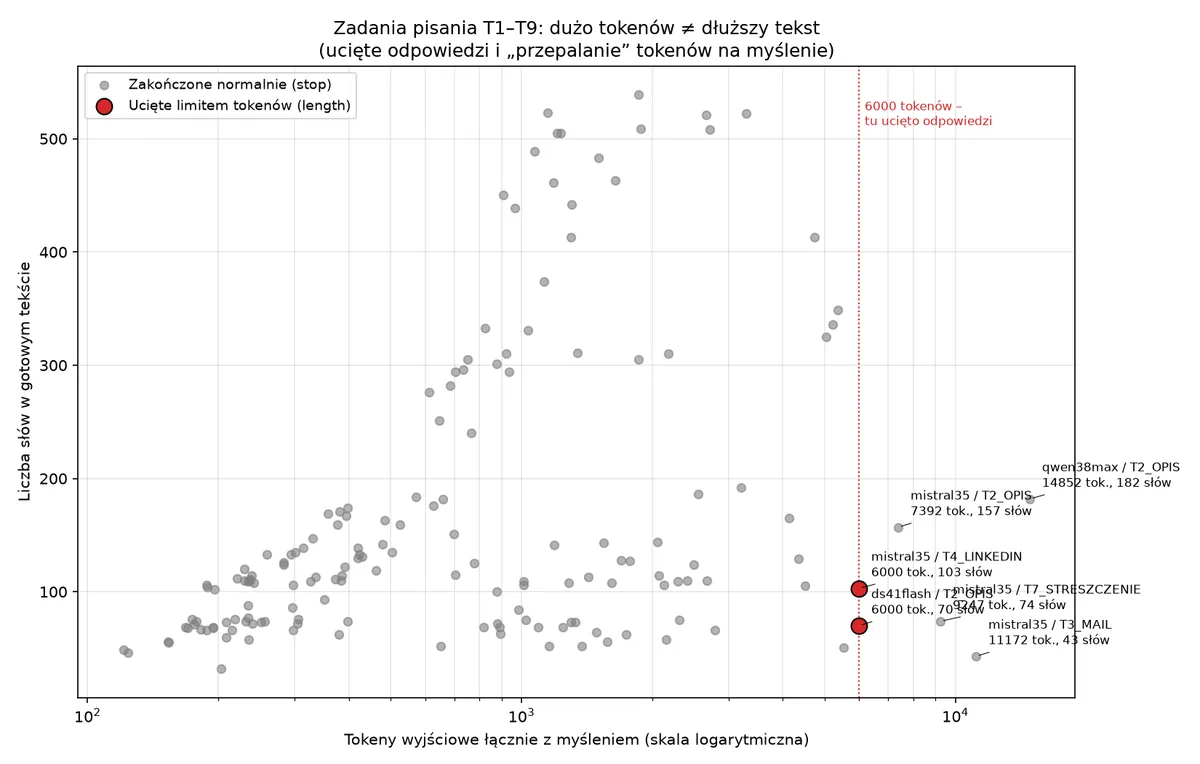
Wady są kosmetyczne: nachodzące podpisy (Grok 4.7 i Kimi K3 na pierwszym wykresie, dwa punkty na drugim) i półpauzy w tytułach wykresów. Poprawka to kilka minut ręcznej pracy.
Rekomendacja dla firmy
Na 2000 tekstów miesięcznie model zaproponował Opusa 5.5 jako model główny (około 55 USD miesięcznie) i GPT-6 Sol jako zapasowy od innego dostawcy (7,96 USD przy przejęciu całego ruchu). Uzasadnienie: w tekstach marketingowych liczy się naturalność, a tu Opus ma 8,50 wobec 7,56 u Sola. Wariant budżetowy to Sol z Luną za około 8 USD miesięcznie. Sam dopisał wrażliwość założenia: gdyby wszystkie teksty były mailami, Opus kosztowałby 17,74 USD. Aktualny cennik modelu jest w tekście o tym, ile kosztuje Claude Opus 5.5.
To opinia redakcji: rekomendacja jest rozsądna i ma dobrze opisane założenia, ale jej jakość zależy od jednej przyjętej przeze mnie proporcji 1/9 kosztu na tekst. Model tę proporcję zakwestionował sam, bez proszenia.
Kiedy to się opłaca
- Pierwsze przejście przez nowy zbiór danych: 13 anomalii w 4,6 minuty, z czego co najmniej jedna prawdziwa i nieoczywista.
- Szkic wykresów, gdy nie chcesz pisać matplotlib od zera: 107 linii działającego kodu.
- Kontrola spójności danych, której nikt nie zamawiał: sumy, wzory, zakresy.
Nie opłaca się przy powtarzalnych raportach na tych samych danych. 0,645 USD za jedną odpowiedź to więcej niż koszt całej sesji pisania w Laboratorium, a przy medium model i tak sam decyduje, ile myśleć (więcej w tekście o poziomach wysiłku). Do stałego raportu lepiej raz wygenerować skrypt i uruchamiać go bez modelu.
Najczęstsze pytania
Czy Claude Opus 5.5 liczy korelację bez uruchamiania kodu?
W moim teście tak. Pearson 0,18 i Spearman 0,20 dla 16 modeli zgadzały się z pandas do trzeciego miejsca po przecinku, a model pokazał też sumę kwadratów różnic rang (542), którą dało się sprawdzić.
Ile kosztuje analiza danych z Opus 5.5?
Jedno zapytanie z 15,6 KB danych CSV kosztowało 0,645 USD, czyli 2,49 zł. 68% tokenów wyjścia to myślenie, więc koszt zależy bardziej od trudności zadania niż od rozmiaru danych.
Czy kod wygenerowany przez Opusa 5.5 działa od razu?
Skrypt do dwóch wykresów w matplotlib zadziałał bez poprawek po doinstalowaniu pandas. Wady były tylko kosmetyczne: nachodzące podpisy punktów.
Czy Opus 5.5 zmyśla liczby w analizie?
Na 44 sprawdzone twierdzenia 43 zgadzały się z danymi, a jedno było pomyłką o 1 w liczniku. Szacunki i hipotezy model oznaczał wprost jako szacunki.
Źródła i data sprawdzenia
Dane: wyniki Laboratorium Promptowego z 26 września 2026 (ranking 16 modeli i pomiary automatyczne 13 zadań). Model: Claude Opus 5.5 na OpenRouterze, cennik z ogłoszenia Anthropic. Wykresy: matplotlib i pandas. Koszt z pola rozliczeniowego odpowiedzi OpenRoutera, kurs 3,857 zł za 1 USD (NBP, 24.09.2026). Test wykonałem na własnym komputerze, sprawdzone 26 września 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Ile kosztowała analiza danych wykonana przez Opus 5.5 w tym teście?
Jedna analiza kosztowała 0,645 USD (2,49 zł) według rozliczenia OpenRoutera. To 2,6 raza więcej niż wszystkie 9 zadań pisania Opusa w Laboratorium.
Czy skrypt w Pythonie wygenerowany przez Opus 5.5 zadziałał od razu?
Skrypt zadziałał bez żadnych poprawek po instalacji biblioteki pandas, której brakowało na komputerze autora. Uruchomienie trwało 2,6 sekundy i zapisało oba pliki PNG.
Jaką anomalię w danych wykrył Opus 5.5, której autor wcześniej nie zauważył?
Model postawił hipotezę, że ponowienia po pustej odpowiedzi szły z innym, wyższym limitem tokenów niż domyślne 6000. Sprawdzenie kodu Laboratorium potwierdziło to: cztery odpowiedzi powyżej 6000 tokenów to dokładnie te, które przy pierwszej próbie przyszły puste.
Który model AI Opus 5.5 zarekomendował polskiej firmie generującej 2000 tekstów miesięcznie?
Model zaproponował Opusa 5.5 jako główny za około 55 USD miesięcznie i GPT-6 Sol jako zapasowy od innego dostawcy za 7,96 USD. Uzasadnieniem był wynik naturalności: Opus uzyskał 8,50 wobec 7,56 u Sola.
