Muse Wonder od Mety: benchmarki, cena, dostęp w Polsce i mój test
Wszystko o Muse Wonder: wersje, benchmarki wg Mety i niezależne, ceny, dostęp z Polski krok po kroku, porównanie z Opusem 5.5, Fable 5.1 i GPT-6 Astra oraz mój test po polsku.
👁 220 przeczytań
- Muse Wonder Full zdobył 56 punktów w indeksie Artificial Analysis 4.3, tyle co Claude Sonnet 5.5 i tylko 2 mniej niż Claude Opus 5.5.
- Przez API dostępny jest wyłącznie słabszy Muse Wonder (52 pkt w AA) za 4 USD za milion tokenów wejścia i 20 USD za milion tokenów wyjścia.
- W teście po polsku Muse Wonder uzyskał 87,0 pkt na 100 i zajął 2. miejsce w rankingu Laboratorium, wyprzedzając GPT-6 Sol, Astrę i Fable 5.1.
Muse Wonder to nowa rodzina modeli Mety, pokazana 12 października 2026: zwykły Muse Wonder i mocniejszy Muse Wonder Full. W niezależnym indeksie Artificial Analysis Full ma 56 punktów, tyle co Claude Sonnet 5.5 i tylko 2 mniej niż Claude Opus 5.5, a zwykły Wonder 52. API kosztuje 4 USD za milion tokenów wejścia i 20 USD za milion wyjścia, czyli tyle co Opus 5.5. Z Polski działa przez OpenRouter i API Mety. W moim teście po polsku Muse Wonder dostał 87,0 pkt na 100 i zajął 2. miejsce w rankingu Laboratorium. Poniżej benchmarki wg Mety obok niezależnych, ceny, dostęp krok po kroku i wyniki testu.
Stan na 12 października 2026, wieczór
- Muse Wonder: dostępny w Meta Model API (muse-wonder-1.0), w Muse Code i na OpenRouterze (meta/muse-wonder). Działa z polskiego konta OpenRoutera - sprawdziłem.
- Muse Wonder Full: tylko w Muse Code, w planach Power Usage (50 USD/mies.) i Maximum Usage (200 USD/mies.). W API go nie ma.
- Aplikacja Muse i Meta AI: Wonder trafi „wkrótce”, najpierw do subskrybentów Muse. Aplikacja Muse nie działa w Polsce ani w UE.
- Wagi: zamknięte. Meta nie zapowiedziała otwartej wersji.
- Niezależne testy: Artificial Analysis już jest (56 i 52 pkt), LMArena jeszcze nie ma wyniku.
W skrócie
Meta ma model z samej czołówki. Muse Wonder Full jest w indeksie AA ex aequo drugi, a w tabeli Mety wygrywa z Opusem 5.5, Fable 5.1 i GPT-6 Astra w 7 z 14 testów, głównie w długich zadaniach programistycznych, pracy agentów i pamięci. Przegrywa w ProgramBench, HealthBench Pro, Terminal-Bench i OSWorld. Do kupienia w API jest jednak tylko słabszy Muse Wonder (52 pkt w AA), w cenie Opusa 5.5, który ma 58. Po polsku pisze bardzo dobrze: 87,0 pkt w moim teście, więcej niż GPT-6 Sol, Astra i Fable 5.1. Słabe punkty: powtarza się w opisach produktów i jest gadatliwy, co przy 20 USD za milion tokenów wyjścia kosztuje.
Czym jest Muse Wonder
Muse Wonder to zamknięta rodzina modeli rozumujących z Meta Superintelligence Labs, zespołu, który Meta zbudowała od zera w ramach przebudowy działu AI rozpoczętej 14 miesięcy temu. Pierwszą rodziną tego zespołu był Muse Spark (kwiecień 2026, wersja 1.3 we wrześniu). Mark Zuckerberg nazwał Wonder „znacznie większą i bardziej zaawansowaną klasą modeli”, która wprowadza Metę do czołówki. Według bloga Mety modele trenowano w gigawatowym centrum danych Prometheus, łącząc pretrening z uczeniem ze wzmocnieniem.
Meta opisuje dwie cechy, pod które trenowała model:
- Active Memory - model ma pamiętać ważne informacje o użytkowniku między rozmowami i samemu je przywoływać, gdy przydadzą się w zadaniu;
- Active Focus - przy trudnym zadaniu ma próbować innych podejść, obchodzić przeszkody i dopytywać przed ważnymi krokami, zamiast stawać i czekać na człowieka.
Karta modelu podaje okno 1 mln tokenów, wejście tekstowe, obrazowe, wideo i dźwiękowe oraz wyjście wyłącznie tekstowe. Meta pisze, że model uczono na danych wielojęzycznych, ale nie podaje listy wspieranych języków i ostrzega, że „nie oceniano go we wszystkich językach”. Polszczyznę sprawdziłem sam - wyniki niżej.
Wersje: Wonder i Wonder Full
| Cecha | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Indeks Artificial Analysis 4.3 | 52 (10. pozycja na liście wariantów) | 56 (ex aequo 2. wynik) |
| Meta Model API | tak, muse-wonder-1.0 | nie |
| OpenRouter | tak, meta/muse-wonder | nie |
| Muse Code | tak | tylko plany Power Usage i Maximum Usage |
| Aplikacja Muse | „wkrótce”, najpierw subskrybenci | brak zapowiedzi |
| Poziomy rozumowania w API | minimal, low, medium (domyślny), high, xhigh, max | - |
| Kontekst | 1 mln tokenów | 1 mln tokenów |
Rozumowania nie da się wyłączyć: na OpenRouterze jest oznaczone jako obowiązkowe, najniższy poziom to minimal. Wszystkie benchmarki Mety liczono na poziomie max.
Benchmarki wg Mety: pełna tabela
Meta porównała oba modele z Claude Fable 5.1, GPT-6 Astra i Claude Opus 5.5, wszystkie na poziomie max. Część wyników pochodzi od niezależnych firm (Artificial Analysis, Vals AI, Surge, Datacurve, Abundant AI), część z wewnętrznych testów Mety (Personal Superintelligence Index, MemoryBench, FocusBench). Pogrubiłem najlepszy wynik w wierszu.
| Test (wg Meta) | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (wewnętrzny) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (prawo) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 (finanse) | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro (zdrowie) | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA (procesy firmowe) | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (praca na dokumentach) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (zadania zawodowe) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (obsługa komputera, częściowo) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (pamięć, wewnętrzny) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 (długie programowanie) | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon (bardzo długie projekty) | 57,5* | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (program od zera) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
* Full na poziomie xhigh. Źródło: tabela z wpisu Meta z 12.10.2026. W OSWorld V2.1 Meta podaje też wynik binarny (zadanie wykonane w całości): Full 39,4, Wonder 34,3, Fable 5.1 43,1, Astra 34,3, dla Opusa 5.5 brak.
Na co uważać, czytając tę tabelę:
- Personal Superintelligence Index i MemoryBench to testy Mety. PSI to złożenie siedmiu testów, w tym wewnętrznych FocusBench i VBT. Wygrana w teście, który zaprojektował producent, mówi mniej niż wygrana w cudzym.
- SWE-Marathon nie jest porównaniem w równych warunkach - Meta sama to pisze w karcie modelu: Astra i Fable mają wyniki z Codexa i Claude Code, a Full liczono na xhigh.
- W ProgramBench Opus 5.5 wygrywa o 11,5 pkt, a w Terminal-Bench i HealthBench Pro Meta jest za Opusem i Astrą. Tego ogłoszenie nie eksponuje.
- Wyniki konkurencji Meta liczyła częściowo sama i zaznacza, że prompty i narzędzia „mogą nie być optymalnie dostrojone” do cudzych modeli.
Niezależne wyniki: Artificial Analysis
Artificial Analysis samo uruchamia 10 testów (m.in. GDPval-AA, Terminal-Bench 4.0, Humanity’s Last Exam, SciCode) i łączy je w jeden indeks. Stan z 12 października 2026, wieczór:
| Model (wariant) | Indeks AA 4.3 | Cena API USD (wejście / wyjście) |
|---|---|---|
| Claude Opus 5.5 (max) | 58 | 4 / 20 |
| Claude Sonnet 5.5 (max) | 56 | 2 / 10 |
| Muse Wonder Full (max) | 56 | brak w API |
| Claude Fable 5.1 (max) | 53 | 10 / 50 |
| GPT-6 Astra (max) | 53 | 10 / 50 |
| Gemini 4 Argon (high) | 53 | 2 / 10 na start (zapowiedź Google) |
| Muse Wonder (max) | 52 | 4 / 20 |
| GPT-6.1 Sol (max) | 52 | 2 / 10 |
| Muse Spark 1.3 (max) | 48 | 1,25 / 4,25 |
Ceny z OpenRoutera i cenników producentów. Dwie obserwacje:
- Meta pominęła Sonneta 5.5 na swoim wykresie indeksu AA. Ma te same 56 pkt co Wonder Full, a w API kosztuje połowę ceny zwykłego Wondera (2 / 10 USD).
- Muse Wonder jest gadatliwy. Przy liczeniu indeksu wygenerował 130 mln tokenów wyjścia, Full 140 mln, przy medianie AA 88 mln.
Na LMArenie, gdzie ludzie wybierają lepszą odpowiedź w ciemno, Muse Wonder nie ma jeszcze wyniku. Dopiszę go, gdy się pojawi.
Ceny
| Gdzie | Cena | Co dostajesz |
|---|---|---|
| Meta Model API | 4 USD wejście, 20 USD wyjście, 0,20 USD wejście z pamięci podręcznej (za 1 mln tokenów) | Muse Wonder, limit 3000 zapytań i 4 mln tokenów na minutę |
| OpenRouter | 4 / 20 USD, 0,20 USD cache | Muse Wonder, jeden klucz do wielu modeli |
| Muse Code Everyday / High Usage | 5 / 15 USD miesięcznie | modele Muse, bez Wonder Full |
| Muse Code Power / Maximum Usage | 50 / 200 USD miesięcznie | Muse Wonder Full |
| Aplikacja Muse (USA, Kanada) | 20 / 100 USD miesięcznie | Wonder „wkrótce”, najpierw dla płacących |
Wyszukiwanie w sieci przez API kosztuje dodatkowo 2,50 USD za 1000 zapytań. Tańszego trybu Contributor, który ma Muse Spark (0,10 / 0,20 USD w zamian za trenowanie na twoich danych), dla Wondera nie ma. W porównaniu z rywalami: Wonder kosztuje tyle co Opus 5.5, dwa razy więcej niż GPT-6.1 Sol i 2,5 raza mniej niż GPT-6 Astra i Claude Fable 5.1. Mój test 13 zadań kosztował 0,45 USD, Opus 5.5 w tym samym teście 0,37 USD.
Jak używać Muse Wonder w Polsce krok po kroku
Najprostsza droga to OpenRouter. Tak zrobiłem test:
- Załóż konto na openrouter.ai i doładuj saldo (karta, minimum kilka USD). Przy modelach Mety OpenRouter może poprosić o potwierdzenie wieku 18+ w ustawieniach - tak było przy Muse Spark.
- Utwórz klucz API w zakładce Keys.
- W czacie OpenRoutera wybierz model „Meta: Muse Wonder” albo w kodzie podaj identyfikator
meta/muse-wonder. - Ustaw poziom rozumowania parametrem
reasoning.effort(od minimal do max). Na medium i wyżej odpowiedzi rosną i drożeją.
Przykład w Pythonie (zmienna środowiskowa OPENROUTER_API_KEY):
import os, requests
r = requests.post("https://openrouter.ai/api/v1/chat/completions",
    headers={"Authorization": "Bearer " + os.environ["OPENROUTER_API_KEY"]},
    json={"model": "meta/muse-wonder",
          "reasoning": {"effort": "low"},
          "messages": [{"role": "user", "content": "Napisz krótki mail z przeprosinami za opóźnioną dostawę."}]})
print(r.json()["choices"][0]["message"]["content"])
Druga droga to Meta Model API (dev.meta.ai) z identyfikatorem muse-wonder-1.0. Meta od końca września opisuje API jako dostępne „z rozszerzonym dostępem globalnym”, ale nie publikuje listy krajów, a w sierpniu część użytkowników z Europy dostawała komunikat o niedostępności w regionie. Jeśli zależy ci na umowie powierzenia danych i przetwarzaniu w UE, Meta takiej opcji nie ogłosiła. Szerzej o tym, co z produktów Mety działa w Polsce, piszę w tekście Meta AI w Polsce. Trzecia droga to Muse Code - tam jest Wonder Full, ale w planach od 50 USD miesięcznie.
Mój test po polsku: 87,0 pkt i 2. miejsce
Muse Wonder przeszedł te same 13 zadań co ponad 20 modeli w moim rankingu AI do pisania po polsku: 9 zadań pisarskich, dwie korekty i dwa quizy o Polsce. Ustawienia jak u wszystkich: OpenRouter, effort=low, te same limity tokenów. Teksty ocenili w ciemno dwaj sędziowie z innych firm (Claude Opus 5.5 i GPT-6 Sol), a w tej samej puli były cztery modele-kotwice z pierwszej rundy. Kotwice zachowały kolejność, skala przesunęła się o 2,45 pkt i o tyle skalibrowałem wynik.
| Model | Wynik (skalibrowany) | Sędziowie 1-10 | Naturalność | Reguły | Korekta trudna | Quiz trudny |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 90,1 | 8,70 | 8,00 | 25/26 | 30/30 | 48/48 |
| Muse Wonder | 87,0 | 8,15 | 7,22 | 26/26 | 29/30 | 48/48 |
| GPT-6 Sol | 86,4 | - | - | - | - | - |
| GPT-6 Astra | 85,3 | - | - | - | - | - |
| Claude Fable 5.1 | 83,9 | - | - | - | - | - |
| GPT-6 Luna | 82,8 | 7,63 | 6,67 | 24/26 | 29/30 | 48/48 |
| Muse Spark 1.3 | 75,3 | 6,78 | 5,63 | 25/26 | 29/30 | 48/48 |
Oceny sędziów, naturalność i reguły dla Opusa 5.5 i Luny z tej samej puli co Muse Wonder (12.10.2026), dla Muse Spark z jego puli z 27.09. Sol, Astra i Fable mają wyniki z pierwszej rundy rankingu, bez rozbicia w tej puli. Muse Wonder spełnił wszystkie 26 reguł z poleceń (limity słów, liczba punktów, słowa kluczowe), czego nie zrobił ani Opus, ani Luna. Odpowiedzi na 13 zadań kosztowały 0,45 USD, łączny czas pisania 100 s (Opus 5.5: 133 s).
Co wyszło dobrze, a co źle:
- Streszczenie i tłumaczenie to najlepsze zadania. GPT-6 Sol jako sędzia napisał, że streszczenie „zwięźle ujmuje wszystkie istotne fakty”, a przekład newslettera oddaje ton oryginału („zimny prysznic”, „ruch należy do nas”).
- Opis produktu wypadł słabo (5,33). Model w jednym akapicie dwa razy podał te same parametry czajnika: regulację temperatury, podtrzymanie przez 30 minut i filtr. Obaj sędziowie wytknęli powtórzenia i to, że lista wymienia cechy zamiast korzyści.
- Drobne potknięcia językowe: hashtag „#małabiznes” w poście na LinkedIn (błąd rodzaju), „serdecznie przepraszamy” w mailu z przeprosinami i założenie, że klient jest mężczyzną.
- Korekta i quizy: 22/22 w łatwej korekcie, 29/30 w trudnej, komplet w obu quizach o Polsce.
Dla porównania: Muse Spark 1.3 w tym samym teście miał 75,3 pkt, więc nowy model Mety pisze po polsku wyraźnie lepiej. Odpowiedzi obok innych modeli zobaczysz w Arenie modeli AI po polsku.
Mój pojedynek: 23 zadania, 5 modeli
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
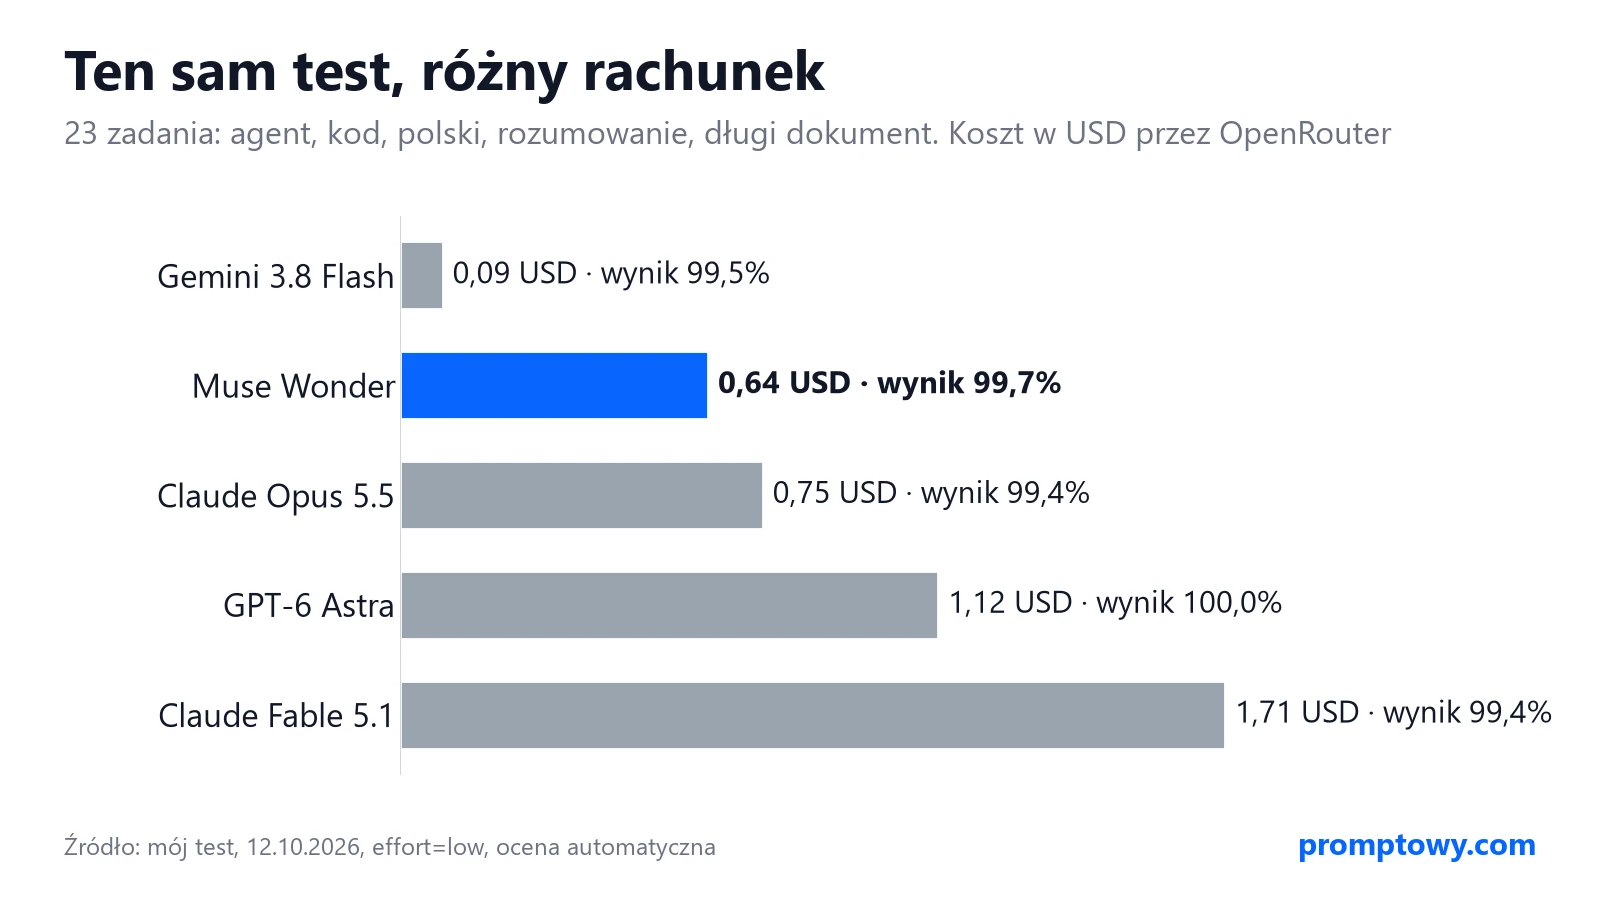
Oprócz testu pisania dałem Muse Wonder, Opusowi 5.5, Fable 5.1, GPT-6 Astra i Gemini 3.8 Flash te same 23 zadania z oceną automatyczną: agent z narzędziami, kod sprawdzany testami, polskie pisma, rozumowanie i długi dokument. Wszystkie modele zrobiły 99-100%, a różnice wyszły w koszcie i czasie:
- Muse Wonder: 99,7%, 0,64 USD, 165 s - drugi najtańszy i drugi najszybszy, jedna wpadka (literówka „trzynadzieście” w kodzie kwoty słownie);
- Claude Opus 5.5: 99,4%, 0,75 USD, 222 s - ta sama cena za token, ale tokenizer Claude’a liczy polski tekst prawie dwa razy drożej (87 675 wobec 46 929 tokenów tego samego dokumentu);
- GPT-6 Astra: 100%, 1,12 USD, 200 s;
- Claude Fable 5.1: 99,4%, 1,71 USD, 263 s;
- Gemini 3.8 Flash: 99,5%, 0,09 USD, 139 s, ale w teście źródeł tylko 7 prawdziwych publikacji na 16 (Muse Wonder 16/16).
Pełne wyniki, wpadki każdego modelu i ograniczenia testu: Muse Wonder vs Opus 5.5 vs GPT-6 Astra: mój test na 23 zadaniach.
Matura AI: 215 na 220 punktów
Muse Wonder rozwiązał też arkusze CKE z maja 2026 w moim teście Matura AI:
| Przedmiot | Muse Wonder | Claude Opus 5.5 | GPT-6.1 Sol | Claude Haiku 5.5 |
|---|---|---|---|---|
| Matematyka podstawowa | 50/50 | 50/50 | 50/50 | 50/50 |
| Matematyka rozszerzona | 49/50 | 50/50 | 50/50 | 50/50 |
| Polski podstawowy (testy i notatka/wypracowanie) | 56/60 | 60/60 | 60/60 | 56/60 |
| Angielski podstawowy | 60/60 | 60/60 | 60/60 | 59/60 |
| Razem | 215/220 | 220/220 | 220/220 | 215/220 |
| Koszt | 1,54 USD | 1,13 USD | 0,32 USD | 0,04 USD |
Maturę zdałby bez problemu, ale nie jest tu liderem. Wszystkie 4 stracone punkty z polskiego to notatka syntetyzująca: zamiast zestawić stanowiska dwóch autorów, wypisał wady i zalety nośników, za co zasady CKE dają 0 punktów - tak samo jak 7 innym modelom. Jeden punkt stracił w zadaniu z rozszerzonej matematyki. Był najdroższy w stawce.
Porównanie z rywalami
| Model | Indeks AA | Mój test po polsku | Cena API USD | Dostęp w Polsce |
|---|---|---|---|---|
| Muse Wonder | 52 | 87,0 | 4 / 20 | OpenRouter, API Mety, Muse Code |
| Muse Wonder Full | 56 | nie testowałem (brak API) | - | tylko Muse Code od 50 USD/mies. |
| Claude Opus 5.5 | 58 | 90,1 | 4 / 20 | Claude.ai, API, OpenRouter |
| Claude Fable 5.1 | 53 | 83,9 | 10 / 50 | Claude.ai, API, OpenRouter |
| GPT-6 Astra | 53 | 85,3 | 10 / 50 | ChatGPT, API, OpenRouter |
| Gemini 4 Argon | 53 | nie testowałem | 2 / 10 na start (Google) | ograniczony, szczegóły w hubie |
Wnioski:
- Wonder kontra Opus 5.5: ta sama cena, Opus wyżej w AA (58 do 52) i w moim teście (90,1 do 87,0). Wonder wygrywa tylko w testach Mety, a tam porównywany był Full.
- Wonder kontra Fable 5.1 i Astra: 2,5 raza taniej, w moim teście po polsku lepiej (87,0 wobec 83,9 i 85,3), w AA o 1 pkt niżej.
- Full ma dopiero sens dla programistów, którzy i tak płacą za Muse Code. To najmocniejszy model Mety, ale nie kupisz go na tokeny.
Bezpieczeństwo
W karcie modelu Meta pisze, że bez zabezpieczeń nie wyklucza przekroczenia progu wysokiego ryzyka w dziedzinie broni chemicznej i biologicznej, dlatego dodała trening bezpieczeństwa i klasyfikatory. Po zabezpieczeniach ocenia ryzyko we wszystkich obszarach jako „umiarkowane lub niższe”. W teście Agentic Misalignment (czy agent szkodzi, żeby uniknąć wyłączenia) Full ma 0%, w teście uczciwości MASK 87,3%. Pełny raport bezpieczeństwa ma wyjść później. Meta ma za sobą głośne wpadki agentów - pisałem o tym, jak agent Muse podał adres domowy użytkownika.
Dla kogo
- Programiści i firmy budujące agentów - jeśli testy Mety w długich zadaniach (DeepSWE, SWE-Marathon, AutomationBench) potwierdzą się w praktyce, to model do sprawdzenia obok Opusa 5.5.
- Osoby piszące po polsku przez API - 87 pkt w moim teście, tańszy od Fable 5.1 i Astry przy lepszym wyniku.
- Nie dla zwykłych użytkowników w Polsce - na razie nie ma go w Meta AI w WhatsAppie ani w aplikacji Muse.
- Nie, jeśli liczysz każdy grosz - GPT-6.1 Sol kosztuje połowę i ma w AA tyle samo punktów (52), a Claude Sonnet 5.5 za tę samą połowę ceny ma 56.
Teksty o Muse Wonder
- Meta pokazała Muse Wonder - news z dnia premiery
- Muse Wonder po polsku - pełny test z fragmentami odpowiedzi
- Mój test na 23 zadaniach - agent, kod, polski, koszty i zmyślone źródła
- Jak używać Muse Wonder w Polsce - OpenRouter, API Mety i Muse Code, gotowy skrypt
- Muse Wonder vs Claude Opus 5.5, Fable 5.1 i GPT-6 Astra - 14 testów obok siebie
Najczęstsze pytania
Czym jest Muse Wonder?
To rodzina zamkniętych modeli językowych Mety z 12 października 2026: Muse Wonder i Muse Wonder Full. Następca Muse Spark, trenowany pod zadania agentowe, programowanie i pamięć długich rozmów.
Ile kosztuje Muse Wonder?
W API 4 USD za milion tokenów wejścia i 20 USD za milion wyjścia, 0,20 USD za wejście z pamięci podręcznej. Wonder Full jest tylko w Muse Code, w planach za 50 i 200 USD miesięcznie.
Czy Muse Wonder działa w Polsce?
Przez OpenRouter tak, sprawdziłem to 12 października. API Mety nie publikuje listy krajów. Aplikacja Muse i Meta AI z nowym modelem w Polsce nie działają.
Czy Muse Wonder jest lepszy od Claude Opus 5.5?
Zwykły Wonder nie: ma 52 pkt w indeksie AA wobec 58 Opusa i 87,0 wobec 90,1 w moim teście po polsku. Wonder Full wygrywa z Opusem w części testów Mety, ale w AA jest za nim (56).
Czy Muse Wonder dobrze pisze po polsku?
Tak. 87,0 pkt na 100 w moim teście 13 zadań, 2. miejsce w rankingu. Słabo wypadł tylko opis produktu, w którym powtórzył te same parametry.
Czy Muse Wonder jest open source?
Nie. Wagi są zamknięte i Meta nie zapowiedziała otwartej wersji. Otwarte modele Mety to nadal Llama i Muse Glimmer.
Czy Muse Wonder jest w WhatsAppie?
Jeszcze nie. Meta pisze, że model „wkrótce” trafi do innych produktów, najpierw do subskrybentów aplikacji Muse w USA. Daty dla UE nie ma.
Czym różni się Muse Wonder od Muse Wonder Full?
Full jest mocniejszy (56 wobec 52 pkt w AA, wyżej w prawie każdym teście Mety), ale dostępny tylko w Muse Code w droższych planach. Zwykły Wonder jest w API i na OpenRouterze.
Źródła i data sprawdzenia
Meta
- Meta AI Research: Muse Wonder (12.10.2026)
- Karta modelu Muse Wonder (PDF)
- Cennik i limity Meta Model API
- Plany Muse Code
- Mark Zuckerberg na X: ogłoszenie
- Mark Zuckerberg na X: dostępność
- AI at Meta na X
Niezależne
- Artificial Analysis: Muse Wonder Full
- Artificial Analysis: Muse Wonder
- Artificial Analysis: ranking modeli
- OpenRouter: meta/muse-wonder
- CNBC: Muse Wonder i subskrypcje
Moje pomiary
- Test 13 zadań po polsku przez OpenRouter, 12.10.2026 (metoda: Laboratorium Promptowe)
- Matura AI, arkusze CKE z maja 2026, 12.10.2026
Sprawdzone 12 października 2026, wieczorem.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym