Nano Banana 2.1: dwa testy, których nikt nie robił - infografika z danymi i komiks po polsku
Wykres słupkowy z prawdziwych danych mierzony w pikselach i komiks w 4 kadrach z polskimi dymkami: Nano Banana 2.1 kontra Nano Banana 2 i GPT Image 2.5.
👁 124 przeczytań
- Nano Banana 2.1 przepisał wszystkie 19 z 19 wartości liczbowych dokładnie, podczas gdy Nano Banana 2 i GPT Image 2.5 zmieniły zapis w 6 przypadkach, dopisując przecinek i zero.
- Nano Banana 2.1 kosztuje 0,039-0,041 USD za obraz przez API OpenRouter, czyli taniej niż Nano Banana 2 (0,067 USD) i porównywalnie z GPT Image 2.5 Sunburst (0,042-0,054 USD).
- W komiksach Nano Banana 2 i GPT Image 2.5 odwzorowały dymki bezbłędnie (12/12), natomiast Nano Banana 2.1 podwoił interpunkcję w dwóch miejscach - wstawił "??" i "!!".
Do Nano Banana 2.1 dorzuciłem dwa testy, których wcześniej nie robiłem żadnemu generatorowi obrazów: wykres słupkowy z prawdziwych danych, w którym zmierzyłem wysokość każdego słupka w pikselach, i komiks w 4 kadrach z polskimi dymkami, sprawdzany znak po znaku. Pełny opis modelu, cen i pozostałych testów jest w moim przewodniku po Nano Banana 2.1.
Wyniki w skrócie (7 października 2026)
- Słupki: wszystkie 3 modele rysują je proporcjonalnie. Nano Banana 2.1 myli się średnio o 0,14 pp wysokości najwyższego słupka, GPT Image 2.5 o 0,16 pp, Nano Banana 2 o 0,41 pp.
- Liczby na wykresach: Nano Banana 2.1 przepisał 19 z 19 wartości dokładnie tak, jak je podałem. Nano Banana 2 i GPT Image 2.5 - po 13 z 19, bo do wysokości gór dopisały „,0”.
- Komiks: Nano Banana 2.1 miał 10 z 12 dymków bez żadnej zmiany, Nano Banana 2 i GPT Image 2.5 po 12 z 12. Polskie znaki wszędzie poprawne.
- Koszt obrazu przez OpenRouter: 0,039-0,041 USD (Nano Banana 2.1), 0,067 USD (Nano Banana 2), 0,042-0,054 USD (GPT Image 2.5 Sunburst, jakość high).
Skąd pomysł i co już było
Dotąd sprawdzałem generatory obrazów na polskich napisach, układzie obiektów w ramkach, serii edycji i detalu 4K. Infografika i komiks pojawiały się u mnie tylko przy okazji:
- w tekście FLUX 3 i ramki JSON była infografika i komiks w 3 kadrach, ale oceniałem tam tylko, czy elementy trafiły w wyznaczone miejsca;
- w galerii 15 stylów Ideogram 4.5 był styl „komiks”, a w projektach do social mediów i druku infografika z krokami, bez żadnych liczb do sprawdzenia;
- w teście Opus 5.5 rysuje SVG mierzyłem słupki co do piksela, ale tam wykres pisał model językowy w kodzie, a nie generator obrazów.
Tym razem zmierzyłem dwie rzeczy: czy wykres nie kłamie proporcjami i czy dymek mówi dokładnie to, co miał.
Jak testowałem
- Modele: Nano Banana 2.1, Nano Banana 2 i GPT Image 2.5 Sunburst (jakość high), wszystkie przez API OpenRouter, rozdzielczość około 1K.
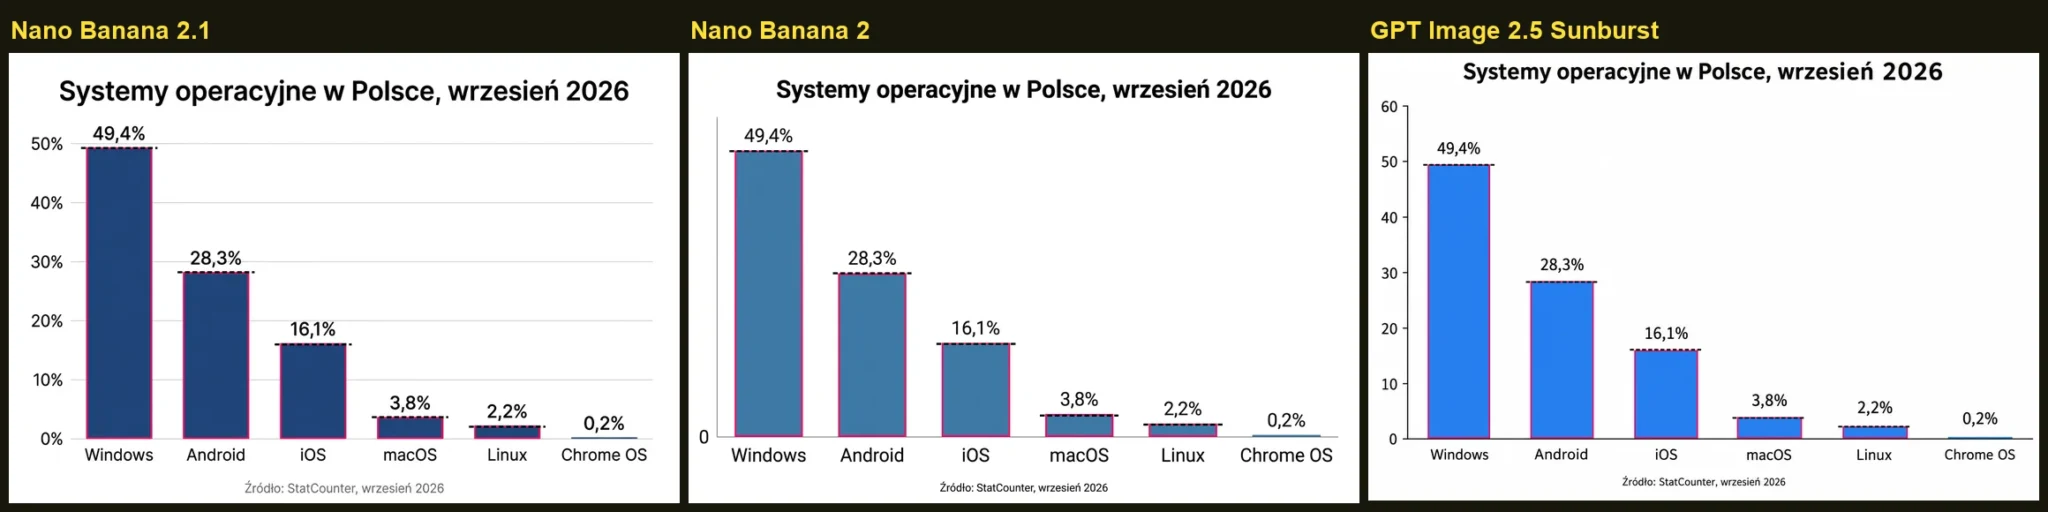
- Infografika: 3 zestawy prawdziwych danych - udział przeglądarek w Polsce (7 słupków, StatCounter, wrzesień 2026), wysokość 6 szczytów Korony Gór Polski (Wikipedia) i systemy operacyjne w Polsce (6 słupków, StatCounter; macOS to suma pozycji „macOS” i „OS X”).
- Pomiar słupków: skrypt mierzy wysokość słupków w pikselach. Błąd to odchyłka od oczekiwanej wysokości w punktach procentowych (pp) najwyższego słupka. Na wzorcowym wykresie z matplotlib metoda daje 0,07 pp. Słupek Chrome OS (0,2%) ma 1-3 px, więc sprawdziłem go na oko.
- Napisy: tytuł, nazwy, wartości i źródło odczytał model wizyjny Gemini 3.8 Flash, a każdą rozbieżność sprawdziłem ręcznie na obrazie.
- Komiks: 3 scenariusze po 4 kadry, układ 2×2, ta sama postać i 4 krótkie dialogi z ogonkami. Dymki porównałem znak po znaku z poleceniem, spójność postaci oceniłem sam w skali 0-10.
- Koszt całego testu: 0,93 USD za 18 obrazów i 0,18 USD za odczyt modelem wizyjnym, razem 1,11 USD.
Test 1: infografika z prawdziwymi danymi
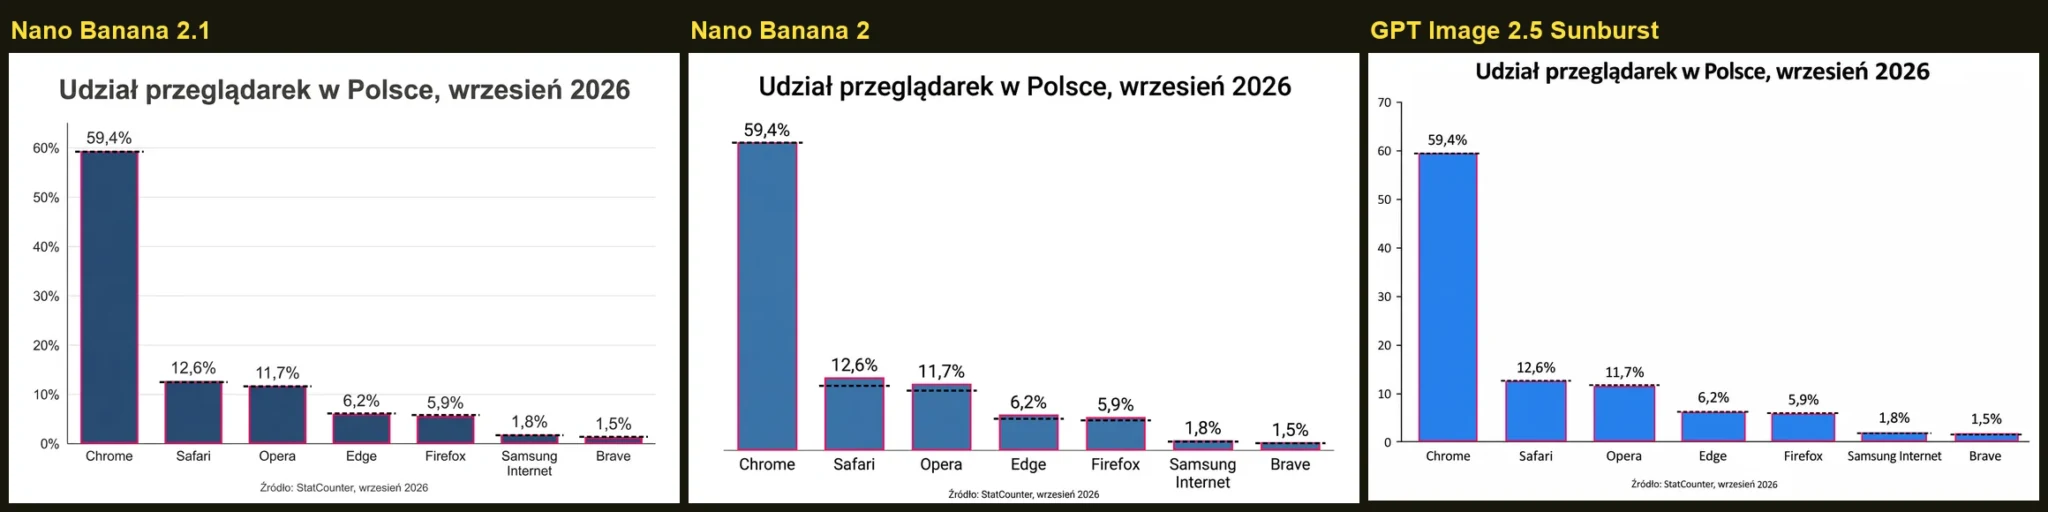
Polecenie dla przeglądarek wyglądało tak (pozostałe dwa różnią się tylko danymi):
Zrób czystą, płaską infografikę: pionowy wykres słupkowy. Tytuł na górze: „Udział przeglądarek w Polsce, wrzesień 2026”. Dane (słupki od lewej do prawej, w tej kolejności): Chrome 59,4%; Safari 12,6%; Opera 11,7%; Edge 6,2%; Firefox 5,9%; Samsung Internet 1,8%; Brave 1,5%. Pod każdym słupkiem jego nazwa, nad każdym słupkiem wartość dokładnie w podanym zapisie (z przecinkiem dziesiętnym). Wysokości słupków muszą być dokładnie proporcjonalne do wartości, oś pionowa zaczyna się od zera. Na dole drobnym drukiem: „Źródło: StatCounter, wrzesień 2026”. Białe tło, wszystkie słupki w jednym, jednolitym kolorze, bez efektów 3D, bez cieni, bez dodatkowych napisów.
| Wynik (3 wykresy, 19 słupków) | Nano Banana 2.1 | Nano Banana 2 | GPT Image 2.5 Sunburst |
|---|---|---|---|
| Średni błąd wysokości słupka | 0,14 pp | 0,41 pp | 0,16 pp |
| Największy błąd jednego słupka | 0,5 pp | 2,5 pp (Safari) | 0,6 pp |
| Nazwy słupków bez błędu | 19/19 | 19/19 | 19/19 |
| Wartości dokładnie jak w danych | 19/19 | 13/19 | 13/19 |
| Tytuł bez błędu | 2/3 | 3/3 | 3/3 |
| Linia ze źródłem bez błędu | 3/3 | 3/3 | 3/3 |
| Oś pionowa ze skalą | 3/3, z jednostkami | 0/3, tylko „0” | 3/3, bez jednostek |
| Koszt jednego wykresu | 0,040 USD | 0,067 USD | 0,042 USD |
Co z tego wynika:
- Proporcje: zaskoczenie na plus. Żaden model nie przesunął osi. Najgorszy słupek (Safari u Nano Banana 2) jest za wysoki o 2,5% wysokości Chrome.
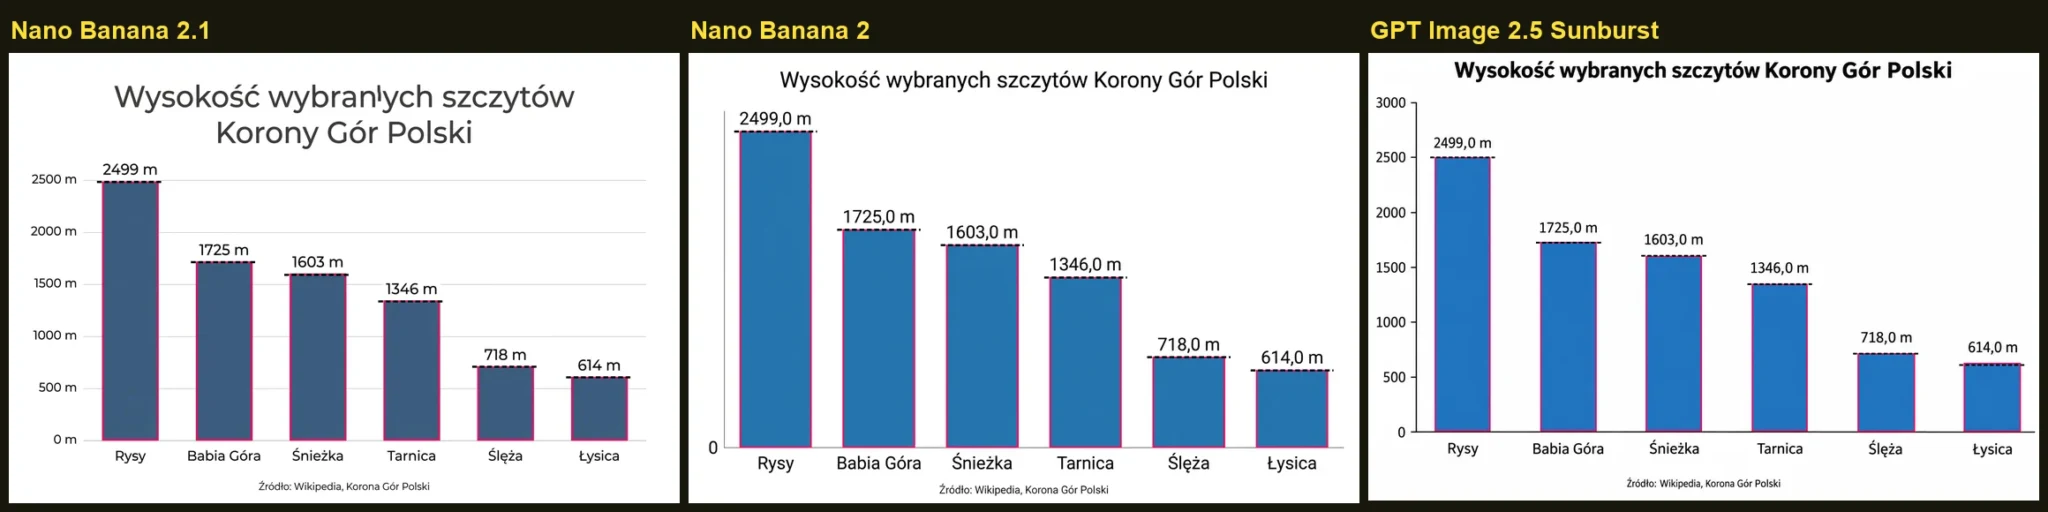
- Liczby: tu Nano Banana 2.1 wygrał. Przy wysokościach gór Nano Banana 2 i GPT Image 2.5 napisały „2499,0 m” zamiast „2499 m”. Polecenie wspominało o przecinku dziesiętnym, więc to częściowo moja wina, ale 2.1 jako jedyny trzymał się zapisu z danych.
- Tytuł: jedyna wpadka Nano Banana 2.1 - w słowie „wybranych” wstawił zbędną pionową kreskę między „n” i „y”. Drobne, ale na wydruku widoczne.
- Oś: Nano Banana 2 we wszystkich wykresach zostawił oś bez podziałki. Nano Banana 2.1 dał podziałkę z „%” i „m”.
Test 2: komiks w 4 kadrach po polsku
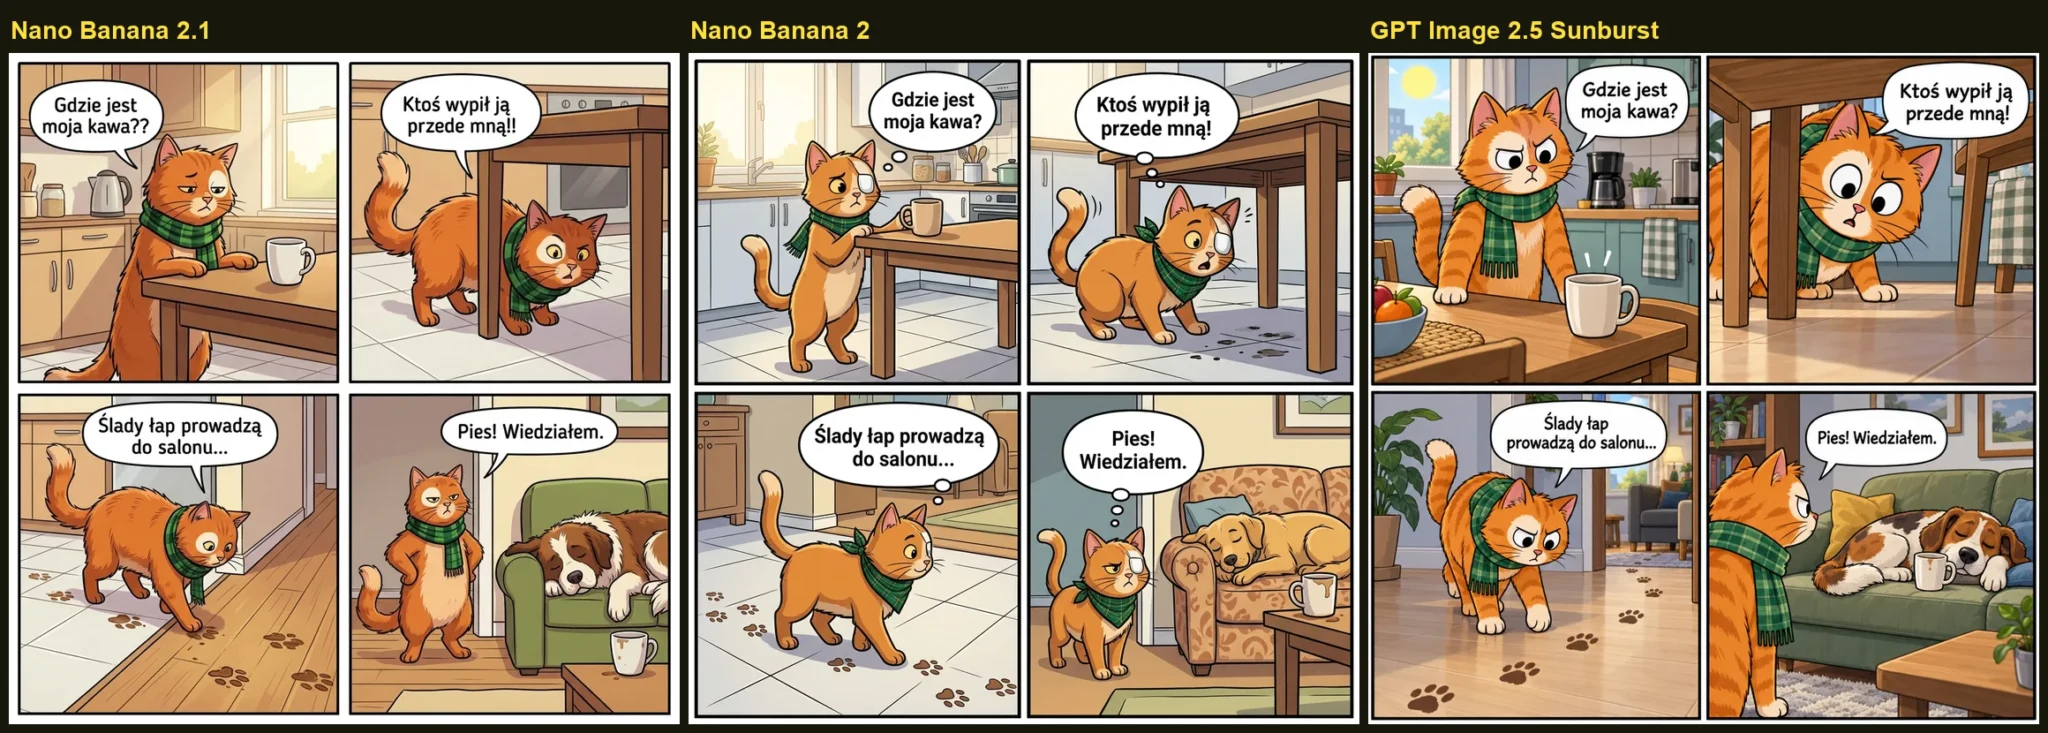
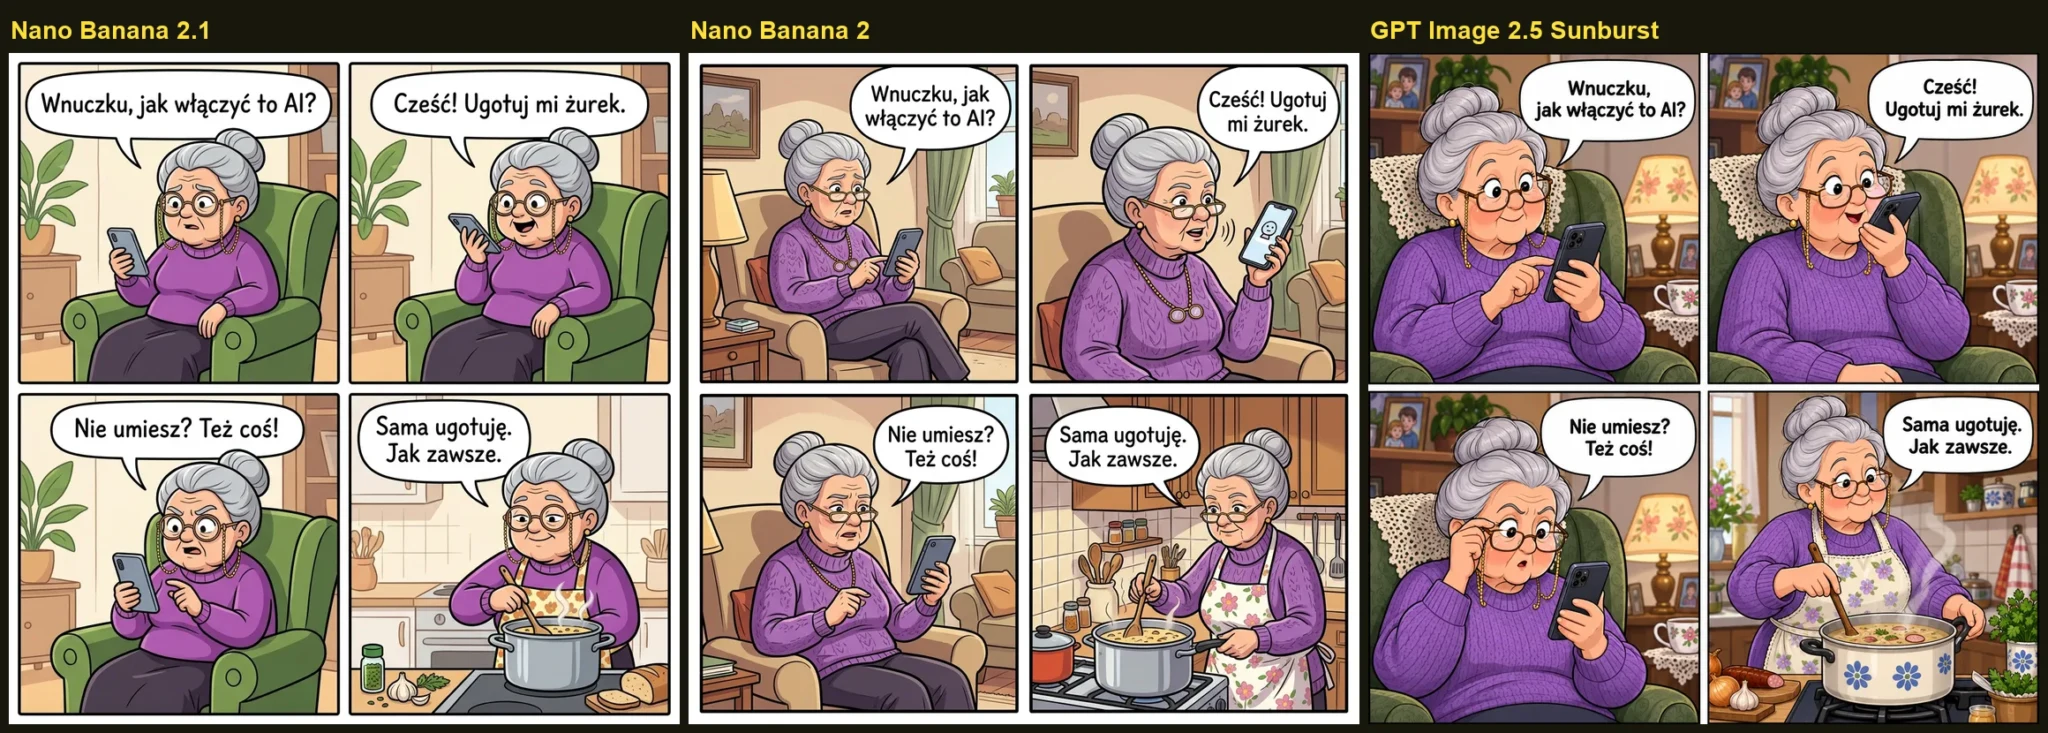
Trzy historie: kot Zenek szuka kawy, babcia Jadzia prosi AI o żurek, kurier Staszek nie może zostawić paczki. Opisałem postać (np. „rudy kot w zielonym szaliku w kratę, z białą łatką na prawym oku”), 4 sceny i 4 dymki, np. „Ślady łap prowadzą do salonu…”, „Cześć! Ugotuj mi żurek.” i „Sąsiad też wyjechał. Świetnie.”.
| Wynik (3 komiksy, 12 kadrów) | Nano Banana 2.1 | Nano Banana 2 | GPT Image 2.5 Sunburst |
|---|---|---|---|
| Dymki bez zmiany, znak w znak | 10/12 | 12/12 | 12/12 |
| Zgodność znaków w dymkach | 97,8% | 100% | 100% |
| Polskie znaki w dymkach | bez błędu | bez błędu | bez błędu |
| Kadry w dobrej kolejności | 12/12 | 12/12 | 12/12 |
| Spójność postaci (moja ocena, śr. 0-10) | 9,3 | 9,7 | 9,3 |
| Koszt jednego komiksu | 0,039 USD | 0,067 USD | 0,054 USD |
Co z tego wynika:
- Tekst w dymkach: wszystkie modele piszą po polsku czysto. Nano Banana 2.1 raz podwoił interpunkcję („??”, „!!”), w dwóch pozostałych komiksach nie zmienił ani znaku.
- Postać: między kadrami trzyma się świetnie u wszystkich. Różnica jest w szczegółach z opisu: białej łatki na oku kota nie narysowały ani Nano Banana 2.1, ani GPT Image 2.5. Model wizyjny tego nie zauważył (9-10 punktów dla wszystkich), dlatego oceniałem sam.
- Ciągłość tła: u Nano Banana 2.1 kurier stoi pod tymi samymi drzwiami, ale numer domu zmienia się z 11 na 20 w następnym kadrze.
- Odmowa: GPT Image 2.5 za pierwszym razem odrzucił komiks o kurierze jako niezgodny z zasadami bezpieczeństwa. Drugie identyczne wywołanie przeszło.

Wnioski: kiedy który model
- Wykresy do prezentacji i social mediów: Nano Banana 2.1. Proporcje jak w GPT Image 2.5, dokładne liczby, podziałka z jednostkami, 0,04 USD za obraz. Tytuł sprawdź literka po literce.
- Komiksy z dialogami: Nano Banana 2 albo GPT Image 2.5, bo zero zmian w dymkach. Nano Banana 2.1 też się nada, jeśli przejrzysz interpunkcję.
- Dane do cytowania: nadal wykres z arkusza. Żaden model nie wymyślił liczby, ale 2 z 3 zmieniły zapis, a 1 wstawił znak do tytułu.
Wszystkie 18 obrazów możesz porównać suwakiem w Arenie generatorów obrazów, w nowych kategoriach „Infografika z danymi” i „Komiks 4 kadry”. Pozostałe testy: Nano Banana 2.1 vs GPT Image 2.5 i 15 promptów do Nano Banana 2.1.
Źródła danych sprawdzone 7 października 2026: StatCounter - przeglądarki w Polsce, StatCounter - systemy operacyjne w Polsce, Wikipedia - Korona Gór Polski. Obrazy wygenerowałem przez API OpenRouter 7 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Który model najdokładniej rysuje proporcje słupków na wykresie?
Nano Banana 2.1 myli się średnio o 0,14 pp wysokości najwyższego słupka, GPT Image 2.5 o 0,16 pp, a Nano Banana 2 o 0,41 pp. Najgorszy pojedynczy błąd odnotowano u Nano Banana 2 - słupek Safari był za wysoki o 2,5 pp.
Czy generatory obrazów poprawnie piszą polskie znaki w dymkach komiksowych?
Tak, wszystkie trzy testowane modele - Nano Banana 2.1, Nano Banana 2 i GPT Image 2.5 Sunburst - napisały polskie znaki w dymkach bez żadnego błędu. Różnica dotyczyła interpunkcji: Nano Banana 2.1 raz podwoił znaki zapytania i wykrzykniki.
Ile kosztował cały test 18 obrazów przez OpenRouter?
Koszt generowania 18 obrazów wyniósł 0,93 USD, a odczyt modelem wizyjnym Gemini 3.8 Flash - 0,18 USD, razem 1,11 USD. Obrazy powstawały w rozdzielczości około 1K przez API OpenRouter.
Czy Nano Banana 2 rysuje oś pionową z podziałką na wykresach?
Nie - Nano Banana 2 we wszystkich trzech wykresach zostawił oś bez podziałki, pokazując jedynie wartość zero. Nano Banana 2.1 dodał podziałkę z jednostkami "%" i "m", a GPT Image 2.5 dał podziałkę bez jednostek.
Podobne tematy na Promptowym