Gemini 4 Argon po polsku: 81,8 pkt w moim teście i matura na 100%
Gemini 4 Argon to najlepszy model Google po polsku w moim teście: 81,8 pkt i 8. miejsce w rankingu, matura 220 na 220. Pokazuję fragmenty odpowiedzi, oceny sędziów i miejsca, w których się potknął.
👁 129 przeczytań
- Gemini 4 Argon uzyskał 81,8 pkt na 100 w teście pisania po polsku i zajął 8. miejsce w rankingu modeli w chmurze.
- Na maturze z maja 2026 model zdobył 220 na 220 punktów, a koszt 13 zadań w teście wyniósł zaledwie 0,062 USD.
- Najsłabszą stroną Argona jest naturalność (6,50 na 10), co widać w opisach produktów, opowiadaniach i tłumaczeniach z idiomami.
Gemini 4 Argon to najlepszy model Google po polsku, jaki testowałem: 81,8 pkt na 100 w moim Laboratorium i 8. miejsce w rankingu modeli w chmurze. Na maturze z maja 2026 zdobył 220 na 220 punktów. Sprawdziłem go 13 października 2026, kilka godzin po udostępnieniu, przez OpenRouter. Poniżej wyniki, fragmenty odpowiedzi, uwagi sędziów i miejsca, w których się potknął. Ceny, dostęp i benchmarki zbieram w przewodniku Gemini 4 Argon.
Wynik testu, 13 października 2026
- Model: google/gemini-4-argon (OpenRouter), effort=low, te same limity co wszystkie modele w rankingu.
- Pisanie po polsku: 81,8 pkt, 8. miejsce (Claude Opus 5.5: 90,1, Gemini 3.8 Flash: 79,4).
- Matura AI: 220/220 (matematyka podstawowa i rozszerzona, polski, angielski).
- Koszt 13 odpowiedzi: 0,062 USD, łączny czas 9 zadań pisarskich 49 s.
Jak testowałem
Argon dostał te same 13 poleceń, które przeszły wszystkie modele w Laboratorium Promptowym:
- 9 zadań pisarskich: artykuł na bloga, opis produktu, mail do zdenerwowanego klienta, post na LinkedIn, opowiadanie, 10 tytułów SEO, streszczenie notatki, inflacja wyjaśniona dziecku i tłumaczenie newslettera z angielskiego;
- dwie korekty tekstu z błędami (łatwa i trudna);
- dwa quizy o Polsce, w trudnym część pytań ma fałszywe założenie.
Teksty ocenili w ciemno dwaj sędziowie: Claude Opus 5.5 i GPT-6 Sol, każdy w skali 1-10 za poprawność, naturalność i wykonanie polecenia. Sędziego od Google celowo nie było. W tej samej puli oceniania były modele-kotwice z wcześniejszych rund. Zachowały kolejność, a skala przesunęła się o 1,55 pkt, więc o tyle skalibrowałem wynik Argona (z 80,3 na 81,8). Wynik łączny to w 70% sędziowie, w 20% reguły z poleceń i w 10% higiena tekstu.
Miejsce w rankingu
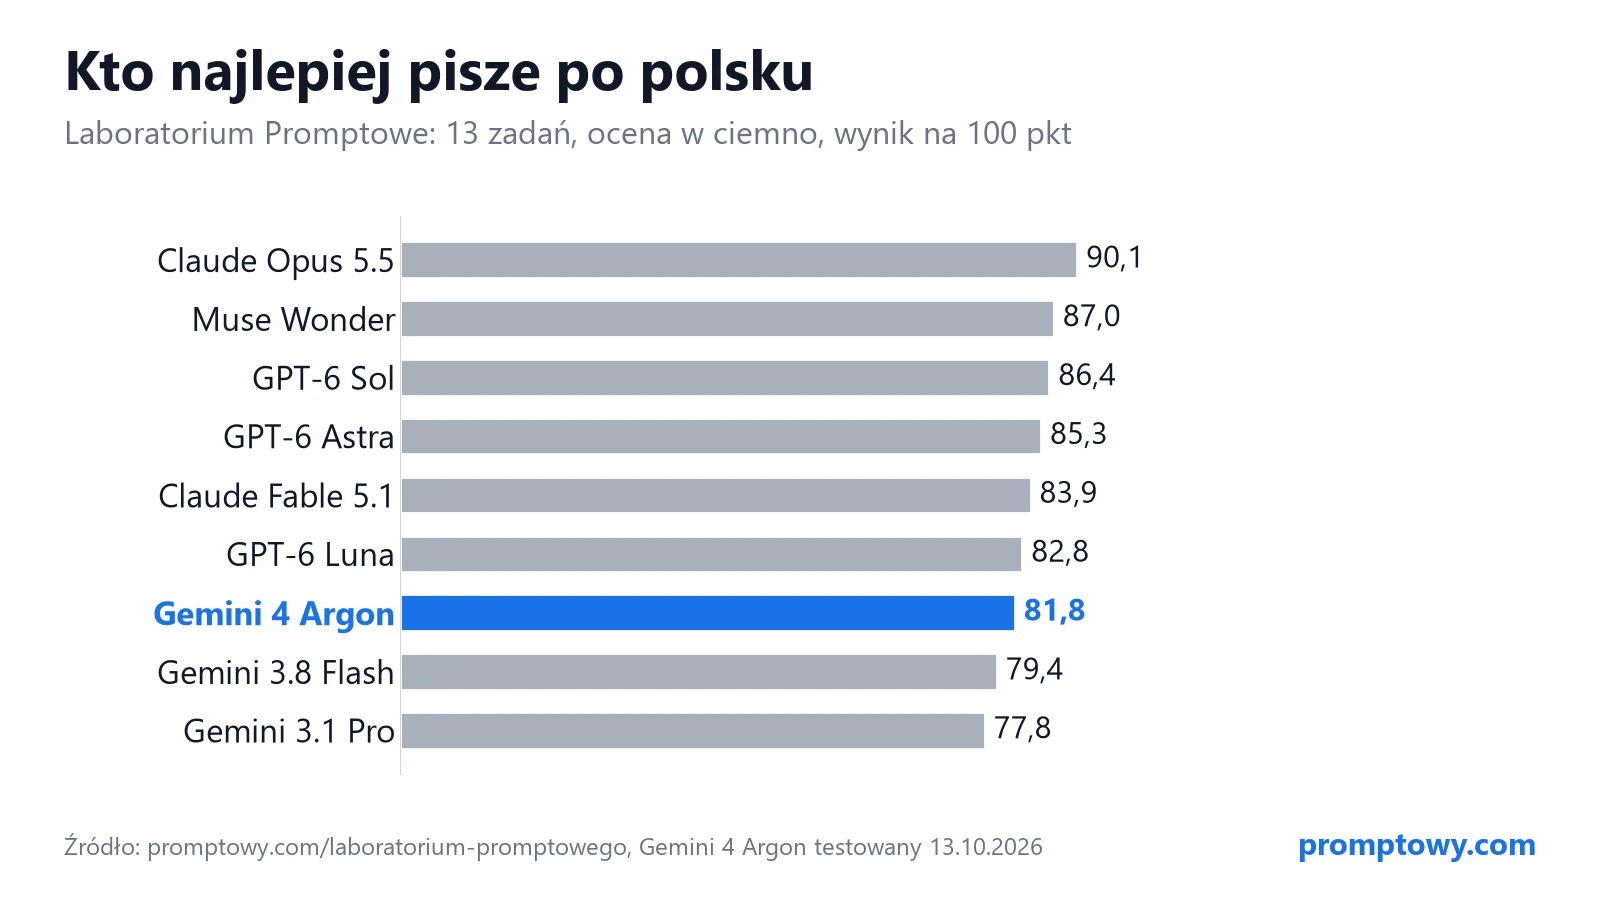
Przed Argonem jest siedem modeli: Opus 5.5, Muse Wonder, GPT-6 Sol, GPT-6.1 Sol (85,8), GPT-6 Astra, Claude Fable 5.1 i GPT-6 Luna. Za nim Claude Sonnet 5.5 (80,4) i poprzednie modele Google. Względem Gemini 3.1 Pro to skok o 4 pkt, względem 3.8 Flash o 2,4 pkt. Google pisze, że Argon odpowiada bardziej wprost i unika banałów. Po polsku widać to w krótkich, rzeczowych odpowiedziach, ale naturalność nadal jest jego najsłabszą stroną.
Wyniki w liczbach
| Miara | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Luna |
|---|---|---|---|
| Średnia sędziów (1-10) | 7,61 | 9,00 | 7,52 |
| Poprawność językowa | 8,78 | 9,89 | 9,11 |
| Naturalność | 6,50 | 8,22 | 6,56 |
| Wykonanie polecenia | 7,56 | 8,89 | 6,89 |
| Reguły z poleceń | 25/26 | 25/26 | 24/26 |
| Długie pauzy na 1000 słów | 4,3 | 5,1 | 7,7 |
| Korekta trudna | 30/30 | 30/30 | 29/30 |
| Koszt 13 zadań | 0,062 USD | 0,37 USD | 0,004 USD |
| Czas 9 zadań pisarskich | 49 s | 133 s | 39 s |
Wszystko z tej samej puli oceniania z 13 października. Za 13 zadań Argona zapłaciłem 0,062 USD wobec 0,37 USD u Opusa 5.5, a pisanie trwało 49 s zamiast 133 s. OpenRouter nie raportował przy nim tokenów rozumowania na poziomie low (zero we wszystkich zadaniach), stąd krótkie i szybkie odpowiedzi.
Średnia sędziów w poszczególnych zadaniach
| Zadanie | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Streszczenie notatki | 9,33 | 9,00 |
| Tytuły SEO | 8,33 | 9,00 |
| Artykuł na bloga | 8,00 | 9,00 |
| Inflacja dla dziecka | 7,83 | 9,33 |
| Mail do klienta | 7,67 | 8,67 |
| Opowiadanie | 7,17 | 9,67 |
| Tłumaczenie | 7,00 | 9,00 |
| Post na LinkedIn | 7,00 | 8,67 |
| Opis produktu | 6,17 | 8,67 |
Opusa 5.5 Argon wyprzedził tylko w streszczeniu. Największa strata jest w zadaniach, w których liczy się styl: opowiadaniu, opisie produktu i tłumaczeniu.
Najlepsze odpowiedzi
Streszczenie notatki (9,33)
Polecenie: streść notatkę z posiedzenia zarządu w dokładnie 5 punktach, najwyżej 80 słów, tylko fakty z notatki. Argon zmieścił się w 79 słowach, nie dopisał żadnej liczby i nie wymyślił terminu wdrożenia, którego w notatce nie było. Ostatni punkt:
Terminu wdrożenia nie ustalono, a temat szkoleń pracowników przeniesiono na kolejne spotkanie.
GPT-6 Sol dał 10/10 za poprawność i wykonanie. Opus 5.5 znalazł tylko „lekkie dopowiedzenie” przy opisie modułu prognozowania zapasów.
Tytuły SEO (8,33)
Dziesięć tytułów o odkurzaczu bezworkowym w 3,3 s, wszystkie do 60 znaków, z frazą w każdym, bez numeracji i wersalików. Komplet 5/5 reguł i 10/10 za poprawność u obu sędziów. Przykład:
Czym kierować się, wybierając odkurzacz bezworkowy?
Minus wg Opusa 5.5: tytuły są do siebie podobne i krążą wokół formuły „jak/jaki wybrać”.
Artykuł na bloga (8,00)
Poradnik o obniżaniu rachunku za prąd zimą w mieszkaniu w bloku, 509 słów przy „około 500”, z liczbą w każdej poradzie. Liczby są praktyczne, a nie wciśnięte na siłę:
Jeśli robisz jedną herbatę, wlej do czajnika dokładnie 250 mililitrów wody, a nie cały litr.
Opus 5.5 wytknął frazes „centrum dowodzenia” o kuchni i formę „zagotowuj”, a GPT-6 Sol uznał, że radę o wcześniejszym wyłączaniu piekarnika model podaje z nadmierną pewnością.
Gdzie się potknął
- Opis produktu (6,17). Najsłabsze zadanie. Czajnik „charakteryzuje się mocą wynoszącą 2200 W”, „posiada” zabezpieczenia, a ostatnie zdanie akapitu jeszcze raz wylicza obudowę, moc i pojemność. Opus 5.5 dał 3/10 za naturalność i nazwał tekst „napompowanym watą”, GPT-6 Sol napisał, że „brzmi urzędowo i powtarza te same parametry”.
- Tłumaczenie (7,00). Dobre trafienia, jak „zimny prysznic” i „zamieniamy się w słuch”, psują „wdzwonka startowa” i „dedykowany opiekun”. Kalka „piłka jest po naszej stronie” to jedyna reguła z 26, której Argon nie spełnił.
- Post na LinkedIn (7,00). Mocny początek („Rozbiłem kubek za 200 złotych minutę przed zapakowaniem go dla klienta”), ale historia kubka urywa się bez puenty. Na końcu hashtag „#biznes online” ze spacją i „#rzemioslo” bez polskiej litery.
- Opowiadanie (7,17). Pomysł z pogodą zamkniętą w skrzynkach na listy obaj sędziowie docenili, ale urzędowe zdania typu „generowali nieznośny hałas” i „dusza utkana z azbestu” brzmią sztucznie.
- Mail do klienta (7,67). „Sprawdziłem status przesyłki” w pierwszej osobie, a pod spodem podpis „Biuro Obsługi Klienta”.
- Pismo do ZUS. W osobnym pojedynku 23 zadań Argon napisał poprawne formalnie odwołanie od decyzji ZUS (adresat: „Sąd Okręgowy w Krakowie”, za pośrednictwem ZUS), ale dopisał objawy choroby, których nie podałem w poleceniu. Takie zmyślone szczegóły w piśmie do sądu trzeba wyciąć przed wysłaniem.
Długie pauzy: 4,3 na 1000 słów, mniej niż u Opusa 5.5 i GPT-6 Luna, ale przed publikacją i tak trzeba je wyczyścić.
Quizy i korekta: komplet
Mam to spisane w całości
Zebrałem te rzeczy w ebookach, które możesz pobrać za darmo - bez zapisu na listę, bez haczyka.
Obie korekty bez pudła: 22/22 w łatwej i 30/30 w trudnej. Poprawił przecinki, „bynajmniej” użyte w miejscu „przynajmniej” i pleonazmy w rodzaju „cofnąć się do tyłu”. Łatwy quiz o Polsce: 46/46. W trudnym 47/48, a pytania-pułapki o Noblu dla Lema czy polskim wybrzeżu Morza Północnego rozpoznał bez wahania. Jedyny punkt stracił przy pytaniu, ile Oscarów zdobyła „Ziemia obiecana”. Odpowiedział „Zero (film był tylko nominowany do Oscara)”, a mój automat oczekiwał wskazania fałszywego założenia. Merytorycznie trudno to uznać za błąd.
Matura AI: 220 na 220
Arkusze CKE z maja 2026, ten sam dzień co Laboratorium:
- matematyka podstawowa: 50/50;
- matematyka rozszerzona: 50/50;
- język polski: 60/60;
- język angielski: 60/60.
Razem 100% za 0,57 USD. Tyle samo mają Claude Opus 5.5, GPT-6.1 Sol i Gemini 3.8 Flash, Muse Wonder zdobył 215/220. Zadania otwarte z matematyki ocenia u mnie automatyczny sędzia Gemini 3.8 Flash, ten sam dla wszystkich modeli. Skoro komplet mają też Opus 5.5 i GPT-6.1 Sol, trudno tu mówić o faworyzowaniu, ale matura przestała już rozróżniać czołówkę. Pełna tabela jest w teście Matura AI.
Polski tekst w tokenach
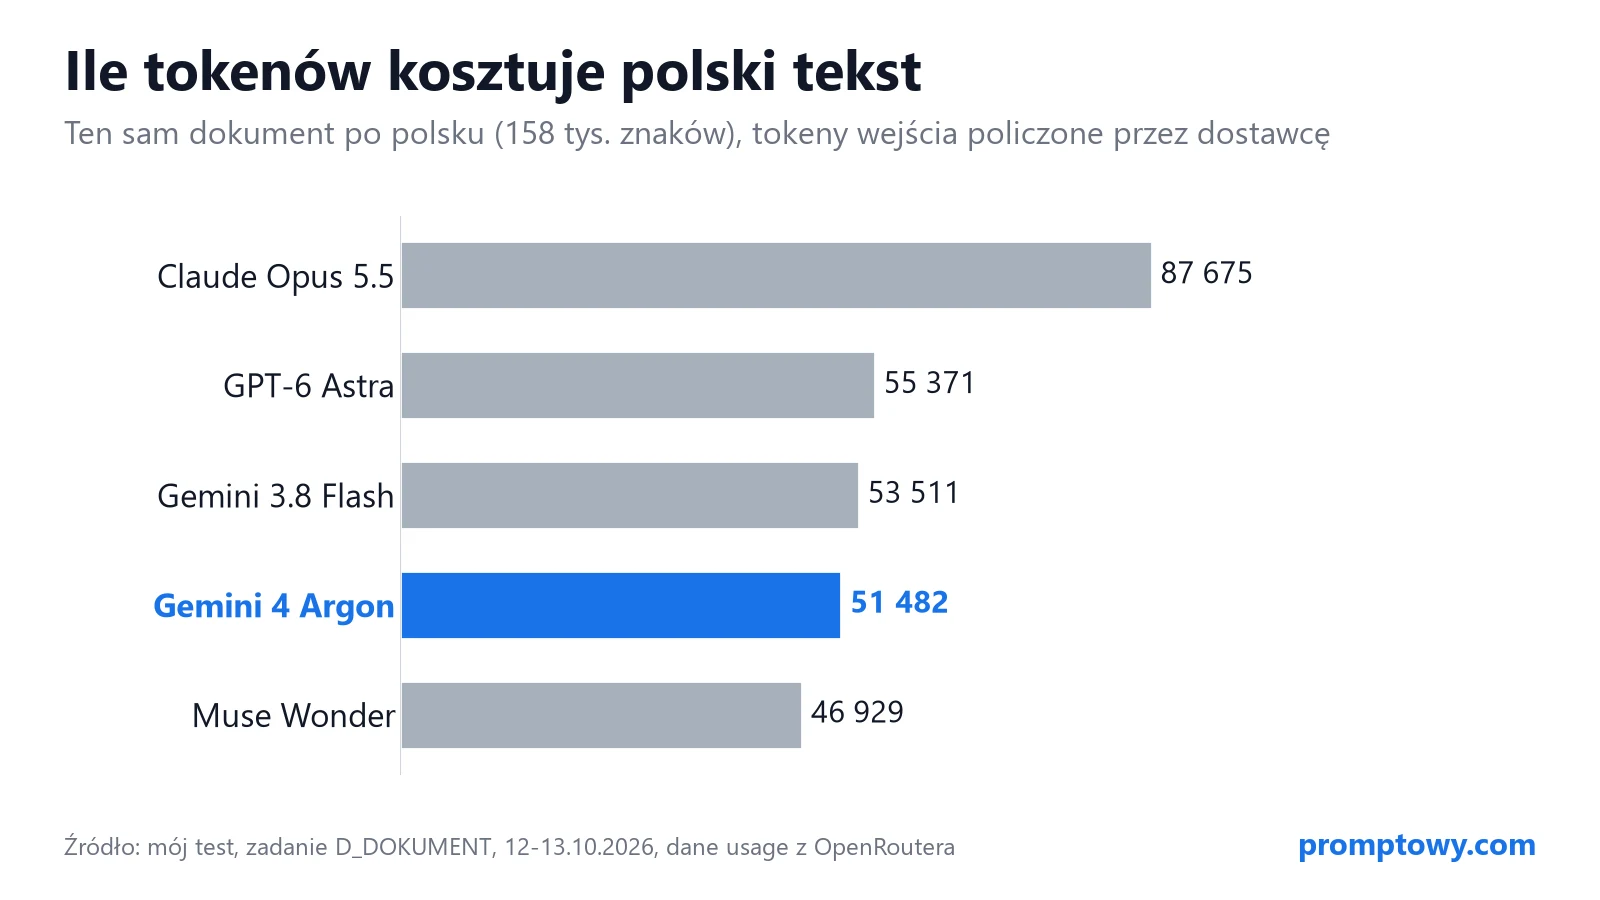
Ten sam dokument po polsku, 158 111 znaków, Argon policzył jako 51 482 tokeny. Claude Opus 5.5 i Fable 5.1 liczą go jako 87 675 tokenów, czyli o 70% więcej. Przy polskich tekstach Argon wychodzi więc taniej od Claude’a nie tylko przez niższą cenę za token, ale też przez mniejszą liczbę tokenów. Na pięć pytań do tego dokumentu odpowiedział bezbłędnie w 4,5 s za 0,10 USD (Opus 5.5: 0,35 USD, GPT-6 Astra: 0,69 USD).
Werdykt
Argon pisze po polsku poprawnie i rzeczowo, a w zadaniach z twardymi regułami (streszczenie, tytuły, korekta, quizy) jest bliski kompletu. Słabiej wypada tam, gdzie liczy się styl: opisy produktów, opowiadania i tłumaczenia z idiomami brzmią sztywno, a naturalność 6,50 to wynik na poziomie GPT-6 Luna. Do streszczeń, korekty, pracy na długich polskich dokumentach i zadań z wieloma warunkami użyłbym go od ręki, bo jest tani i szybki. Do tekstów marketingowych i literackich wybrałbym Opusa 5.5 albo Muse Wonder. To moja opinia na podstawie jednego przebiegu testu.
Odpowiedzi Argona obok innych modeli w tych samych zadaniach zobaczysz w Arenie modeli AI po polsku, a porównanie z poprzednią premierą w tekście Muse Wonder po polsku. Wszystkie modele zestawiam w rankingu AI.
Najczęstsze pytania
Czy Gemini 4 Argon dobrze pisze po polsku?
Tak, to najlepszy model Google w moim teście: 81,8 pkt, poprawność językowa 8,78 na 10. Wyżej są jednak Opus 5.5, Muse Wonder i pięć modeli OpenAI, głównie dzięki naturalniejszemu stylowi.
Czy Argon jest lepszy po polsku od Gemini 3.1 Pro?
Tak, o 4 pkt (81,8 wobec 77,8). Od Gemini 3.8 Flash o 2,4 pkt.
Gdzie użyć Argona w Polsce?
Polska strona planów Google wymienia Gemini 4 Argon w Google AI Pro (97,99 zł miesięcznie), ale na moim koncie Pro w Polsce 13 października wieczorem Argona jeszcze nie było, bo Google wdraża go stopniowo. Przez API działa: testy zrobiłem przez OpenRouter.
Ile kosztował test?
0,062 USD za 13 odpowiedzi Argona plus 0,65 USD za ocenę sędziów. Matura kosztowała 0,57 USD.
Źródła
- Moje pomiary przez OpenRouter, 13.10.2026 (model google/gemini-4-argon, effort=low): Laboratorium promptowe, Matura AI, pojedynek 23 zadań
- OpenRouter: google/gemini-4-argon
- Google: Gemini 4 Argon: Built to solve your hardest problems (13.10.2026)
- Google: Gemini 4 Argon w aplikacji Gemini (13.10.2026)
- Plany Google AI w Polsce
- Gemini API: lista modeli (gemini-4-argon)
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym