MAGI-2 Preview: otwarty model wideo Sand.ai - ranking i wymagania
Otwarty model wideo Sand.ai: miejsce w rankingu Artificial Analysis, parametry, wagi 307 GB na Apache-2.0, sprzęt, dostępność API i jak go uruchomić.
👁 115 przeczytań
Strona aktualizowana na bieżąco. Stan na 11 października 2026.
MAGI-2 Preview to otwarty model wideo pekińskiej firmy Sand.ai: 114 mld parametrów, z czego na jeden token pracuje ok. 6 mld, klipy po 10 sekund w 1080p z dźwiękiem, licencja Apache-2.0. W rankingu obrazu na wideo Artificial Analysis jest 10. (1093 punkty Elo), czyli najwyżej po MiniMax H3 wśród modeli z publicznymi wagami. Haczyk: do uruchomienia trzeba 8 kart NVIDIA Hopper po 80 GB, a API z ceną jeszcze nie ma.
Stan na 11 października 2026
- Premiera: 5 sierpnia 2026, raport techniczny Sand.ai, wagi na Hugging Face od 3-5 sierpnia.
- Status: „Preview”, producent sam nazywa go pośrednim wydaniem badawczym. Od 6 sierpnia w repozytorium kodu nie było nowych zmian.
- Ranking: 10. miejsce w AA-Video-I2V v1.0 (1093 Elo, przedział 1086-1100, 11 895 porównań). W tekście na wideo jest tylko wersja „0912” bez publicznych wag: 21. miejsce, 960 Elo.
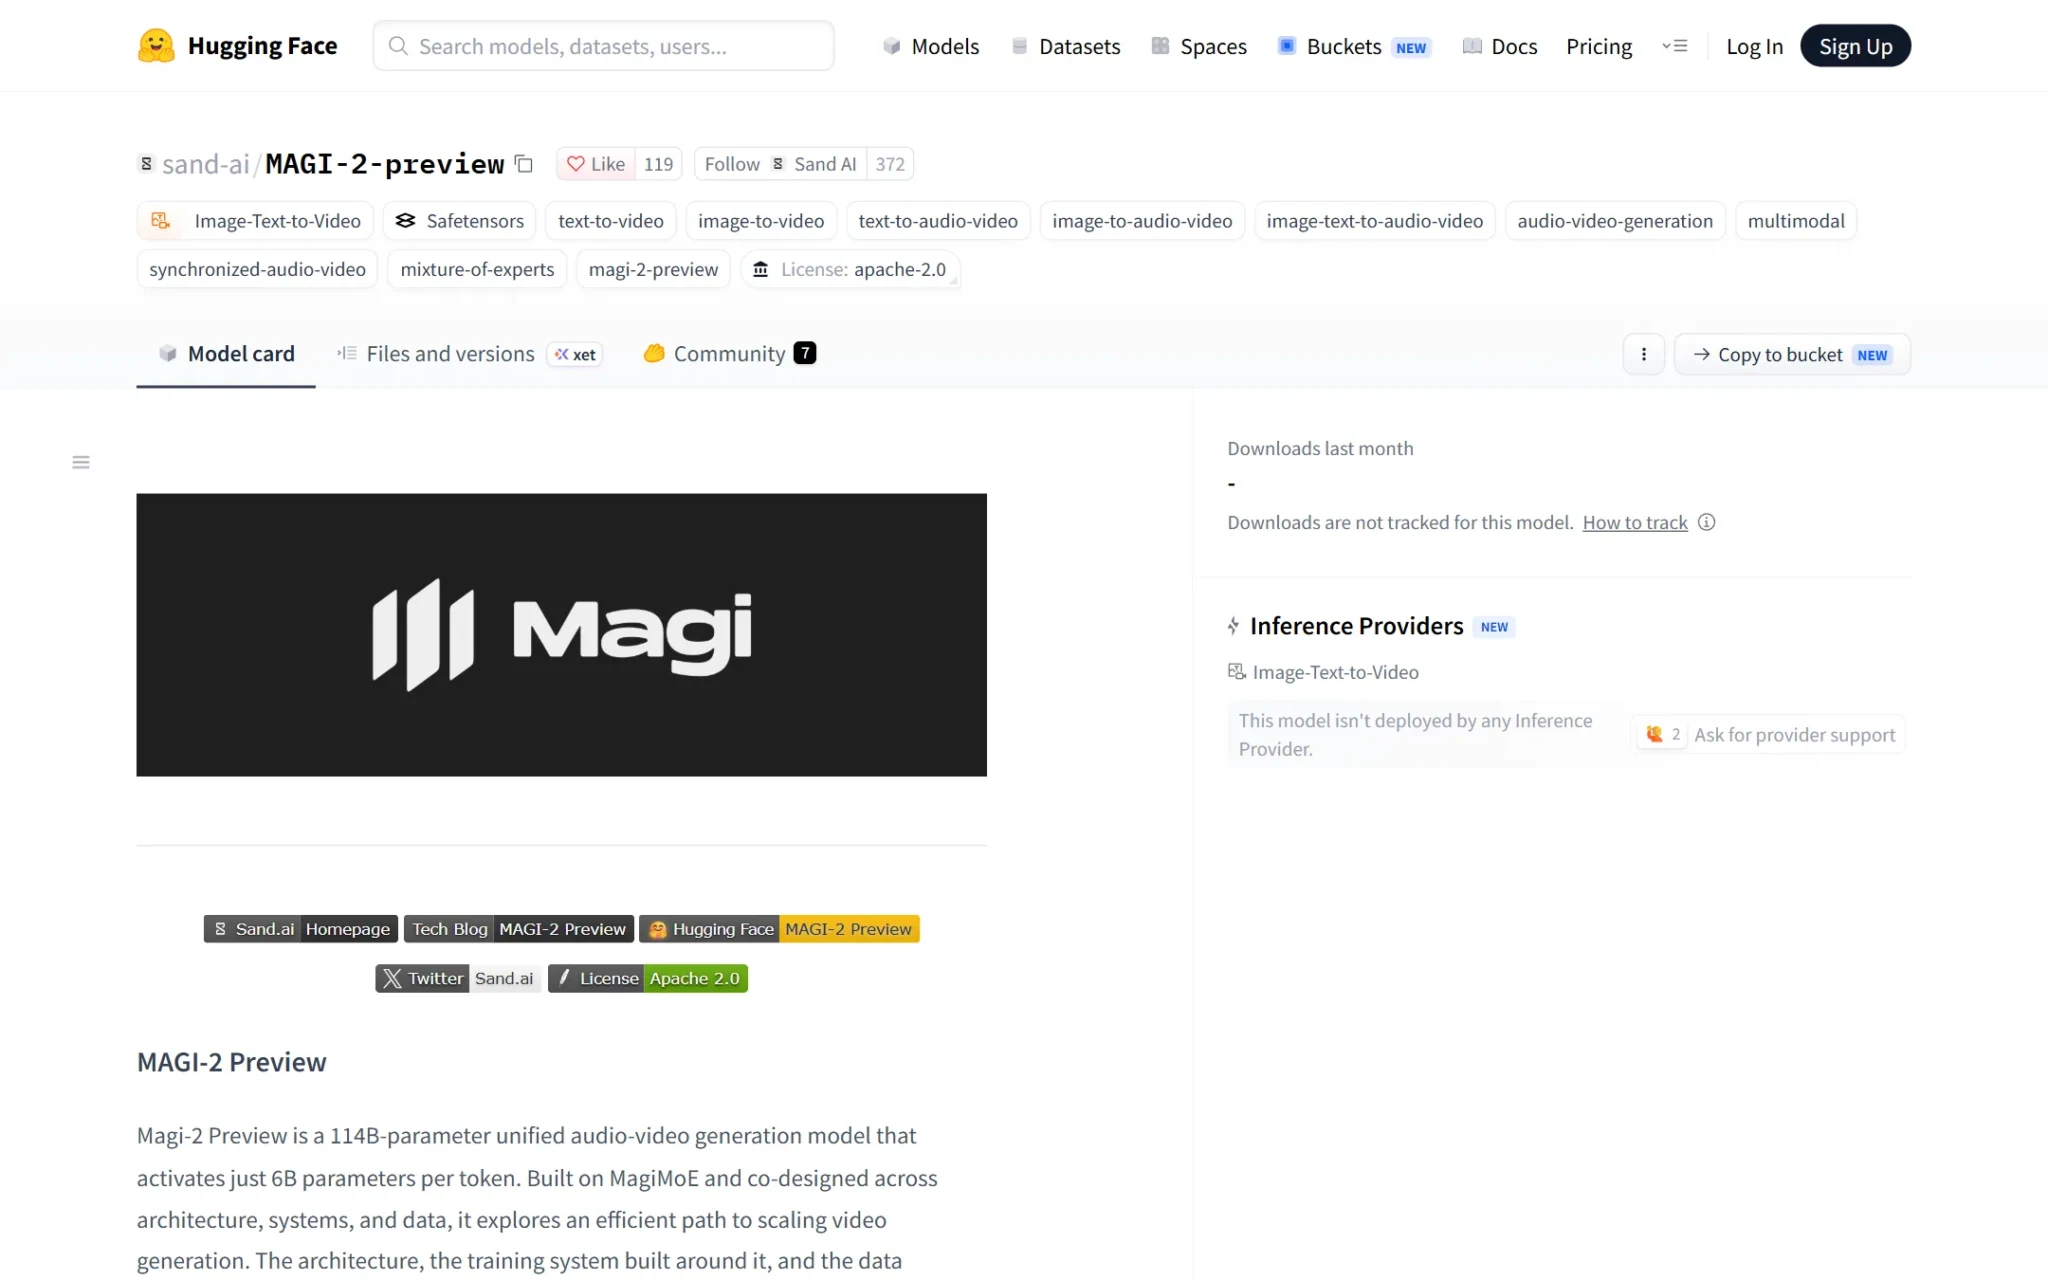
- Licencja: Apache-2.0, także do użytku komercyjnego, bez wyłączeń regionalnych.
- Sprzęt: 8 GPU Hopper (80 GB), ok. 307 GB wag. Na RTX 4090 i żadnym domowym PC się nie uruchomi.
- API: Artificial Analysis podaje „Coming soon”. Nie ma go na fal.ai, Replicate, WaveSpeedAI ani OpenRouterze.
- Mój test: nie zrobiłem - nie ma API z ceną, a lokalnie wymaga serwera z 8 kartami po 80 GB.
Co to jest MAGI-2 i kto za nim stoi
Sand.ai to start-up z Pekinu założony przez Cao Yue. To współautor architektury Swin Transformer (nagroda Marr Prize), wcześniej Principal Researcher w Microsoft Research Asia i szef centrum badawczego w BAAI. Firma ma za sobą kilka produktów:
- MAGI-1 (2025) - autoregresyjny model wideo, który generował klip kawałkami i umiał go przedłużać. Jest dostępny przez API u kilku pośredników.
- GAGA-1 - model audio-wideo do gadających postaci.
- VidMuse - aplikacja do teledysków; strona Sand.ai twierdzi, że przekroczyła 10 mln USD przychodu rocznego (ARR) w dwa miesiące.
- MAGI-2 Preview (5 sierpnia 2026) - nowy model bazowy z otwartymi wagami.
Pieniądze: według 36kr (29 czerwca 2026) Sand.ai zebrało ponad 100 mln USD w dwóch rundach, m.in. od Matrix Partners China, Sinovation, IDG i Baidu Ventures. 29 września Wangsu Science & Technology ogłosiło zakup 4,4% udziałów za 300 mln juanów, co wycenia firmę na ok. 1 mld USD. Te same dokumenty pokazują małe przychody i duże straty - opisałem to w tekście Sand.ai wyceniony na miliard dolarów.
Technicznie MAGI-2 to zerwanie z MAGI-1. Zamiast generowania kawałkami jest jeden transformer dyfuzyjny, który przetwarza tekst, obraz i dźwięk w jednej sekwencji. Duża liczba parametrów bierze się z architektury MoE (mieszanina ekspertów): 40 warstw, z czego 36 rzadkich, w każdej 12 głów z własnym routerem, a każda głowa wybiera 6 z 256 ekspertów. Dzięki temu model ma 114 mld parametrów, ale na jeden token liczy ok. 6 mld. Sand.ai w raporcie pisze wprost, że to „intermediate research release”, czyli wydanie pośrednie.
MAGI-2 Preview: The Open-Source 100B+ Ultra-Fine-Grained MoE Video Generation Model
- Sand.ai (@SandAI_HQ) 14 sierpnia 2026
Miejsce w rankingu Artificial Analysis
Artificial Analysis (AA) układa ranking ze ślepych porównań: oceniający widzą dwa klipy z tego samego polecenia i wybierają lepszy. Odczytałem obie tabele 11 października 2026. W obrazie na wideo MAGI-2 Preview jest 10. z wynikiem 1093 Elo. Przedział 95% (1086-1100) nachodzi na Grok Imagine 1.5 i HappyHorse 1.0, więc miejsca 9-11 to praktycznie remis. Do czołówki brakuje mu dużo: lider, MiniMax H3 Max, ma 102 punkty więcej.
| Miejsce I2V | Model | Elo | Przedział 95% | USD za minutę (AA) | Otwarte wagi |
|---|---|---|---|---|---|
| 1 | MiniMax H3 Max | 1195 | 1186-1204 | 4,80 | nie |
| 2 | MiniMax H3 | 1181 | 1173-1189 | 7,80 | tak (bez UE) |
| 7 | Wan 3.0 | 1164 | 1156-1172 | 12,00 | nie |
| 8 | HappyHorse 1.1 | 1104 | 1097-1111 | 9,90 | nie |
| 9 | Grok Imagine Video 1.5 | 1098 | 1090-1106 | 8,40 | nie |
| 10 | MAGI-2 Preview | 1093 | 1086-1100 | brak ceny | tak, Apache-2.0 |
| 11 | HappyHorse 1.0 | 1083 | 1076-1090 | 13,20 | nie |
| 23 | LTX-2.5 Fast | 1038 | 1029-1047 | 7,80 | tak |
Dane: AA-Video-I2V v1.0, odczyt 11.10.2026. Kolumna „otwarte wagi” według linków w tabeli AA.
Skala wykresu zaczyna się od 1000 punktów (pełny pasek = 1200), żeby było widać różnice.
Wersja 0912 w rankingu tekstu na wideo
W tabeli tekstu na wideo (AA-Video-T2V v2.0, oceniany w 1080p z dźwiękiem, uruchomiony 30 września) występuje „MAGI-2 Preview (0912)” z datą 12 września 2026. Jest 21. z wynikiem 960 Elo (przedział 950-970, 3674 porównań). To nie jest wersja, którą można pobrać: AA nie podaje przy niej linku do wag, a w repozytorium na GitHubie ostatnia zmiana jest z 6 sierpnia. Najpewniej to nowszy punkt kontrolny testowany przez AA bez publikacji - ale to mój wniosek, producent tej wersji nigdzie nie opisał. Publiczna wersja z sierpnia w rankingu T2V v2.0 nie występuje.
Parametry MAGI-2 Preview
| Cecha | MAGI-2 Preview |
|---|---|
| Parametry | 114 mld łącznie, ok. 6 mld aktywnych na token (MoE) |
| Architektura | jednostrumieniowy transformer dyfuzyjny, 40 warstw (36 MoE + 4 gęste), Top-6 z 256 ekspertów na głowę |
| Tryby | tekst na wideo (T2V) i obraz na wideo (I2V, obraz jako pierwsza klatka) |
| Długość klipu | 10 s - jedyna obsługiwana długość |
| Rozdzielczość | dwuetapowo: podgląd 512 x 896, refiner do 1088 x 1920, opcjonalne przeskalowanie do 1080 x 1920 |
| Dźwięk | natywny, generowany razem z obrazem (dialogi, efekty, muzyka); audio VAE ze Stable Audio Open 1.0 |
| Sterowanie | polecenie strukturalne z osią czasu (segmenty z zakresem sekund, zdarzenia dźwiękowe, kwestie dialogu) |
| Kroki | 100 kroków podglądu + 5 kroków refinera (model niedestylowany) |
| Enkoder tekstu | Qwen3.5-27B |
| VAE wideo | z Wan2.2-TI2V-5B, plus destylowany dekoder turbo |
| Klatki na sekundę | producent nie podaje w README (w konfiguracji jest 25) |
Źródło: README na GitHubie i raport Sand.ai, odczyt 11.10.2026. Przedłużania klipów ani „nieskończonej długości” MAGI-2 nie ma - to były cechy MAGI-1.
Oś czasu w poleceniu to najciekawsza cecha dla twórców. Oficjalny przykład opisuje 10-sekundowy klip jako listę segmentów („00:00.0-00:05.0”, „00:05.0-00:10.0”), a w każdym osobno ruch kamery, akcję postaci, zdarzenia dźwiękowe z dokładnym czasem i kwestię dialogu. Model był uczony na długich, ustrukturyzowanych opisach, więc README zaleca rozwinięcie krótkiego polecenia przez osobny model językowy. Gotowe polecenia z repozytorium pokazuję w tekście Co potrafi MAGI-2: przykłady.
Gdzie jest dostępny i ile kosztuje
Tu MAGI-2 wypada najsłabiej. Otwarte wagi są, ale gotowej usługi z cennikiem dla zwykłego użytkownika nie znalazłem. Sprawdziłem 11 października:
| Miejsce | MAGI-2 | Cena |
|---|---|---|
| Hugging Face (wagi) | tak | 0 USD, ale potrzebny własny serwer |
| platform.sand.ai (API Sand.ai) | nie potwierdziłem | pakiety kredytów, ceny dopiero po zalogowaniu; dokumentacja opisuje API MAGI-1 |
| magi.sand.ai (aplikacja) | nie potwierdziłem | plany i darmowe kredyty nie są opisane bez logowania |
| Artificial Analysis | - | „API Pricing: Coming soon” |
| fal.ai | nie | jest MAGI-1 extend-video: 0,80 USD za 4 s + 0,20 USD za każdą kolejną sekundę |
| WaveSpeedAI | nie | jest MAGI-1 24B: 0,08 USD za sekundę; daVinci-MagiHuman: 0,02-0,06 USD/s (256p-1080p) |
| Replicate, OpenRouter | nie | - |
Sand.ai obiecuje „1/10 kosztu” popularnych modeli, ale bez konkretnej stawki. Kwota 0,5 juana za klip, która krąży w sieci, pochodzi z bloga strony trzeciej i dotyczy przyszłej wersji destylowanej - nie traktuję jej jako ceny. Ile kosztują sekundy u konkurencji, zebrałem w tekście Ile kosztuje sekunda wideo AI.
Otwarte wagi: co dokładnie dostajesz i na czym to ruszy
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
To jest powód, dla którego o MAGI-2 w ogóle się mówi. Wagi leżą na Hugging Face na licencji Apache-2.0: można je pobrać, zmieniać, dotrenowywać i używać komercyjnie, bez progów przychodu i bez wyłączeń krajów. Dla porównania otwarty MiniMax H3 ma licencję, która wyklucza Unię Europejską, a LTX-2.5 jest bezpłatny tylko dla firm z przychodem poniżej 10 mln USD rocznie.
| Folder | Rozmiar | Co zawiera |
|---|---|---|
| preview | 228 GB | transformer etapu podglądu (56 plików safetensors) |
| text_encoder | 56 GB | enkoder tekstu Qwen3.5-27B |
| refiner | 14 GB | transformer etapu 1080p |
| stable-audio-open-1.0 | 5 GB | audio VAE |
| vae | 3 GB | VAE wideo z Wan2.2 |
| turbo_vae | 2 GB | destylowany szybki dekoder (domyślny) |
| Razem | ok. 307 GB |
Wymagania z README:
- 8 kart NVIDIA Hopper (H100/H200). README zaznacza, że w 1080p ani transformer podglądu, ani refiner nie mieszczą się na jednej karcie 80 GB razem z aktywacjami drugiego, więc są przenoszone między etapami.
- Python 3.12, aktualne CUDA i ffmpeg (bez niego wideo zapisze się bez dźwięku).
- Obraz Docker
sandai/magi-2-preview- ok. 12,7 GB według Docker Hub (11.10), tagi z 5 sierpnia. - Tryby offloadu dla enkodera, podglądu, refinera i VAE:
cpu,gpualboroundtrip.
Czego nie ma:
- Wersji destylowanej - w README wciąż jako „Coming soon”, z „far fewer” krokami. To ona miałaby skrócić czas generowania.
- Oficjalnych kwantyzacji (FP8, GGUF).
- Węzłów ComfyUI - comfyui-wiki 5 sierpnia pisało, że ich nie ma, a README do dziś nie wspomina o ComfyUI.
Jak długo to trwa i ile kosztuje? Producent nie podaje. Jedyny szacunek, jaki znalazłem, jest z bloga mushroom.cv (7.08.2026): ok. 15-30 minut na jeden 10-sekundowy klip na 8 x H100 i ok. 25-42 USD za klip przy wynajmie instancji AWS p5. To strona trzecia, nie pomiar producenta ani mój. Dla porównania minuta z H3 Max przez API kosztuje 4,80 USD.
Na RTX 4090 i każdym domowym komputerze MAGI-2 się nie uruchomi. Sam transformer podglądu waży 228 GB, a karta ma 24 GB. Nie pomogą tu ani 2, ani 4 karty konsumenckie. Uważaj też na repozytoria na GitHubie i Hugging Face, które podszywają się pod MAGI-2 - oficjalne źródła to tylko SandAI-org/MAGI-2-preview i sand-ai/MAGI-2-preview.
Co zamiast lokalnie? Jeśli masz jedną kartę 24 GB, realną opcją jest Wan 2.2: wersja TI2V-5B (Apache-2.0) według README Alibaby robi 720p przy 24 kl./s na RTX 4090, a 5-sekundowy klip generuje w mniej niż 9 minut na jednej karcie konsumenckiej. LTX-2.5 ma oficjalne szablony ComfyUI, pliki w int8 i NVFP4 oraz tryb FP8 z offloadem na CPU dla kart z mniejszą pamięcią. Przegląd modeli, które naprawdę uruchomisz w domu, jest w tekście Lokalne AI.
Jak zacząć z MAGI-2 krok po kroku
Bez API zostaje jedna droga: wynajęty serwer z 8 GPU Hopper. Poniżej kroki dokładnie z README - nie dopisuję flag, których tam nie ma.
- Wynajmij maszynę z 8 kartami H100 lub H200 80 GB i dyskiem na co najmniej 307 GB wag plus obraz Docker.
- Pobierz wagi do katalogu
ckpt/:pip install huggingface_hub, potemhf download sand-ai/MAGI-2-preview --local-dir ckpt. Nazwy folderów pasują do konfiguracji, nic nie trzeba zmieniać. Wagi gdzie indziej wskażesz zmiennąMAGI2_CKPT_ROOT. - Uruchom kontener:
docker pull sandai/magi-2-preview:latest, a potemdocker run --gpus all -it -v /path/to/ckpt:/workspace/ckpt sandai/magi-2-preview:latest. README radzi przy zgłaszaniu wyników podawać tag konkretnego commitu, bolatestsię zmienia. - Wygeneruj oficjalne demo:
bash scripts/run_demo.sh- 1080p, ziarno 42, polecenia zassets/demo_samples.json. Wynik trafia dosample_000.mp4i kolejnych. - Własny klip:
torchrun --nproc_per_node=8 inference/pipeline/entry.py --prompt "a red fox in snow" --output output/. Do I2V dodajesz--image, do dokładnego 1080 x 1920--output-widthi--output-height. - Rozwijanie polecenia (opcjonalnie): w
inference/prompt_enhancement/enhancer.pyustawAPI_KEYdo zgodnego z OpenAI modelu językowego. Puste pole oznacza, że model dostaje polecenie bez zmian.
Instalacja bez Dockera (pip install -r requirements.txt plus MagiAttention i MagiCompiler) jest możliwa, ale README podaje tylko wersje w Dockerfile, więc kontener jest prostszy.
Porównanie z rywalami
| Model | Elo I2V | Elo T2V | USD/min wg AA (I2V / T2V) | Otwarte wagi |
|---|---|---|---|---|
| MAGI-2 Preview | 1093 | 960 (tylko 0912) | brak ceny | tak, Apache-2.0 |
| Wan 3.0 | 1164 | 1156 | 12,00 / 12,00 | nie (otwarte jest Wan 2.2) |
| MiniMax H3 | 1181 | 1137 (768p) | 7,80 / 4,80 | tak, licencja MiniMax bez UE, USA, UK i Korei |
| LTX-2.5 Fast | 1038 | 946 | 7,80 / 7,80 | tak, LTX-2.x Community License |
| HappyHorse 1.1 | 1104 | 1042 | 9,90 / 10,80 | nie |
| Grok Imagine Video 1.5 | 1098 | 1045 | 8,40 / 15,00 | nie |
Elo i ceny z tabel AA (11.10.2026). Licencje odczytałem 11.10 na Hugging Face. Pełne zestawienie otwartych modeli z wymaganiami sprzętowymi: MAGI-2 vs Wan vs LTX-2.5 vs MiniMax H3.
Wniosek: w jakości MAGI-2 jest na poziomie zamkniętych modeli ze środka stawki (Grok Imagine 1.5, HappyHorse) i wyraźnie przed LTX-2.5. Od MiniMax H3, drugiego otwartego modelu, jest gorszy o 88 punktów - ale H3 z wagami nie może legalnie działać w Polsce bez osobnej zgody MiniMax, a MAGI-2 może.
Dla kogo jest MAGI-2
- Dla zespołów badawczych i laboratoriów z dostępem do klastra H100 - to największy otwarty model wideo MoE, z pełnym raportem architektury.
- Dla firm, które muszą trzymać generowanie u siebie (dane klientów, wymogi prawne) i potrzebują czystej licencji bez wyłączeń dla UE.
- Dla studiów, które chcą dotrenować model na własnym stylu - Apache-2.0 na to pozwala bez opłat.
- Nie dla twórcy z jednym komputerem - nie uruchomisz go, a API z ceną nie ma. Lepszy będzie MiniMax H3 Max przez API albo Wan 2.2 lokalnie.
- Nie dla produkcji masowej - przy szacunku 25-42 USD za klip na wynajętym serwerze każdy model z API wychodzi taniej.
Szerszy przegląd: Generatory wideo AI - który wybrać i mój ranking generatorów wideo.
Najczęstsze pytania
Czy MAGI-2 jest za darmo?
Wagi są darmowe, na licencji Apache-2.0. Płacisz za sprzęt: 8 kart Hopper po 80 GB. Gotowej darmowej wersji w przeglądarce nie znalazłem.
Czy MAGI-2 uruchomię na RTX 4090?
Nie. Sam transformer podglądu ma 228 GB, a cały zestaw ok. 307 GB. README wymaga 8 GPU Hopper. Nie ma oficjalnych kwantyzacji ani wersji destylowanej.
Ile kosztuje MAGI-2 przez API?
Ceny nie ma. Artificial Analysis podaje „Coming soon”, a platforma Sand.ai pokazuje ceny dopiero po zalogowaniu i w dokumentacji opisuje API MAGI-1. Fal.ai, Replicate, WaveSpeedAI i OpenRouter MAGI-2 nie mają (11.10.2026).
Czy MAGI-2 działa w ComfyUI?
Oficjalnych węzłów nie ma. Nieoficjalne repozytoria istnieją, ale ich nie polecam - część podszywa się pod MAGI-2 i może zawierać złośliwy kod.
Czym MAGI-2 różni się od MAGI-1?
MAGI-1 generował wideo kawałkami i umiał je przedłużać. MAGI-2 to jeden transformer dyfuzyjny MoE, który robi naraz obraz i dźwięk, ale tylko klipy po 10 s. Przedłużania nie ma.
Co to jest MAGI-2 Preview (0912)?
Wersja z 12 września, która jest tylko w rankingu tekstu na wideo AA (21. miejsce, 960 Elo). Nie ma jej publicznych wag ani opisu od producenta.
Czy MAGI-2 mówi po polsku?
Producent nie podaje listy języków. Oficjalny przykład dialogu ma ustawiony język angielski. Polskiej mowy nie sprawdziłem, bo nie miałem jak wygenerować klipu.
Czy mogę używać klipów z MAGI-2 komercyjnie?
Licencja Apache-2.0 pozwala na użycie komercyjne modelu, bez progów przychodu i bez wyłączeń krajów. Odpowiadasz za treść, którą wygenerujesz.
Teksty w tej serii
- Co potrafi MAGI-2: przykłady i oficjalne polecenia z osią czasu
- Otwarte modele wideo 2026: MAGI-2 vs Wan vs LTX-2.5 vs MiniMax H3
- Sand.ai wyceniony na 1 mld USD po inwestycji Wangsu
- Agnes Video 2.5 i HiDream-O1-Video - inne modele z tej samej aktualizacji rankingu
Źródła i data sprawdzenia
- Hugging Face: sand-ai/MAGI-2-preview - licencja, pliki (11.10.2026)
- GitHub: SandAI-org/MAGI-2-preview - README, wymagania, polecenia (11.10.2026)
- Sand.ai: MAGI-2 Preview: Scaling Video Generation Models Efficiently (5.08.2026)
- sand.ai - strona główna, materiały wideo (11.10.2026)
- Docker Hub: sandai/magi-2-preview (11.10.2026)
- Artificial Analysis: obraz na wideo i tekst na wideo (odczyt 11.10.2026)
- 36kr o finansowaniu Sand.ai (29.06.2026)
- China AI Dispatch o inwestycji Wangsu (29.09.2026)
- Sand.ai: About us (11.10.2026)
- mushroom.cv - szacunek czasu i kosztu (7.08.2026)
- comfyui-wiki o MAGI-2 (5.08.2026)
- fal.ai MAGI-1, WaveSpeedAI MAGI-1 24B, WaveSpeedAI daVinci-MagiHuman (11.10.2026)
- licencja MiniMax H3, karta LTX-2.5, karta Wan2.2-TI2V-5B (11.10.2026)
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym