

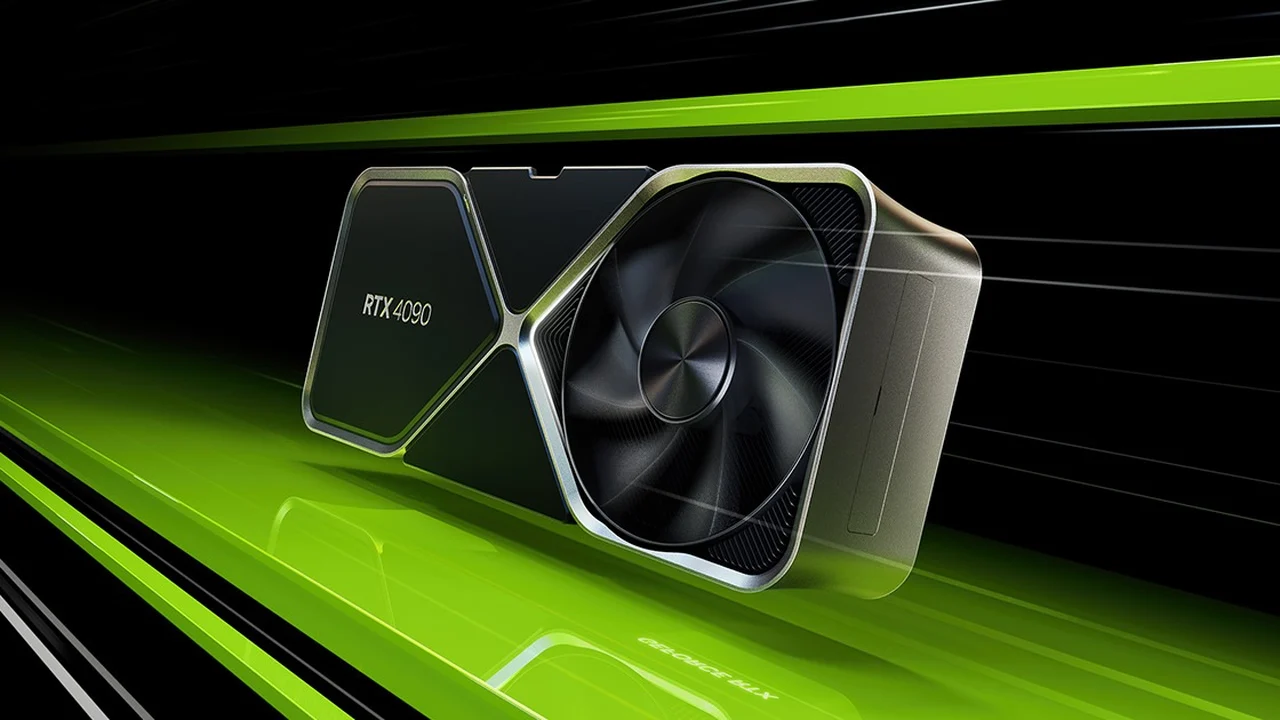
RTX 4090 do AI w 2026: co mieści 24 GB, ile bierze prądu i czy kupić używaną
Co realnie mieści 24 GB, ile prądu bierze karta przy AI i kiedy używana RTX 4090 ma sens zamiast RTX 5080 albo 5090. Moje pomiary i ceny z 14.11.2026.
Spis treści 7
👁 120 przeczytań
RTX 4090 to wciąż najlepsza karta do lokalnego AI, jaką da się postawić w domowym komputerze bez wydawania kilkudziesięciu tysięcy złotych, tylko że nowej już prawie nie kupisz. 14 listopada 2026 nie sprzedawał jej żaden z czterech sprawdzonych sklepów. Pracuję na niej od ponad roku i to na niej zrobiłem wszystkie pomiary lokalnych modeli na promptowym. Poniżej piszę, co realnie mieści 24 GB, ile to zużywa prądu, z czym 4090 przegrywa i kiedy ma sens szukać jej używanej zamiast brać RTX 5080 albo RTX 5090.
Stan na 14 listopada 2026
- Mój zestaw: RTX 4090 24 GB, i9-14900KF, 64 GB DDR5, Windows 11. Pomiary z 26.09-17.10.2026 (Ollama 0.35-0.40, ComfyUI 0.37-0.41, nvidia-smi co 0,5 s).
- Ceny nowych kart: x-kom, morele.net, proline.pl, Komputronik, odczyt 14.11.2026. Cen używanych kart nie uśredniam.
- Kart RTX 5080, RTX 5090 ani Radeonów nie testowałem. Porównania z nimi to wyliczenia z danych producentów.
24 GB w praktyce: co uruchamiam na co dzień
Najwięcej czasu RTX 4090 spędza u mnie na trzech rzeczach: modelach językowych do szkiców i tłumaczeń, generowaniu obrazów do okładek i wideo do testów. Każda z nich mieści się w 24 GB, ale żadna nie zostawia dużego zapasu, kiedy obok chodzi przeglądarka z kilkudziesięcioma kartami.
| Model | Zajęta pamięć | Szybkość na 4090 |
|---|---|---|
| Gemma 4 12B Q4 (tekst) | 7,5 GB | 99 tok/s |
| GPT-OSS 20B (tekst) | 11,3 GB | 237 tok/s |
| Bielik 11B v3 Q8 (tekst po polsku) | 12,3 GB | 70 tok/s |
| Qwen 3.8 27B Q4 (tekst) | 15,6 GB | 47 tok/s |
| Gemma 4 31B QAT (tekst) | 19,2 GB | 41-43 tok/s |
| Z-Image Turbo (obraz 1344×768) | - | 4,2 s / obraz |
| Qwen-Image 2.1 Turbo (obraz) | 16,8-18,6 GB | 3 s / obraz |
| Kandinsky 6 Lite (wideo 5 s z dźwiękiem) | 18,8-19,9 GB | 111-148 s / klip |
| Wan 2.2 TI2V 5B (wideo 5 s, 720p) | 17,3-23,4 GB | ok. 4 min / klip |
Pamięć tekstowych modeli to przyrost po załadowaniu przy 4 tys. tokenów kontekstu, obrazów i wideo to szczyt zajętości całej karty, razem z około 2 GB, które trzyma Windows. Pełny test siedmiu modeli po polsku jest w tekście 7 lokalnych modeli AI po polsku.
Granica 24 GB wychodzi przy dwóch rzeczach. Pierwsza to modele 31-32 mld parametrów z długim kontekstem: Gemma 4 31B zajmuje 19,2 GB przy 4 tys. tokenów, więc przy 32 tys. pamięć uwagi zjada resztę. Druga to cięższe modele wideo. Kandinsky 6 Pro w wersji int8 ma 30,5 GB pliku i do karty nie wchodzi w ogóle. ComfyUI trzyma część wag w RAM i dosyła je w trakcie, przez co klip liczy się 6-7 minut zamiast około 2 w wersji Lite.
Prąd, ciepło i hałas
Pod obciążeniem karta pobiera u mnie od 190 do 450 W. Przy klipie z Wan 2.2 średnio 272-282 W, szczytowo 441 W, czyli około 19 Wh na pięciosekundowy klip. Przy cenie prądu około 1 zł za kWh to 2 grosze. Obraz z Z-Image Turbo kosztuje 0,04 grosza, milion tokenów z Gemmy 4 12B około 1,22 zł, licząc razem z resztą komputera.
Rachunek nie jest problemem, problemem jest ciepło. Przez kilka minut generowania karta oddaje do pokoju ponad 400 W i bez dobrego przepływu powietrza w obudowie wentylatory szybko robią się głośne. Jeśli planujesz długie serie wideo w małym pokoju, policz to, zanim kupisz. Wszystkie wyliczenia kosztów są w tekście lokalny model czy API.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
RTX 4090 na tle nowych kart
Nvidia nie ma dziś w sprzedaży nowej karty z 24 GB. Seria RTX 50 przeskakuje z 16 GB (RTX 5060 Ti 16 GB, 5070 Ti, 5080) od razu do 32 GB w RTX 5090. To jest powód, dla którego 4090 dalej ma sens do AI, chociaż jest kartą poprzedniej generacji.
| Karta | VRAM | Przepustowość pamięci | Cena nowej od (14.11) | Największy model w całości* |
|---|---|---|---|---|
| RTX 5080 | 16 GB | 960 GB/s | 8 890 zł | 14 mld |
| RTX 4090 | 24 GB | 1008 GB/s | brak nowych | 32 mld |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 9 499 zł | 32 mld (49 mld**) |
| RTX 5090 | 32 GB | 1792 GB/s | 38 861 zł | 32 mld (49 mld**) |
* Wyliczenie metodą mojego kalkulatora VRAM: Q4_K_M, 8 tys. tokenów kontekstu, 1 GB rezerwy na system. ** Z pamięcią uwagi w 8 bitach.
- Z RTX 5080 4090 wygrywa pojemnością. 5080 ma podobnie szybką pamięć, więc model, który mieści się w 16 GB, wygeneruje podobnie szybko. Ale Gemma 4 31B, Qwen-Image 2.1 Turbo czy Wan 2.2 na 16 GB już nie wejdą w całości.
- Z RTX 5090 4090 przegrywa wszystkim poza ceną. 5090 ma o 8 GB więcej i prawie dwa razy szybszą pamięć, co przy generowaniu tekstu przekłada się wprost na tokeny na sekundę. Kosztuje jednak od 38 861 zł.
- Z Radeonem AI PRO R9700 to wybór między pamięcią a oprogramowaniem. R9700 ma 32 GB za 9 499 zł, ale wolniejszą pamięć i mniej programów, które go obsługują bez kombinowania. Szerzej w tekście 32 GB do AI: RTX 5090 czy R9700.
Używana RTX 4090: na co patrzeć
Skoro nowej nie ma w sklepach, zostaje rynek wtórny. Ceny używanych kart rozjeżdżają się zbyt mocno, żeby podać jedną liczbę, więc zamiast niej podaję próg opłacalności: używana 4090 ma sens, dopóki kosztuje wyraźnie mniej niż nowa RTX 5080 (od 8 890 zł) plus to, co jest Ci warte 8 GB pamięci więcej. Jeśli zbliża się do ceny R9700, a pracujesz na Linuksie, policz też Radeona.
Przy odbiorze sprawdziłbym cztery rzeczy:
- Pamięć i sterownik. Skrypt
sprawdz-gpu.pyz huba jaka karta graficzna do AI pokaże nazwę karty i pełne 24564 MiB. Mniej oznacza inny model albo problem. - Długie obciążenie. Puściłbym 15-20 minut generowania obrazów albo klipu wideo i obserwował w
nvidia-smipobór mocy i temperaturę. Karta, która spada z taktowaniem albo się wyłącza, odpada. - Złącze zasilania. 4090 ma jedno złącze 16-pinowe. Obejrzałbym wtyczkę i gniazdo, czy nie ma przebarwień, i użył kabla dobrze wciśniętego do końca.
- Zasilacz w moim komputerze. Skoki mocy dochodzą u mnie do 441-450 W samej karty, więc zasilacz musi mieć zapas na całą resztę zestawu.
Czy kupiłbym ją dziś
Do pracy z lokalnym AI tak, jeśli trafię na sprawną kartę w cenie zbliżonej do RTX 5080. 24 GB to dziś próg, od którego modele wideo, Qwen-Image i modele językowe rzędu 27-31 mld parametrów działają w całości na karcie, a w nowej ofercie Nvidii ten próg kosztuje cztery razy więcej. Jeśli robisz głównie tekst i obrazy, nie potrzebujesz jej: RTX 5060 Ti 16 GB albo Radeon RX 9060 XT 16 GB za około 3,1-3,6 tys. zł zrobią to samo wolniej. Porównanie wszystkich aktualnych kart z cenami jest [brak dopełnienia/urwana konstrukcja]. w hubie jaka karta graficzna do AI.
Najczęstsze pytania
Czy RTX 4090 nadaje się do AI w 2026 roku?
Tak. Mieści modele językowe do około 32 mld parametrów w Q4, Qwen-Image 2.1 Turbo, Kandinsky 6 Lite i Wan 2.2 5B. Gemma 4 31B robi na niej 41-43 tokeny na sekundę, a obraz z Z-Image Turbo powstaje w 4,2 s.
Gdzie kupić nową RTX 4090?
14 listopada 2026 nie było jej w ofercie x-kom, morele.net, proline.pl ani Komputronika. Zostaje rynek wtórny albo przejście na RTX 5080 (16 GB) lub RTX 5090 (32 GB).
RTX 4090 czy RTX 5090 do AI?
5090 ma 32 GB zamiast 24 i prawie dwa razy szybszą pamięć (1792 wobec 1008 GB/s), więc jest lepsza pod każdym względem poza ceną: nowa kosztuje od 38 861 zł. Dla kogoś, kto nie zarabia na lokalnym AI, używana 4090 to rozsądniejszy kompromis.
RTX 4090 czy RTX 5080 do AI?
Do AI 4090, bo ma 24 GB zamiast 16. Przy modelach mieszczących się w 16 GB obie są podobnie szybkie, ale większe modele i wideo na 5080 trzeba częściowo przenosić do RAM, co spowalnia je kilka razy.
Ile prądu zużywa RTX 4090 przy AI?
U mnie 190-450 W zależnie od zadania. Klip wideo z Wan 2.2 to około 19 Wh, czyli 2 grosze, a tysiąc obrazów z Z-Image Turbo około 50 groszy.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła i data sprawdzenia
- Nvidia: GeForce RTX 4090
- Nvidia: specyfikacje GeForce RTX 50
- AMD: Radeon AI PRO R9700
- Ceny: x-kom.pl, morele.net, proline.pl, komputronik.pl, odczyt 14.11.2026.
- Moje pomiary na RTX 4090: 26.09-17.10.2026, opisane w tekstach o lokalnych modelach na promptowy.com.
Sprawdzone 14 listopada 2026.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Artykuły · 349 zł za GTA 6. Kto to bierze? Rozbieram cenę na części: Sony, sklep, VAT i RockstarRozebrałem cenę GTA 6 na części. Z 349 zł w PlayStation Store do wydawcy trafia około 198,62 zł, z pudełka za 369 zł około 150 zł. Sklep zarabia na...
 Artykuły · Nvidia: chipy AI, Blackwell i Vera Rubin, karty RTX, kurs akcji i sprawa Huanga (oś czasu)Co Nvidia sprzedaje, ile zarabia, jak zachowuje się kurs i co po kolei wydarzyło się w sprawie Jensena Huanga, w tym najnowsze ustalenia o zarządzie...
 Lokalne AI · Bielik 3.1: 56 języków i wywoływanie narzędzi. Sprawdziłem nowego Bielika na RTX 4090Bielik 11B v3.1 od SpeakLeash i Cyfronetu zna 56 języków i sam wywołuje narzędzia. Sprawdziłem go na RTX 4090: 8 na 10 zadań po polsku wobec 5 w...
- generatornia.plPortret akwarela ze zdjęcia: jak przerobić fotografię na malarski obraz
- dygot.plOkulary Samsunga i Google z Gemini XR już są. Wyglądają jak zwykłe, a widzą wszystko
- przelomowy.plAnthropic przejął biotech z jednym pracownikiem: dwa przeciwciała na rzadką dystrofię mięśni
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm