

Agenty MCP muszą wiedzieć nie tylko co, ale skąd - nowe podejście do weryfikacji źródeł
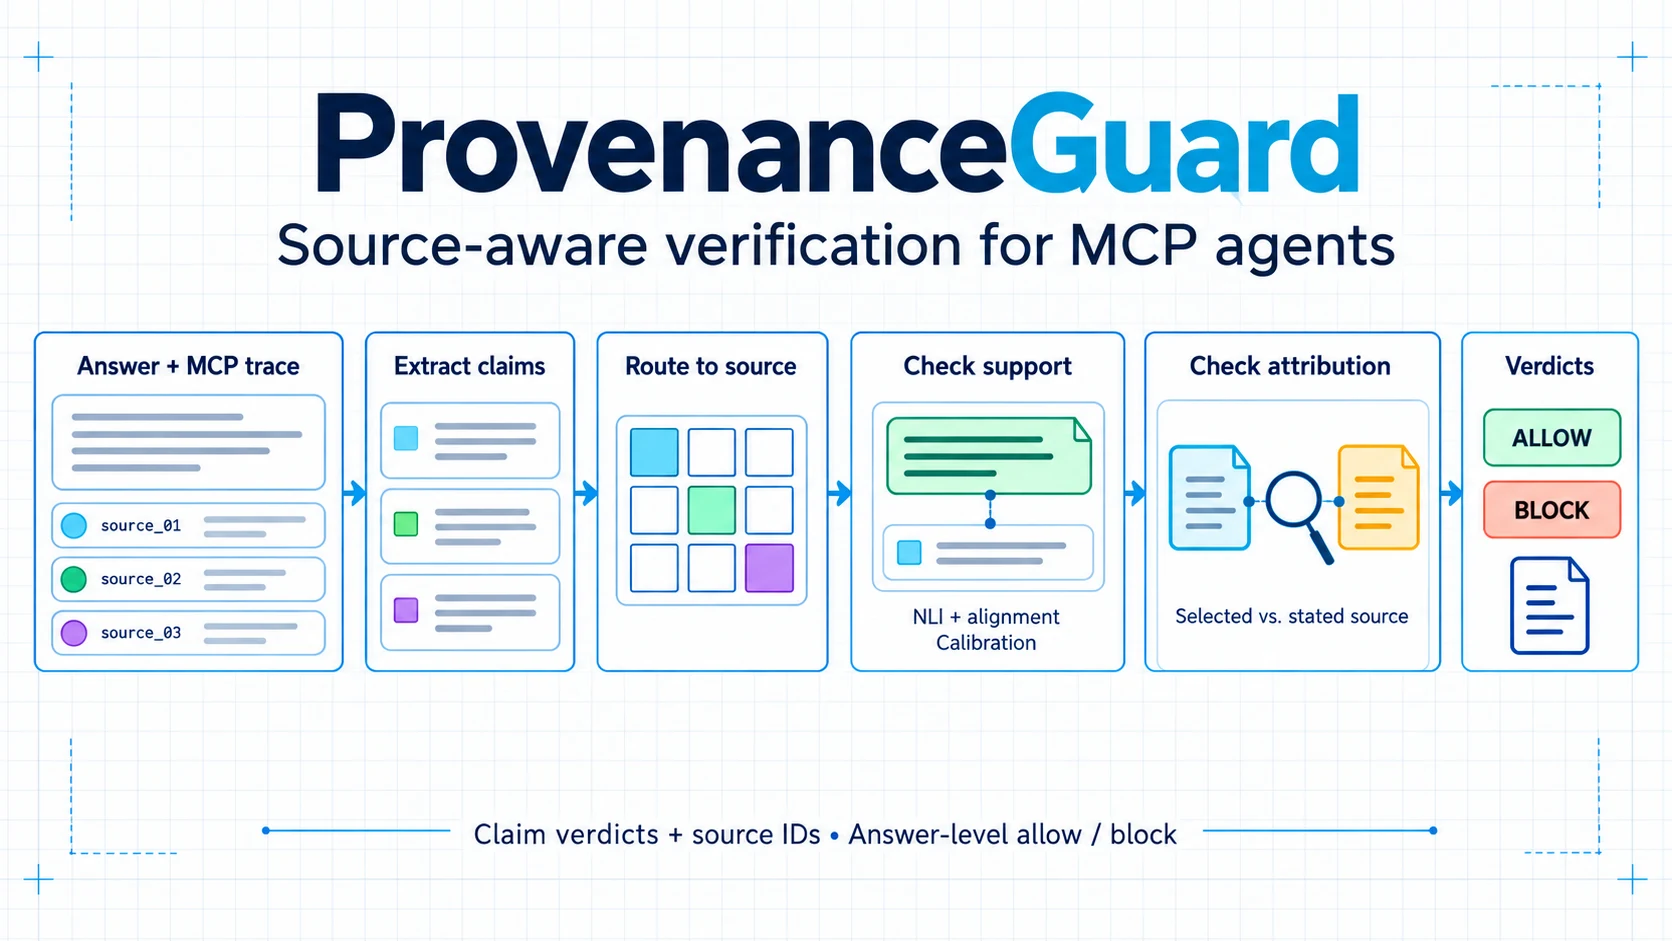
Zespół Multiverse Computing przedstawił metodę weryfikacji odpowiedzi agentów AI, która sprawdza nie tylko poprawność faktu, ale też czy pochodzi on z właściwego źródła.
Spis treści 3
Ten news ukazał się 4 min po komunikacie źródła.
👁 150 przeczytań
452 tysiące pobrań i 225 polubień w ciągu niecałego roku - taki wynik na Hugging Face zebrał model klasyfikacji zero-shot będący rdzeniem nowego podejścia do weryfikacji agentów AI, które w kwietniu 2024 roku opisał zespół Multiverse Computing w pracy „Getting the Source Right, Not Just the Fact”. Liczby robią wrażenie, ale naprawdę istotny jest problem, który badacze próbują rozwiązać: co zrobić, gdy agent poda ci prawdziwy fakt, lecz wyczyta go z zupełnie złego miejsca?
Fakty bez kontekstu źródłowego to za mało
Wyobraź sobie system obsługi klienta oparty na protokole MCP - Model Context Protocol, standardzie integracji narzędzi z dużymi modelami językowymi - który odpowiada na pytanie o aktualny regulamin zwrotów. Model może przytoczyć absolutnie poprawną regułę, tyle że zaczerpniętą z wersji dokumentu sprzed trzech lat, a nie z obowiązującego pliku zatwierdzonego przez dział prawny. Fakt jest prawdziwy, źródło jest błędne. Dla użytkownika różnica może być niewidoczna, dla firmy - brzemienne w skutkach.
Właśnie ten scenariusz leży u podstaw pracy badaczy z Multiverse Computing. Ich argument jest prosty, lecz rzadko artykułowany wprost w literaturze o halucynacjach: tradycyjne podejścia do weryfikacji LLM koncentrują się na tym, czy twierdzenie jest prawdziwe, zupełnie pomijając pytanie, czy pochodzi z właściwego, autoryzowanego dokumentu. W architekturach agentowych opartych na MCP, gdzie model ma dostęp do dziesiątek narzędzi i setek dokumentów jednocześnie, takie pominięcie staje się poważną luką bezpieczeństwa informacyjnego.
Model 0,2 miliarda parametrów jako strażnik proweniencji
Rozwiązanie, które proponuje zespół, opiera się na modelu klasyfikacji zero-shot o rozmiarze zaledwie 0,2 miliarda parametrów. To świadomy wybór - mały, wyspecjalizowany model działający jako zewnętrzna warstwa weryfikacyjna jest zarówno szybszy, jak i łatwiejszy do audytu niż próba nakłonienia głównego LLM do samoweryfikacji. Podejście zero-shot oznacza, że klasyfikator nie wymaga etykietowanych danych treningowych specyficznych dla danej domeny: wystarczy opisać kategorie źródeł w języku naturalnym, a model oceni, czy odpowiedź agenta pochodzi z dokumentu należącego do właściwej klasy.
Mechanizm działa na poziomie tak zwanej świadomości źródłowej - source-aware verification. Agent MCP, zanim zwróci odpowiedź użytkownikowi, przepuszcza ją przez klasyfikator, który porównuje deklarowane przez agenta źródło z faktycznym dokumentem, z którego pochodzi fragment. Jeśli kategoria się nie zgadza, odpowiedź jest blokowana lub flagowana do weryfikacji ludzkiej. W ten sposób system nie tylko sprawdza, co agent twierdzi, ale też skąd to twierdzi.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Dlaczego protokół MCP zmienia stawkę
Protokół MCP, wprowadzony przez Anthropic jako otwarty standard pod koniec 2023 roku, szybko stał się punktem skupienia dla twórców systemów agentowych. Pozwala modelom językowym w ustandaryzowany sposób wywoływać zewnętrzne narzędzia - bazy danych, API, repozytoria dokumentów - co radykalnie zwiększa ich możliwości, ale też mnoży powierzchnię ataku i błędów. Im więcej źródeł ma do dyspozycji agent, tym łatwiej o pomylenie dokumentu właściwego z podobnym, lecz nieaktualnym lub nieautoryzowanym.
Praca Multiverse Computing trafia więc w moment, gdy branża zaczyna budować poważne systemy produkcyjne na bazie MCP i dopiero odkrywa, że halucynacje to nie jedyny problem. Obok wymyślania faktów istnieje równie groźna kategoria błędu: cytowanie prawdziwych faktów z niewłaściwych miejsc. W środowiskach regulowanych - finanse, prawo, medycyna - ten drugi rodzaj błędu może być trudniejszy do wykrycia właśnie dlatego, że na pierwszy rzut oka wygląda poprawnie.
Liczba pobrań modelu na Hugging Face sugeruje, że problem trafił w rzeczywistą potrzebę deweloperów budujących agenty. 452 tysiące pobrań dla niszowego narzędzia weryfikacyjnego to wynik, który trudno zbagatelizować - i sygnał, że pytanie „skąd to wiesz?” zaczyna być dla budowniczych systemów AI równie ważne jak pytanie „czy to prawda?”.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · FinSkillBench: jak testować agenty AI w zarządzaniu inwestycjamiBadacze stworzyli benchmark do oceny agentów językowych w zadaniach inwestycyjnych - od budowy portfela po analizę fundamentalną. Kluczowy wniosek...
 Newsy · 34 prezesów o tym, co ich fascynuje i przeraża w agentycznym AIFast Company zapytało blisko trzydziestu kilku CEO z branż od ochrony zdrowia po marketing, jak myślą o agentycznym AI - i co z tych rozmów wynika...
 Newsy · Midjourney chce wiedzieć, jak Hollywood samo używa AIMidjourney złożyło wniosek procesowy, domagając się od Disneya, Universal i Warner Bros. ujawnienia szczegółów własnego wykorzystania generatywnej AI...
- przewagi.plAgent AI w małej firmie w 2026: co zrobi sam, ile kosztuje (od 14 900 zł netto) i gdzie potrzebny jest człowiek
- dygot.plOkulary Samsunga i Google z Gemini XR już są. Wyglądają jak zwykłe, a widzą wszystko
- przelomowy.plAnthropic przejął biotech z jednym pracownikiem: dwa przeciwciała na rzadką dystrofię mięśni
- generatornia.plŚwiąteczne zdjęcie AI: 10 stylów od choinki po śnieżną kulę