

temat tygodnia · 55 tekstów
lokalne AI
Tekst, obrazy, wideo i muzyka na własnej karcie - testy na RTX 4090 i darmowy Hangar.

 lokalne ai·Bielik 3.1: 56 języków i wywoływanie narzędzi. Sprawdziłem nowego Bielika na RTX 4090Bielik 11B v3.1 od SpeakLeash i Cyfronetu zna 56 języków i sam wywołuje narzędzia. Sprawdziłem go na RTX 4090: 8 na 10 zadań po polsku wobec 5 w wersji 3.0, 67 tok/s w Q8_0.
 artykuły·Chatterbox po polsku: darmowy lektor AI i klonowanie głosu na własnym komputerzeOtwarty model, który czyta po polsku i klonuje głos z próbki na twoim komputerze.
 artykuły·Lokalny głos AI 2026: lektor po polsku, klonowanie głosu, napisy i wokal bez chmuryWszystkie lokalne modele głosu w jednym miejscu: polski lektor i klonowanie, głos z opisu, napisy SRT, wokal i RVC.
 artykuły·Hangar 0.3: polski lektor, klonowanie głosu, napisy SRT i wokal na własnym komputerze
 artykuły·Qwen3 27B lokalnie: czy zmieści się na RTX 4090?Qwen3.6-27B to gęsty model Alibaby na licencji Apache 2.0.
 newsy·Opera WebAI: lokalne AI w przeglądarce bez klucza API. Na Macu korzysta z modelu AppleOpera dodała WebAI, czyli dostęp stron i rozszerzeń do modeli AI działających na twoim komputerze.
 newsy·Liquid AI wypuściło LFM3: sześć otwartych modeli po 2 mld parametrów, które widzą, słyszą i mówiąLiquid AI wypuściło rodzinę LFM3: sześć otwartych modeli około 2 mld parametrów, od tekstu po model omni.
 artykuły·KoboldCpp: lokalny czat i opowieści z modelem GGUF w jednym pliku
 artykuły·Nemotron Bolt E4B: lokalny agent, wymagania i możliwościNVIDIA opublikowała Nemotron 3.5 Bolt E4B 4GB 23 października 2026.
 artykuły·FLUX.2 Klein 4B lokalnie: test na RTX 4090 i porównanie z FLUX 3
 artykuły·Komputer do wideo AI: ile VRAM, RAM i jaki dysk (moje pomiary)Ile pamięci karty, RAM i jaki dysk potrzeba do generowania wideo AI w domu.
 artykuły·Jaka karta graficzna do AI w 2026? Ceny, VRAM i moje pomiaryKartę do AI wybierasz po pamięci, nie po szybkości.
 artykuły·Wan 2.2 w ComfyUI krok po kroku: pierwszy klip AI na swojej karcie graficznejInstrukcja na zrzutach: szablon Wan 2.2 5B w ComfyUI, pliki modelu, polecenie, rozmiar klipu i pierwszy film.
 artykuły·Cloudflare Tunnel i Ollama: lokalny model AI w sieci bez portówQuick Tunnel z Cloudflare wystawia lokalną Ollamę pod adresem HTTPS jednym poleceniem.
 artykuły·LTX-Video lokalnie: klip 5 s w 18 s na RTX 4090, LTX-2 i LTX DesktopZmierzyłem LTX-Video 13B distilled na RTX 4090: czasy, VRAM, dwa klipy bez poprawek.
 artykuły·Lokalny generator wideo AI: Wan 2.2, LTX i Kandinsky 6 na RTX 4090Który darmowy generator wideo AI uruchomisz na własnej karcie i legalnie użyjesz w Polsce?
 artykuły·Najlepszy lokalny model AI po polsku: test 10 modeli na 8-24 GB VRAMKtóry lokalny LLM najlepiej radzi sobie z polskim na karcie 8, 12, 16 i 24 GB?
 artykuły·Napisy do filmu za darmo: Whisper lokalnie, skrypt i Subtitle Edit
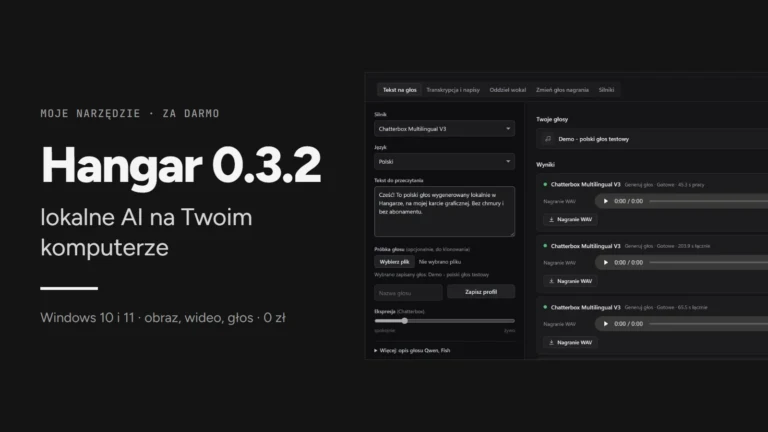 lokalne ai·Hangar: darmowe lokalne modele AI na Windowsie - obraz, wideo, muzyka i głos
 artykuły·ACE-Step 1.5 lokalnie: polska piosenka na RTX 4090 - test
 artykuły·Lokalny czat z PDF po polsku: RAG w Ollamie, skrypt i testDziałający lokalny czat z dokumentem PDF po polsku: gotowy skrypt w Pythonie, Ollama i bge-m3.
 artykuły·GGUF i kwantyzacja: Q4_K_M, Q6_K czy Q8_0? Test Bielika na RTX 4090Co to jest GGUF, co znaczą Q4_K_M, Q5_K_M, Q6_K, Q8_0 i IQ oraz który wariant wybrać.
 artykuły·basal lokalnie: Ollama, llama.cpp i Mac. Uruchomiłem polski model decyzyjny na RTX 4090Krok po kroku: basal-omni-1.0-mini w GGUF przez Ollamę na Windowsie, warianty dla llama.cpp i Maca.
 artykuły·Pinokio: instalacja aplikacji AI jednym kliknięciem - test (2026)
 artykuły·Mówiąca AI influencerka lokalnie: Kandinsky 6 i Wan 2.2
 artykuły·AI influencerka bez plastiku: 5 postaci na 5 lokalnych modelach