


Gemini Omni 1.2 Flash
Klipy do 15 sekund, 30% taniej, edycja w rozmowie.
- Mój test 24 klipów: polskie dialogi, obrót kamery, 4K
- Porównanie z Veo, Kling, Seedance i Wan
 artykuły · 5.11
 artykuły · 5.11
 narzędzia · 5.11
Ceny i premiery
Ceny 25 serwisów w złotych, moje oceny, premiery tydzień po tygodniu i Netflix Top 10 dla Polski.
 artykuły · 1.11
Zelda okiem 20 artystów
Hyrule w stylu Hokusaia, van Gogha, Klimta, Wyspiańskiego i Beksińskiego.
- 60 obrazów i GIF z 20 stylami
- Cała seria za ok. 2,50 USD w GPT-Image-2.6
Atlas gracza i galerie AI
Dwa tomy Atlasu gracza: 100 gier u mistrzów Zachodu i 72 w stylu Hokusaia, Mœbiusa i mangi.
- Przepis i prompty bez nazwisk artystów
- 18 obrazów z popkultury przeniesionej do Polski
-
 artykuły · 5.11
Leonida w trzech spojrzeniach: 39 kadrów GTA VI i 117 plakatów w stylu 28 artystów
-
 artykuły · 5.11
Tusz i piksel: 72 gry w stylu Hokusaia, Mœbiusa i mistrzów mangi. Atlas gracza, tom drugi
-
artykuły · 5.11
Zelda: Ocarina of Time okiem 20 wielkich artystów. Od Hokusaia i van Gogha po Beksińskiego
ChatGPT Images 2.6
GIF-y w ChatGPT i dwa nowe modele w API - Flare robi obraz w 8 sekund.
- Polskie napisy bez błędów w każdym teście
- Ta sama stawka co 2.5, ale 3x więcej tokenów
-
artykuły · 5.11
Leonida w trzech spojrzeniach: 39 kadrów GTA VI i 117 plakatów w stylu 28 artystów
-
artykuły · 5.11
Zelda: Ocarina of Time okiem 20 wielkich artystów. Od Hokusaia i van Gogha po Beksińskiego
-
 artykuły · 5.11
Western o sołtysie, VHS z blokowiska i Maluch 2084. 18 obrazów z GPT-Image-2.6
Gemini 4 Carbon
Najmocniejszy model Google: 1. miejsce w Artificial Analysis i rekordy w cyberbezpieczeństwie.
- 17 z 19 testów wygranych według Google
- Ta sama cena API co Argon: 2 / 10 USD
- Na razie tylko program Fairwind, w Polsce jeszcze nie
-
artykuły · 12.11
Najlepsze modele AI: listopad 2026. Ranking w 5 kategoriach z cenami (tekst, kod, obraz, wideo, muzyka)
-
 newsy · 10.11
Gemini 4 Carbon dostępny dla wszystkich - cena, jak używać i pierwszy test
-
 artykuły · 28.10
Gemini 4 Carbon vs Argon: test na tych samych zadaniach, cena i który wybrać
Jantaris: modele AI w złotówkach
Jedno saldo w złotówkach do 85 modeli AI - BLIK, faktura VAT, bez abonamentu.
- Obraz od 0,09 zł, klip Veo 3.1 od 1,02 zł
- API zgodne z SDK OpenAI i Anthropic
- Nieudana generacja kosztuje 0 zł
 artykuły · 7.11
 artykuły · 5.11
 artykuły · 4.11
Wszystkie tematy
30 hubów z testami i przewodnikami Lokalne AITekst, obrazy, wideo i muzyka na własnej karcie - testy na RTX 4090 i darmowy Hangar.
59 tekstów → PublicystykaEseje o tym, co AI robi z pracą, państwem, pieniędzmi i nami - na weekend.
40 tekstów →- PromptowyAI w edukacjiKtóre AI do nauki, pracy dyplomowej i lekcji - z cenami w złotych.
32 tekstów →  Kimi K3.1 ProNastępca Kimi K3: 2,8 bln parametrów, 1 mln tokenów kontekstu i tańsze API.
7 tekstów → Otwarte modele AIMeta, DeepSeek, StepFun i Nvidia otworzyły wagi czterech dużych modeli w trzy dni.
15 tekstów → Nano Banana 2.1Nowy model obrazowy Google - w API za połowę ceny Nano Banana 2.
9 tekstów → AI do programowaniaOpus 5.5 w Antigravity, Cursor traci modele OpenAI, Codex z GPT-6.1 Sol.
21 tekstów → Mistral Large 4Największy model Mistrala w API od 6.10, otwarte wagi do końca miesiąca.
4 tekstów →- Areny PromptowegoPorównaj AI samDwie interaktywne areny z wynikami moich testów - bez głosowań i reklam.
11 tekstów →  Tłumaczenie i transkrypcjaTen sam polski tekst z 13 idiomami w 6 tłumaczach.
5 tekstów → Kalendarz AIPremiery modeli, konferencje i terminy prawa w jednym miejscu.
5 tekstów → Grafika AITen sam zestaw poleceń w 4 modelach: kto bezbłędnie pisze po polsku.
25 tekstów → Qwen-Image-2.1Najlepszy otwarty model obrazowy w rankingu Artificial Analysis.
16 tekstów → ElevenLabs i głos AIEleven v4 po polsku na tle 13 modeli - nagrania do odsłuchu i ceny w złotych.
20 tekstów → FLUX 3 ImagePierwsze prawdziwe 4K, obiekty w ramkach i edycja bez psucia zdjęcia.
14 tekstów → Ideogram 4.5Model do edycji, który nie psuje zdjęcia po kolejnych poprawkach.
9 tekstów → Muzyka AITa sama polska piosenka w 7 modelach - do odsłuchania.
41 tekstów → Cloudflare: hub i nowościObsługuje ruch do 26,5% stron w sieci - co daje za darmo i jak traktuje boty AI.
19 tekstów → Claude DuetAgent Anthropic na Opusie 5.5, który odzywa się pierwszy: poranny brief i zadania w chmurze.
3 tekstów →- Przypadki AIPrzypadki AIInPost, PKO BP, deepfake i agenty na cudzej wiki - z liczbami i źródłami.
10 tekstów →  Hangar - lokalne AI na Twoim komputerzeObrazy, klipy, piosenki i polski głos z AI na własnej karcie NVIDIA - darmowy program na Windows.
8 tekstów → GPT-6.1 TerraŚredni model GPT-6 za połowę ceny Sol, tylko w ChatGPT Work, Codex i API.
13 tekstów → Kling 4.0: 6 filmów i mój testZwiastun, sitcom, teledysk disco polo, reklama, dokument i horror - po 30 s w 1080p
27 tekstów →- Ścieżka od zeraZbuduj własnego agenta AIOd pierwszego zapytania do API po agenta z narzędziami - z kodem, który uruchomiłem.
18 tekstów →  Modele otwarte11 wariantów na 5 zadaniach po polsku, część lokalnie na RTX 4090.
10 tekstów → Ranking muzyki AIRanking Artificial Analysis z 7.10 i ta sama polska piosenka w każdym modelu.
41 tekstów → FLUX 3 Max10 sekund wideo w 9,5 s generowania - sprawdziłem obietnicę BFL z Polski.
6 tekstów → Polski basal i modele decyzyjnePolski model decyzyjny Remka Kinasa prowadzi wśród otwartych modeli w JevBench.
22 tekstów → AI ActKRiBSI może karać od 28 października, polska ustawa o AI już w mocy.
30 tekstów → Perplexity10 pytań o polskie sprawy z ostatnich dni, każda odpowiedź sprawdzona u źródła.
15 tekstów →
Siła LoRA (LoRA weight)
LoRA to mały dodatek do modelu, który uczy go jednego stylu, postaci albo przedmiotu, a jej siła mówi, jak mocno ten dodatek ma działać. Przy zerze model działa jak bez LoRA, przy wysokich wartościach styl dominuje i zaczyna psuć obraz.
Spotkasz też jako: LoRA strength, lora scale, strength_model, <lora:nazwa:0.8>
Przed i po: mój test
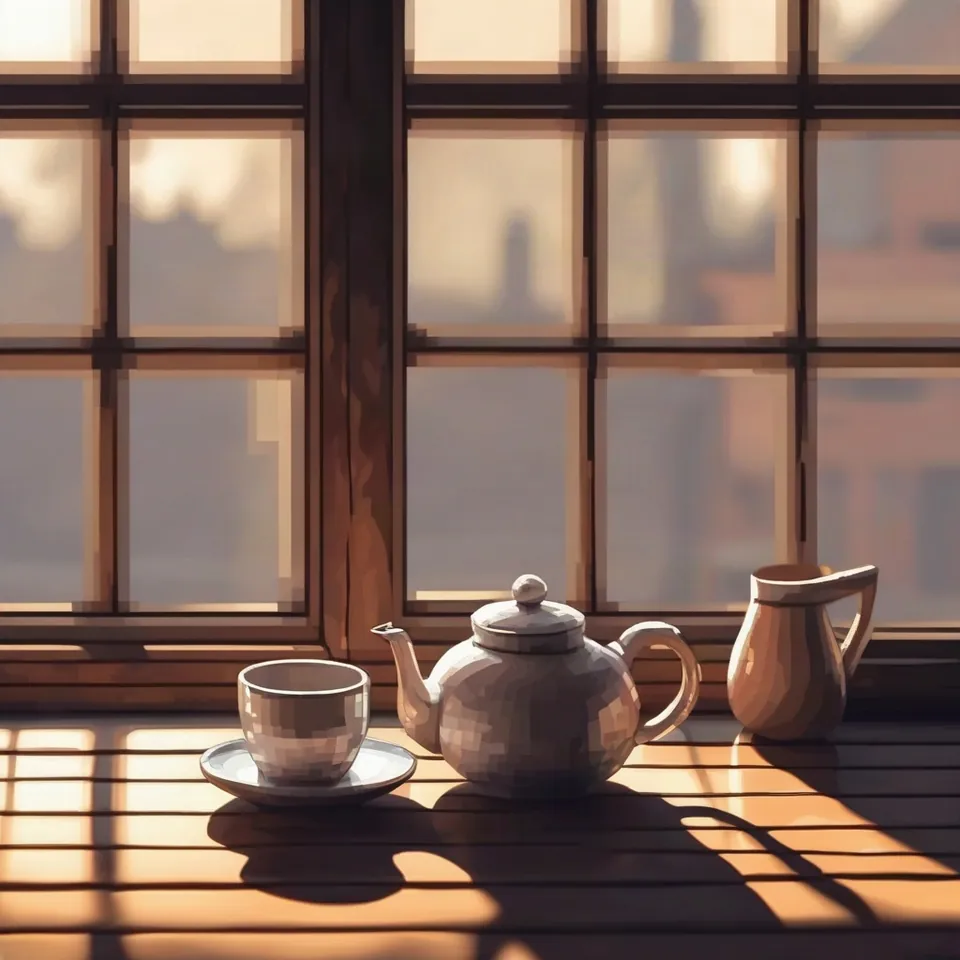
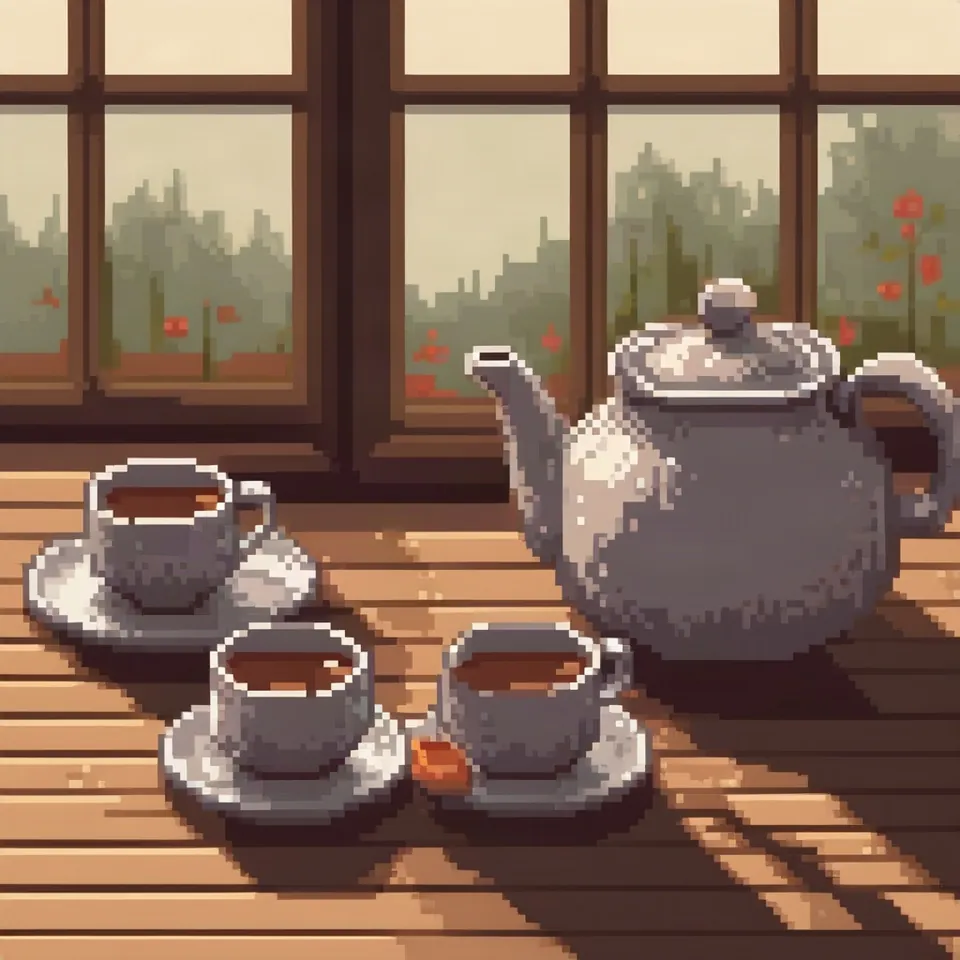
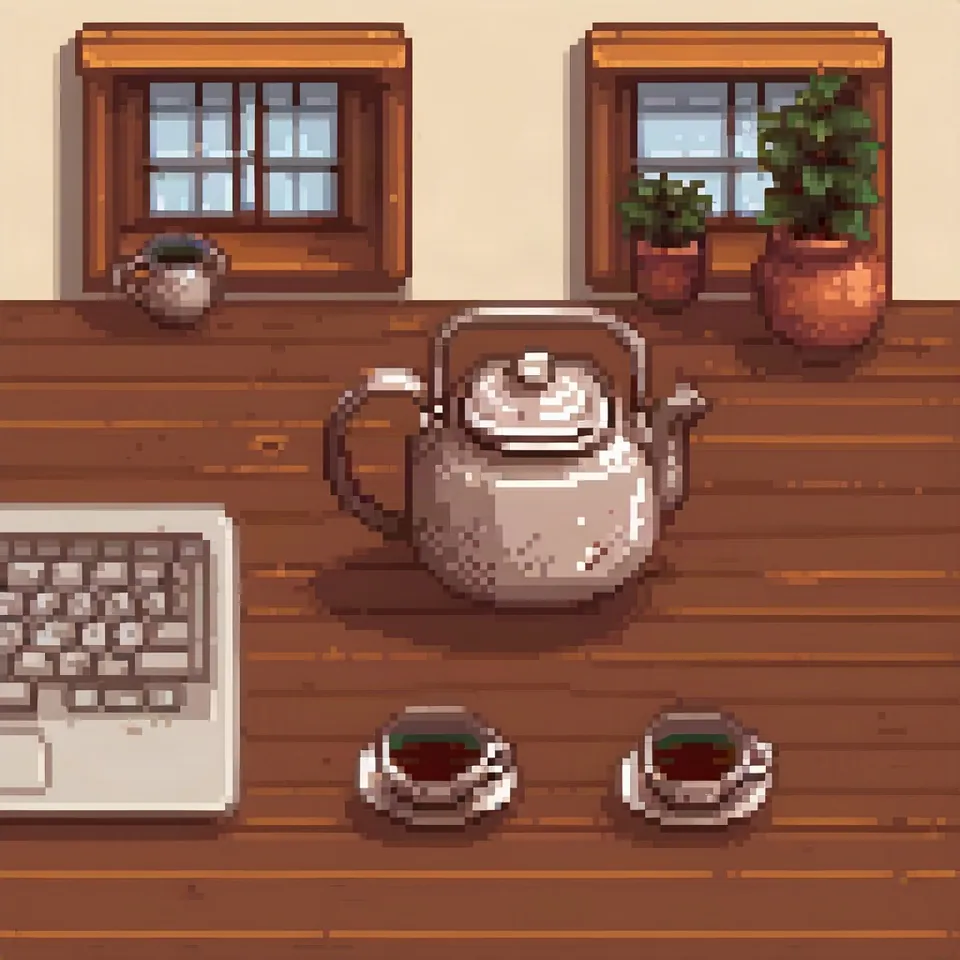
Model: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Ustawienia: seed 1411, zmienia się tylko siła LoRA. Data: 14.11.2026.
Prompt: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
Przy zerze SDXL zrobił zwykłe zdjęcie - samo "pixel art" w prompcie nie wystarczyło. Przy 0,6 dostałem czystą grafikę pikselową z zachowaną sceną. Przy 1,2 styl był najmocniejszy, ale model dorysował na stole klawiaturę laptopa, której nie było w prompcie. Za wysoka siła wnosi do obrazu rzeczy z danych, na których LoRA była uczona.
Jak to się nazywa w każdym generatorze
| Generator | Parametr | Wartości | Domyślnie |
|---|---|---|---|
| FLUX | LoRA na FLUX 3 Image Klein (open weights) / FLUX.2 [klein] trainingTrening na Klein Base; przykład: rank 32, 20 obrazów, 4000 kroków, lr 1e-4, ok. 4,5 h na 1 GPU | skala LoRA 0.5-1.0 (przykład 0.75 na Distilled) | - |
| Ideogram | custom_model_uri (modele własne 3.0/4.0)Brak parametru siły | model/<nazwa>/version/<wersja> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipDomyślna i krok z kodu nodes.py; docs.comfy.org podaje tylko zakres | -100.0 do 100.0, krok 0.01 | 1.0 |
| Midjourney | brak | - | - |
| GPT Image | brak | - | - |
| Stability AI (SD 3.5) | brak w API | - | - |
- Źródła, odczyt 14.11.2026:
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
Kiedy tego używać
- 0,5-0,8 jako punkt startu dla stylu
- bliżej 1,0 dla postaci i przedmiotów, które mają być wierne
- przy kilku LoRA naraz obniż każdą, bo efekty się sumują
Typowy błąd
Brak słowa wyzwalającego. Wiele LoRA działa dopiero z konkretnym słowem w prompcie (tu: pixel art) - bez niego w moim pierwszym podejściu LoRA nie zmieniła nic. Drugi błąd: siła powyżej 1 "dla pewności", która kończy się artefaktami.
Gotowy przykład do skopiowania
ComfyUI:  Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge:  pixel art, dzbanek <lora:pixel-art-xl:0.6>
FLUX.2 przez API (np. fal): "loras": [{"path": "...", "scale": 0.6}]Pytania
Jaką siłę LoRA ustawić?
Zacznij od 0,6-0,8. Jeśli styl jest za słaby, podnoś po 0,1. Jeśli pojawiają się dziwne elementy, obniż.
Czy LoRA działa w Midjourney albo GPT Image?
Nie. LoRA dotyczy modeli z otwartymi wagami: Stable Diffusion, FLUX z otwartymi wagami, Qwen-Image lokalnie.