

Megawat, 60 milionów dolarów i wyścig o każdy token - jak NVIDIA liczy zwrot z fabryki AI
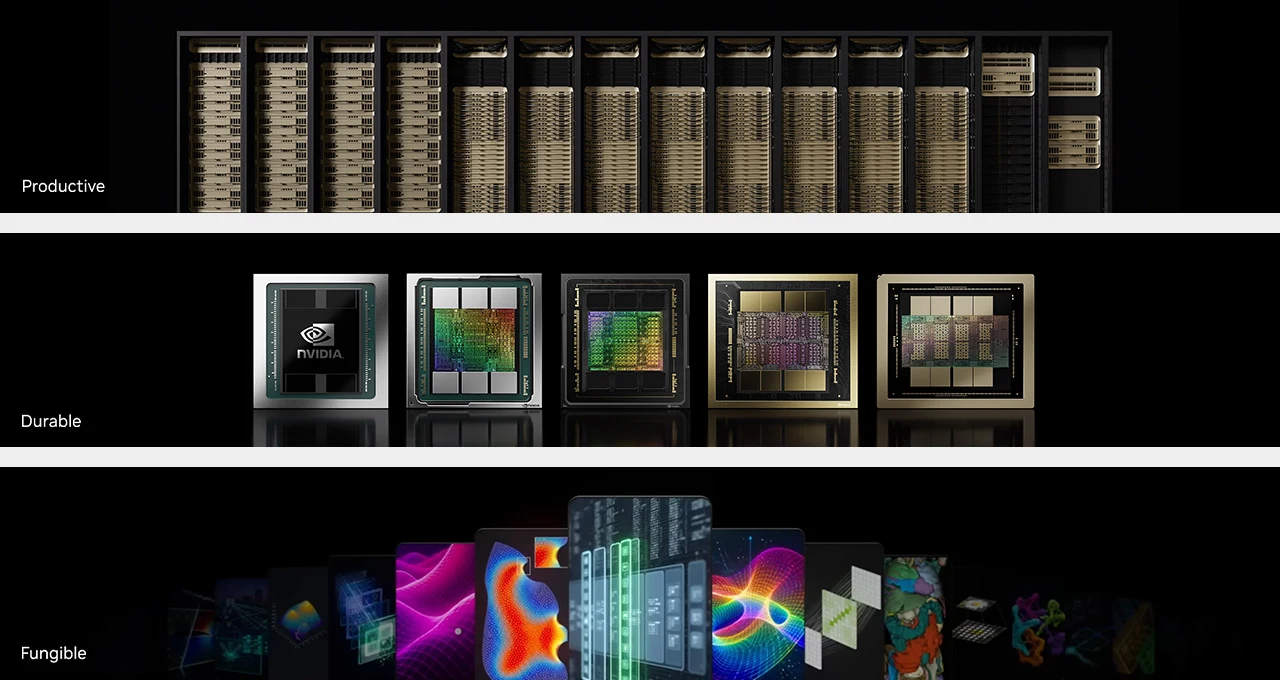
NVIDIA opublikowała szczegółową analizę ekonomiki tzw. fabryk AI, twierdząc, że jej systemy - od GB300 po Vera Rubin - są zaprojektowane tak, by maksymalizować trzy kluczowe wskaźniki zwrotu: przepustowość, trwałość i wszechstronność.
Spis treści 3
Ten news ukazał się 13 min po komunikacie źródła.
👁 157 przeczytań
Jeden megawat. Tyle kosztuje 60 milionów dolarów - i to właśnie w megawatach operatorzy mierzą dzisiaj swoje fabryki AI. Nie w liczbie serwerów, nie w liczbie GPU, lecz w poborze mocy. A gdy centrum danych rośnie do rozmiarów gigawatowych, rachunek za samą infrastrukturę zamienia się w sumę, która wymaga absolutnej pewności co do zwrotu z inwestycji.
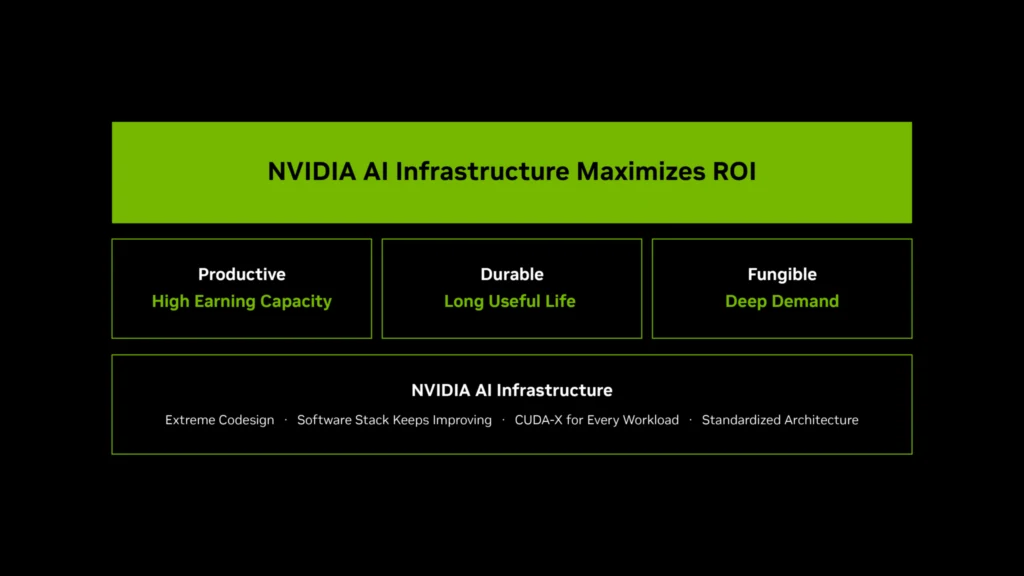
Na tym prostym fakcie NVIDIA zbudowała obszerny dokument strategiczny opublikowany na swoim blogu korporacyjnym, w którym próbuje odpowiedzieć na pytanie, które zadaje sobie każdy operator hurtowni obliczeniowej: skąd mam wiedzieć, że ten sprzęt mi się zwróci? Odpowiedź firmy sprowadza się do trzech słów - produktywny, trwały, zamienny - i całkiem konkretnych liczb, które za tymi słowami stoją.
Tokeny na megawat - nowa waluta rentowności
Zanim zrozumie się ekonomikę fabryki AI, trzeba zrozumieć, czym właściwie handluje. Nie serwerem. Nie czasem GPU. Tokenami - jednostkami tekstu, obrazu lub kodu, które model językowy produkuje w odpowiedzi na zapytanie. To token jest atomem rozliczeń między dostawcą infrastruktury a klientem końcowym. I to token decyduje o marży.
Stąd kluczowy wskaźnik: tokeny na sekundę na megawat. Im więcej tokenów w granicach stałego poboru mocy, tym wyższy przychód z każdego kilograma infrastruktury. Im niższy koszt wyprodukowania miliona tokenów, tym wyższa marża na każdej transakcji.
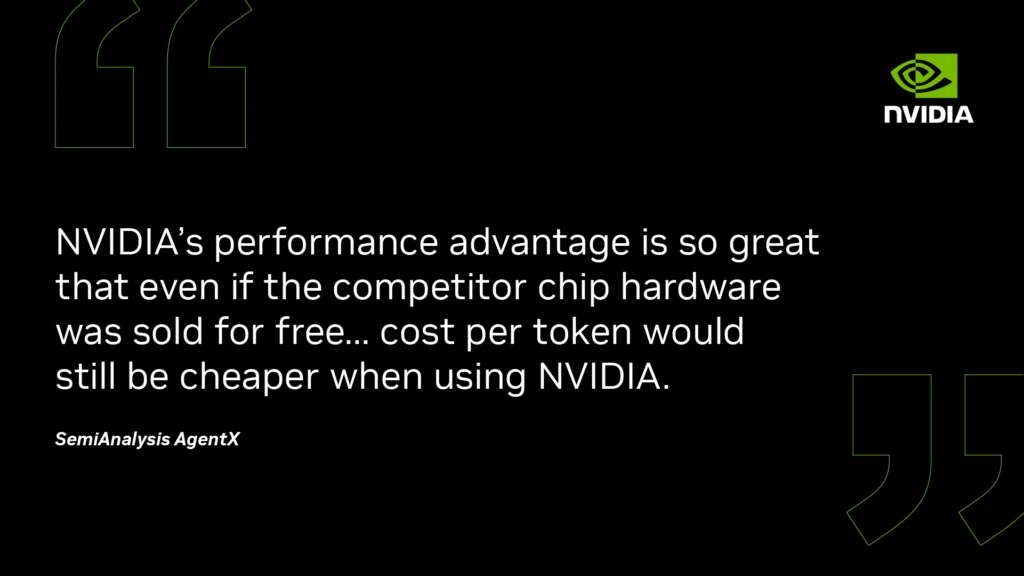
Dane, na które powołuje się NVIDIA, pochodzą z analizy SemiAnalysis AgentX i dotyczą porównania dwóch generacji sprzętu firmy. Systemy Vera Rubin NVL72 - najnowsza architektura - mają według tej analizy osiągać ponad 30-krotnie wyższą przepustowość na megawat niż systemy GB300 NVL72. Na modelu DeepSeek V4 Pro różnica w koszcie na milion tokenów sięga 45-krotności. To nie są liczby z marginesu - to przepaść między generacjami, która całkowicie zmienia rachunek ekonomiczny operatora.
NVIDIA tłumaczy tę skalę pojęciem codesign: ścisłego współprojektowania modeli, oprogramowania, sieci, pamięci i układów obliczeniowych jako jednego systemu, nie zestawu komponentów. Każda warstwa jest optymalizowana pod kątem każdej innej. Efekt - i tu firma nie stroni od autopromocji - ma być wyraźnie widoczny właśnie w tokenach na megawat.
Ale tu pojawia się paradoks. Jeśli każda generacja sprawia, że tokeny są dramatycznie tańsze, czy nie oznacza to, że zapotrzebowanie na moc obliczeniową w końcu maleje? NVIDIA odpowiada na to pytanie wprost i bez owijania w bawełnę: nie, rośnie. Tańsze tokeny sprawiają, że opłacalne stają się zastosowania, które wcześniej były zbyt drogie. A nowe zastosowania konsumują więcej tokenów, niż zaoszczędziła sama efektywność. To klasyczna dynamika indukcji popytu - znana z historii dysków twardych, łączy internetowych i procesorów konsumenckich.
A100 z 2020 roku nadal zarabia pieniądze
Drugi filar argumentacji NVIDIA to trwałość. I tutaj firma sięga po przykład, który brzmi zaskakująco w branży słynącej z rocznych cykli wymiany sprzętu.
GPU NVIDIA A100 zadebiutował w 2020 roku. Pięć lat później, w 2025 roku, wciąż pracuje komercyjnie - i to nie w jakimś muzeum informatyki, lecz w realnej infrastrukturze wynajmowanej przez klientów. Firma CoreWeave, jeden z największych operatorów infrastruktury AI na świecie, przedłużyła rezerwacje jednostek A100 pierwotnie wprowadzonych do użytku w 2020 roku aż do 2029 roku. Oznacza to co najmniej dziewięć lat aktywnej służby komercyjnej dla sprzętu, który - w ogólnym wyobrażeniu - powinien był dawno trafić na złom.
To nie jest przypadek ani wyjątek. NVIDIA wskazuje, że kolejni wielcy operatorzy - rok po roku - wydłużali harmonogramy amortyzacji swoich serwerów. Amortyzacja to w tym kontekście finansowy szacunek momentu, w którym sprzęt przestaje zarabiać. Fakt, że te szacunki są systematycznie przesuwane w przyszłość, oznacza jedno: sprzęt zarabia dłużej, niż pierwotnie zakładano.
Raport Sprout z września 2026 roku zatytułowany The Productive Life of a Data Center GPU bada to zjawisko szczegółowo - choć pełna treść dokumentu nie jest publicznie dostępna, NVIDIA przywołuje go jako dowód na systemowy charakter tego trendu.
Zobacz wpis na X
Mechanizm jest logiczny. Nie każde zadanie wymaga najnowszego sprzętu. Modele produkcyjne o umiarkowanej złożoności, zadania wsadowe, przetwarzanie mniej wymagających zapytań - to workloady, które starsza generacja obsłuży sprawnie i taniej. Nowy sprzęt trafia do zadań wymagających maksymalnej przepustowości, stary zostaje tam, gdzie liczy się koszt jednostkowy, nie rekordowa prędkość.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Zamienność jako argument dla CFO
Trzecia cecha w narracji NVIDIA - zamienność, czyli fungibility - jest być może najtrudniejsza do wyjaśnienia, a zarazem finansowo najistotniejsza. Chodzi o zdolność tej samej infrastruktury do obsługi jak największej różnorodności zadań.
Fabryka AI, która może uruchamiać wyłącznie modele językowe pewnego rodzaju, jest uzależniona od popytu na jeden typ usługi. Fabryka, która obsługuje wnioskowanie, trenowanie, finetunning, a obok tego klasyczne obciążenia HPC czy renderowanie, ma znacznie większą pulę potencjalnych klientów i jest mniej wrażliwa na wahania popytu w jednym segmencie. Biblioteki NVIDIA CUDA-X mają właśnie to umożliwiać - uruchamianie dosłownie każdego przyspieszonego workloadu na tej samej platformie sprzętowej.
W praktyce oznacza to, że operator kupujący systemy NVIDIA nie kupuje tylko mocy do dzisiejszych modeli AI. Kupuje infrastrukturę, która - przynajmniej według tej narracji - będzie mogła przestawić się na zadania, których dzisiaj jeszcze nie ma.
Dokument NVIDIA nie jest neutralną analizą rynku. To przemyślany argument sprzedażowy skierowany do osób podpisujących kontrakty na setki megawatów mocy. Ale liczby, które padają w tym dokumencie - 60 milionów za megawat, 30-krotna różnica w przepustowości, dziewięć lat służby A100 - są wystarczająco konkretne, by traktować je poważnie przy podejmowaniu decyzji, które będą ciążyć przez dekadę.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · ASML wysyła do fabryk maszynę za 400 mln dolarów. Tranzystory o rozdzielczości 8 nanometrówHolenderski ASML rozpoczął dostawy nowej generacji maszyn litograficznych EUV, które pozwalają tworzyć układy o rozdzielczości 8 nanometrów.
 Premium · Serwery Nvidii za milion dolarów. Chiny płacą cenę za głód mocy obliczeniowejSerwery Nvidii za milion dolarów. Chiny płacą cenę za głód mocy obliczeniowej w wyścigu sztucznej inteligencji.
 Newsy · Największa fabryka AI w regionie WNP powstała w ArmeniiFirebird uruchomił największą fabrykę AI w regionie WNP - obiekt w armeńskim Hrazdan dysponuje mocą 300 MW i docelowo pomieści ponad 70 000 GPU...
- przelomowy.plHalucynacje AI w sądach: baza Charlotina po roku liczy ponad 1300 przypadków
- przewagi.plChatGPT Ads czy Google Ads w 2026: jak podzielić budżet i ile dać na test
- generatornia.plPrompt świąteczny do zdjęć AI: gotowe wzory portretów i produktów
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm