


AI dostała laboratorium na próbę. W 52 zadaniach najlepszy model zdobył 45 punktów na 100
W TwinLab-Bench modele planują doświadczenia i proszą o pomiary oparte na dokumentacji laboratoriów. Najwyższa średnia wyniosła 45 punktów na 100.
👁 111 przeczytań
Jeżeli dwie hipotezy przewidują ten sam wynik pomiaru, wykonanie tego pomiaru nie pomoże wybrać lepszej. W TwinLab-Bench model sam musi zdecydować, o jaki pomiar poprosić. Badacze zaprojektowali 52 zadania oparte na dokumentacji rzeczywistych laboratoriów. W pracy z 19 listopada najlepszy z ocenianych modeli, Claude Fable 5.2, uzyskał średnio 45 punktów na 100.
Laboratorium odpowiada danymi
Model otrzymuje problem, projektuje doświadczenie, a wirtualny odpowiednik laboratorium odpowiada na jego zapytania. Odpowiedzi opierają się na zachowanych materiałach z badań i obliczeniach powiązanych z tymi zapisami. Zespół przewidział ponad sto rodzajów czynności eksperymentalnych. W części zadań badacz ma do dyspozycji wyłącznie istniejącą dokumentację.
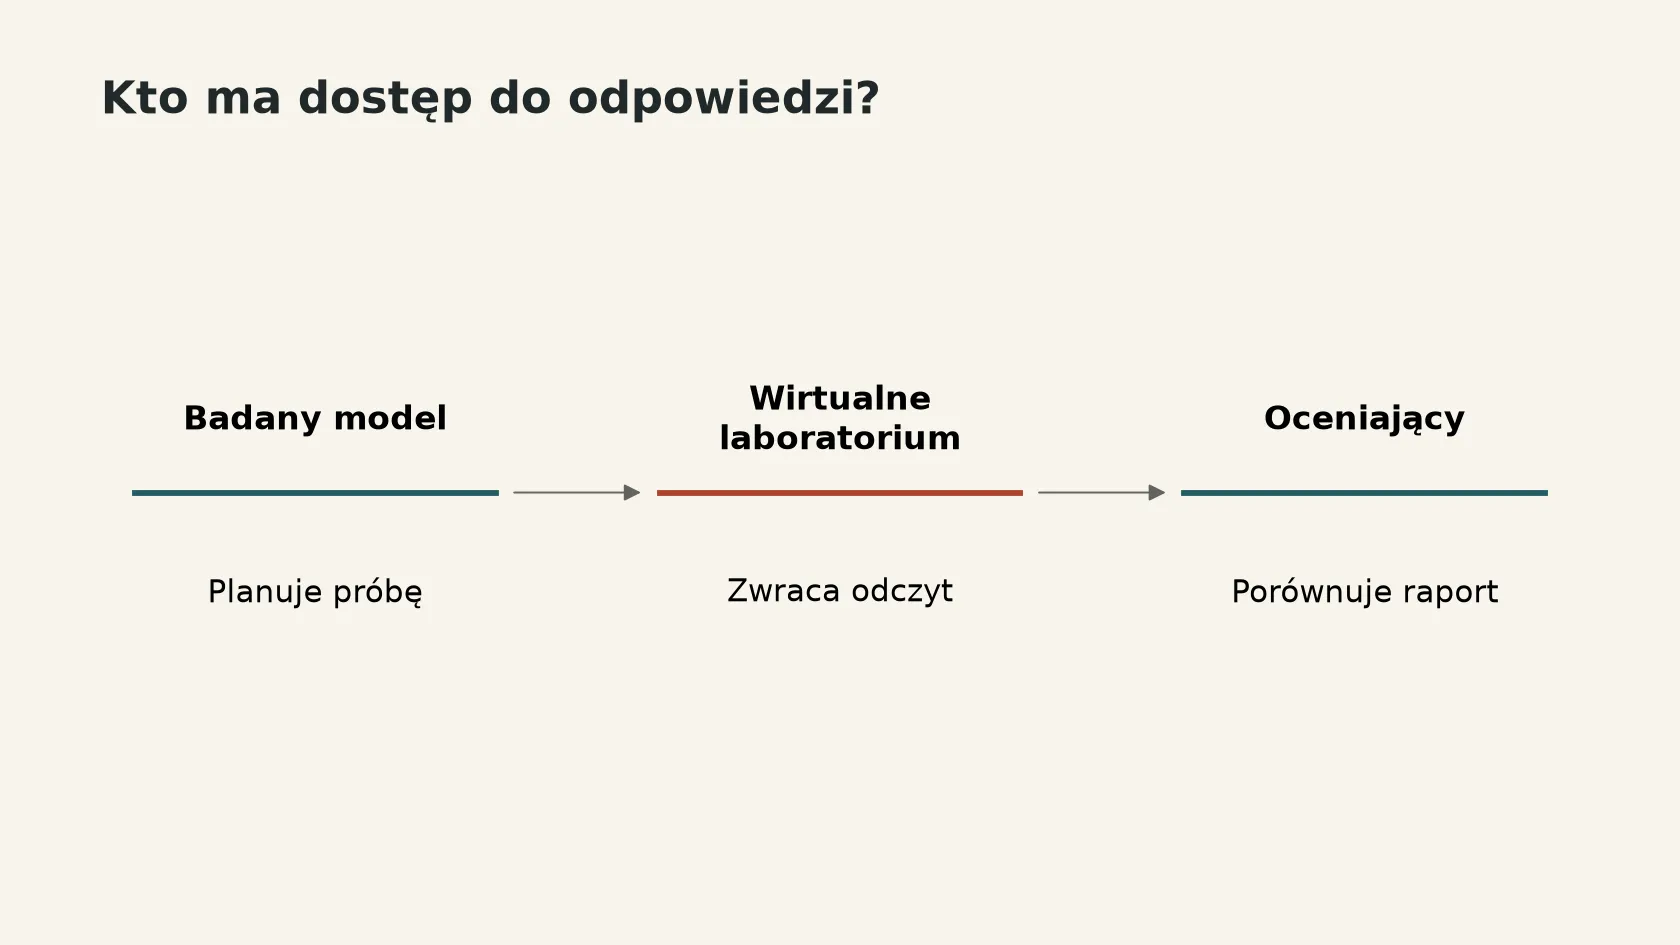
Taki układ pozwala ukryć wynik rzeczywistego doświadczenia przed badanym modelem, a zachować go dla oceniających. Autorzy sprawdzają też zachowanie modeli bez dostępu do wirtualnego laboratorium. Dobry wynik uzyskany z pamięci odpowiada na inne pytanie niż trafny wybór kolejnego pomiaru.
Jedna błędna decyzja może wyzerować raport
Ocena bierze pod uwagę raport końcowy i kryteria przypisane do każdego zadania. Wśród nich są warunki uznane przez autorów za konieczne. Niespełnienie takiego warunku może dać zero punktów za cały przebieg mimo poprawnych fragmentów raportu. Dlatego średni wynik 45/100 nie oznacza, że model rozwiązał dokładnie 45% doświadczeń.
Po lekturze przykładów najciekawszy wydaje mi się błąd, który autorzy opisują dla Opusa 5.5: przyjęcie wyjaśnienia bez przeprowadzenia próby rozróżniającej konkurencyjne mechanizmy. Raport może wtedy brzmieć przekonująco i zawierać sensowne liczby. Brakuje w nim właśnie pomiaru, który mógłby zmusić autora do zmiany zdania.
Stan na 21.11.2026, godz. 19:34 czasu polskiego.
Źródła
Więcej o tym temacie: Megaherc - polski ranking modeli AI

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 AI · Grok 4.6 kontra GPT-5.6 Sol i Fable 5: cztery rundy na żywych zadaniach i rachunek-niespodziankaGrok 4.6 kontra GPT-5.6 Sol i Claude Fable 5: cztery identyczne zadania przez API, rachunek co do grosza i niespodzianka: najdroższy cennik nie...
 AI · Modele AI: rodzaje, zastosowania i wybór do zadaniaModele AI do tekstu, obrazów, głosu i wideo. Sprawdź różnicę między modelem a aplikacją oraz sposób porównania kosztu gotowego wyniku.
- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI