


EgoCaptioner ogląda film z perspektywy oczu. Liczy się chwila, w której ręka wykonała ruch
50 tysięcy przykładów z ośmiu źródeł wideo pomaga modelowi wiązać opis z czasem. Autorzy sprawdzili, czy z opisu można odtworzyć kolejność zdarzeń.
👁 111 przeczytań
Nagranie z kamery noszonej na głowie rzadko ustawia scenę tak wygodnie jak film instruktażowy. Ręka wpada w kadr na moment, przedmiot znika za palcami, obraz przesuwa się wraz z głową. Wystarczy pomylić ruch kamery z ruchem przedmiotu, żeby zgrabny opis przestał się zgadzać z tym, co naprawdę widać. EgoCaptioner uczy model rozpoznawać także kolejność i moment tych zdarzeń.
Od całej sceny do ruchu dłoni
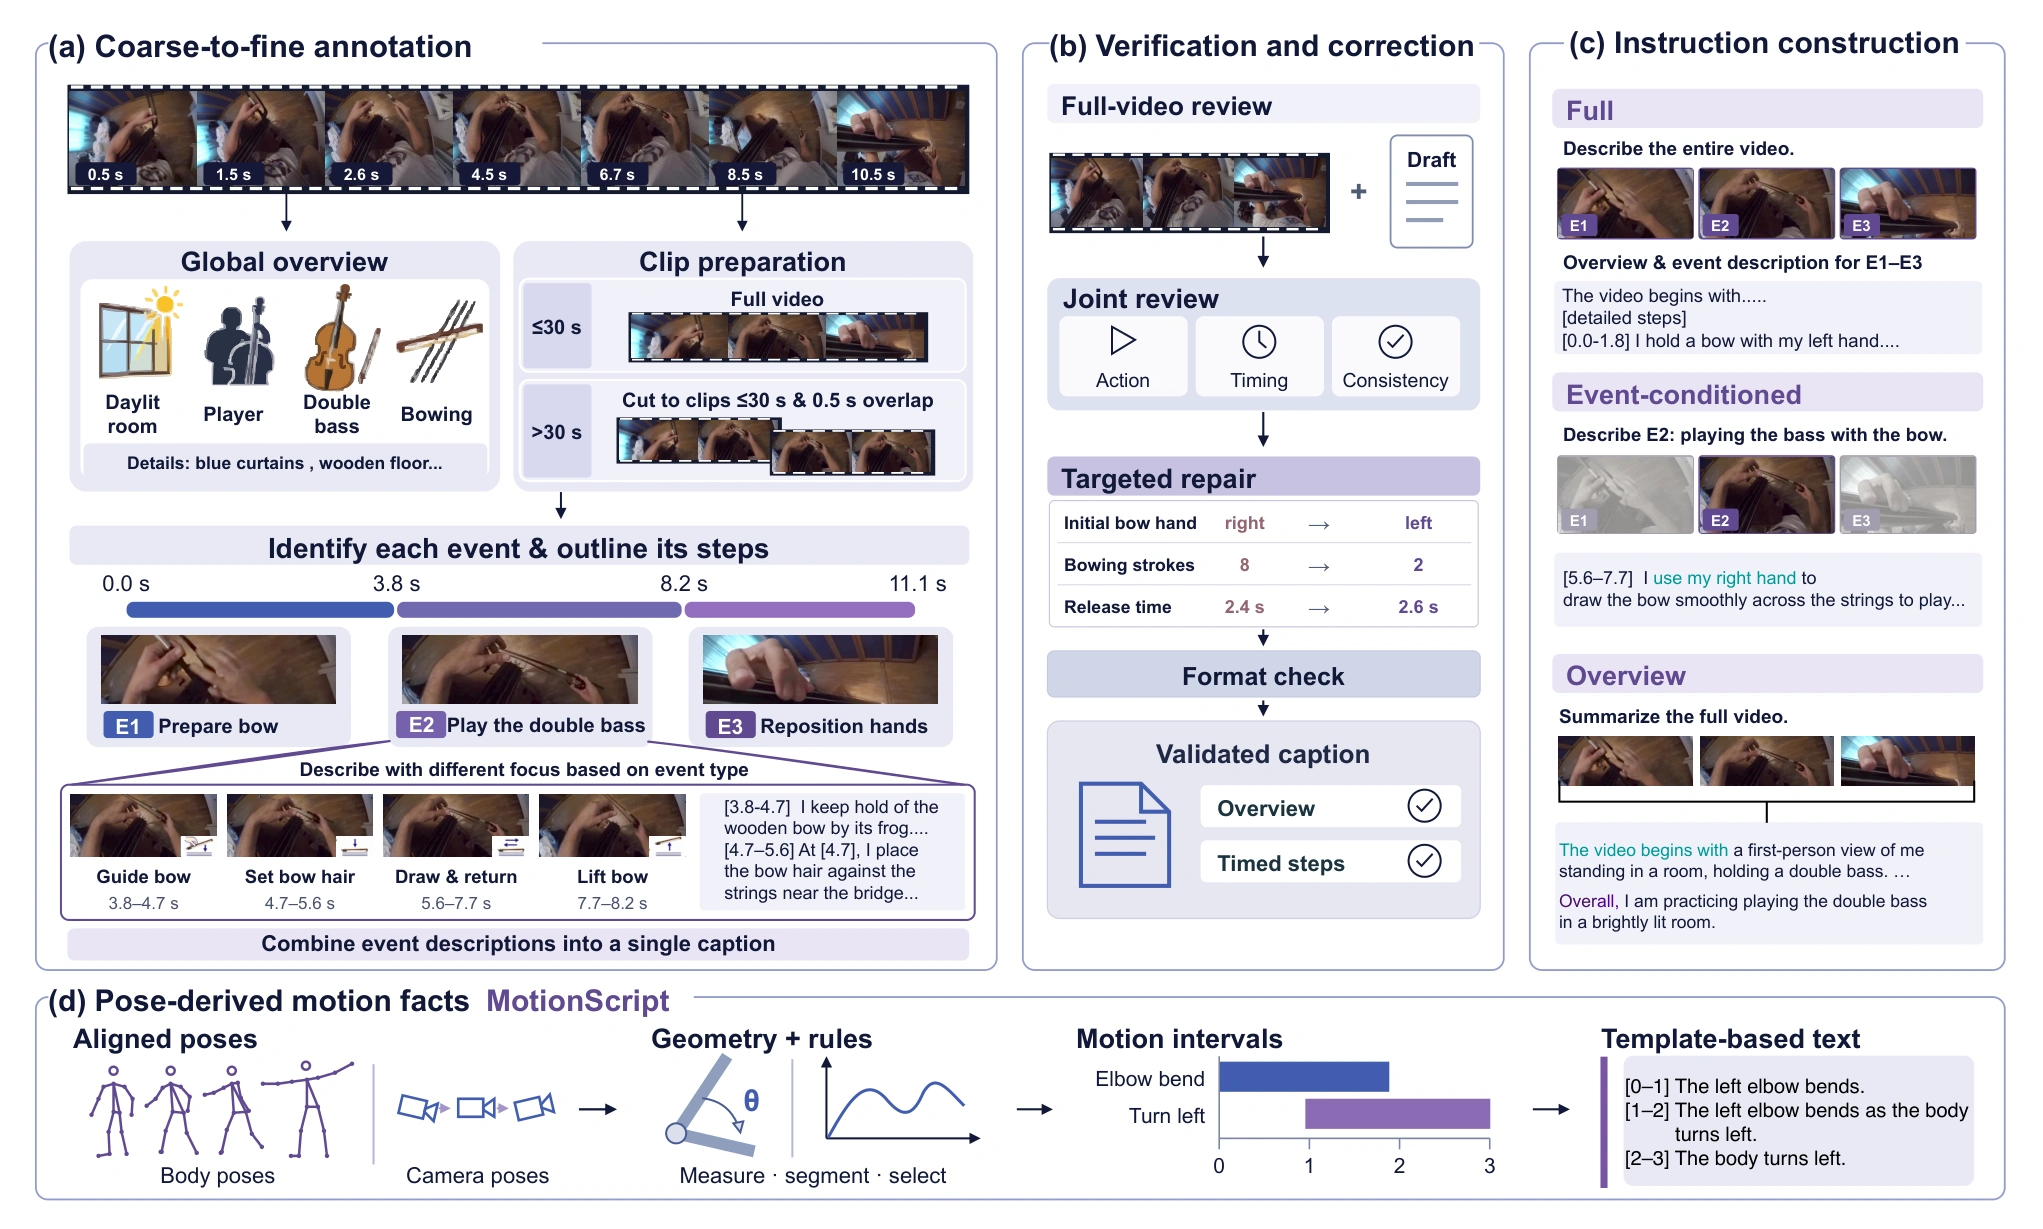
W pracy z 19 listopada zespół opisuje budowę 50 tysięcy przykładów treningowych z ośmiu źródeł nagrań z pierwszej osoby. Najpierw powstaje ogólny opis otoczenia, uczestników i zajęcia osoby noszącej kamerę. Potem autorzy wyodrębniają kolejne czynności i dopiero wtedy dopisują szczegóły związane z konkretnym czasem. Przy nagraniach z odpowiednimi czujnikami wykorzystują również informacje o ruchu wyprowadzone z pomiarów pozycji.
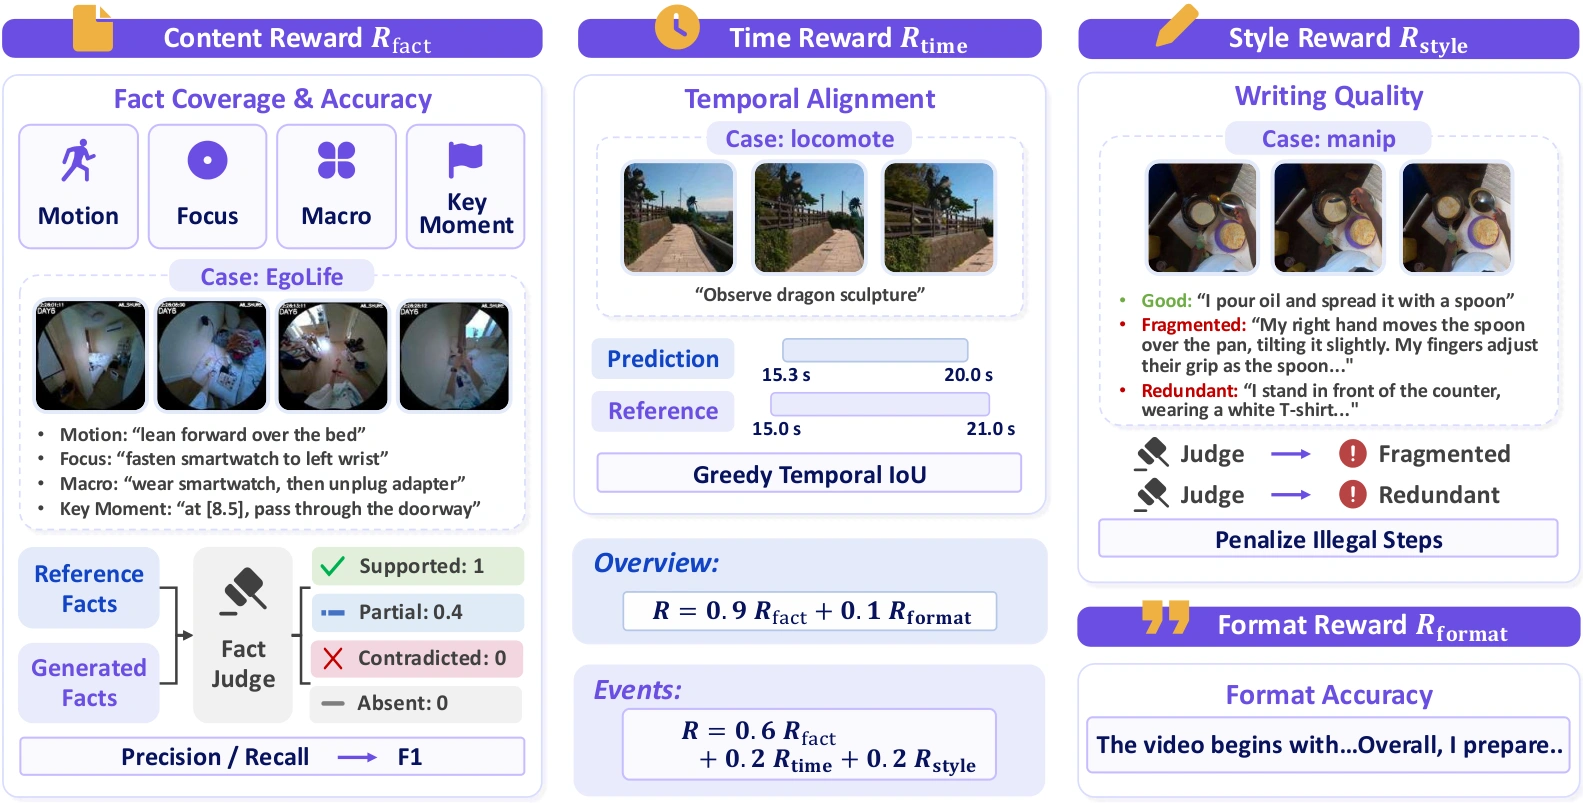
W treningu poprawny opis musi dobrze pokrywać fakty i zgadzać się z czasem w materiale. Kara dotyczy między innymi rozwlekania jednej czynności na kilka powtarzających się fragmentów. Łatwo wyobrazić sobie, jak to pomaga przy szukaniu krótkiego momentu: samo stwierdzenie „osoba przygotowuje posiłek” nie wskaże miejsca, w którym odstawiła naczynie.
Czy z podpisu można odpowiedzieć na pytanie
Autorzy porównali system w pięciu zestawach testowych. Szczególnie interesuje mnie próba, w której kolejny model odpowiada na pytanie na podstawie opisu wideo. Jeśli opis pominął krótki, ważny ruch, odpowiedź może być błędna mimo sprawnego języka. Na Minerva-Ego w tym właśnie wariancie autorzy raportują przewagę nad porównywanymi systemami zamkniętymi.
To preprint zespołu badawczego. Dobra pozycja w teście pytań opartych na podpisie mówi coś konkretnego o informacjach zachowanych w tym podpisie. Nie dowodzi jeszcze, że system zawsze ustali prawidłową kolejność w długim, nieprzerwanym nagraniu z dowolnej kamery.
Stan na 21.11.2026, godz. 19:34 czasu polskiego.
Źródła

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej


- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI