


Gemini 4 Hydrogen: planowanie pracy na długim dokumencie w jednym oknie
Jak zaplanować analizę i generowanie długiego tekstu w Gemini 4 Hydrogen, uwzględniając limit 1 048 576 tokenów oraz budżet na rozumowanie.
Spis treści 4
👁 111 przeczytań
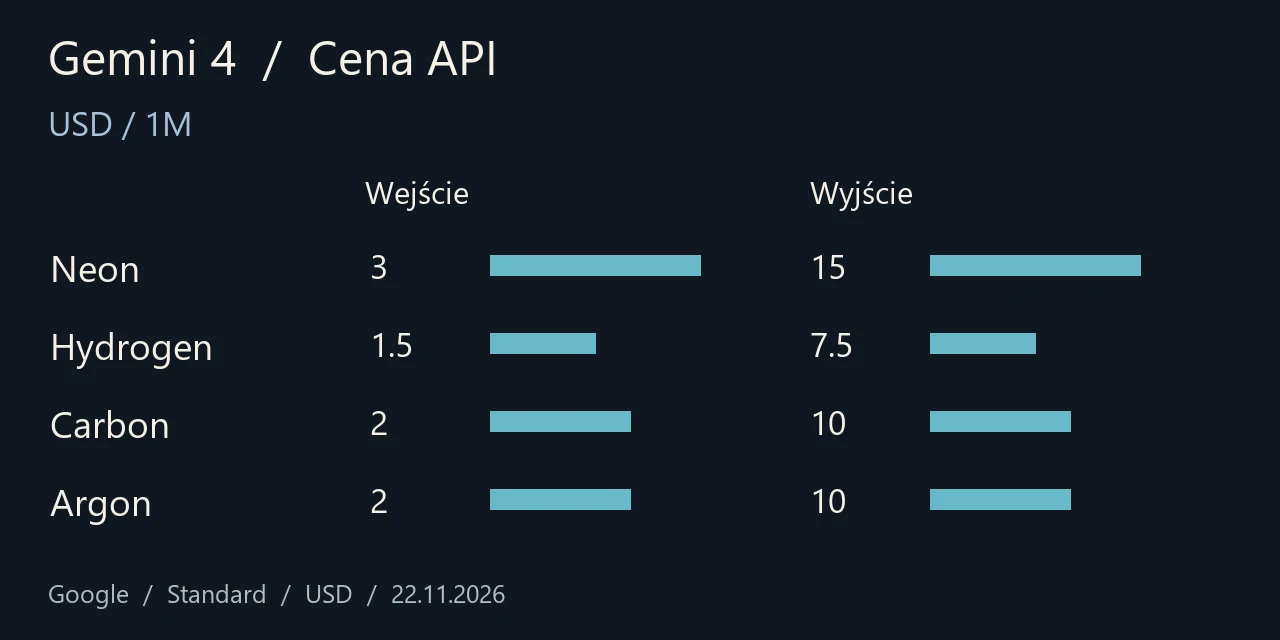
- Standard: Wejście 1.5 USD / Wyjście 7.5 USD.
- API: gemini-4-hydrogen
Cała rodzina nowych modeli, w tym Gemini 4 Hydrogen, korzysta ze zunifikowanego okna kontekstu o pojemności 1 048 576 tokenów. W praktyce oznacza to, że wszystkie elementy zapytania i odpowiedzi - czyli tekst wejściowy, wewnętrzne rozumowanie modelu oraz finalny tekst wyjściowy - dzielą tę samą, wspólną pulę. Planując pracę nad dużym dokumentem, trzeba ten podział uwzględnić z góry.
Hipotetyczny przykład pojemności
Załóżmy hipotetycznie, że musimy przeanalizować obszerny raport o objętości 800 000 tokenów. Po wgraniu takiego pliku do kontekstu w naszym wspólnym oknie pozostaje dokładnie 248 576 tokenów. Ten zapas musi wystarczyć na całą resztę operacji: zarówno na tokeny zużyte podczas rozumowania (thinking), jak i na właściwą odpowiedź tekstową. Jeśli raport miałby 1 000 000 tokenów, na myślenie i odpowiedź zostałoby już tylko 48 576 tokenów, co przy złożonym zadaniu mogłoby okazać się niewystarczające.
Limit pojedynczej odpowiedzi a kontynuacja
Nawet jeśli w oknie kontekstu zostało jeszcze sporo miejsca, obowiązuje nas drugie ograniczenie: domyślny limit pojedynczej odpowiedzi w Gemini 4 Hydrogen wynosi 65 536 tokenów. Oznacza to, że w jednym wywołaniu API model nie wygeneruje dłuższego tekstu.
Jeśli zadanie wymaga stworzenia opracowania przekraczającego ten próg, konieczna jest kontynuacja w kolejnych zapytaniach. Warunkiem powodzenia takiego procesu jest posiadanie wystarczającego budżetu w całym oknie 1 048 576 tokenów, ponieważ każda kolejna runda dolicza dotychczasową historię rozmowy do wejścia.
Punkty kontrolne i tekst końcowy
Warto pamiętać, że w limicie 65 536 tokenów pojedynczej odpowiedzi mieszczą się zarówno tokeny rozumowania, jak i finalny tekst widoczny dla użytkownika. Przy długich zadaniach najlepiej zaplanować jawne punkty kontrolne. Zamiast prosić o cały dokument naraz, warto podzielić pracę na logiczne sekcje, zapisywać stan pośredni po każdym etapie i w kolejnym kroku przekazywać jedynie niezbędne podsumowanie zamiast pełnej historii generowania.
Nie przepłacaj za subskrypcje AI
Prowadzę sklep z rocznymi dostępami do narzędzi AI, taniej niż w cenniku producenta. Sprawdź, co jest teraz na stanie.
Źródła
Najczęstsze pytania
Jaki jest identyfikator w API?
gemini-4-hydrogen
Ile wynosi cena za milion tokenów?
22.11.2026 (Standard): Wejście 1.5 USD / Wyjście 7.5 USD.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · Gemini 4 Hydrogen: powtarzalny wsad w raportach i cennik pamięci podręcznejJak działa niejawny cache w Gemini 4 Hydrogen przy cyklicznych raportach i ile kosztuje w porównaniu ze standardowym wejściem 1,50 USD za milion...
 Newsy · Gemini 4 Hydrogen: dobór głębokości rozumowania do rutyny i niejasnościKiedy zostawić domyślny poziom HIGH, a kiedy zejść do LOW w Gemini 4 Hydrogen? Praktyczna procedura oceny dla zadań rutynowych i złożonych.
 Newsy · Gemini 4 Neon i okno 1 048 576 tokenów: planowanie długich zadańJak zaplanować analizę długich dokumentów w Gemini 4 Neon: wspólny budżet 1 048 576 tokenów, limit 65 536 tokenów na odpowiedź i punkty kontrolne.
- przelomowy.plAnthropic przejął biotech z jednym pracownikiem: dwa przeciwciała na rzadką dystrofię mięśni
- dobieracz.plNano Banana (Gemini Image)
- dygot.plClaude ma nową aplikację. Czat stał się w niej tylko jedną z czterech kart
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
Komentarze 0
Wulgaryzmy, obrażanie i oskarżenia wobec osób lub firm sprawdzam ręcznie przed publikacją. Spam usuwam.
Nikt jeszcze nie skomentował. Napisz pierwszy komentarz.