


Gemini 4 Neon i okno 1 048 576 tokenów: planowanie długich zadań
Jak zaplanować analizę długich dokumentów w Gemini 4 Neon: wspólny budżet 1 048 576 tokenów, limit 65 536 tokenów na odpowiedź i punkty kontrolne.
Spis treści 3
👁 111 przeczytań
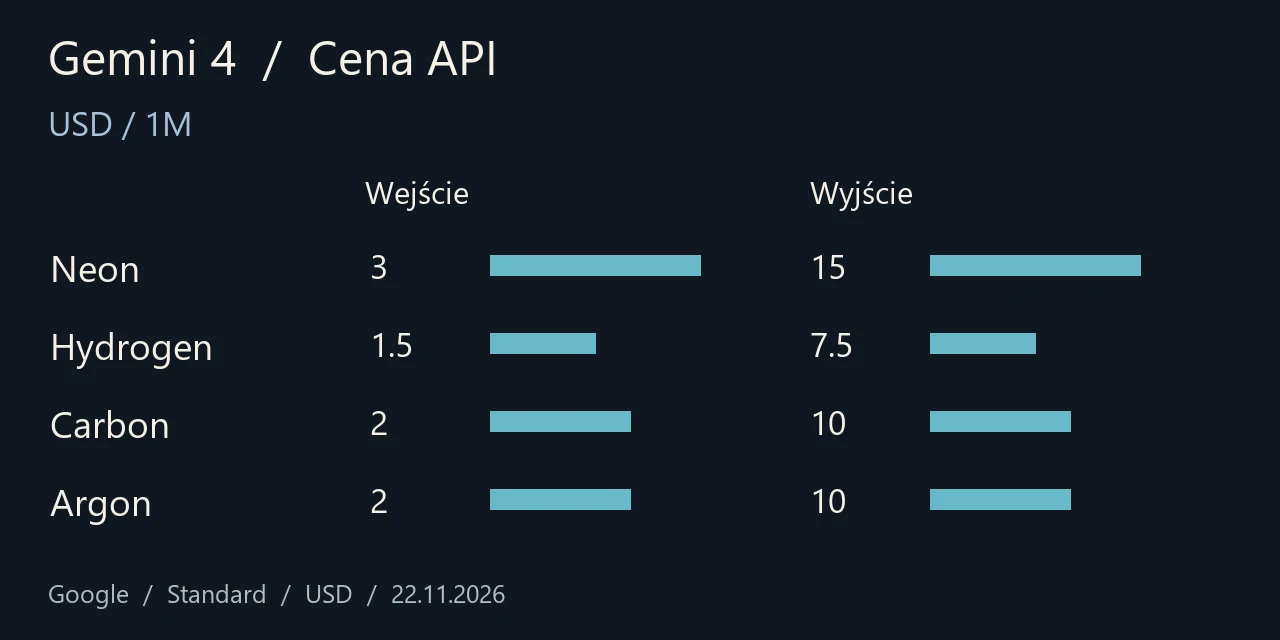
- Standard: Wejście 3 USD / Wyjście 15 USD.
- API: gemini-4-neon
Cała rodzina modeli, w tym Gemini 4 Neon, oferuje wspólne okno kontekstu o pojemności 1 048 576 tokenów. W praktyce oznacza to, że wejście, wyjście oraz wewnętrzne rozumowanie (thinking) dzielą dokładnie ten sam budżet. Przy długich dokumentach wymaga to świadomego planowania, zanim wyślesz pierwsze zapytanie.
Hipotetyczny przykład budżetu i limit pojedynczej odpowiedzi
Rozważmy hipotetyczny scenariusz analizy obszernej dokumentacji projektowej. Załóżmy, że dokument źródłowy zajmuje 800 000 tokenów na wejściu. W takim układzie w oknie 1 048 576 tokenów pozostaje 248 576 tokenów na całą resztę, czyli na rozumowanie oraz wygenerowany tekst.
Tutaj pojawia się drugie ograniczenie: domyślny limit pojedynczej odpowiedzi w Gemini 4 Neon wynosi 65 536 tokenów (dla Carbon i Argon w trybie bezpośrednim bez strumieniowania na pierwszym planie jest to 32 768 tokenów). Jeśli więc zlecisz wygenerowanie bardzo długiego raportu końcowego, model nie zmieści go w jednym kroku, nawet jeśli w ogólnym oknie zostało jeszcze ponad 200 000 tokenów.
Nie przepłacaj za subskrypcje AI
Prowadzę sklep z rocznymi dostępami do narzędzi AI, taniej niż w cenniku producenta. Sprawdź, co jest teraz na stanie.
Kontynuacja, punkty kontrolne i tekst końcowy
Aby bezpiecznie obsłużyć tak duże zlecenie, warto podzielić je na etapy:
- zaplanuj kontynuację: jeśli odpowiedź przekracza 65 536 tokenów, musisz wywołać kolejne zapytanie, upewniając się, że w oknie 1 048 576 tokenów nadal masz wystarczający zapas budżetu,
- stosuj punkty kontrolne: zamiast generować jeden wielki plik na końcu, proś o ustrukturyzowane podsumowania rozdziałów lub sekcji i zapisuj je po swojej stronie,
- kontroluj udział rozumowania: tokeny myślenia zużywają ten sam limit odpowiedzi (65 536) i ten sam budżet okna co finalny tekst, więc przy ustawieniu HIGH lub XHIGH na właściwą treść zostaje mniej miejsca.
Takie podejście chroni przed ucięciem odpowiedzi w połowie zdania i pozwala zachować pełną kontrolę nad kosztem oraz czasem wykonania zadania.
Źródła
Najczęstsze pytania
Jaki jest identyfikator w API?
gemini-4-neon
Ile wynosi cena za milion tokenów?
22.11.2026 (Standard): Wejście 3 USD / Wyjście 15 USD.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · Gemini 4 Neon - jak dobrać poziom rozumowania do zadaniaPraktyczny poradnik doboru poziomu rozumowania w Gemini 4 Neon między zadaniami rutynowymi a niejednoznacznymi wraz z procedurą oceny.
 Newsy · Gemini 4 Neon w teście zwrotów księgarni po polskuSprawdziłem Gemini 4 Neon na prostym polskim zadaniu rozliczenia zwrotów w księgarni. Zobacz interpretację wyniku, koszt i ograniczenia testu.
 Newsy · Gemini 4 Neon w API: ile kosztuje pojedyncze zlecenie w PLNPraktyczne wyliczenie kosztów Gemini 4 Neon w API: stawki za wejście, wyjście i rozumowanie oraz przelicznik na PLN według kursu NBP.
Komentarze 0
Wulgaryzmy, obrażanie i oskarżenia wobec osób lub firm sprawdzam ręcznie przed publikacją. Spam usuwam.
Nikt jeszcze nie skomentował. Napisz pierwszy komentarz.