


Trzecia recenzja coraz częściej powtarza pierwsze dwie. Badacze policzyli uwagi na ICLR
W dwóch edycjach ICLR nakładanie się zastrzeżeń wzrosło z 12,0 do 21,3%. Badanie sprawdza rolę AI i pokazuje, czego detektor tekstu nie rozstrzygnie.
👁 111 przeczytań
Gdy trzech recenzentów znajduje tę samą pomyłkę w artykule, autor dostaje wyraźny sygnał do poprawki. Gorzej, jeśli wszyscy przeoczyli drugą, poważniejszą wadę. W pracy opublikowanej 19 listopada badacze policzyli, ile różnych zastrzeżeń wnoszą czytelnicy tego samego artykułu naukowego. W recenzjach konferencji ICLR ta różnorodność spadła.
Jednostką jest konkretna uwaga
Badacze rozłożyli recenzje na pojedyncze zarzuty i grupowali uwagi odnoszące się do tego samego problemu. Dzięki temu dwaj recenzenci nie muszą użyć identycznych słów, żeby ich zastrzeżenia uznać za pokrywające się. Porównano materiały na tym samym etapie procesu. Rocznik 2027 oznacza edycję konferencji, której recenzje są już dostępne w listopadzie 2026 roku.
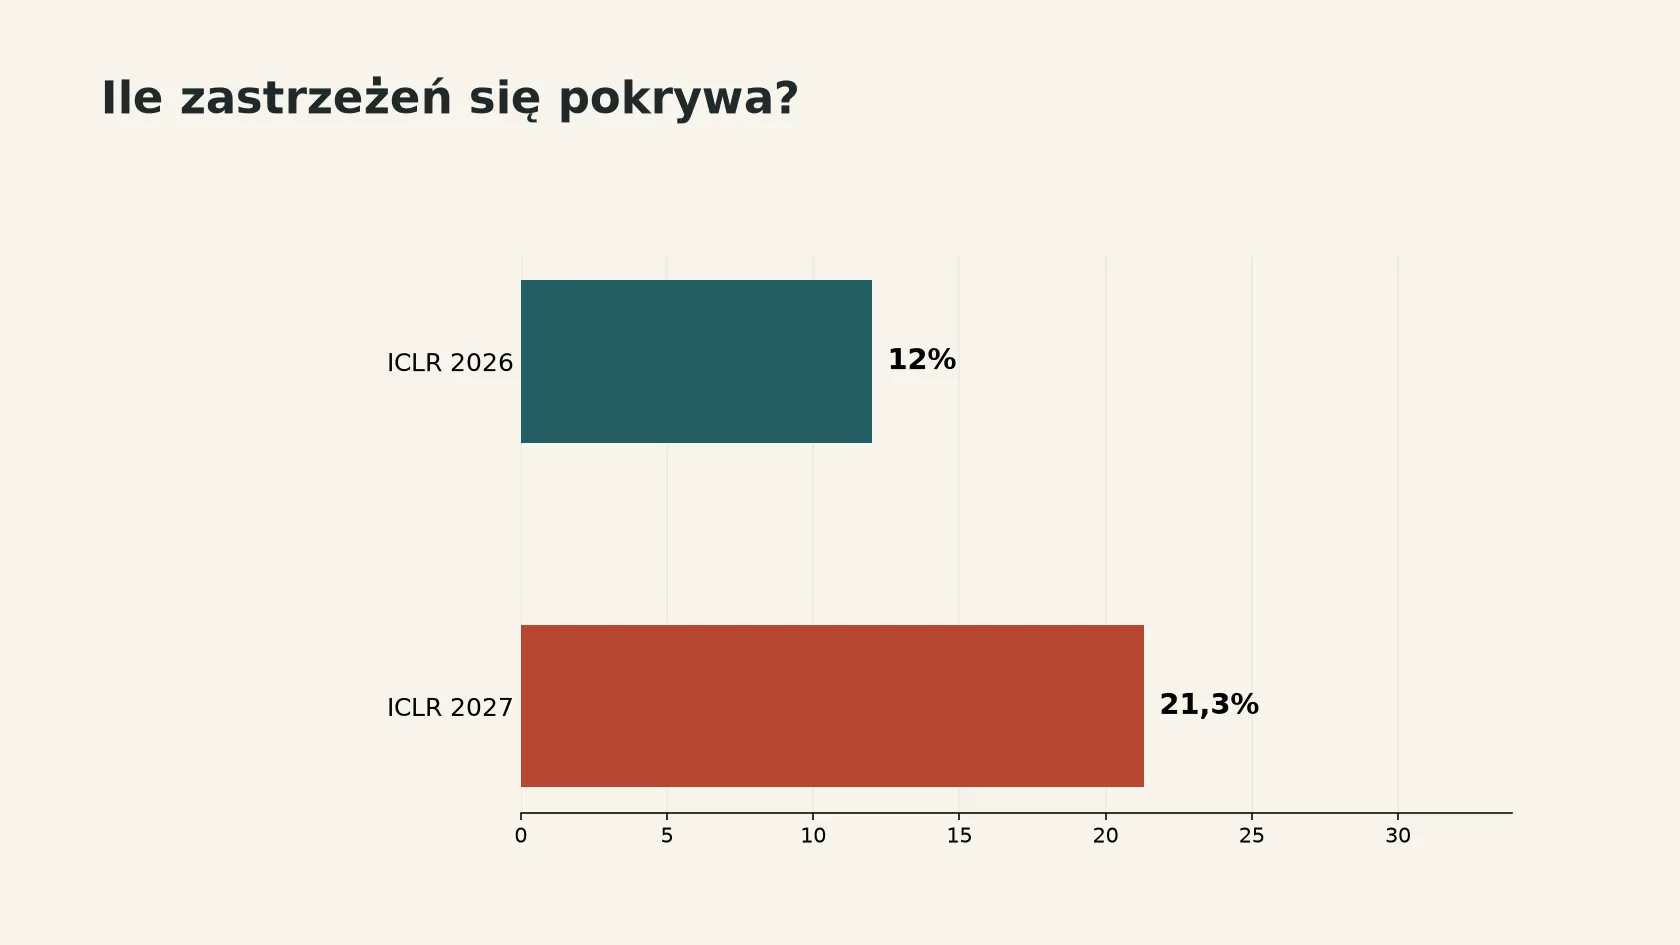
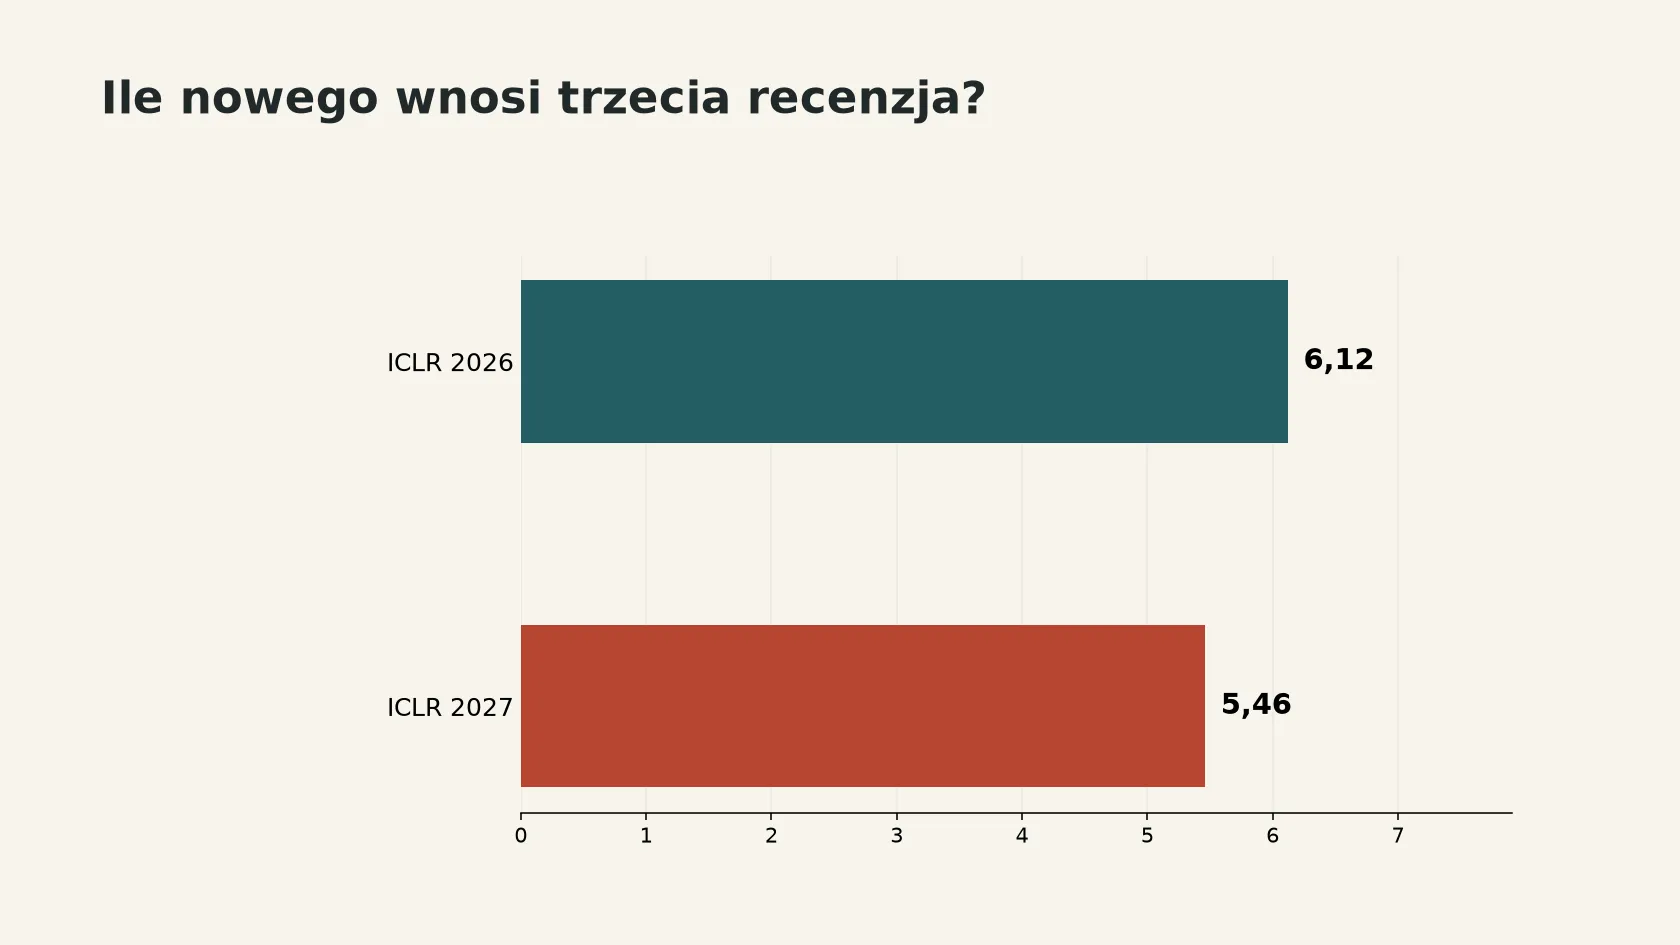
Między edycjami 2026 i 2027 zmierzony odsetek nakładających się uwag wzrósł z 12,0% do 21,3%. Różnicę dobrze widać też z perspektywy autora pracy. Do dwóch otrzymanych recenzji trzecia wnosiła wcześniej średnio 6,12 nowych zastrzeżeń. W nowszej edycji średnia spadła do 5,46.
Detektor nie powie, kto pisał
Autorzy użyli narzędzia MELD do oznaczenia tekstów o cechach wypowiedzi generowanych przez model językowy. Dwie tak oznaczone recenzje tego samego artykułu pokrywały się częściej niż dwie bez oznaczenia. Samo oznaczenie nie jest dowodem, że konkretny recenzent skorzystał z AI. Badanie obserwacyjne nie rozstrzyga też, co spowodowało całą zmianę między latami.
W metodologii zwróciłem uwagę na dodatkową trudność. O podobieństwie merytorycznym uwag współdecydują modele użyte do ich grupowania. Autorzy sprawdzali wrażliwość wyniku na wybór narzędzia. Gdybym oceniał własny system recenzji, obok liczby nadesłanych opinii policzyłbym właśnie to, ile różnych problemów udało się z nich wydobyć.
Stan na 21.11.2026, godz. 19:34 czasu polskiego.
Źródła

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 AI · 200 tysięcy złotych za 26 stron. Rozebrałem rządowy raport o marce Polska na czynniki pierwsze i policzyłem wszystkie bzduryTL;DR - Raport „Polaków portret własny” za 200 tys. zł z Ministerstwa Sportu i Turystyki zniknął ze strony fundacji, ale kopia krąży po sieci...
 AI · GTA 6 bez generatywnej AI, Epic na AI-first: dwa teksty Schreiera, dwie drogi branżyDwa dni, dwa teksty Jasona Schreiera: Epic przestawia grę Disneya na AI-first, a Rockstar robi GTA 6 rękami 4711 osób. Co naprawdę mówi Take-Two o AI.
- przelomowy.plTransformer w AI: jak mechanizm uwagi z 2017 roku zastąpił sieci rekurencyjne
- dobieracz.plDarmowa transkrypcja AI - limity Notta, Otter.ai, Fireflies.ai i trzech innych narzędzi
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan