


Robot zna właściwy ruch i wciąż przegrywa. W teście Mind2Act wykonał 12% zadań łączonych
W 180 symulowanych konfiguracjach badacze rozdzielili pamięć, ruch i korektę po wykonaniu ruchu. Najtrudniejsze było połączenie tych umiejętności.
👁 111 przeczytań
Przedmiot chowa się pod osłoną. Po kilku zamianach miejsc trzeba podnieść właściwą osłonę, a potem wykorzystać zapamiętaną informację. Ten przykład z Mind2Act World pokazuje, jak łatwo pomylić dwie przyczyny porażki robota. Maszyna mogła stracić przedmiot z pamięci albo dobrze wybrać cel i zepsuć sam ruch.
Trzy próby zamiast jednego wyniku
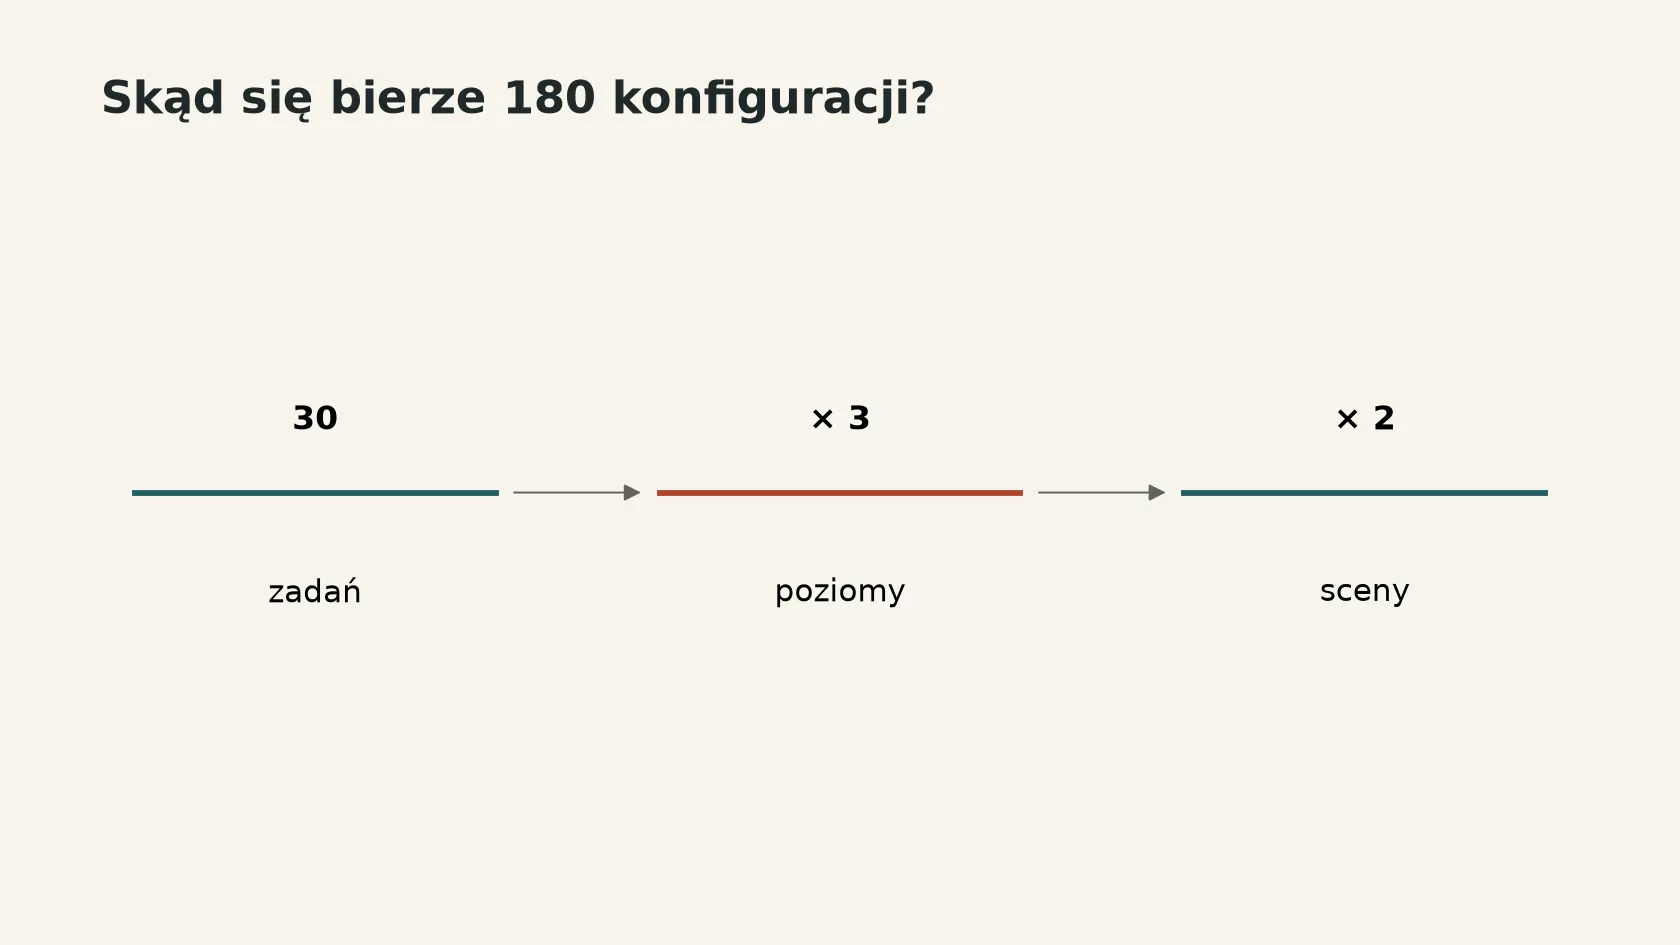
Badacze opisali 19 listopada zestaw trzydziestu symulowanych zadań z pięciu obszarów. Każde ma trzy poziomy trudności i dwa warianty sceny. Razem daje to 180 konfiguracji. Osobno badają decyzje na podstawie wcześniejszych obserwacji, dokładność i czas wykonania ruchu, a wreszcie połączenie tych umiejętności. W ostatniej grupie to, jak skończył się ruch, powinno wpłynąć na kolejną decyzję.
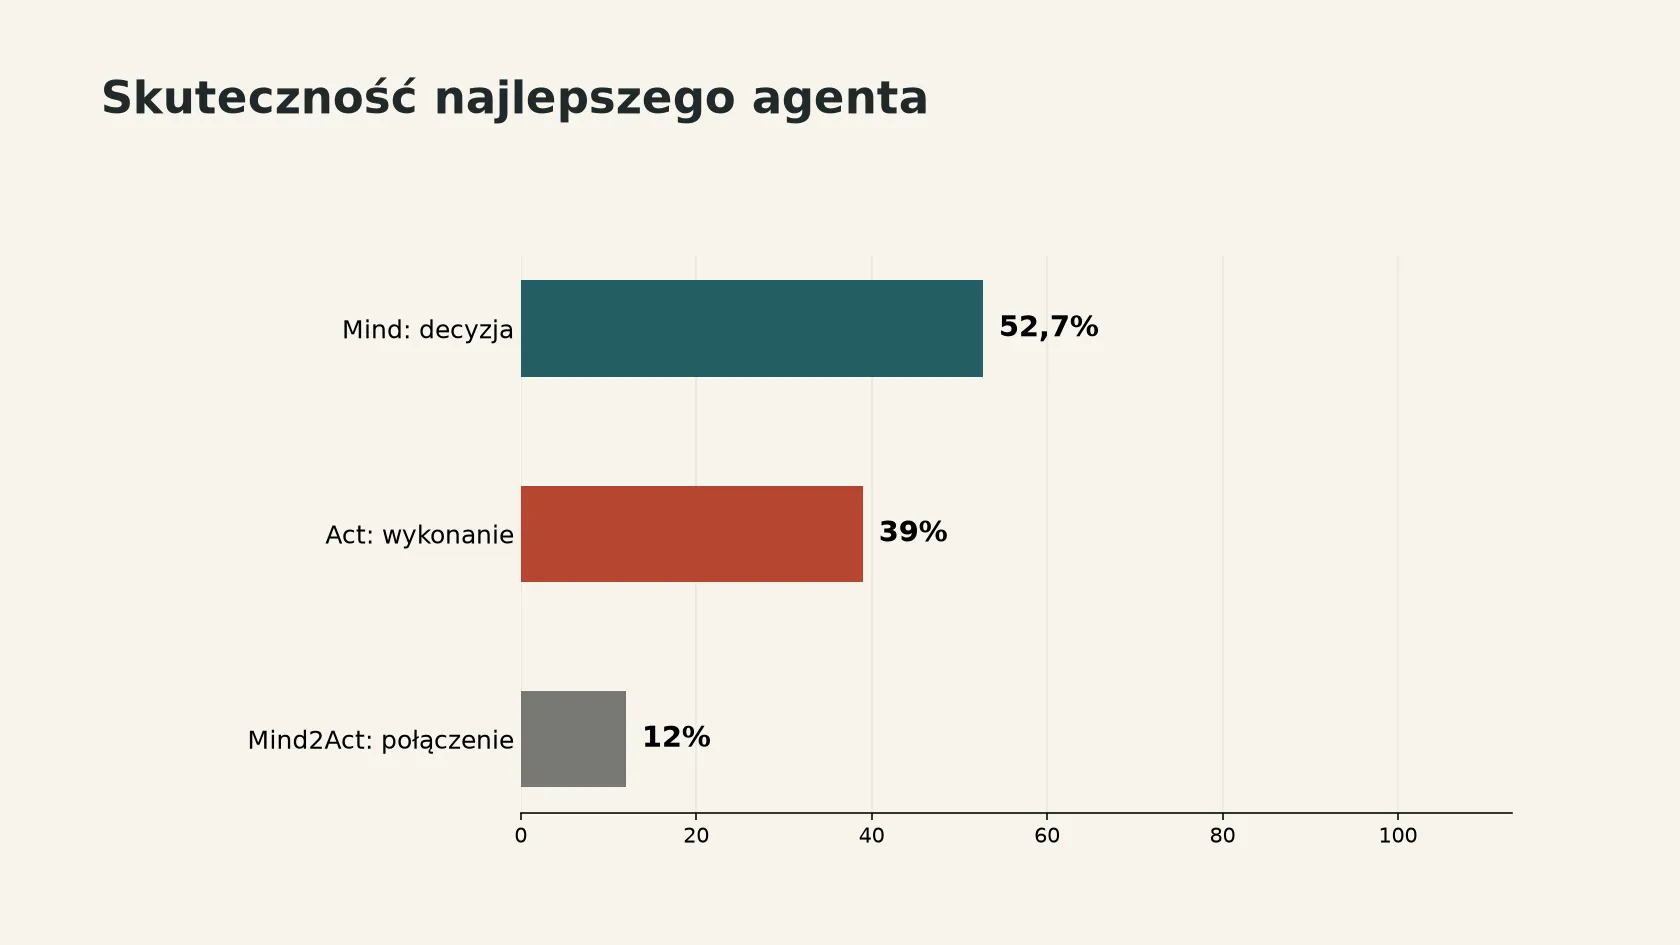
Najmocniejszy agent z porównania zaliczył 52,7% prób typu Mind i 39,0% typu Act. Kiedy miał powiązać rozumowanie z wykonaniem w zadaniach Mind2Act, skuteczność wyniosła 12,0%. To trzy wyniki jednej procedury badawczej. Nie wolno przemnożyć pierwszych dwóch liczb i potraktować wyniku jako przewidywanej skuteczności w trzeciej próbie.
Co umknęłoby przy pojedynczej punktacji
Z porównania profili wyłaniają się dwa odmienne kłopoty. Silny agent potrafił pamiętać stan zadania, lecz gorzej radził sobie z utrzymywaniem kontaktu podczas manipulacji. Modele wyspecjalizowane w sterowaniu wykonywały przećwiczone ruchy, ale słabiej zachowywały potrzebną informację o scenie. Te przypadki łatwo byłoby wrzucić do jednej rubryki „nieudana próba”.
Dla mnie największą wartością tego testu jest możliwość wskazania, co poprawić po błędzie. Liczba 12% opisuje wybranego agenta w symulatorze i konkretny zestaw czynności. Nie mówi, z jaką skutecznością dowolny robot poradzi sobie w twojej kuchni.
Stan na 21.11.2026, godz. 19:34 czasu polskiego.
Źródła

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI