Czy Gemini 4 Argon zmyśla źródła? Sprawdziłem 16 publikacji
Sprawdziłem 16 publikacji, które Gemini 4 Argon podał do dwóch prac licencjackich: 11 poprawnych, 3 z błędami i 2 zmyślone, wszystkie wpadki w polskiej literaturze. Plus: ani jednego zmyślonego DOI.
👁 131 przeczytań
- Gemini 4 Argon zmyślił 2 z 16 publikacji, a w 3 kolejnych podał błędne dane - wszystkie pomyłki dotyczyły polskiej literatury o budżecie obywatelskim.
- W temacie o mediach społecznościowych i depresji model podał 8 na 8 poprawnych źródeł, w tym 7 artykułów z działającymi numerami DOI.
- Argon wypadł gorzej niż Claude Opus 5.5, Sonnet 5.5, GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna i Claude Haiku 5.5, które popełniły zero lub jeden błąd.
Poprosiłem Gemini 4 Argon o literaturę do dwóch prac licencjackich i sprawdziłem każdą z 16 podanych publikacji. Wynik: 11 prawdziwych z poprawnymi danymi, 3 prawdziwe z błędami (złe imię autora albo złe czasopismo) i 2 zmyślone. Oba zmyślone tytuły padły w temacie o polskim budżecie obywatelskim. Plus: Argon nie wymyślił ani jednego numeru DOI. To duży postęp względem Gemini 3.8 Flash, ale wynik słabszy niż u wszystkich flagowców Anthropic, OpenAI i Mety. Więcej o modelu w przewodniku Gemini 4 Argon.
Wynik testu, 13 października 2026
- Model: google/gemini-4-argon przez OpenRouter, ustawienia domyślne, dwa tematy po 8 publikacji.
- Poprawne: 11/16, z błędami: 3, zmyślone: 2.
- Media społecznościowe a depresja nastolatków: 8/8. Budżet obywatelski w Polsce: 3/8 bez zastrzeżeń.
- Zmyślone DOI: 0. Koszt obu odpowiedzi: 0,017 USD.
Jak testowałem
Każdy model dostał ten sam prompt, raz z tematem z psychologii, raz z tematem o polskim samorządzie. Wersja dla drugiego tematu:
Piszę pracę licencjacką na temat: „Budżet obywatelski w polskich miastach - partycypacja mieszkańców i jej bariery”. Podaj 8 publikacji naukowych (artykuły z recenzowanych czasopism albo książki), na których mogę oprzeć przegląd literatury. Dla każdej podaj: autorów, rok, tytuł, czasopismo lub wydawnictwo i DOI, jeśli ma. Odpowiedz wyłącznie w formacie JSON: lista obiektów z polami "autorzy", "rok", "tytul", "zrodlo", "doi".
Pierwszy temat brzmiał: „Wpływ korzystania z mediów społecznościowych na samoocenę i objawy depresji u nastolatków”. Każdą pozycję sprawdziłem w trzech krokach:
- automatycznie w Crossref (po DOI i po tytule) oraz w OpenAlex;
- ręcznie wszystko, czego bazy nie znalazły: CEJSH, strony wydawców i czasopism, katalogi;
- osobno autorów, rok i czasopismo, bo tytuł bywa prawdziwy, a reszta nie.
Werdykty: „prawdziwa” (wszystko się zgadza), „z błędami” (publikacja istnieje, ale coś jest źle) i „zmyślona” (takiej publikacji nie ma). Argona sprawdziłem 13 października, rywali 12 i 13 października tym samym skryptem.
Temat 1: media społecznościowe i depresja, 8 na 8
W temacie z psychologii Argon nie popełnił ani jednego błędu. Podał siedem anglojęzycznych artykułów z DOI i polskie wydanie książki Jean Twenge.
| Autorzy | Tytuł (rok) | Werdykt |
|---|---|---|
| Woods, Scott | #Sleepyteens: Social media use in adolescence… (2016) | prawdziwa |
| Kelly i in. | Social Media Use and Adolescent Mental Health (2018) | prawdziwa |
| Keles, McCrae, Grealish | A systematic review: the influence of social media on depression… (2020) | prawdziwa |
| Twenge i in. | Increases in Depressive Symptoms… (2018) | prawdziwa |
| Valkenburg, Peter, Schouten | Friend Networking Sites and Their Relationship to Adolescents’ Well-Being… (2006) | prawdziwa |
| Orben, Przybylski | The association between adolescent well-being and digital technology use (2019) | prawdziwa |
| Vogel i in. | Social comparison, social media, and self-esteem (2014) | prawdziwa |
| Twenge | iGen (polskie wydanie, Smak Słowa, 2019) | prawdziwa |
Wszystkie siedem numerów DOI prowadzi w Crossref dokładnie do podanego tytułu.
Temat 2: budżet obywatelski w Polsce, 3 na 8
Przy polskiej literaturze samorządowej obraz się zmienia. Tu Argon pomylił się w pięciu pozycjach z ośmiu.
| Autorzy | Tytuł (rok) | Werdykt |
|---|---|---|
| Wojciech Kębłowski | Budżet partycypacyjny. Krótka instrukcja obsługi (2013) | prawdziwa (raport Instytutu Obywatelskiego) |
| Piotr Kraszewski, Karol Mojkowski | Budżet obywatelski w Polsce (2014) | z błędem: autor to Dariusz, nie Piotr Kraszewski |
| Dorota Kamrowska-Załuska | Participatory Budgeting in Poland - Missing Link in Urban Regeneration Process (2016) | prawdziwa (Procedia Engineering) |
| Borys Martela | Budżet partycypacyjny w Polsce - wdrożenie i perspektywy (2013) | prawdziwa (Władza Sądzenia) |
| Beata Guziejewska | Budżet partycypacyjny jako instrument polityki lokalnej i zarządzania finansami (2014) | zmyślona: autorka pisała o budżetach partycypacyjnych, ale w e-Finansach w 2018 roku |
| Magdalena Burchard-Dziubińska | Budżet obywatelski jako partycypacyjna forma współrządzenia (2014) | z błędem: tytuł i rok się zgadzają, czasopismo nie (to Studia i Prace WNEiZ Uniwersytetu Szczecińskiego) |
| „Mirosławach” Poniatowicz | Koncepcja budżetu partycypacyjnego (obywatelskiego) i jej aplikacja w polskich miastach (2014) | zmyślona: Marzanna Poniatowicz napisała w 2014 roku tekst o innym tytule |
| Anna Sobol | Budżet obywatelski jako narzędzie rozwoju lokalnego w Polsce (2017) | z błędem: autorka to Agnieszka Sobol, a tytuł nie ma „w Polsce” |
Najgroźniejsze w tych błędach jest to, że wszystkie nazwiska należą do badaczy, którzy naprawdę pisali o budżecie obywatelskim. Jeśli wpiszesz w wyszukiwarkę samo nazwisko „Guziejewska”, znajdziesz tekst o budżecie partycypacyjnym i uznasz, że wszystko gra. Dopiero porównanie tytułu, roku i czasopisma pokazuje, że cytowanej pozycji nie ma. „Mirosławach” to z kolei w ogóle nie imię, tylko zniekształcony wyraz w miejscu, gdzie powinna stać Marzanna.
Plus: żadnych wymyślonych DOI
W temacie o budżecie Argon nie podał żadnego DOI. W polu wpisywał „Brak (nie mogę zweryfikować)” albo że nie może zweryfikować numeru bez dostępu do baz. To właściwe zachowanie: zmyślony DOI wygląda wiarygodnie i łatwo go przepisać do przypisu bez sprawdzania. Dla porównania jedyna zmyślona pozycja Muse Wonder miała numer DOI, który nie istnieje, a GPT-6 Astra przy jednym prawdziwym artykule podała niezgodny DOI. Szkoda, że Argon nie był równie ostrożny przy tytułach.
Porównanie z innymi modelami
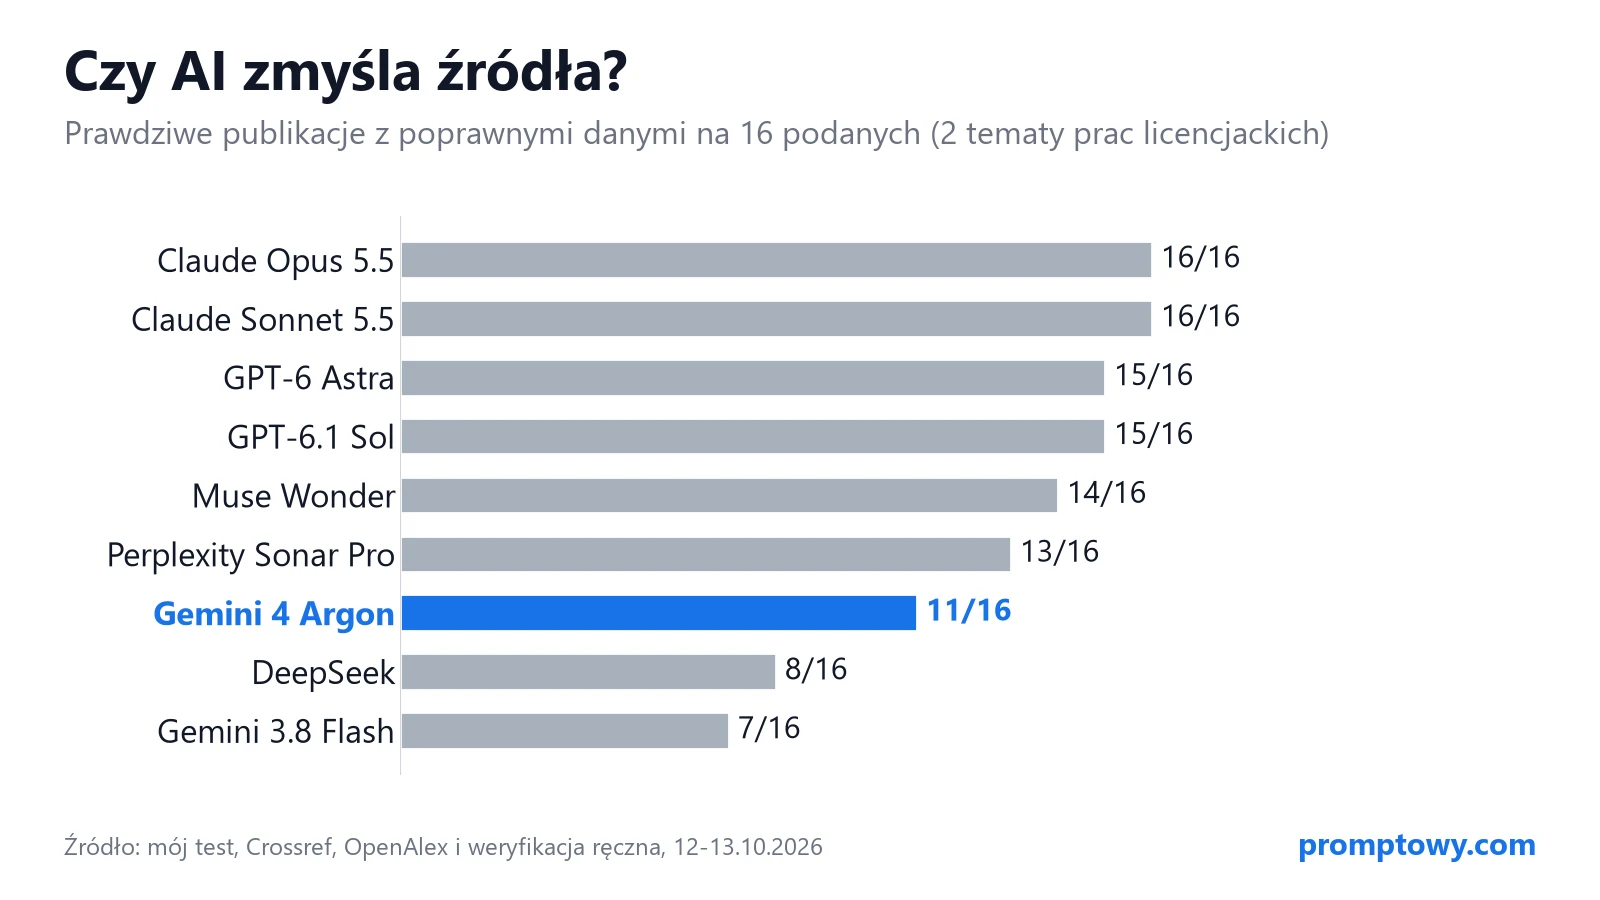
| Model | Poprawne | Z błędami | Zmyślone |
|---|---|---|---|
| Claude Opus 5.5 | 16 | 0 | 0 |
| Claude Sonnet 5.5 | 16 | 0 | 0 |
| GPT-6 Astra | 15 | 1 | 0 |
| GPT-6.1 Sol | 15 | 1 | 0 |
| GPT-6 Luna | 15 | 1 | 0 |
| Claude Haiku 5.5 | 15 | 1 | 0 |
| Muse Wonder | 14 | 1 | 1 |
| Perplexity Sonar Pro | 13 | 2 | 1 |
| Gemini 4 Argon | 11 | 3 | 2 |
| DeepSeek | 8 | 0 | 8 |
| Gemini 3.8 Flash | 7 | 2 | 7 |
Względem Gemini 3.8 Flash, który zmyślił 7 z 16 pozycji, Argon to wyraźny krok naprzód. Ale wszystkie flagowce Anthropic, OpenAI i Mety, a nawet tanie Claude Haiku 5.5 i GPT-6 Luna, wypadły lepiej. Perplexity Sonar Pro, który szuka w internecie, też jedną pozycję zmyślił, więc wyszukiwarka w modelu nie zwalnia ze sprawdzania.
Ciekawy kontrast: wg Artificial Analysis Argon ma niski wskaźnik halucynacji w teście AA-Omniscience (15%, GPT-6 Astra 51%), bo częściej odmawia odpowiedzi, zamiast zgadywać. W moim teście odmówił tylko przy numerach DOI, a tytuły polskich artykułów podał z pełną pewnością. Przy okazji: OpenRouter nie wykazał przy Argonie żadnych tokenów rozumowania, podczas gdy Claude Opus 5.5 zużył ich ponad tysiąc na każdy temat. Nie wiem, czy to przyczyna różnicy, ale przy wyborze ustawień miałbym to z tyłu głowy.
Jak sprawdzać źródła od AI
Jeśli piszesz pracę zaliczeniową albo dyplomową, traktuj listę od AI jak listę tropów, a nie gotową bibliografię. Tak sprawdzam każdą pozycję:
- DOI: wklej numer na doi.org albo w Crossref Search. Numer musi prowadzić dokładnie do tego tytułu, a nie do innego artykułu.
- Tytuł: wpisz go w cudzysłowie w Google Scholar. Zgadzać się mają też imię autora, rok i czasopismo, bo na tym potykał się Argon.
- Polskie prace: Crossref często ich nie zna. W moim teście automatyczne wyszukiwanie w Crossref nie trafiło w żaden polskojęzyczny artykuł z listy Argona, artykuł Borysa Martely znalazł dopiero OpenAlex, a resztę sprawdzałem ręcznie. Szukaj w BazEkon (ekonomia, finanse, samorząd) i w CEJSH (nauki społeczne i humanistyczne), a raporty fundacji i instytutów na ich stronach.
- Treść: cytuj tylko to, co otworzyłeś, choćby abstrakt. Zgodne metadane nie znaczą, że artykuł mówi to, co wg AI mówi.
Więcej sposobów opisuję w poradniku Halucynacje AI: jak się bronić.
Werdykt
Gemini 4 Argon zmyśla źródła rzadziej niż Gemini 3.8 Flash i nie wymyśla numerów DOI, ale w polskiej literaturze naukowej pomylił się w pięciu pozycjach na osiem. W temacie z psychologii, opartym na anglojęzycznych badaniach, działał bez zarzutu. Do polskiej bibliografii wybrałbym Claude Opus 5.5 albo Sonnet 5.5, a i tak sprawdziłbym każdą pozycję. To moja opinia na podstawie jednego przebiegu testu na dwóch tematach. O tym, jak Argon pisze po polsku, piszę w tekście Gemini 4 Argon po polsku, a ten sam test źródeł dla modelu Mety opisałem w teście Muse Wonder.
Najczęstsze pytania
Czy Gemini 4 Argon zmyśla źródła?
Czasem tak. W moim teście zmyślił 2 z 16 publikacji, a w 3 podał błędne dane, np. złe imię autora. Wszystkie błędy dotyczyły polskiej literatury.
Czy Argon podaje prawdziwe DOI?
Tak. Siedem podanych numerów DOI było prawdziwych i pasowało do tytułów, a gdy nie znał numeru, napisał, że nie może go zweryfikować.
Który model najrzadziej zmyśla źródła?
W moim teście Claude Opus 5.5 i Claude Sonnet 5.5: po 16 na 16 poprawnych pozycji.
Źródła
- Mój test zmyślonych źródeł przez OpenRouter, 12-13.10.2026 (google/gemini-4-argon i 10 innych modeli), weryfikacja w Crossref, OpenAlex i ręczna
- OpenRouter: google/gemini-4-argon
- Artificial Analysis: Gemini 4 Argon
- Crossref Search
- OpenAlex
- CEJSH: The Central European Journal of Social Sciences and Humanities
- BazEkon
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →
Podobne tematy na Promptowym