Muse Wonder vs Opus 5.5 vs GPT-6 Astra: mój test na 23 zadaniach
23 zadania, 5 modeli, ocena automatyczna: wszystkie mają 99-100%, a różnice wychodzą w koszcie, czasie i wpadkach. Muse Wonder tańszy od Opusa dzięki tokenizerowi.
👁 120 przeczytań
- GPT-6 Astra jako jedyny zdobył 100% na 23 zadaniach, Muse Wonder był tuż za nim z wynikiem 99,7%, a Gemini 3.8 Flash okazał się najtańszy - zaledwie 0,09 USD.
- Muse Wonder i Claude Opus 5.5 mają identyczną cenę za token (4 USD/mln wejścia, 20 USD/mln wyjścia), ale tokenizer Anthropic liczy ten sam polski tekst prawie dwa razy drożej - 87 675 tokenów wobec 46 929 dla Mety.
- Gemini 3.8 Flash zmyślił 7 z 16 źródeł przy polskim temacie budżetu obywatelskiego, podczas gdy Muse Wonder, oba Claude'y i GPT-6 Astra podały 16 prawdziwych pozycji na 16.
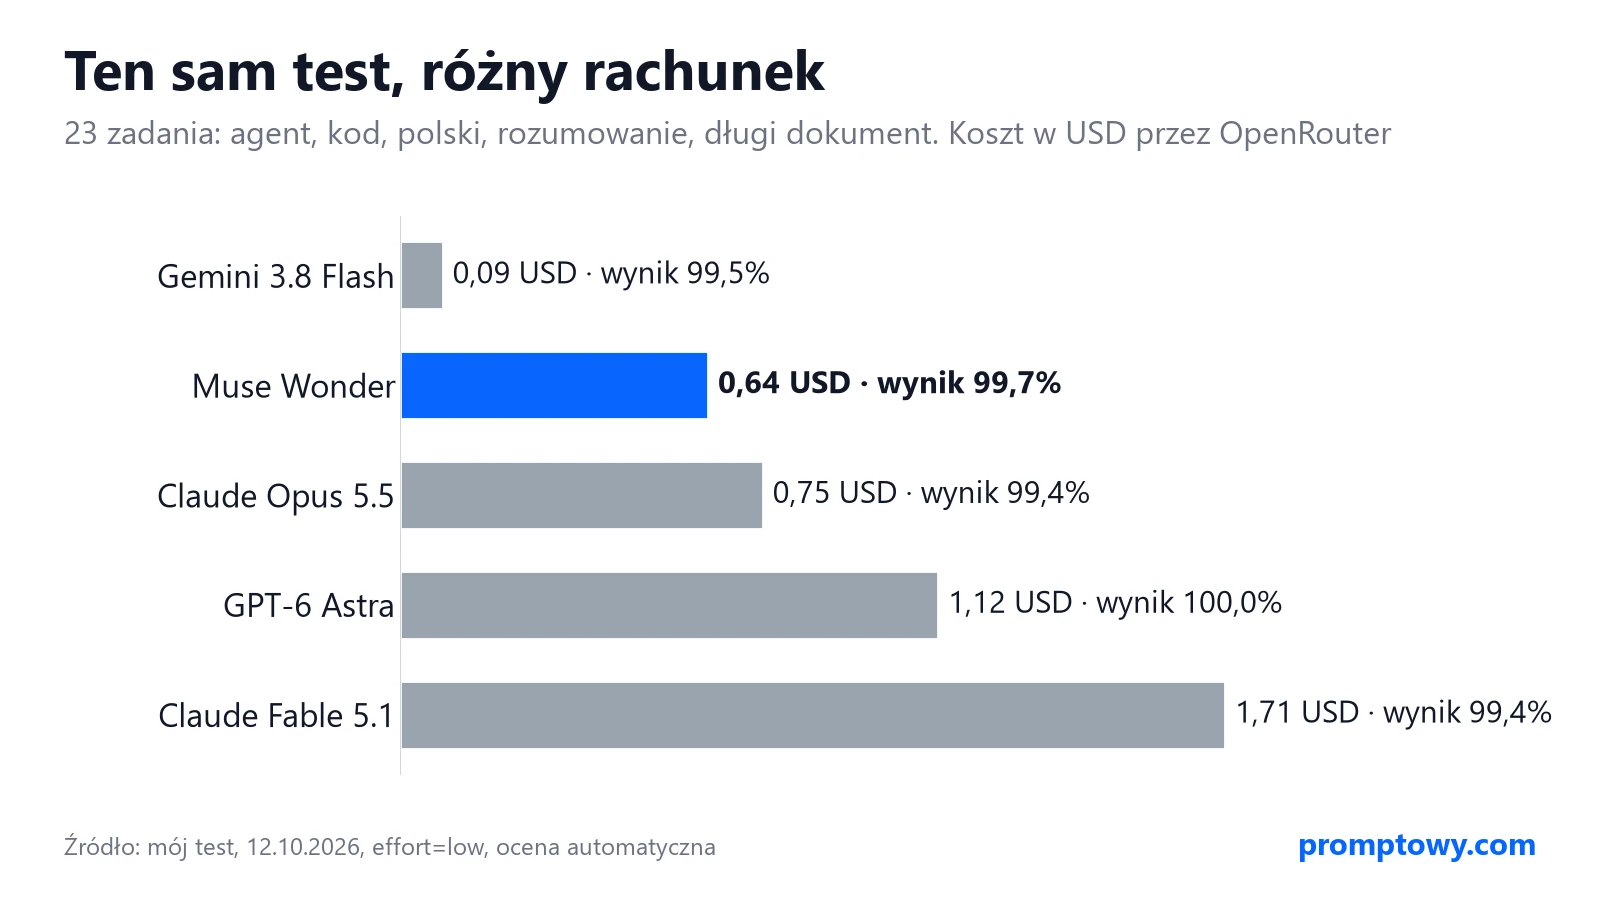
Dałem Muse Wonder i czterem rywalom te same 23 zadania: agenta z narzędziami, kod sprawdzany testami, polskie pisma, rozumowanie i dokument na 47-88 tys. tokenów. Wynik zaskoczył mnie bardziej niż benchmarki Mety: na praktycznych zadaniach wszystkie pięć modeli zrobiło 99-100%, a prawdziwe różnice wyszły w rachunku, czasie i pojedynczych wpadkach. Muse Wonder był drugi najtańszy i drugi najszybszy. Wszystkie dane, wykresy i wpadki są poniżej, a opis modelu w przewodniku Muse Wonder.
Test z 12 października 2026, wieczór
- Modele: Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Wszystkie przez OpenRouter, rozumowanie na poziomie low.
- 23 zadania w dwóch rundach, ocena automatyczna (testy jednostkowe, sprawdzenie wywołań narzędzi, dokładne odpowiedzi), bez sędziego AI.
- Osobno: test zmyślonych źródeł (16 publikacji na model, weryfikacja w Crossref i OpenAlex).
- Koszt całego testu: 5,04 USD. Logi i wszystkie odpowiedzi zapisane w plikach.
Wynik w jednej tabeli
| Model | Wynik (23 zadania) | Koszt | Czas łączny | Prawdziwe źródła | Wpadki |
|---|---|---|---|---|---|
| Muse Wonder | 99,7% | 0,64 USD | 165 s | 16/16 | literówka w kodzie („trzynadzieście”) |
| Claude Opus 5.5 | 99,4% | 0,75 USD | 222 s | 16/16 | streszczenie ponad limit słów |
| Claude Fable 5.1 | 99,4% | 1,71 USD | 263 s | 16/16 | streszczenie ponad limit słów |
| GPT-6 Astra | 100% | 1,12 USD | 200 s | 16/16 | brak |
| Gemini 3.8 Flash | 99,5% | 0,09 USD | 139 s | 7/16* | Wigilia wolna także w 2024 roku |
Wynik to średnia z 23 zadań, każde waży tyle samo (w zadaniu z kilkoma kryteriami liczy się odsetek spełnionych). * Gemini 3.8 Flash w teście źródeł z mojego wcześniejszego pomiaru z 12 października, ten sam prompt.
Co dokładnie sprawdzałem
| Kategoria | Zadania | Jak oceniane |
|---|---|---|
| Agent z narzędziami | planowanie wyjazdu (3 narzędzia, 4 warunki, pułapki cenowe), zwrot w sklepie (czy agent nie utworzy zwrotu po terminie), przeliczenie faktur w EUR po kursach NBP z awarią serwisu przy pierwszym zapytaniu | poprawność wywołań, wybór, wynik liczbowy |
| Kod | walidacja NIP, scalanie przedziałów, dni robocze w Polsce (z Wigilią od 2025 roku), kwota słownie na fakturę | testy jednostkowe uruchomione u mnie (8-19 przypadków na zadanie) |
| Polski | korekta 10 błędów, streszczenie w 3 punktach do 60 słów, odwołanie od decyzji ZUS, odmiana 10 nazw (Bielsko-Biała, Kukuczka, Końskie) | lista kontrolna elementów i dokładne formy |
| Rozumowanie | 11 zadań z jednoznaczną odpowiedzią (kombinatoryka, kalendarz, logika rycerzy i łotrów) | dokładna odpowiedź |
| Długi dokument | 80 protokołów zarządu, 5 pytań, w tym zmieniona później decyzja i pytanie o informację, której nie ma | dokładne odpowiedzi |
Najważniejszy wniosek: zadania z życia już nie różnicują
Przy planowaniu wyjazdu wszystkie pięć modeli wywołało narzędzia równolegle (4 wywołania w 2 turach), odrzuciło tani lot o 6:05 i hotel z oceną 7,4 i podało ten sam koszt: 1730 zł. W zadaniu ze zwrotem żaden nie utworzył zwrotu po 32 dniach. Przy fakturach wszystkie ponowiły zapytanie po awarii serwisu NBP, pominęły fakturę zapłaconą i podały 15 226,58 zł. Wszystkie wyłapały, że informacji o kampanii w TikToku nie ma w dokumencie, i że powierzchnię magazynu zmieniono w późniejszym protokole. To dobra wiadomość dla użytkownika i zła dla marketingu: na takich zadaniach płacisz za markę, nie za skuteczność.
Gdzie były różnice
Koszt: Muse Wonder tańszy od Opusa, choć cena za token jest ta sama
Muse Wonder i Claude Opus 5.5 kosztują tyle samo za token: 4 USD za milion wejścia i 20 USD za milion wyjścia. A jednak Opus wyszedł o 18% drożej. Powód widać w zadaniu z długim dokumentem: ten sam polski tekst to dla Mety 46 929 tokenów, dla Gemini 53 511, dla GPT-6 Astra 55 371, a dla modeli Anthropic 87 675. Tokenizer Claude’a liczy polski tekst prawie dwa razy drożej niż tokenizer Mety. Przy dokumentach po polsku to realne pieniądze: jedno pytanie do 80 protokołów kosztowało 0,19 USD w Muse Wonder, 0,35 USD w Opusie 5.5 i 0,88 USD w Fable 5.1.
| Model | Tokeny tego samego dokumentu | Koszt pytania do dokumentu |
|---|---|---|
| Muse Wonder | 46 929 | 0,19 USD |
| Gemini 3.8 Flash | 53 511 | 0,04 USD |
| GPT-6 Astra | 55 371 | 0,69 USD |
| Claude Opus 5.5 | 87 675 | 0,35 USD |
| Claude Fable 5.1 | 87 675 | 0,88 USD |
W krótkich zadaniach jest odwrotnie: Muse Wonder dużo „myśli” nawet na poziomie low (w planowaniu wyjazdu 636 tokenów rozumowania, Opus 46), więc w pojedynczych krótkich pytaniach bywa droższy od Opusa.
Czas
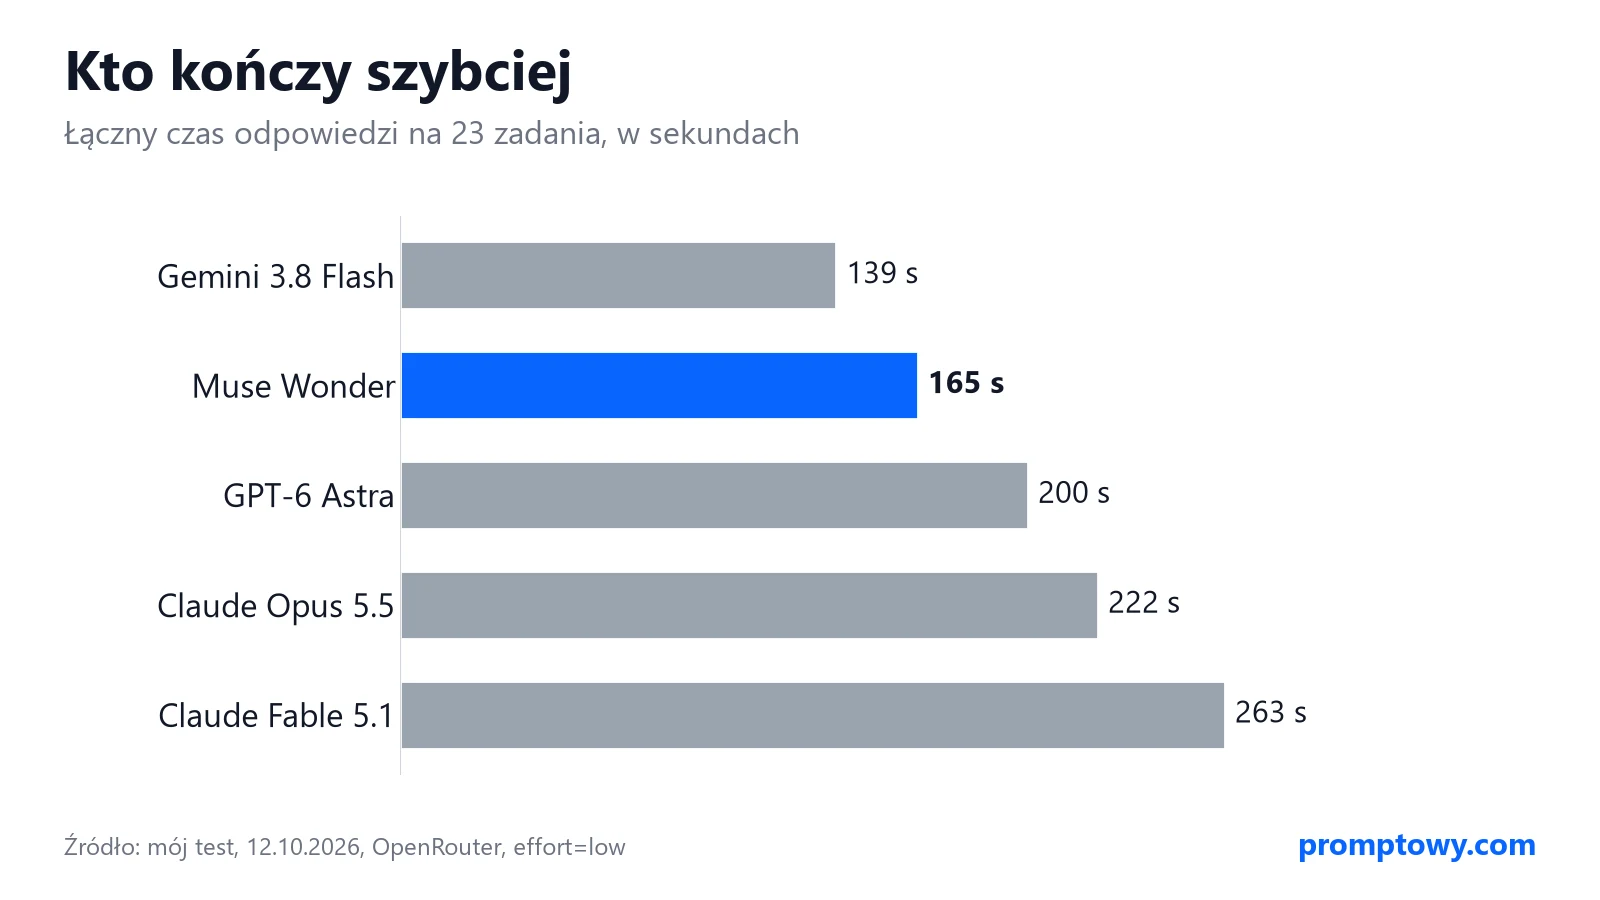
Najwolniejszy był Fable 5.1: samo odwołanie od decyzji ZUS pisał 80 sekund i kosztowało 0,28 USD, Muse Wonder napisał je w 12 sekund za 0,03 USD.
Wpadki, które wyłapały testy
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Muse Wonder: „trzynadzieście groszy”. W funkcji zamieniającej kwotę na słowa model wpisał do tablicy liczebników nieistniejące słowo. 15 z 16 testów przeszło, a 12,13 zł zamieniło się w „dwanaście złotych trzynadzieście groszy”. Na fakturze to byłby wstyd.
- Muse Wonder: zmyślona data w piśmie. W odwołaniu do sądu wpisał datę „14 października 2026 r.”, choć jej nie podałem. Pozostałe modele zostawiły miejsce do uzupełnienia. Nie odejmowałem za to punktu, ale przy pismach trzeba to sprawdzać.
- Claude Opus 5.5 i Fable 5.1: limit słów. Streszczenie miało mieć najwyżej 60 słów, wyszło 62 i 66. Muse Wonder trafił w 60, GPT-6 Astra miał 59.
- Gemini 3.8 Flash: Wigilia. Dodał 24 grudnia jako dzień wolny dla wszystkich lat, choć ustawowo wolna jest od 2025 roku. Test z grudniem 2024 nie przeszedł.
Zmyślone źródła: czołówka już nie zmyśla
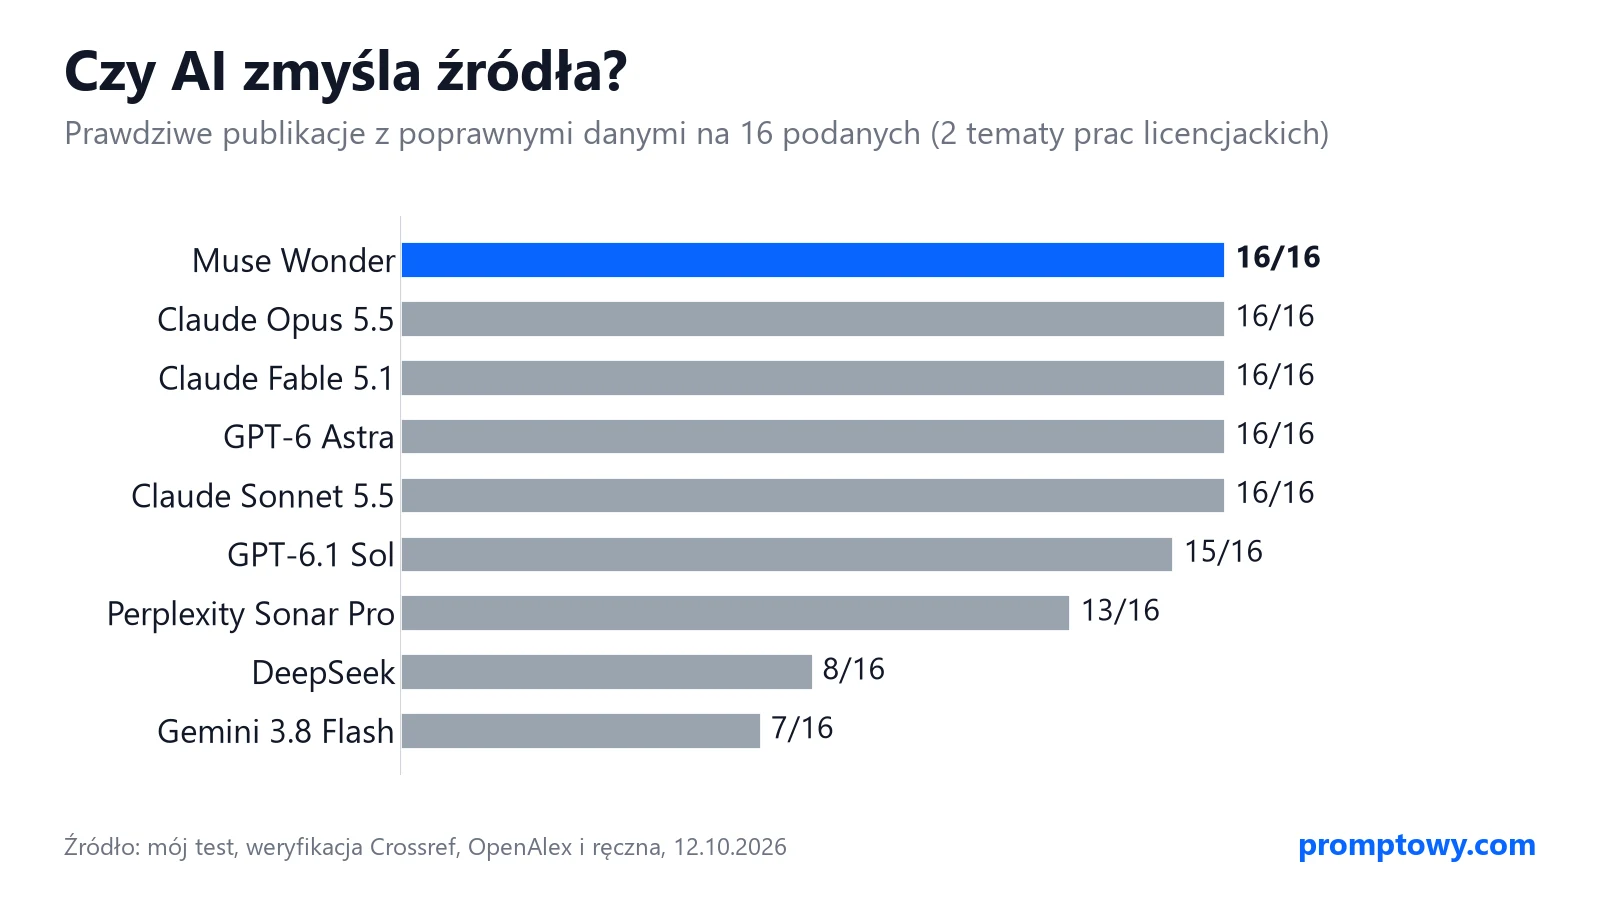
Prosiłem o 8 publikacji do pracy licencjackiej na dwa tematy: wpływ mediów społecznościowych na nastolatków i budżet obywatelski w polskich miastach. Każdą pozycję sprawdziłem w Crossref i OpenAlex, a cztery, których bazy nie znalazły (polskie raporty Instytutu Obywatelskiego i Fundacji Batorego oraz artykuł z francuskiego czasopisma Métropoles), ręcznie. Wszystkie istnieją. Muse Wonder, Opus 5.5, Fable 5.1 i Astra podały 16 prawdziwych pozycji na 16. Ten sam prompt w moim wcześniejszym teście dał Gemini 3.8 Flash tylko 7 prawdziwych pozycji, przy polskim temacie 7 zmyślonych. Tani model wygrywa w zadaniach z życia, ale do bibliografii się nie nadaje.
Dla porównania: benchmarki Mety i mój test pisania
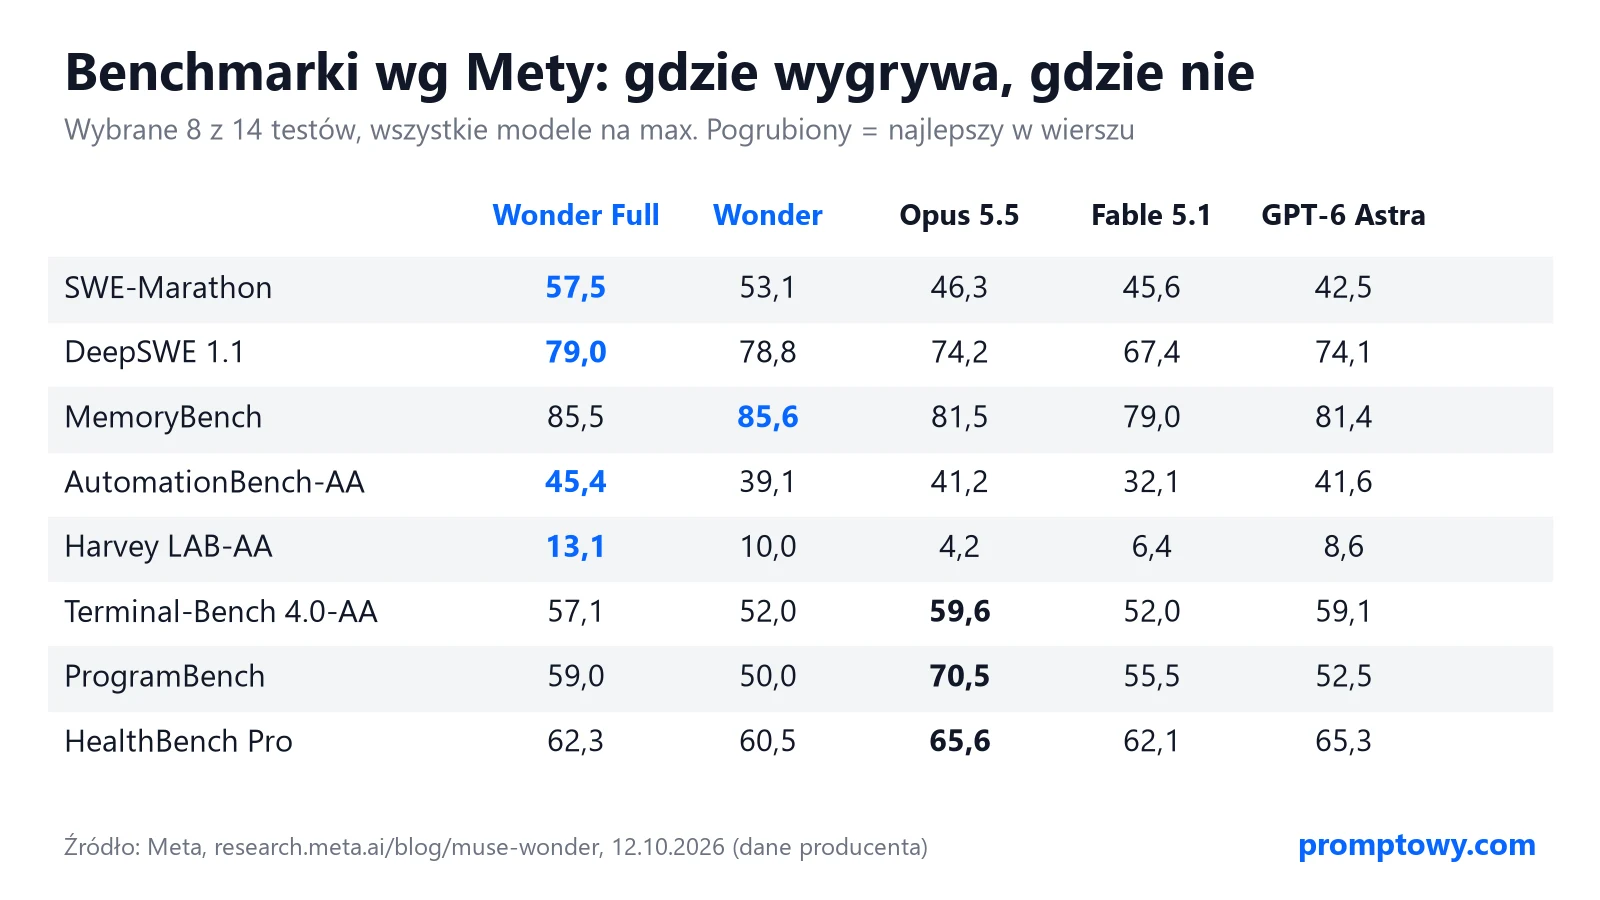
Meta w swojej tabeli pokazuje przewagę Muse Wonder Full w długich zadaniach programistycznych i pracy agentów, a przegraną z Opusem 5.5 w ProgramBench, Terminal-Bench i HealthBench Pro. Mój test sprawdzał zwykły Muse Wonder, ten dostępny w API, i na zadaniach tej skali przewagi żadnej strony nie widać. W teście pisania po polsku z oceną w ciemno, który bardziej różnicuje, Muse Wonder ma 87,0 pkt, Opus 5.5 90,1, Astra 85,3, a Fable 5.1 83,9 - szczegóły w tekście Muse Wonder po polsku.
Ograniczenia testu
- Jeden przebieg każdego zadania. Przy wynikach 99-100% różnica jednego zadania to przypadek, nie przewaga.
- Rozumowanie na poziomie low dla wszystkich, żeby było równo i tanio. Na max wyniki i koszty byłyby inne.
- Zadania są praktyczne, nie graniczne. Do tego, gdzie modele naprawdę się różnią (wielogodzinne projekty, trudna matematyka), potrzeba innych testów - tu bardziej miarodajne są niezależne rankingi jak Artificial Analysis.
- Ocena automatyczna: sprawdza fakty i formę, nie styl. Styl ocenia osobny test pisania po polsku.
Werdykt
Jeśli używasz AI do codziennej pracy po polsku przez API, Muse Wonder zrobi to samo co Opus 5.5, Fable 5.1 i Astra, a przy długich polskich dokumentach wyjdzie wyraźnie taniej dzięki oszczędnemu tokenizerowi. Najlepszy stosunek ceny do jakości w moim teście ma jednak Gemini 3.8 Flash - pod warunkiem, że nie prosisz go o źródła. To moja opinia na podstawie jednego przebiegu testu z 12 października 2026.
Najczęstsze pytania
Który model wygrał test?
GPT-6 Astra zrobił 100%, Muse Wonder 99,7%, Gemini 3.8 Flash 99,5%, Opus 5.5 i Fable 5.1 po 99,4%. Różnice to pojedyncze wpadki, nie przewaga.
Czy Muse Wonder jest tańszy od Claude Opus 5.5?
Cena za token jest ta sama, ale przy polskim tekście Muse Wonder zużywa mniej tokenów. W moim teście 23 zadań zapłaciłem 0,64 USD, za Opusa 0,75 USD, a za pytanie do długiego dokumentu 0,19 wobec 0,35 USD.
Czy Muse Wonder zmyśla źródła?
W moim teście nie: 16 prawdziwych publikacji na 16.
Źródła i metoda
- Mój test przez OpenRouter, 12.10.2026: 23 zadania, effort=low, ocena automatyczna (testy jednostkowe, kontrola wywołań narzędzi, dokładne odpowiedzi)
- Test źródeł: weryfikacja w Crossref i OpenAlex, 4 pozycje ręcznie
- OpenRouter: ceny modeli
- Meta AI Research: Muse Wonder (tabela benchmarków)
- Artificial Analysis: ranking modeli
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym