


ElevenLabs Scribe v3 i v3 Live: co nowego, cena i próba po polsku
Scribe v3 i v3 Live od ElevenLabs: 27% mniej błędów niż v2 wg producenta, 0,20 USD za godzinę, 4,5 h w planie Free. Próba v2 vs v3 na polskich nazwach.
Spis treści 7
👁 113 przeczytań
ElevenLabs wypuścił 10 listopada 2026 nową wersję swojego modelu do zamiany mowy na tekst: Scribe v3 do nagrań i Scribe v3 Live do transkrypcji na żywo. Firma podaje 27% mniej błędów w słowach niż Scribe v2 w 102 językach, a w wersji Live - po raz pierwszy - rozpoznawanie, kto mówi, w czasie rzeczywistym. Cena w API się nie zmieniła: 0,20 USD za godzinę nagrania. Zrobiliśmy krótką próbę po polsku, v2 kontra v3, na nagraniu pełnym trudnych nazw.
W skrócie
Scribe v3 jest już domyślnym modelem w aplikacji ElevenLabs, a w API wystarczy zmienić identyfikator modelu na scribe_v3 albo scribe_v3_live. Cennik API (odczyt 18.11.2026): Scribe v3 - 0,20 USD za godzinę, v3 Live - 0,22 USD za godzinę, w planie Free 4 h 30 min nagrań (v3) albo 2 h 30 min (Live). W naszej próbie na czystym nagraniu po polsku v3 pomylił się tyle samo co v2 - po dwa trudne nazwy własne - a oba modele poprawiły się po podaniu listy słów kluczowych (keyterms). Różnicę, którą obiecuje ElevenLabs, trzeba sprawdzać na trudniejszym dźwięku: szumie, rozmowie kilku osób, telefonie.
Co nowego w Scribe v3
Scribe to rodzina modeli ElevenLabs do transkrypcji (opis pierwszej wersji: ElevenLabs Scribe po polsku). Trzecia generacja ma dwa modele:
| Scribe v3 | Scribe v3 Live | |
|---|---|---|
| Do czego | gotowe nagrania (pliki) | dźwięk na żywo: rozmowy, agenci głosowi, napisy |
| Identyfikator w API | scribe_v3 | scribe_v3_live |
| Błędy wg ElevenLabs | 27% mniej błędnych słów niż Scribe v2 (102 języki FLEURS) | 43% mniej błędów znaczeniowych niż Scribe v2 Realtime |
| Kto mówi (diaryzacja) | 12% mniej błędów, 17% mniej przy 3 i więcej osobach | nowość w trybie na żywo: 3,1% błędów diaryzacji (inne testowane modele 5,9-7,3%) |
| Słowa kluczowe | do 1000 terminów w zapytaniu | biblioteka słownictwa dla bardzo dużych zbiorów |
| Inne | reguły formatowania pisane zwykłym językiem, liczby jako cyfry albo słowa, podpowiedzi języka | wykrywanie końca wypowiedzi z kontekstu (nie tylko po ciszy), zmiana języka w środku zdania |
| Cena API | 0,20 USD / godz. | 0,22 USD / godz. |
Źródła: ElevenLabs blog, 10.11.2026 (aktualizacja 14.11), dokumentacja modeli, cennik API. Odczyt: 18.11.2026.
W dokumentacji ElevenLabs podaje średni błąd słów (WER) na FLEURS dla wszystkich 102 języków: 16,94% dla Scribe v2 i 12,38% dla Scribe v3. Na blogu firma pokazuje największe spadki dla niemieckiego (42%), hiszpańskiego (35%) i suahili (34%). Wyniku dla polskiego nie publikuje.
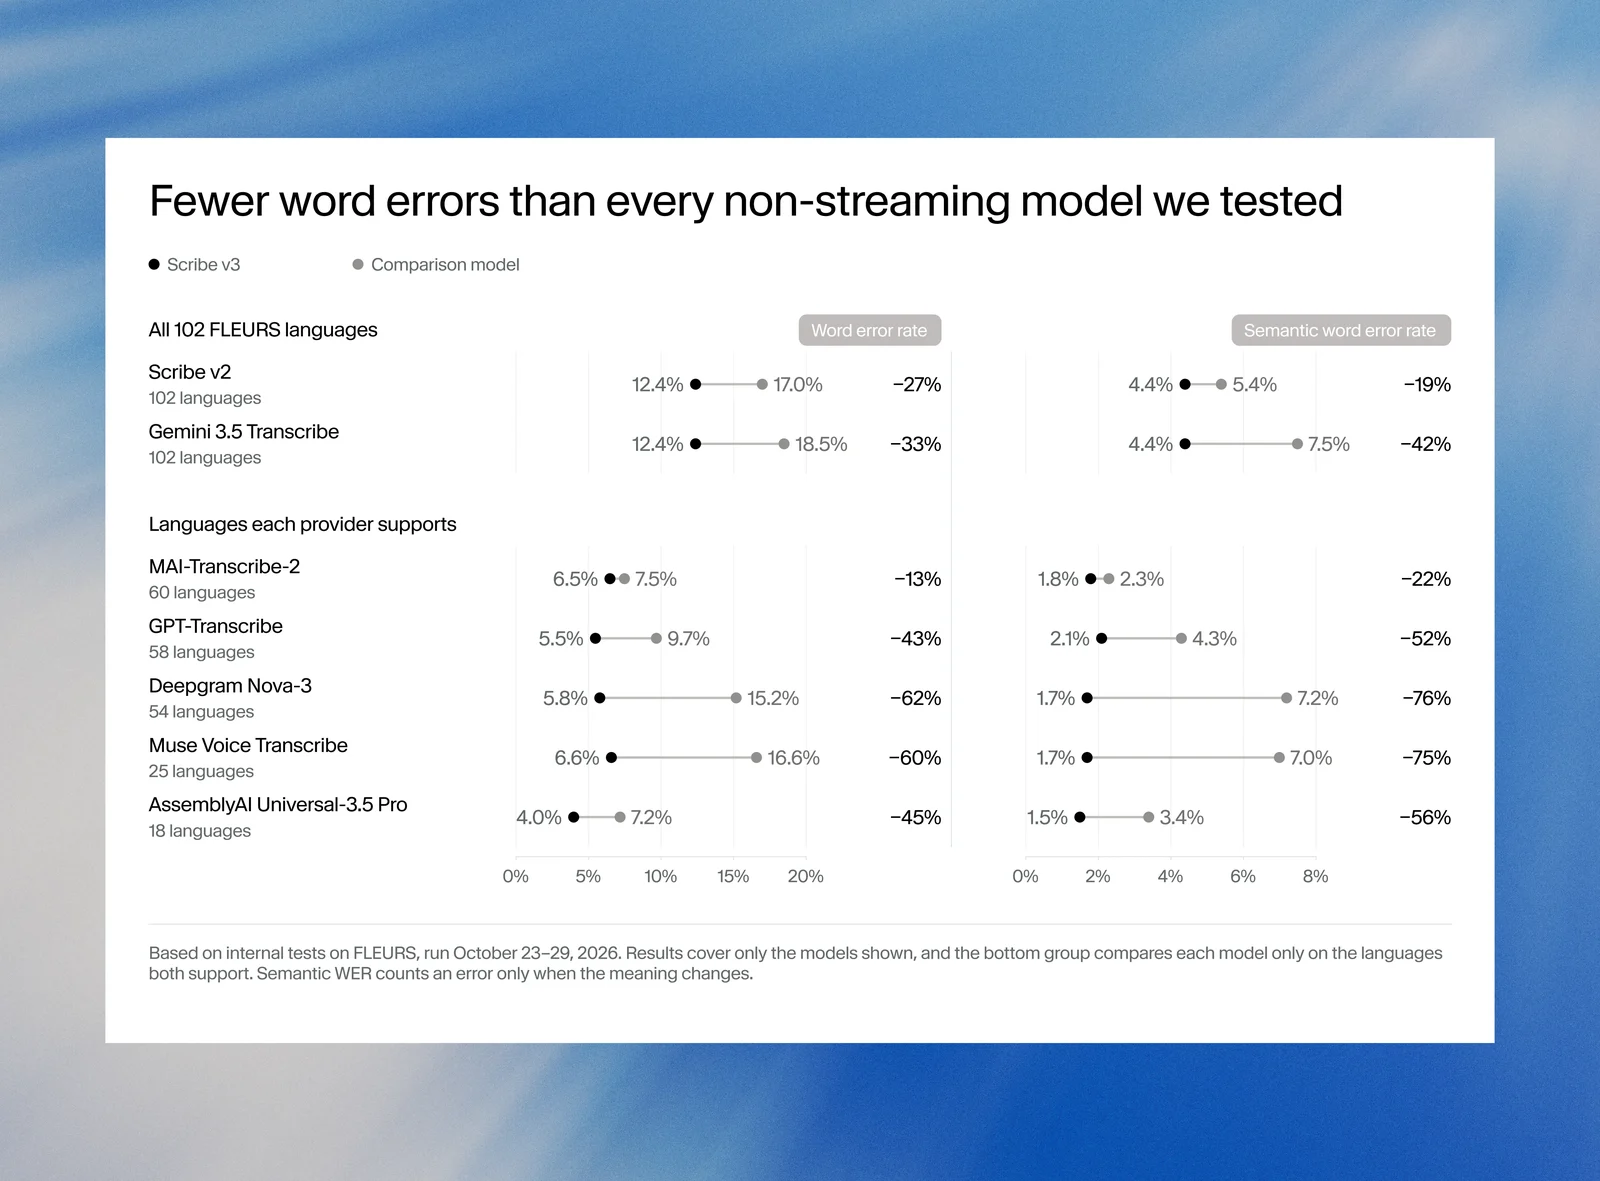
Z wykresu: w 102 językach Scribe v3 ma 12,4% błędnych słów wobec 17,0% dla Scribe v2 i 18,5% dla Gemini 3.5 Transcribe. W językach wspólnych z konkurencją: 6,5% wobec 7,5% dla MAI-Transcribe-2 i 5,5% wobec 9,7% dla GPT-Transcribe. To pomiary ElevenLabs.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Nasza próba po polsku: Scribe v2 kontra v3
Jak: 92-wyrazowy tekst po polsku, nagrany syntezą mowy ElevenLabs (model Multilingual v2) dwoma głosami z biblioteki, po około 45 sekund. W tekście: nazwisko Brzęczyszczykiewicz, miejscowość Chrząszczyrzewoszyce, „powiat łękołodzki”, daty, numer zamówienia, kwota, adres e-mail i karta GeForce RTX 4090. Każde nagranie przepisaliśmy przez API 18.11.2026 czterema wariantami: v2 i v3, bez listy słów kluczowych i z listą 5 terminów (keyterms). Język ustawiony na polski. Koszt wszystkich zapytań: poniżej 0,05 USD.
Zastrzeżenie: to czysty, syntetyczny dźwięk z jednym mówcą. Nie mierzy tego, w czym v3 ma być najlepszy według ElevenLabs: szumu, rozmów kilku osób, nagrań z telefonu. Traktuj to jako sprawdzenie polskich nazw, nie ranking.
| Wariant | Chrząszczyrzewoszyce | łękołodzkim | Liczby i e-mail | Czas odpowiedzi |
|---|---|---|---|---|
| Scribe v2 | „Chrząszczy Rzewoszyc” (oba głosy) | „łękołockim” (oba) | liczby słownie, e-mail sformatowany: biuro@przykład.pl | 4-5 s |
| Scribe v2 + keyterms | poprawnie (oba) | poprawnie (oba) | jak wyżej | 3-4 s |
| Scribe v3 | „Chrząszczyżewoszyc” (oba) | „łękołockim” (oba) | liczby słownie, e-mail dosłownie: „biuro małpa przykład kropka pl” | 6-19 s |
| Scribe v3 + keyterms | poprawnie (głos 1), „Chrząszczyżewoszyc” (głos 2) | poprawnie (oba) | jak wyżej | 6 s |
Próba promptowy.com, 18.11.2026, API ElevenLabs, 2 nagrania x 4 warianty. Jedno zapytanie v2 z keyterms trzeba było ponowić (przekroczony czas oczekiwania).
Wnioski z tej próby:
- Reszta tekstu bezbłędnie we wszystkich wariantach - daty, kwota „tysiąc dwieście czterdzieści dziewięć złotych i dziewięćdziesiąt groszy”, „Szczebrzeszyn”, „w Pszczynie pszczoły”, „GeForce RTX 4090”.
- Trudne nazwy własne psuje i v2, i v3 - każdy po dwie na nagranie. v3 zapisał „Chrząszczyżewoszyc” przez „ż”.
- Lista słów kluczowych działa - po jej podaniu v2 poprawił obie nazwy w obu nagraniach, v3 w trzech przypadkach na cztery. Jeśli transkrybujesz nagrania z nazwiskami, nazwami firm albo miejscowości, podawaj je w
keyterms. - v3 nie zamienił e-maila na adres - zapisał go dosłownie, tak jak był wypowiedziany. v2 sam zrobił „biuro@przykład.pl”. W v3 takie rzeczy ustawia się regułami formatowania.
- v3 był wolniejszy - 6-19 s na 45 s nagrania wobec 3-5 s dla v2. Przy pojedynczych plikach to bez znaczenia.
Jak używać Scribe v3
W aplikacji ElevenLabs
- Zaloguj się na ElevenLabs (konto Free wystarczy na początek).
- Wybierz Speech to Text i wgraj plik audio albo wideo.
- Scribe v3 jest domyślnym modelem. Ustaw język (polski) albo zostaw automatyczne wykrywanie, włącz rozpoznawanie mówców, jeśli jest kilka osób.
- Pobierz tekst albo napisy.
Przez API
Zapytanie POST /v1/speech-to-text z polem model_id=scribe_v3, plikiem i opcjonalnie language_code=pol oraz listą keyterms (do 1000 terminów). Kto korzysta już ze Scribe v2, zmienia tylko identyfikator modelu. Scribe v3 Live działa przez WebSocket i jest też w ElevenAgents (agenci głosowi), razem z wersją do rozmów medycznych.
Firmy: domyślnie dane przetwarzane są w USA, są osobne środowiska w UE, Indiach i Singapurze, tryb Zero Retention (usuwanie audio i tekstu po zakończeniu zapytania), SOC 2, ISO 27001, PCI DSS Level 1 i HIPAA z umową BAA.
Ile kosztuje Scribe v3
| Plan | Scribe v3 (0,20 USD/godz.) | Scribe v3 Live (0,22 USD/godz.) |
|---|---|---|
| Free | 4 h 30 min | 2 h 30 min |
| Starter | 30 h | 27 h |
| Creator | 110 h | 100 h |
| Pro | 495 h | 450 h |
| Scale | 1495 h | 1359 h |
| Business | 4950 h | 4500 h |
Godziny nagrań w ramach planu według cennika API ElevenLabs, odczyt 18.11.2026. Scribe v3 kosztuje tyle samo co Scribe v2.
Przykład: godzinny wywiad przez API to 0,20 USD, czyli mniej niż złotówka. Ceny planów w złotówkach i co jeszcze w nich jest: ElevenLabs - ceny i modele. Darmowe sposoby na transkrypcję: transkrypcja po polsku za darmo.
Najczęstsze pytania
Czy Scribe v3 obsługuje język polski?
Tak, Scribe rozpoznaje polski (ElevenLabs podaje „ponad 90 języków”, a wyniki liczy na 102 językach FLEURS). Osobnego wyniku dla polskiego firma nie publikuje. W naszej próbie zwykły polski tekst przepisał bezbłędnie, mylił się na rzadkich nazwach własnych.
Czy Scribe v3 jest za darmo?
W planie Free jest pula 4 h 30 min nagrań dla Scribe v3 (albo 2 h 30 min dla v3 Live). Potem płaci się 0,20 USD za godzinę w API albo kupuje wyższy plan.
Czym różni się Scribe v3 od Scribe v3 Live?
v3 przepisuje gotowe nagrania i jest dokładniejszy. v3 Live działa na żywo, z małym opóźnieniem, dla rozmów, napisów na żywo i agentów głosowych. Live kosztuje 0,22 USD za godzinę.
Jak poprawić nazwiska i nazwy w transkrypcji?
Podaj je w liście słów kluczowych (keyterms, do 1000 terminów). W naszej próbie po tym obie wersje poprawnie zapisały m.in. „łękołodzkim”.
Czy Scribe v3 rozpozna, kto mówi?
Tak. W plikach (v3) rozpoznawanie mówców było już wcześniej i według ElevenLabs ma 12% mniej błędów. Nowość to rozpoznawanie mówców na żywo w Scribe v3 Live.
Scribe v3 czy Gemini, GPT-Transcribe albo MAI-Transcribe?
Według wykresu ElevenLabs Scribe v3 ma mniej błędów od każdego z nich na FLEURS. To pomiar producenta. Niezależnego porównania po polsku na prawdziwych nagraniach jeszcze nie ma.
Źródła
- ElevenLabs: Scribe v3 (10.11.2026, aktualizacja 14.11.2026, odczyt 18.11.2026)
- ElevenLabs Docs: Models (odczyt 18.11.2026)
- ElevenLabs: API pricing (odczyt 18.11.2026)
- ElevenLabs na YouTube: Introducing Scribe v3
- Próba promptowy.com: API ElevenLabs, 18.11.2026, 2 nagrania syntetyczne x 4 warianty
Link do ElevenLabs jest partnerski: jeśli kupisz przez niego, serwis dostaje prowizję, a Ty płacisz tyle samo. Nie wpływa to na treść, także tam, gdzie piszę krytycznie.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
- generatornia.plSuno cena 2026: plany, limity pobrań i prawa autorskie
- przelomowy.plTest 10 modeli AI w zakupach: więcej rozumowania podnosi pewność, nie trafność wyboru
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI
- jutropis.plKE konsultuje formularz oceny wpływu AI na prawa podstawowe