GPT-6.2 Astra vs Claude Fable 5.2 vs Gemini 4 Carbon: benchmarki i mój test na 5 modelach
Spis treści 5
👁 138 przeczytań
- Według benchmarków OpenAI GPT-6.2 Astra wyprzedza Claude Fable 5.2 o 5,5 pkt w Agents' Last Exam i osiąga 1318 Elo w AA-3D wobec 1271 Fable 5.2.
- W teście 5 modeli na 4 zadaniach po polsku wszystkie uzyskały wynik 4/4, ale GPT-6.2 Astra była najszybsza (41 s, 0,13 USD), a Claude Fable 5.2 najwolniejsza i najdroższa (117 s, 0,52 USD).
- GPT-6.2 Astra kosztuje w API 8 USD za milion tokenów wejściowych i 40 USD wyjściowych, czyli taniej niż poprzednik GPT-6 Astra (10 USD/50 USD).
Krótko: według benchmarków OpenAI GPT-6.2 Astra wyprzedza Claude Fable 5.2 i Gemini 4 Carbon w pracy zawodowej, nauce i 3D, a robi to za ułamek ich kosztu. W moim teście po polsku wszystkie trzy rozwiązały 4 zadania bezbłędnie - różniły się czasem i ceną. GPT-6.2 Astra była najszybsza, najtańszy był Gemini 4 Carbon.
Uczciwie: ten tekst pisałem z pomocą Claude, czyli modelu Anthropic - liczby biorę z oficjalnych źródeł i własnego testu, nie z sympatii.
Benchmarki z ogłoszenia OpenAI
| Test | Co mierzy | Wynik |
|---|---|---|
| Agents’ Last Exam v1.1 | wieloetapowa praca zawodowa | GPT-6.2 Astra o 5,5 pkt przed Claude Fable 5.2 przy 5% jego kosztu |
| Harvey LAB-AA v1.1 | zadania prawnicze bez halucynacji | Astra ma ponad 2 razy wyższy odsetek zaliczeń niż Fable 5.2 przy ok. 1/6 kosztu |
| AA-3D (Artificial Analysis) | ludzie oceniają doświadczenia 3D w przeglądarce | Astra 1318 Elo, Fable 5.2 1271, GPT-6.2 Sol 1259 |
| Terminal-Bench-Science 0.1 | praca naukowa w terminalu | nowy rekord Astry; Anthropic podaje dla Fable 5.2 wynik 74,6% w Claude Code |
Zastrzeżenia samego OpenAI: wyniki Fable 5.2 w Agents’ Last Exam pomijają 9 zadań, w których użyto modelu zapasowego, a wynik Fable w Terminal-Bench-Science pochodzi od Artificial Analysis w innym środowisku niż wynik podany przez Anthropic. Gemini 4 Carbon jest na wykresach, ale OpenAI nie podaje dla niego w tekście konkretnych różnic. Źródło: wpis OpenAI, odczyt 17.11.2026.
Nie przepłacaj za subskrypcje AI
Prowadzę sklep z rocznymi dostępami do narzędzi AI, taniej niż w cenniku producenta. Sprawdź, co jest teraz na stanie.
Mój test: te same 4 zadania, 5 modeli
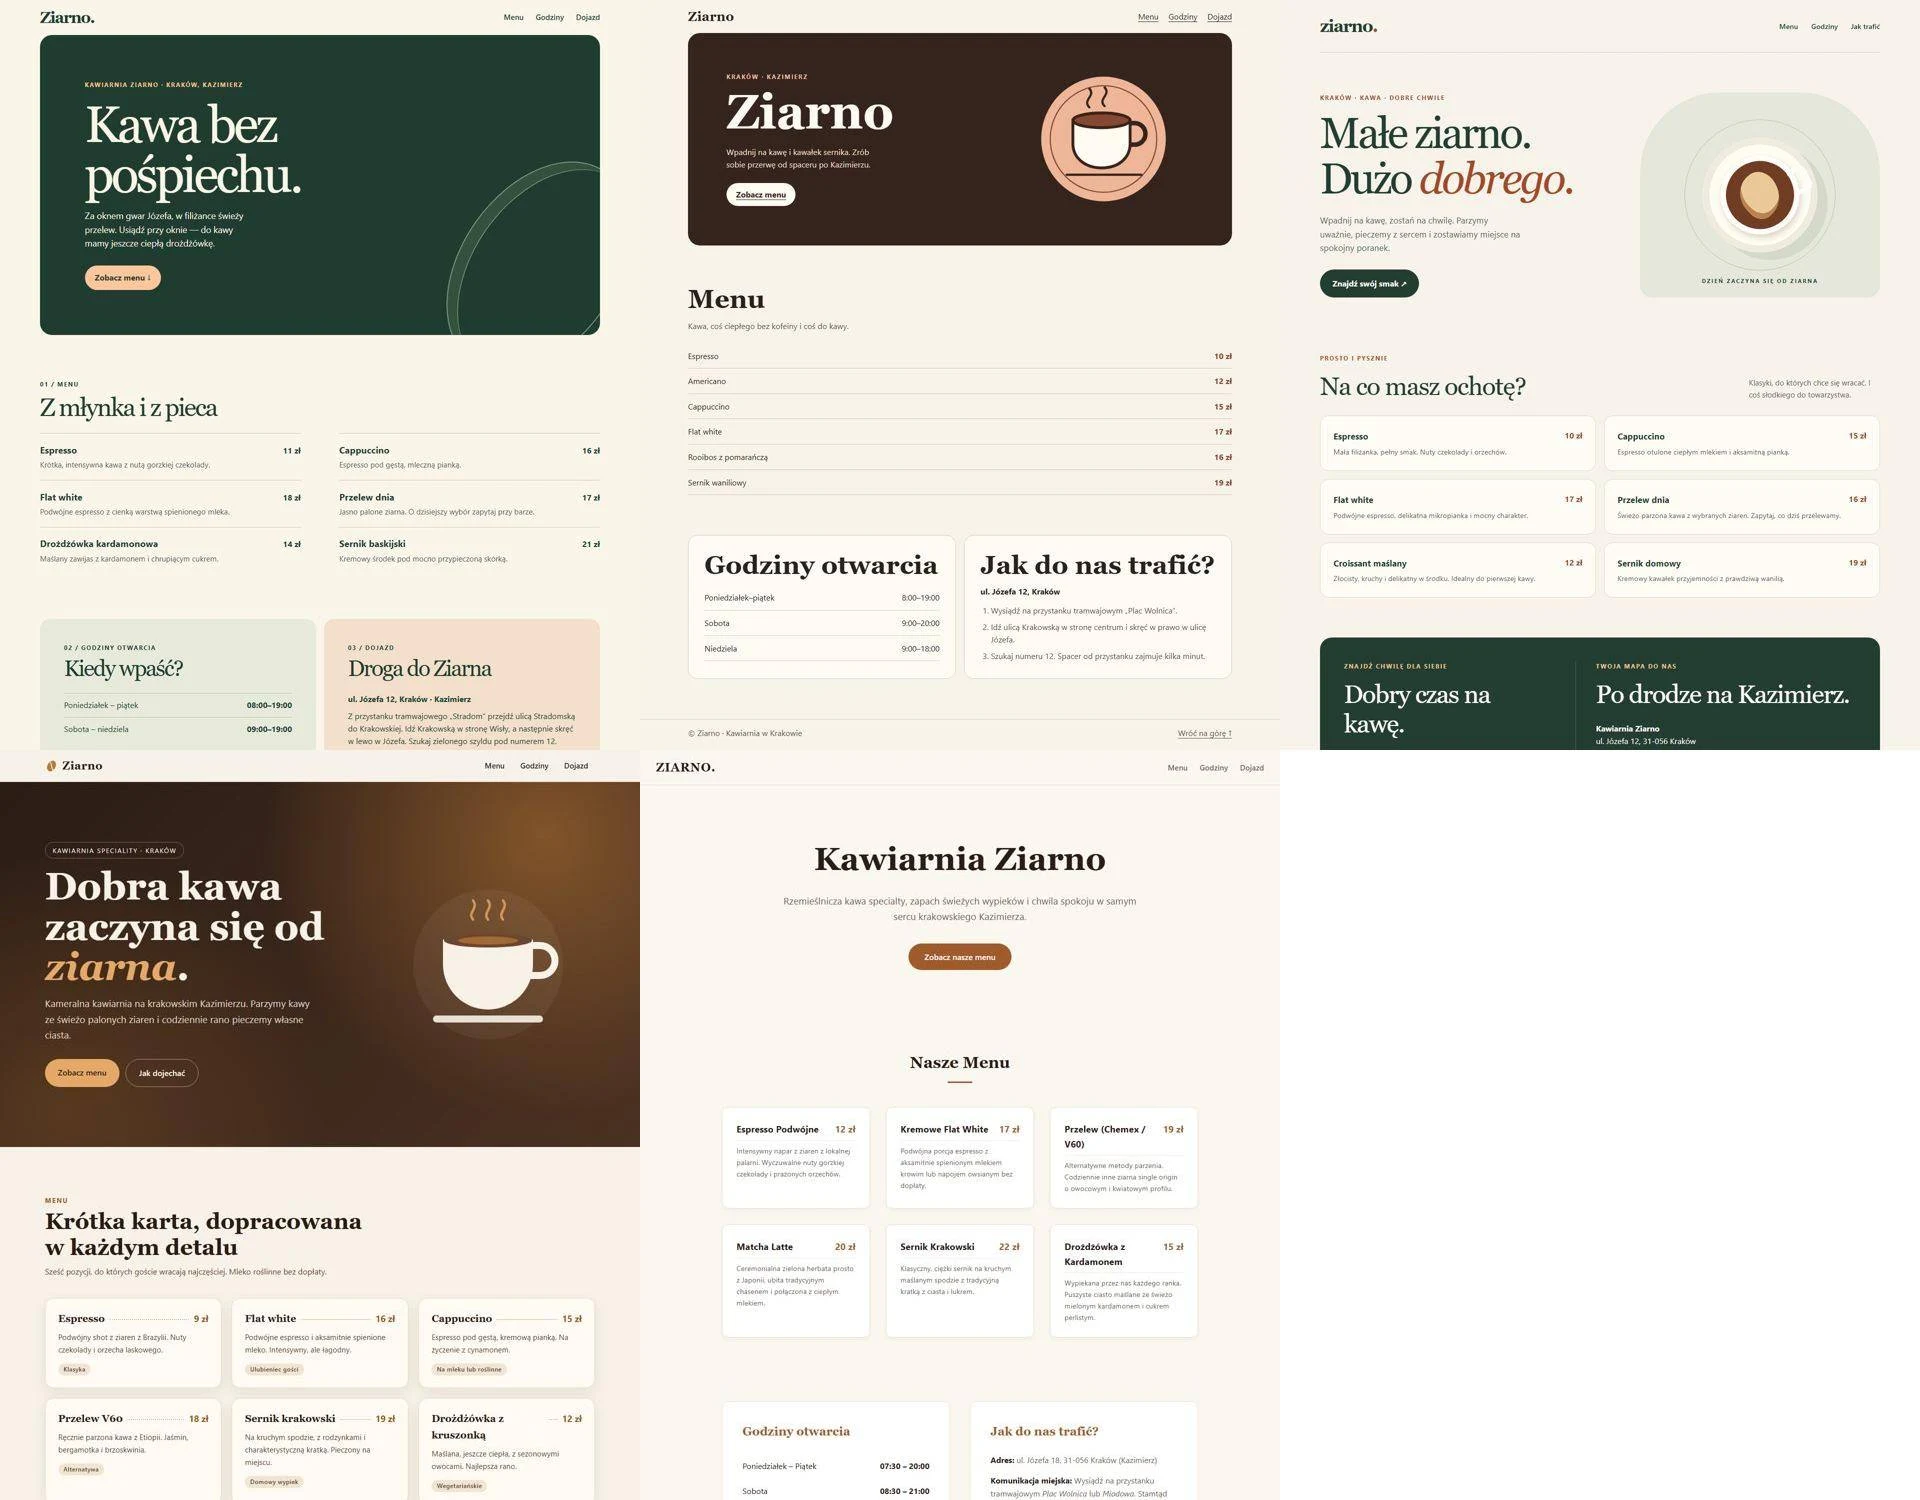
Zadania: zadanie z pociągami (wynik 9:42), funkcja walidująca PESEL w Pythonie z testami, korekta tekstu z 6 błędami i strona kawiarni w jednym pliku HTML. Każde raz, przez OpenRouter, na domyślnych ustawieniach, 17.11.2026.
| Model | Poprawność | Czas 4 zadań | Koszt 4 zadań | Długość strony HTML |
|---|---|---|---|---|
| GPT-6.2 Astra | 4/4 | 41 s | 0,13 USD | 2 508 tokenów |
| GPT-6.2 Sol | 4/4 | 40 s | 0,034 USD | 2 378 tokenów |
| GPT-6 Astra | 4/4 | 81 s | 0,26 USD | 4 073 tokeny |
| Claude Fable 5.2 | 4/4 | 117 s | 0,52 USD | 10 331 tokenów |
| Gemini 4 Carbon | 4/4 | 130 s | 0,075 USD | 3 230 tokenów |
Co z tego wynika:
- W prostych zadaniach po polsku nie ma przegranych - wszystkie pięć modeli policzyło, napisało kod przechodzący testy i poprawiło 6 z 6 błędów.
- GPT-6.2 jest wyraźnie oszczędniejszy niż poprzednik: Astra zrobiła to samo co GPT-6 Astra w połowie czasu i za połowę ceny.
- Claude Fable 5.2 pisze najdłużej - stronę HTML ponad 4 razy dłuższą niż GPT-6.2, z dodatkami, o które nie prosiłem. Jeśli płacisz za tokeny, to widać na rachunku.
- Gemini 4 Carbon był najwolniejszy, ale drugi najtańszy po GPT-6.2 Sol.
Ceny w API (za milion tokenów)
| Model | Wejście | Wyjście |
|---|---|---|
| GPT-6.2 Astra | 8 USD | 40 USD |
| GPT-6.2 Sol | 2 USD | 10 USD |
| GPT-6 Astra | 10 USD | 50 USD |
Ceny Claude Fable 5.2 i Gemini 4 Carbon zebrałem w tekstach Claude Fable 5.2 vs GPT-6 Astra vs Gemini 4 i najtańszy dostęp do topowych modeli.
Co wybrać
- Pracujesz na dokumentach, slajdach, arkuszach, dużym kodzie - GPT-6.2 Astra: najlepsze wyniki producenta w pracy zawodowej i duża oszczędność względem GPT-6 Astra.
- Chcesz dużo i tanio - GPT-6.2 Sol albo Gemini 4 Carbon.
- Lubisz Claude i jego styl - Fable 5.2 dalej robi bardzo dobre rzeczy, ale w tym teście był najdroższy i najwolniejszy.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
FAQ
Czy GPT-6.2 Astra jest lepszy od Claude Fable 5.2?
W benchmarkach OpenAI tak: w Agents’ Last Exam o 5,5 pkt, w AA-3D 1318 wobec 1271 Elo. W moich prostych zadaniach po polsku oba były bezbłędne, a GPT-6.2 Astra była szybsza i tańsza.
Który model jest najtańszy?
W moim teście GPT-6.2 Sol (0,034 USD za 4 zadania), potem Gemini 4 Carbon (0,075 USD).
Czy te benchmarki są niezależne?
Część pochodzi od OpenAI (GDPval v2), część od zewnętrznych firm (Artificial Analysis, Harvey, Cognition), ale wszystkie zestawienia w ogłoszeniu wybrał producent. Dlatego dokładam własny test.
Więcej: premiera GPT-6.2 Astra i Sol, GPT-6.2: cena, dostęp w Polsce, Astra czy Sol.
Więcej o tym temacie: Megaherc - polski ranking modeli AI

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.