Lip-sync AI po polsku: Seedance, Wan i InfiniteTalk - test
Ten sam kadr i fragment polskiej piosenki pokazały różnicę między ładnym obrazem a zgodnym playbackiem. Sprawdziłem wyniki MediaPipe, koszty API i lokalny InfiniteTalk.
👁 117 przeczytań
- InfiniteTalk uruchomiony lokalnie uzyskał najwyższą korelację lip-sync wynoszącą 0,471, wyprzedzając Wan 3.0 z wynikiem 0,419 i Seedance 2.5 z wynikiem 0,153.
- Seedance 2.5 kosztował w tej próbie 5,3365 USD i dał najładniejszy obraz, ale zwrócił własną ścieżkę dźwiękową z korelacją 0,12 względem oryginału, co wymuszało podmianę audio.
- Wan 3.0 nie ukończył zlecenia na 20 s i zwrócił błąd generation_failed, przez co wspólnym odcinkiem pomiaru dla wszystkich trzech modeli zostało pierwsze 15 s.
Sprawdziłem lip-sync AI do polskiej piosenki na tym samym fragmencie i z tym samym kadrem postaci. Seedance 2.5 dał obraz, który podobał mi się najbardziej, ale najsłabiej dopasował usta do wokalu. Wan 3.0 był szybszą drogą do użytecznego playbacku, choć zatrzymał mnie limit długości. Lokalny InfiniteTalk uzyskał najlepszy wynik pomiaru, za cenę dłuższego oczekiwania.
W skrócie
W porównaniu pierwszych 15 s InfiniteTalk uzyskał korelację 0,471, Wan 3.0 osiągnął 0,419, a Seedance 2.5 zakończył próbę z wynikiem 0,153. To wskaźnik zgodności otwarcia ust z głośnością wokalu, a nie procent poprawnie zaśpiewanych słów. Do ujęcia nastawionego na playback wybrałbym InfiniteTalk. Seedance potraktowałbym jako bazę obrazu do dalszej obróbki.
Ten sam fragment, ta sama postać
Do próby wybrałem fragment „Kiedy po swojemu gram” od 14,5 do 34,5 s. Obejmuje drugi refren, wejście perkusji i początek zwrotki. Dzięki temu nie oceniałem wyłącznie spokojnej, długo trzymanej samogłoski. Materiał zawiera zmianę energii, przy której łatwiej dostrzec, czy twarz reaguje na śpiew, czy tylko wykonuje efektowną animację.
Punktem wyjścia był ten sam kadr postaci przygotowany lokalnie w Z-Image Turbo. W wariantach API użyłem odniesienia audio przez silnik TAKT. Lokalny wariant opierał się na InfiniteTalk uruchomionym przez WanVideoWrapper, z bazą Wan 2.1 I2V 14B fp8 i lightx2v przy 6 krokach. To porównanie konkretnych konfiguracji, nie wszystkich możliwości tych modeli.
Planowałem zestawić całe 20 s, ale Wan 3.0 nie ukończył takiego zlecenia. Dlatego wspólnym odcinkiem pomiaru zostało pierwsze 15 s. Wyników z dłuższego fragmentu nie wstawiam do wspólnego rankingu. Inaczej porównywałbym modele na materiale o różnej zawartości, a sama tabela wyglądałaby bardziej wiarygodnie, niż zasługiwałaby na to metoda.
Jak policzyłem lip-sync przez MediaPipe
W skrypcie lipsync_pomiar.py zestawiłem przebieg otwarcia ust wykrywanego przez MediaPipe z głośnością wokalu wydzielonego przez demucs. Szukałem przesunięcia w zakresie ±0,5 s. Wyższa korelacja oznaczała lepszą zgodność tych przebiegów w przyjętej metodzie. Pozwalało to oddzielić ogólną reakcję twarzy na głos od samego wrażenia, że postać „coś śpiewa”.
Ten pomiar ma ograniczenia. Głośność nie opisuje dokładnego kształtu ust wymaganego przez każdą polską głoskę. Zamknięcie warg, artykulacja spółgłosek i naturalność mimiki wymagają dodatkowej oceny podczas oglądania. Nie interpretuję więc korelacji jako automatycznej oceny wymowy ani dowodu, że odbiorca uwierzy w wykonanie całej piosenki.
Osobno odnotowałem wykrywanie twarzy. InfiniteTalk i Wan miały w zapisie 100%, a Seedance 69-76%. Mniejsza dostępność twarzy ogranicza kompletność pomiaru i utrudnia bezpośrednie wnioskowanie. Nie dopisuję przyczyny brakujących detekcji, ponieważ raport jej nie rozstrzyga. Łączę wskaźnik z oglądem materiału, zamiast traktować go jako samowystarczalny werdykt.
Szukanie przesunięcia oznacza również, że wynik opisuje dopasowanie przebiegów po takim wyrównaniu. Nie dowodzi, że plik pobrany z generatora ma od razu idealnie ustawiony początek ścieżki. Przy składaniu gotowego ujęcia sprawdzam więc osobno stały offset oraz to, czy zgodność utrzymuje się w kolejnych frazach. Przesunięcie całego audio może poprawić początek, lecz nie zastąpi właściwej animacji ust w dalszej części piosenki.
Wyniki, koszty i czas oczekiwania
| Wariant | Lip-sync, 15 s | Koszt zapisany w teście | Czas |
|---|---|---|---|
| InfiniteTalk lokalnie | 0,471 | 0 zł opłaty za generację, pozostaje prąd | 1284 s |
| Wan 3.0 przez API | 0,419 | 1,0594 USD | 330 s |
| Seedance 2.5 przez API | 0,153 | 5,3365 USD | 316 s |
Czasy dotyczą otrzymanych klipów: lokalnie i w Seedance materiał miał 20 s, a w Wan 15 s. Wspólna długość dotyczy kolumny z pomiarem synchronizacji. Kwoty są kosztami tej próby, nie cennikiem na dowolny dzień. Nie przeliczam ich na złotówki ani nie dopisuję kosztu energii, ponieważ nie mam takiego pomiaru.
Różniły się także parametry obrazu. InfiniteTalk oddał 832×480 przy 25 kl./s, Wan 1280×720 przy 30 kl./s, a Seedance 1280×720 przy 24 kl./s. Te różnice trzeba uwzględnić przy montażu. Sama wyższa rozdzielczość nie przełożyła się jednak w tym zestawieniu na lepszą zgodność ust z piosenką.
Seedance: najładniejszy obraz i problem z własnym audio
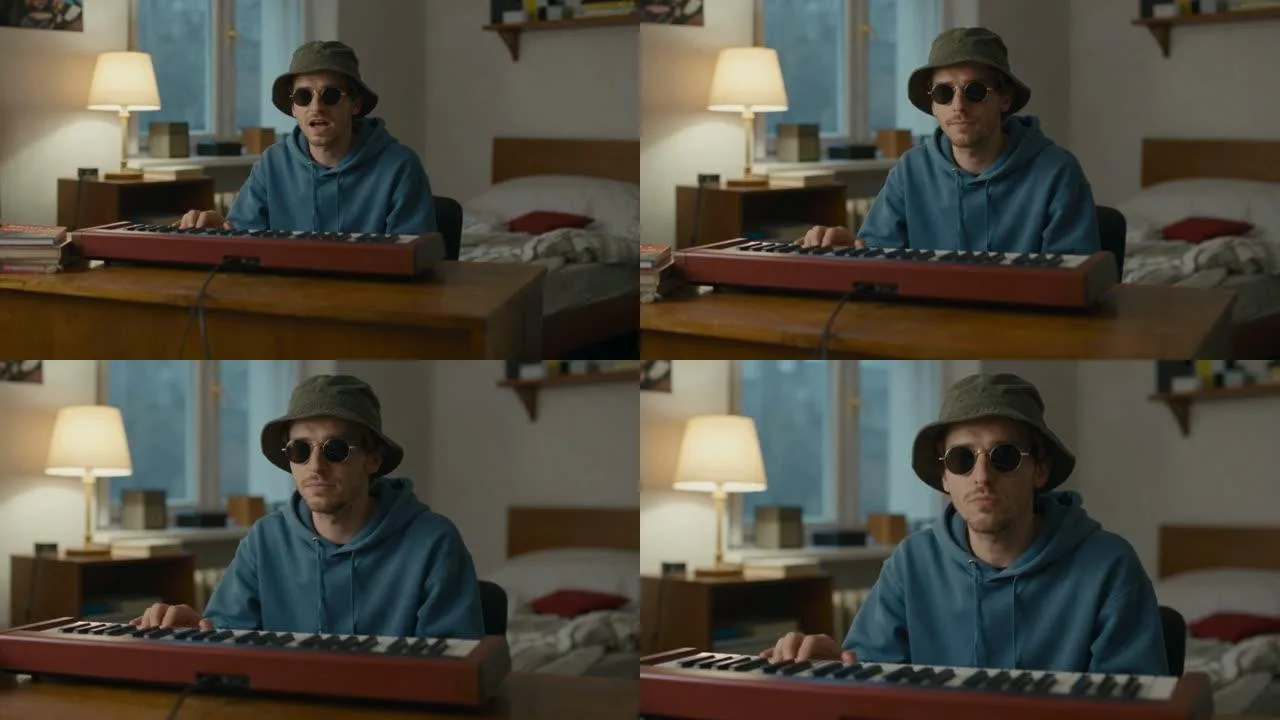
W Seedance najbardziej odpowiadały mi światło, kompozycja i ogólne wrażenie gotowego ujęcia. To ocena wizualna, którą oddzielam od pomiaru synchronizacji. Ładny kadr łatwo odciąga uwagę od ust, zwłaszcza gdy ogląda się go bez oryginalnej piosenki. Po zestawieniu obrazu z właściwym wokalem przewaga estetyczna przestała wystarczać.
Model zwrócił własną wersję ścieżki dźwiękowej. Jej korelacja z oryginałem wyniosła 0,12. W tym materiale podmiana dźwięku na oryginał była konieczna, z uwzględnieniem przesunięcia około 47 ms zapisanego w notatkach. Nie przenosiłbym tego przesunięcia automatycznie na inne klipy. Własna ścieżka modelu nie może zastępować mastera piosenki tylko dlatego, że przyszła razem z obrazem.
Wan 3.0: użyteczny playback, ale maksymalnie 15 s w tej próbie
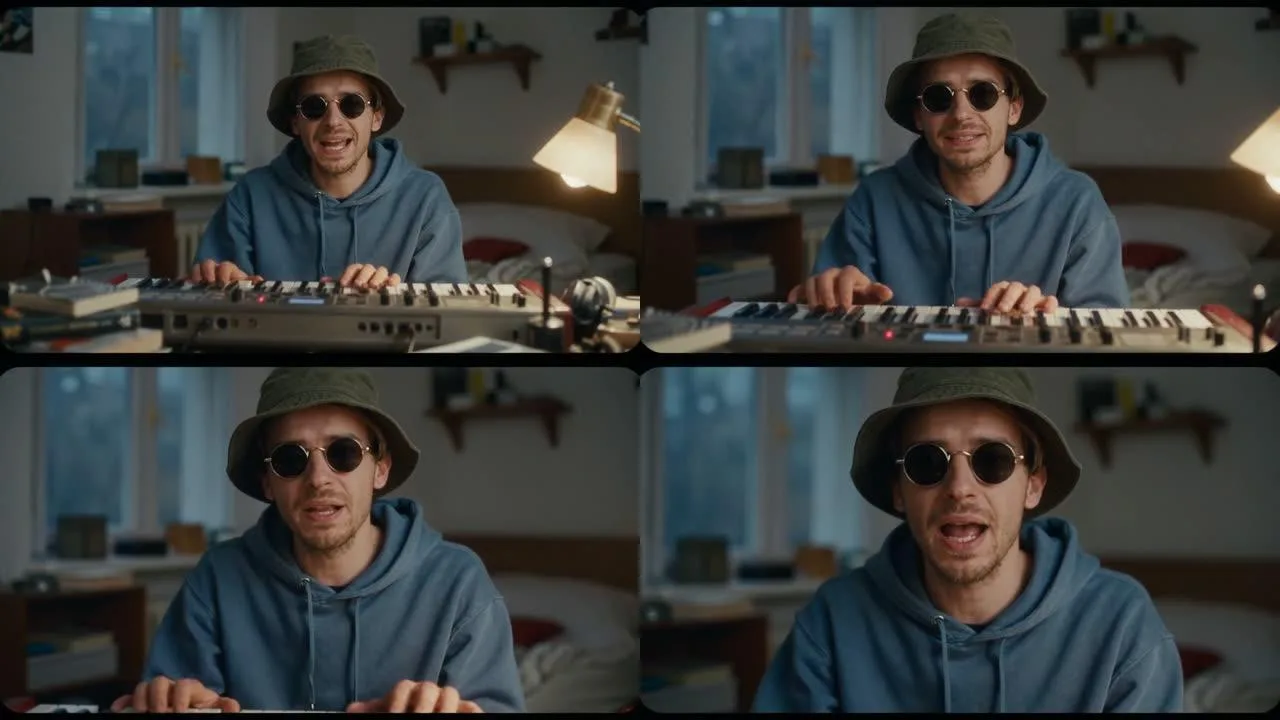
Wan uzyskał lepszą korelację niż Seedance i kosztował w tej próbie mniej. Najbardziej praktyczny problem pojawił się przed oceną obrazu: żądanie 20 s zakończyło się komunikatem generation_failed, bez opłaty. Dopiero 15 s działało. Tak rozumiem limit z tego testu: jako ograniczenie sprawdzonej ścieżki API, nie dowód dotyczący każdej możliwej integracji.
Przy planowaniu teledysku przygotowałbym więc krótsze odcinki i miejsca montażowych cięć. Nie zakładałbym, że dłuższa fraza przejdzie tylko dlatego, że pole długości przyjmie żądaną wartość. Udane wygenerowanie obrazu i dopasowanie granic klipu do muzyki to osobne zadania, które trzeba uwzględnić przed wysłaniem kolejnego zlecenia.
InfiniteTalk wygrywa pomiar, a V2V daje dodatkową drogę
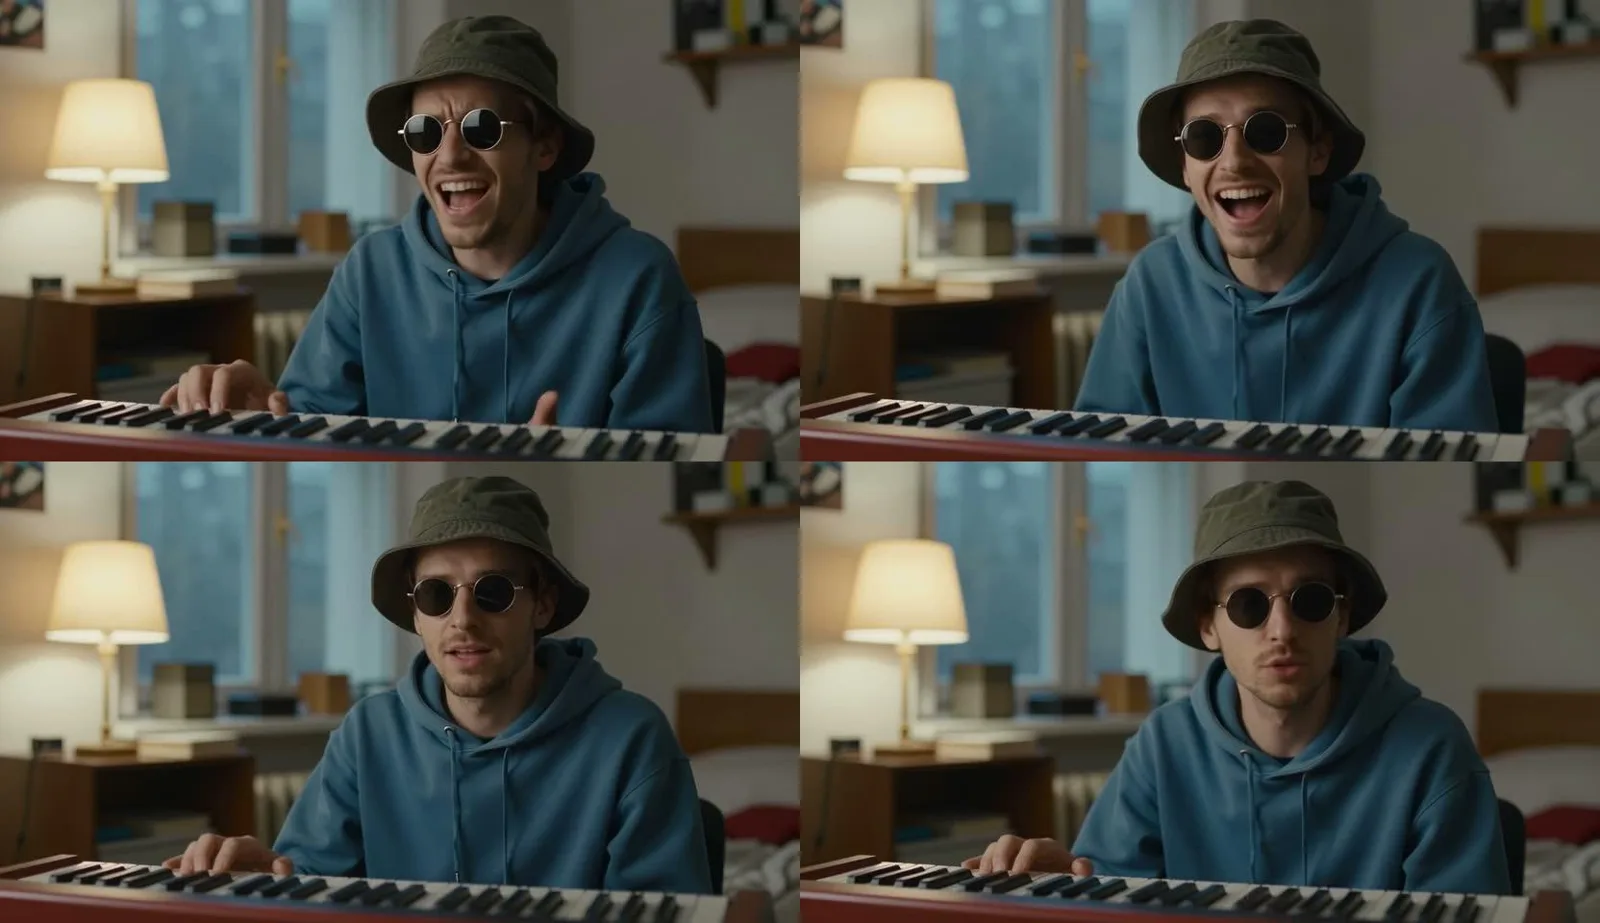
Lokalny InfiniteTalk uzyskał najwyższą korelację na wspólnym odcinku. Dla całych 20 s wynik wyniósł 0,424. Otrzymałem niższą rozdzielczość i dłuższy czas obliczeń, ale do zadania polegającego na śpiewaniu konkretnego fragmentu był to mocniejszy punkt wyjścia. Nie oznacza to jeszcze bezbłędnej artykulacji każdego słowa.
Sprawdziłem również połączenie Seedance z lokalnym InfiniteTalk w trybie V2V. Przy 2 z 4 kroków i audio_scale równym 1,5 korelacja wzrosła z 0,153 do 0,366. Wykrywanie twarzy wyniosło 77%, a dodatkowy etap trwał 656 s. Powstał materiał 832×480, więc poprawa playbacku wymagała zaakceptowania zmiany parametrów obrazu.
Ta ścieżka nie pobiła samodzielnego InfiniteTalk w pomiarze, lecz pozwoliła wykorzystać obraz wygenerowany wcześniej w API. Późniejszy SeedVR2 7B fp8 podniósł go do 1872×1080 w dodatkowych 1034 s. Traktuję to jako sposób wykończenia wybranego ujęcia. Upscale nie jest dowodem kolejnej poprawy synchronizacji.
Najczęstsze pytania
Który model wybrałbym do polskiego śpiewu?
Na podstawie tej próby wybrałbym InfiniteTalk, jeśli najważniejszy jest playback. Wan rozważyłbym przy krótszych ujęciach i potrzebie szybszego wyniku. Seedance zostawiłbym do obrazów, które uzasadniają dodatkową korektę ust.
Czy najwyższa korelacja oznacza idealny lip-sync?
Nie. Sprawdziłem zależność otwarcia ust od głośności wokalu, a nie poprawność wszystkich głosek. Wynik pomaga porównywać tę próbę, ale nie zastępuje oglądania klipu z oryginalnym miksem.
Czy lokalna generacja jest darmowa?
W raporcie zapisałem brak opłaty za generację. Pozostają energia, sprzęt i czas przygotowania środowiska. Bez pomiaru zużycia energii nie podaję pełnego kosztu ani obietnicy oszczędności przy każdej liczbie klipów.
Ceny i dostęp do modeli opisałem w tekstach Seedance i Wan 3.0, a plan ujęć do całego klipu w tekście Kling 4.0 do teledysków.
Źródła i data sprawdzenia
Pomiary, czasy i koszty: zapis testu klipy-ai-test/WYNIKI.md. Konfiguracje: opus-wideo/KLIPY-AI-REPO.md oraz karta infinitetalk.md. Ilustracje pochodzą z tej samej próby. Dokumentacja projektów: InfiniteTalk i WanVideoWrapper. Wnioski dotyczą opisanego materiału i zapisanych ustawień.
Sprawdzone 21 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym