Wan 3.0 po polsku: test modelu nr 1 w rankingu wideo - dialog, neon i film z PDF
Mówi po polsku słowo w słowo i pisze polskie neony z ogonkami. Drobny tekst się sypie, a filtr treści zablokował niewinną scenę na targu.
👁 119 przeczytań
- Wan 3.0 od Alibaby zajmuje 1. miejsce w rankingu wideo Artificial Analysis z wynikiem 1335 punktów Elo, wyprzedzając Gemini Omni Flash Google o zaledwie 3 punkty.
- Polskie kwestie dialogowe zostały wypowiedziane słowo w słowo, a neon z napisem ŻÓŁTA GĘŚ wyszedł bezbłędnie ze wszystkimi znakami diakrytycznymi - drobny tekst na kartkach już się sypie.
- Pięć testowych klipów o łącznej długości 71 sekund kosztowało 7,10 USD, a czas generowania wahał się od 3 do prawie 14 minut za jeden klip.
Wan 3.0 od Alibaby prowadzi w rankingu wideo Artificial Analysis: 1335 punktów Elo w kategorii tekst na wideo, przed Gemini Omni Flash i MiniMax H3. Robi do 30 sekund wideo w jednym przebiegu, z dźwiękiem, i potrafi zrobić film z dokumentu. Wydałem na testy 7,10 dolara: pięć klipów, w tym dialog po polsku, polski neon, jedno ujęcie na 30 sekund i film z pliku PDF. Poniżej wszystko, co wyszło - razem z tym, co nie wyszło.
Werdykt w jednym akapicie
Wan 3.0 mówi po polsku i pisze po polsku. Dialog „Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.” wyszedł słowo w słowo, a neon „ŻÓŁTA GĘŚ” - ze wszystkimi ogonkami. 30-sekundowe ujęcie bez cięcia utrzymało postać i kolejność akcji od początku do końca. Słabe strony: drobny tekst się sypie, generowanie trwa od 3 do 14 minut, filtr treści zablokował niewinną scenę na targu, a funkcja „wideo ze strony internetowej” w moich dwóch próbach nie zadziałała ani razu. Wideo z pliku PDF - zadziałało i to bardzo dobrze.
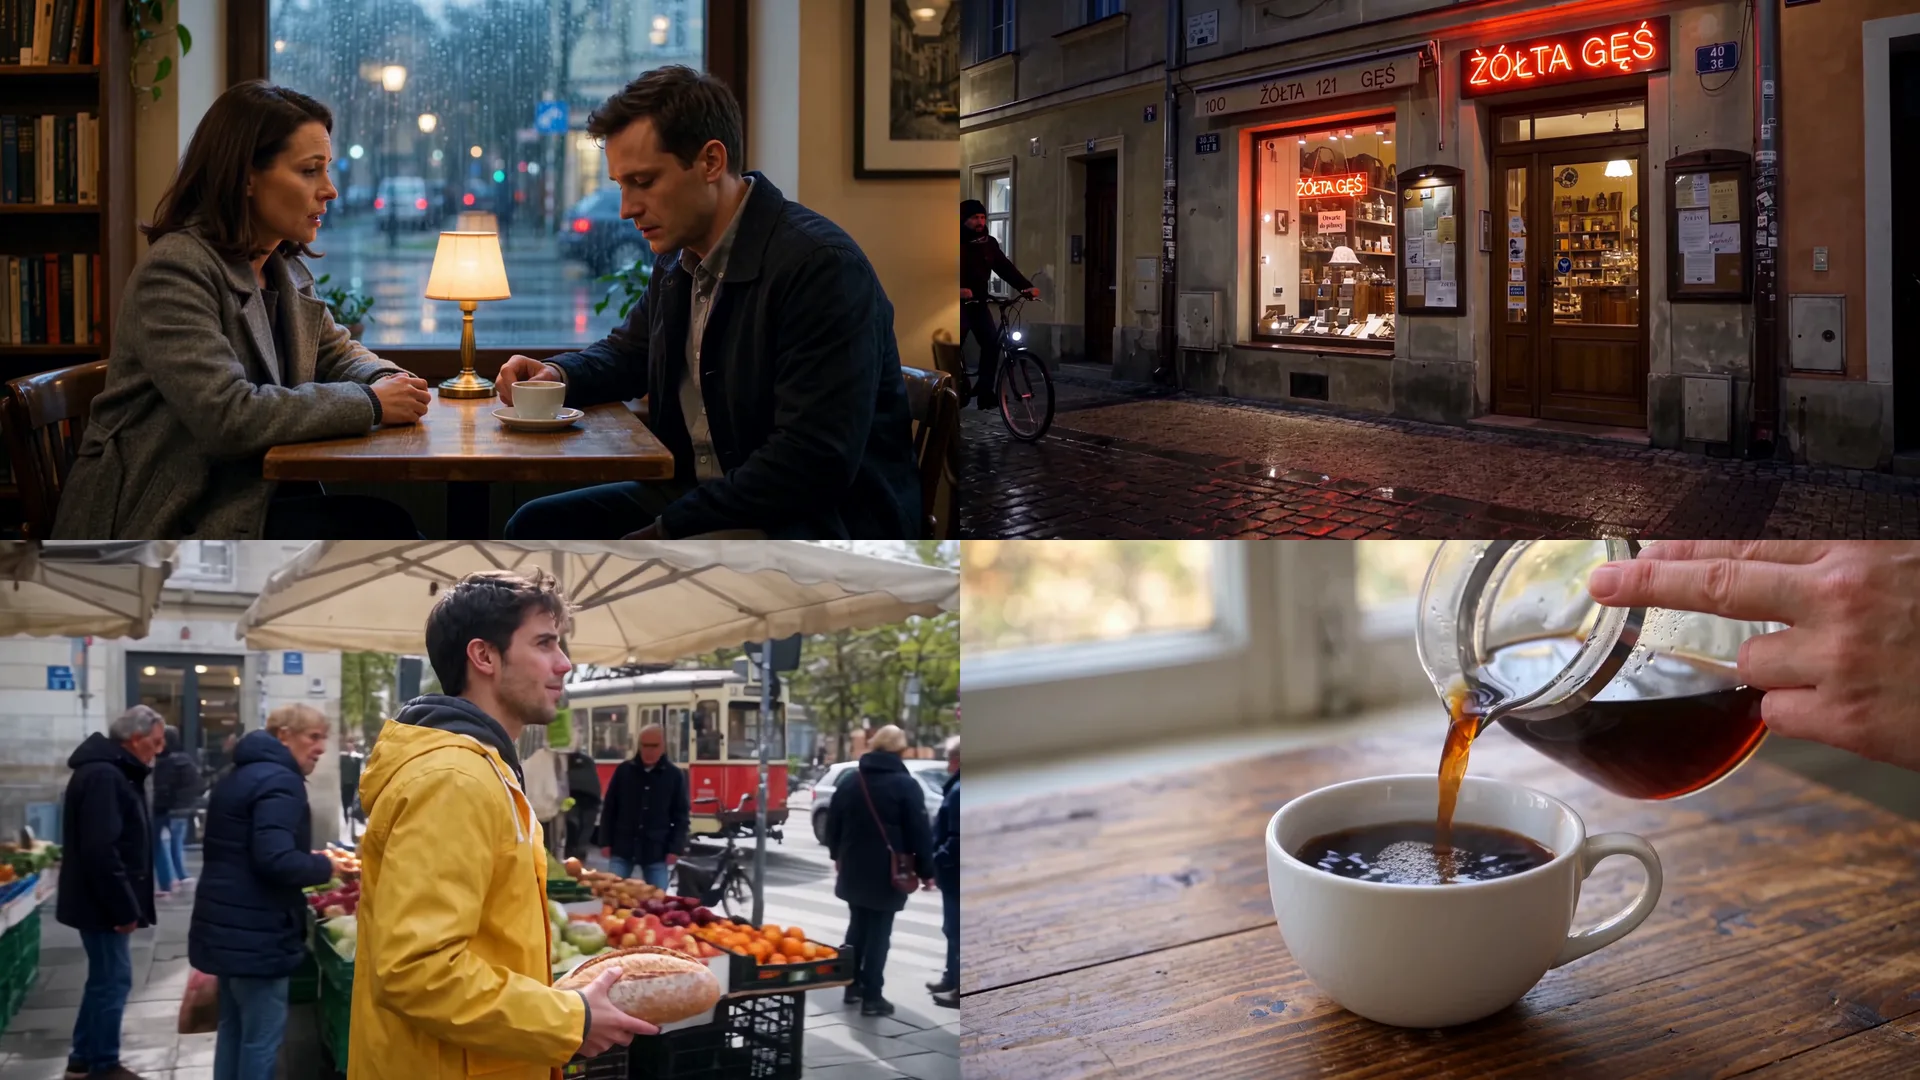
Cztery kadry z moich testów Wan 3.0: dialog po polsku, neon ŻÓŁTA GĘŚ, ujęcie 30-sekundowe i nalewanie kawy. 720p, bez poprawek.
Wan 3.0 w liczbach
| Parametr | Wan 3.0 |
|---|---|
| Producent | Alibaba (Alibaba Cloud) |
| Ogłoszenie | 13 sierpnia 2026 |
| Maksymalna długość | 30 sekund w jednym przebiegu |
| Rozdzielczość | 480p, 720p, 1080p |
| Wejście | tekst, obrazy, dźwięk, wideo i dokumenty: PDF, DOC, XLS, PPT, TXT, MD, Keynote, Pages, Numbers - 1 plik do 100 MB i 50 stron |
| Dźwięk | generowany razem z obrazem |
| Cena w Alibaba Cloud Model Studio | 0,05 / 0,10 / 0,20 USD za sekundę (480p / 720p / 1080p) |
| 30 sekund w 1080p | 6 USD (~22,70 zł) |
| Otwarte wagi | nie - tylko przez API |
| Ranking Artificial Analysis, tekst na wideo | 1. miejsce, 1335 Elo |
Ta sama stawka obowiązuje na fal.ai, przez które robiłem testy. Jest tam też wariant Wan 3.0 Prime - szybszy, za 0,14 USD za sekundę w 720p. Przeliczenie na złote po kursie 3,78 zł.
Ranking: prowadzenie o włos
| Miejsce | Model | Producent | Elo |
|---|---|---|---|
| 1 | Wan 3.0 | Alibaba | 1335 |
| 2 | Gemini Omni Flash | 1332 | |
| 3 | MiniMax H3 | MiniMax | 1302 |
| 4 | HappyHorse-1.0 | Alibaba (ATH) | 1286 |
Trzy punkty przewagi nad Gemini Omni Flash to w rankingu opartym na głosowaniach ludzi praktycznie remis. Ciekawostka: czwarty HappyHorse to też Alibaba, ale inna jednostka firmy (ATH) - dwa niezależne zespoły jednego koncernu w pierwszej czwórce.
Test 1: dialog po polsku
Polecenie opisywało kawiarnię w Warszawie w deszczowy wieczór i dwie kwestie po polsku: kobieta mówi „Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.”, mężczyzna odpowiada „Wiem.”.
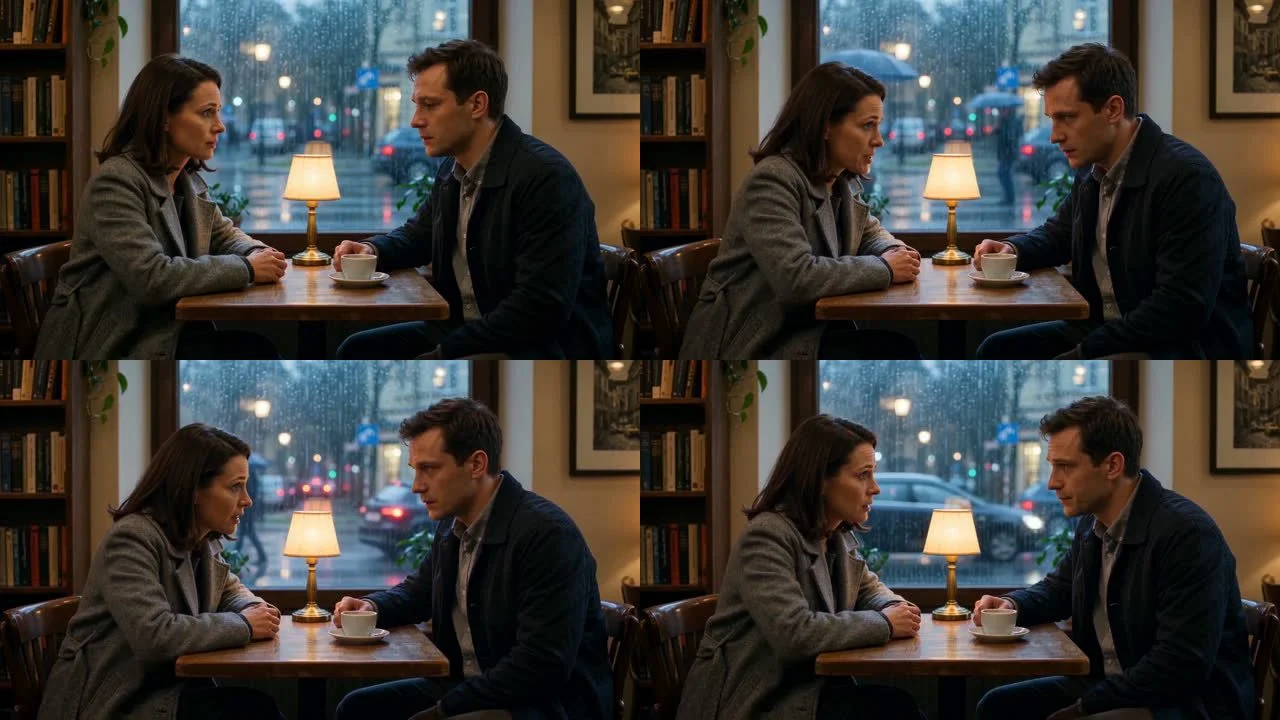
Cztery klatki z 8-sekundowego klipu. Postacie, stolik, lampa i deszcz za oknem są spójne przez całe ujęcie.
Przepuściłem ścieżkę dźwiękową przez rozpoznawanie mowy Whisper. Wynik: „Nie wyjadę bez Ciebie, słyszysz? Nie wyjadę.” i „Wiem.” - słowo w słowo, język rozpoznany jako polski z pewnością 99%. Kwestie padają w kolejności z polecenia: pierwsza od 0 do 4 sekundy, druga w 5. sekundzie. To realna przewaga: w moich wcześniejszych pracach z Seedance polskie kwestie w ogóle nie wchodziły w grę.
Koszt: 0,80 USD. Czas generowania: 3 minuty 38 sekund.
Test 2: polski napis w kadrze
Nocna ulica starego miasta, czerwony neon z napisem „ŻÓŁTA GĘŚ” i kartka w oknie „Otwarte do północy”. Wszystkie polskie litery naraz: Ż, Ó, Ł, Ę, Ś.
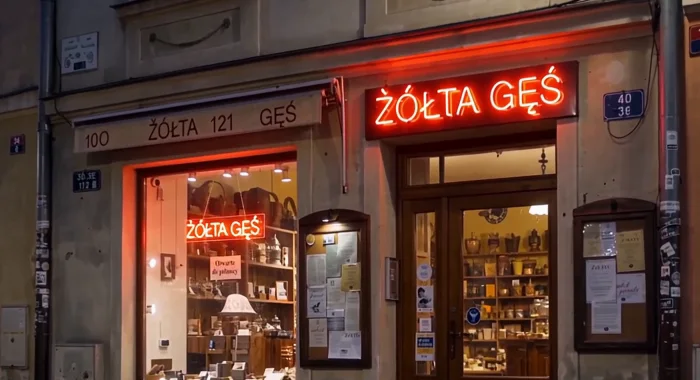
Neon ŻÓŁTA GĘŚ z poprawnymi ogonkami - dwa razy, bo model sam dodał drugi neon w witrynie. Szyld nad oknem ma dopisane liczby, których nie było w poleceniu.
Neon wyszedł bezbłędnie - wszystkie znaki diakrytyczne na miejscu, i to w dwóch miejscach, bo model sam dołożył drugi neon w witrynie. Dopisał też szyld „100 ŻÓŁTA 121 GĘŚ” - poprawna pisownia, ale liczby wziął znikąd.
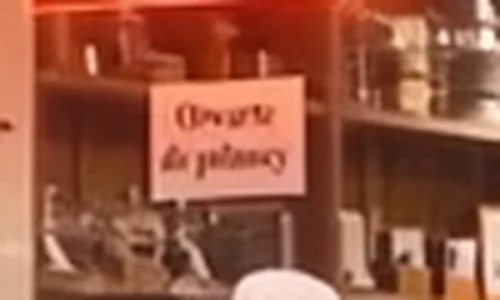
Kartka w oknie, powiększona. Słowo Otwarte jest czytelne, dalsza część napisu już nie.
Kartka pokazuje granicę: „Otwarte” jest czytelne, „do północy” - zniekształcone. Przy 720p i literach wysokości kilkunastu pikseli model nie utrzymał pisowni. Sama Alibaba przyznaje w ogłoszeniu, że dokładność tekstu w kadrze „wciąż się poprawia”. Wniosek praktyczny: duże napisy tak, drobny druk nie.
Test 3: fizyka i dłonie
Statyczne ujęcie z bliska: dłonie nalewają kawę ze szklanego dzbanka, strumień cienieje i się urywa, jedna dłoń podnosi filiżankę, druga wrzuca kostkę cukru.
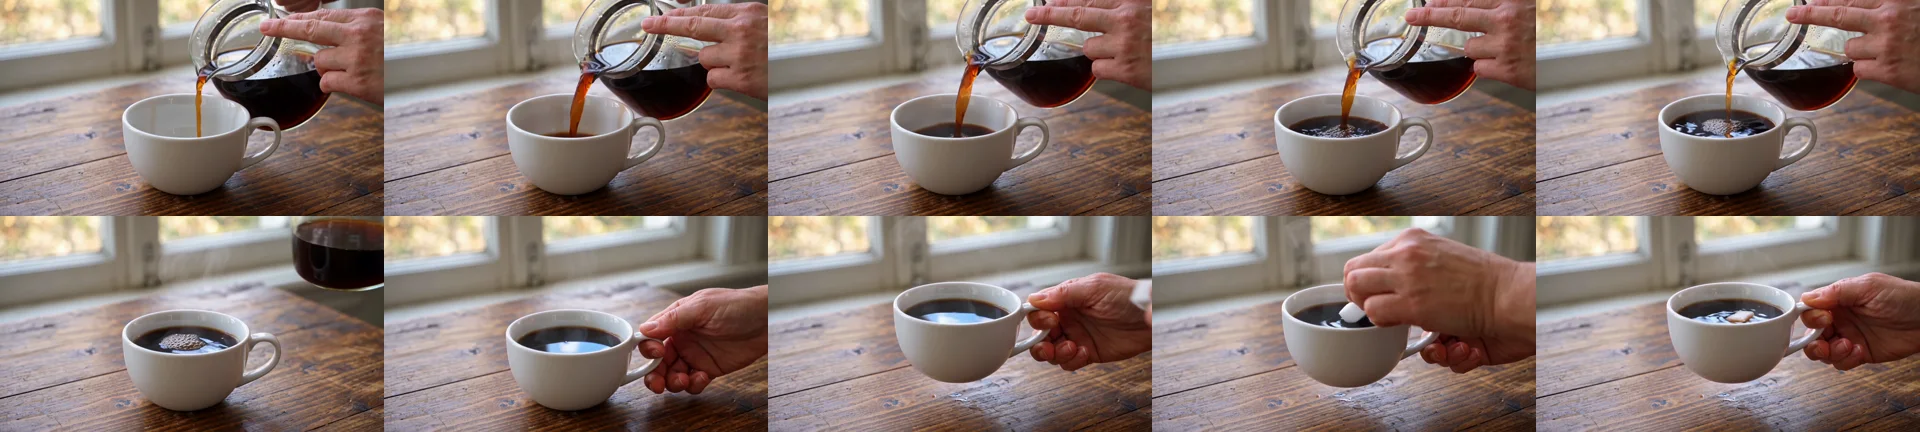
Dziesięć klatek, co sekundę. Strumień urywa się około 6. sekundy, dłoń podnosi filiżankę, kostka cukru wpada w 9. sekundzie.
Strumień kawy, jego urwanie, para i ruch dłoni wyglądają naturalnie, a kolejność zdarzeń zgadza się z poleceniem. W klatkach, które przejrzałem co sekundę, dłonie wyglądają poprawnie. Koszt: 1,00 USD, czas: 4 minuty.
Test 4: 30 sekund bez cięcia
Najtrudniejszy test: jedno ciągłe ujęcie z ręki, 30 sekund. Chłopak w żółtej kurtce przechodzi przez targ, mija stragany z jabłkami i rybami, kupuje chleb, płaci, kiwa głową i wychodzi na ulicę, gdzie przejeżdża tramwaj.
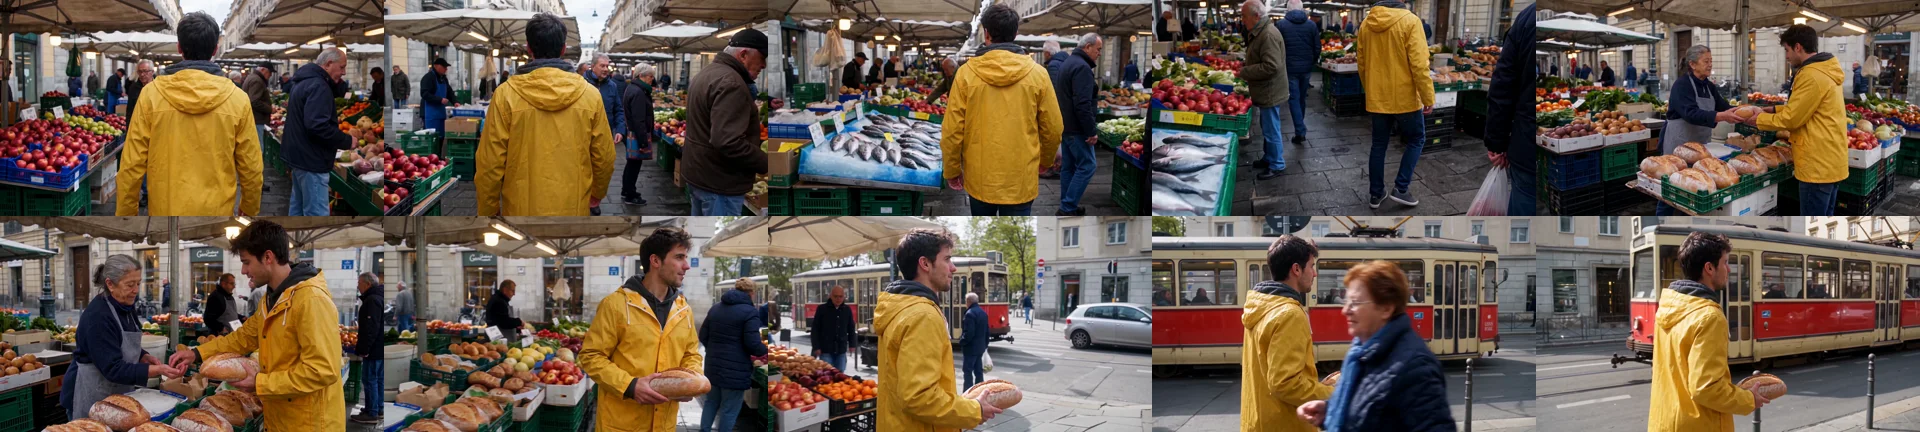
Dziesięć klatek co 3 sekundy z jednego 30-sekundowego ujęcia. Jabłka, ryby, zakup chleba, wyjście na ulicę i tramwaj - w kolejności z polecenia.
Wszystkie elementy są w kolejności z polecenia, a postać jest spójna przez całe 30 sekund - ta sama twarz, kurtka i chleb w dłoni. Detektor zmian sceny w ffmpeg zareagował tylko między 20. a 22. sekundą - obejrzałem te klatki co ćwierć sekundy i to szybka, płynna panorama za bohaterem, a nie cięcie. Jedyne odstępstwo: zamiast słonecznej ulicy jest pochmurno.
Ale ten klip ma drugą historię. Za pierwszym razem filtr treści fal.ai zablokował wynik z komunikatem, że materiał „został oznaczony przez system kontroli treści”. W scenie nie ma niczego poza targiem, chlebem i tramwajem. Druga próba z identycznym poleceniem przeszła. Filtr jest więc niedeterministyczny i daje fałszywe alarmy - a dowiadujesz się o tym po kilkunastu minutach czekania. Udana wersja generowała się 13 minut 35 sekund i kosztowała 3 USD.
Test 5: film z dokumentu
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
To funkcja, którą Alibaba stawia w centrum premiery: podajesz plik albo adres strony, a model robi z niego film. Sprawdziłem obie drogi.
| Próba | Wynik |
|---|---|
| Adres artykułu na promptowy.com | błąd: „nie udało się odczytać strony” - po około 20 minutach |
| Adres hasła „Żubr” w polskiej Wikipedii | błąd po stronie dostawcy |
| Adres PDF z Wikipedii bez rozszerzenia .pdf w adresie | odrzucone od razu - adres musi kończyć się rozszerzeniem pliku |
| Ten sam PDF wgrany do magazynu fal.ai | działa - 15 s wideo, 10,5 minuty generowania, 1,50 USD |
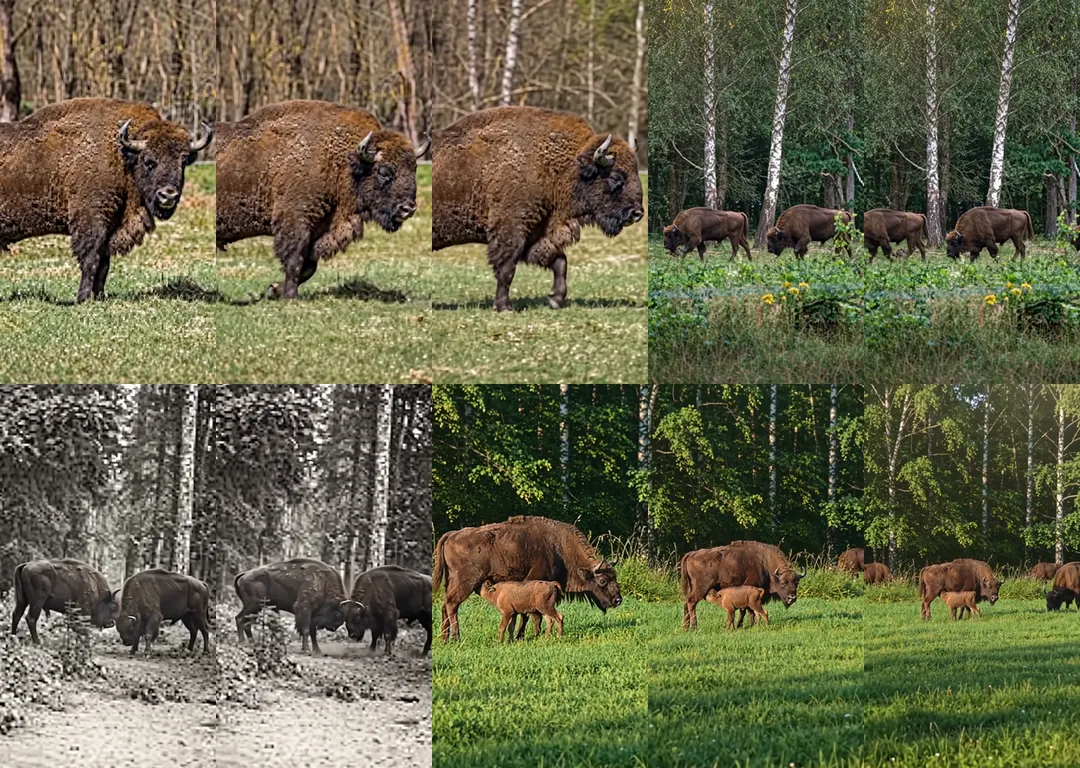
Klatki z 15-sekundowego filmu zrobionego z PDF hasła Żubr z polskiej Wikipedii. Cztery ujęcia, w tym czarno-białe przy zdaniu o tym, że gatunek prawie wyginął.
Efekt z PDF jest najciekawszy z całego testu. Model sam zmontował cztery ujęcia (detektor ffmpeg znalazł trzy cięcia: w 2,8, 8,2 i 10,2 sekundzie): żubr w zbliżeniu, stado w brzozowym lesie, czarno-biały kadr stylizowany na archiwalny i matka z młodym. Dodał lektora: „Meet the European bison, Europe’s largest land mammal. Once nearly extinct, they now roam these primeval forests.” - fakty zgodne z hasłem. Lektor mówi po angielsku, bo po angielsku było moje polecenie, choć dokument był polski. To jest moja interpretacja: żeby dostać polskiego lektora, trzeba o niego poprosić wprost.
Wniosek: wideo z dokumentu działa, ale tylko z plikiem. Na adresach stron w moich próbach nie zadziałało ani razu - przynajmniej przez fal.ai.
Ile to wszystko kosztowało
| Klip | Długość | Koszt | Czas generowania |
|---|---|---|---|
| Dialog po polsku | 8 s | 0,80 USD | 3 min 38 s |
| Kawa | 10 s | 1,00 USD | 4 min 4 s |
| Neon | 8 s | 0,80 USD | 3 min 17 s |
| 30 sekund bez cięcia | 30 s | 3,00 USD | 13 min 35 s |
| Film z PDF | 15 s | 1,50 USD | 10 min 27 s |
| Razem | 71 s | 7,10 USD (~26,80 zł) |
Koszt według stawki 0,10 USD za sekundę wideo w 720p. Średnio generowanie trwało około 25 sekund na każdą sekundę wideo. Do pracy „na żywo” to za wolno, do produkcji reklam i materiałów w social mediach - do przyjęcia.
Dla kogo jest Wan 3.0
- Dla twórców treści po polsku - dialog i duże napisy po polsku to rzadkość wśród modeli wideo. Opinia na podstawie jednego klipu z dialogiem.
- Dla firm robiących filmy z materiałów - prezentacja albo PDF zamienione w krótki film to realna oszczędność czasu.
- Nie dla niecierpliwych - 3-14 minut na klip i ryzyko fałszywego alarmu filtra.
- Nie do drobnego tekstu - napisy na kartkach, cenach czy etykietach się rozsypią.
Więcej o cenach wideo z AI: ile kosztuje sekunda wideo z AI. Inne chińskie premiery tego miesiąca: test pięciu modeli językowych po polsku.
Najczęstsze pytania
Czy Wan 3.0 mówi po polsku?
Tak. W moim teście postacie wypowiedziały polskie kwestie słowo w słowo - rozpoznawanie mowy Whisper potwierdziło to z pewnością 99%.
Ile kosztuje Wan 3.0?
0,05 USD za sekundę w 480p, 0,10 USD w 720p i 0,20 USD w 1080p. Klip 30-sekundowy w 1080p kosztuje 6 USD.
Czy Wan 3.0 jest open source?
Nie. W przeciwieństwie do wcześniejszych wersji Wan nie ma otwartych wag - działa tylko przez API, m.in. w Alibaba Cloud Model Studio i na fal.ai.
Jak długie wideo robi Wan 3.0?
Do 30 sekund w jednym przebiegu. Mój 30-sekundowy klip był jednym ujęciem bez cięcia i generował się 13,5 minuty.
Czy Wan 3.0 zrobi film z PDF?
Tak - w moim teście zrobił 15-sekundowy film z lektorem z hasła Wikipedii w PDF. Adres musi kończyć się rozszerzeniem pliku. Z adresów stron internetowych nie udało mi się uzyskać filmu.
Źródła i data sprawdzenia
Data ogłoszenia, długość, rozdzielczości, obsługiwane dokumenty, limity plików, stawki i uwaga o tekście w kadrze - z ogłoszenia na blogu Alibaba Cloud. Stawki Wan 3.0 Prime i parametry wywołania - z dokumentacji modelu na fal.ai. Ranking tekst na wideo - z danych Artificial Analysis pobieranych przez Megaherc. Wszystko odczytane 24 września 2026. Wszystkie klipy wygenerowałem sam 24 września 2026 przez fal.ai w 720p, z włączonym dźwiękiem, po jednej udanej próbie na test. Transkrypcje z Whisper (model small). Obrazy w tekście to klatki z tych klipów bez retuszu; cięcia w klipach sprawdziłem filtrem scdet w ffmpeg i ręcznie, klatka po klatce. Przeliczenia na złote po kursie 3,78 zł.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Czy Wan 3.0 obsługuje język polski w dialogach i napisach?
Tak, Wan 3.0 poprawnie generuje polski dialog i duże napisy. Rozpoznawanie mowy Whisper potwierdziło zgodność kwestii dialogowych z poleceniem z pewnością 99%, a neon ŻÓŁTA GĘŚ wyświetlił wszystkie ogonki poprawnie. Drobny tekst, jak napisy na kartkach, jest jednak zniekształcony już przy literach wysokości kilkunastu pikseli.
Ile kosztuje generowanie wideo w Wan 3.0?
Cena wynosi 0,05 USD za sekundę w 480p, 0,10 USD w 720p i 0,20 USD w 1080p. Klip 30-sekundowy w 1080p kosztuje 6 USD, co odpowiada około 22,70 zł po kursie 3,78 zł. Te same stawki obowiązują na fal.ai, przez które przeprowadzono testy.
Czy Wan 3.0 potrafi zrobić film z pliku PDF?
Tak, funkcja działa przy wgraniu pliku bezpośrednio - w teście powstał 15-sekundowy film z lektorem na podstawie hasła o żubrze z polskiej Wikipedii w formacie PDF. Adres URL musi kończyć się rozszerzeniem pliku, a adresy zwykłych stron internetowych w obu próbach nie zadziałały. Generowanie 15-sekundowego klipu z PDF zajęło 10 minut 27 sekund i kosztowało 1,50 USD.
Jak długo trwa generowanie wideo w Wan 3.0?
Czas generowania wynosi od 3 do ponad 13 minut w zależności od długości klipu. Średnio model potrzebuje około 25 sekund na każdą sekundę gotowego wideo. Najdłużej trwało wygenerowanie 30-sekundowego ujęcia - 13 minut 35 sekund, przy czym pierwsza próba zakończyła się fałszywym alarmem filtra treści i wymagała ponowienia.
Podobne tematy na Promptowym