

ArtykułyLokalne AIPrzed testem
128 GB w laptopie:cztery RTX 4090, nie pięć
ASUS ProArt P16 z Nvidia RTX Spark ma na pudełku więcej pamięci niż pięć moich kart graficznych. Według dokumentacji Nvidii model AI dostanie z niej 102,4-112 GB. Liczę, zanim przyjedzie egzemplarz do testów.
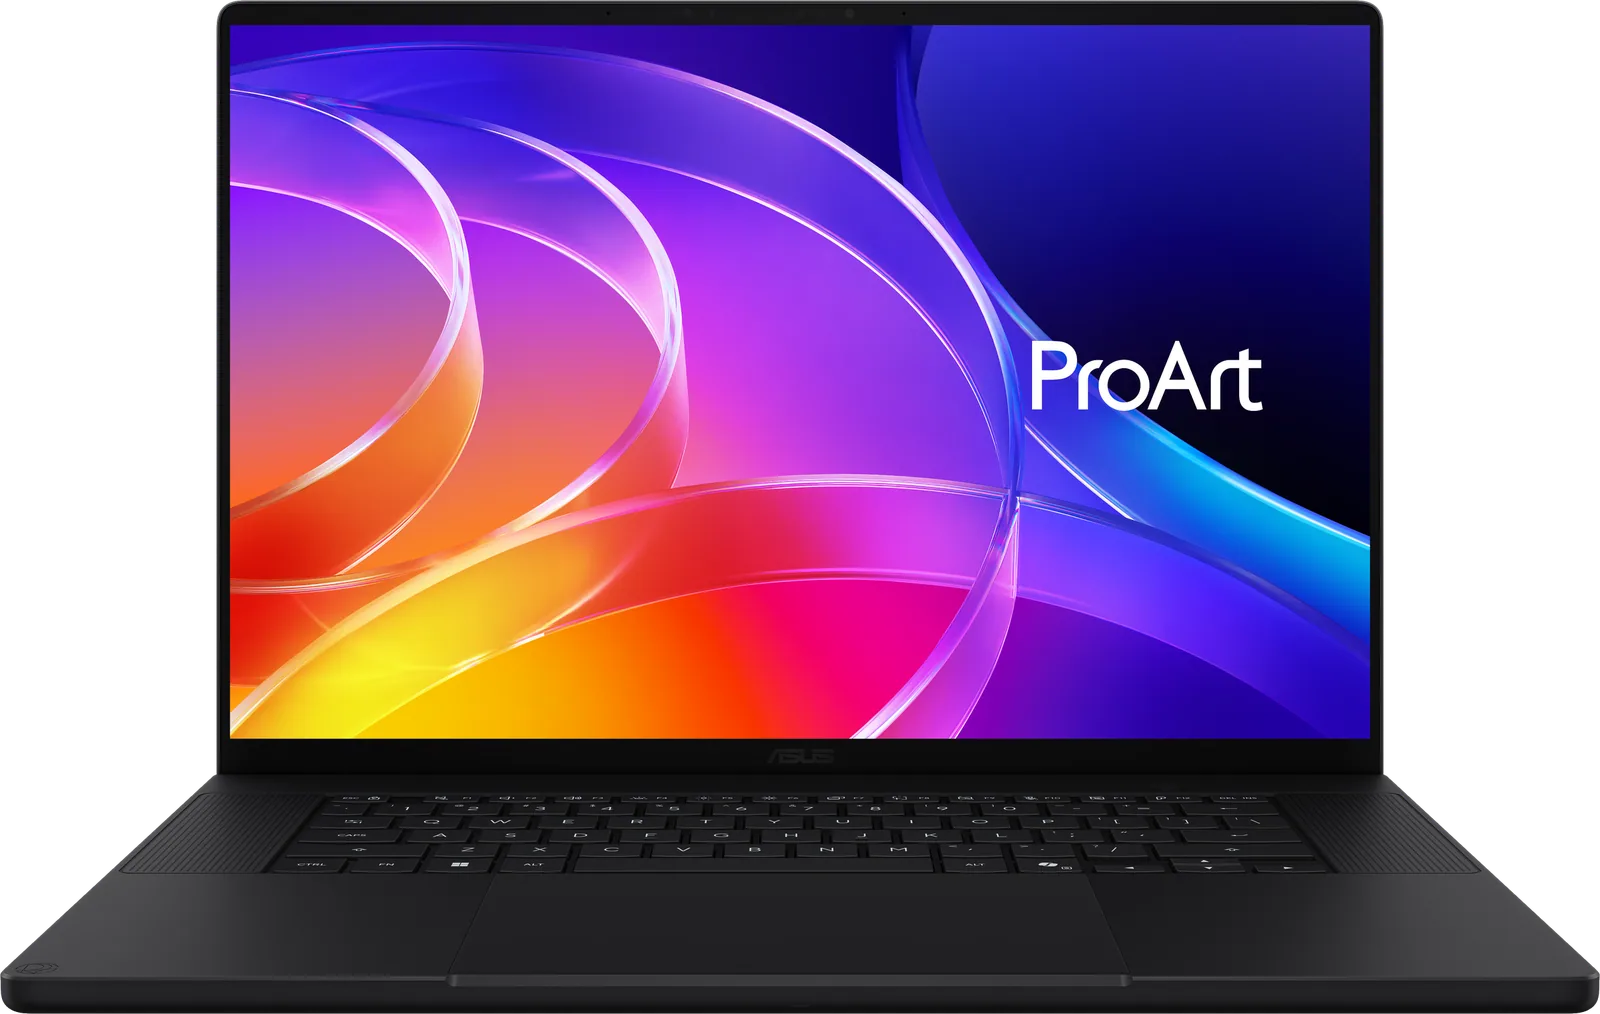
ASUS ProArt P16 z układem Nvidia RTX Spark ma 128 GB pamięci wspólnej dla procesora i grafiki. Moja karta RTX 4090 ma 24 GB. Zanim egzemplarz testowy do mnie dojedzie, policzyłem, ile z tej pamięci naprawdę dostanie model AI, co się w niej zmieści, ile kosztuje gigabajt i czego z tabelek nie da się wyczytać.
To nie jest recenzja ani test. ASUS Polska zaproponował mi egzemplarz do testów, ale sprzęt jeszcze nie dotarł. Wszystko poniżej to rachunek na danych Nvidii, ASUS-a, Apple, sklepów i na moich pomiarach z RTX 4090. Stan na 14 listopada 2026 roku.
RTX 4090 · 24 GB
Ściana na 24 gigabajtach
Najdroższą lekcję o pamięci dostałem przy modelu wideo Kandinsky 6.0 Pro. Jego plik w wersji ośmiobitowej waży 30,5 GB, a moja karta RTX 4090 ma 24 GB. Model załadował do karty 21,4 GB, a resztę, około 29 GB, trzymał w zwykłej pamięci komputera. Pięciosekundowy klip liczył się od 6 minut 18 sekund do 6 minut 52 sekund. Lżejsza wersja Lite, która mieści się w karcie cała, robiła taki sam klip w czasie od 1:51 do 2:28.
Przy modelach językowych widać to jeszcze ostrzej. Qwen 3.8 27B w wersji czterobitowej zajmuje u mnie 15,6 GB i pisze 47,4 tokena na sekundę. Kiedy w październiku sztucznie ograniczyłem mu miejsce w karcie tak, jakby miała 12 GB, zwolnił do 6,9 tokena. Przy 8 GB do 4,4. Ten sam model, ten sam komputer, prawie siedem razy wolniej, bo część warstw wypadła poza pamięć grafiki i liczył je procesor.
Dlatego w lokalnym AI jedna liczba waży więcej niż wszystkie pozostałe: ile pamięci widzi układ graficzny. W komputerze stacjonarnym to VRAM, pamięć przylutowana do karty. RTX 4090 ma jej 24 GB, RTX 5090 ma 32 GB. Model, który się w niej mieści, działa szybko. Model, który się nie mieści, działa tak, jak opisałem wyżej, albo wcale.
W piątek dostałem propozycję od polskiego oddziału ASUS-a: egzemplarz laptopa ProArt P16 do testów. To wersja z układem Nvidia RTX Spark i 128 GB pamięci, z której korzystają jednocześnie procesor i grafika. Na papierze to ponad pięć moich kart w obudowie, która według producenta waży 1,77 kg.
Sprzęt jeszcze nie dojechał, więc niczego nie zmierzyłem. Mogłem za to zrobić coś, czego nie robi się w zapowiedziach: usiąść nad specyfikacją, dokumentacją dla programistów i cennikami, a potem policzyć, co z tych 128 GB wynika dla kogoś, kto modele uruchamia u siebie. Wynik jest mniej efektowny niż hasło z pudełka i moim zdaniem ciekawszy.
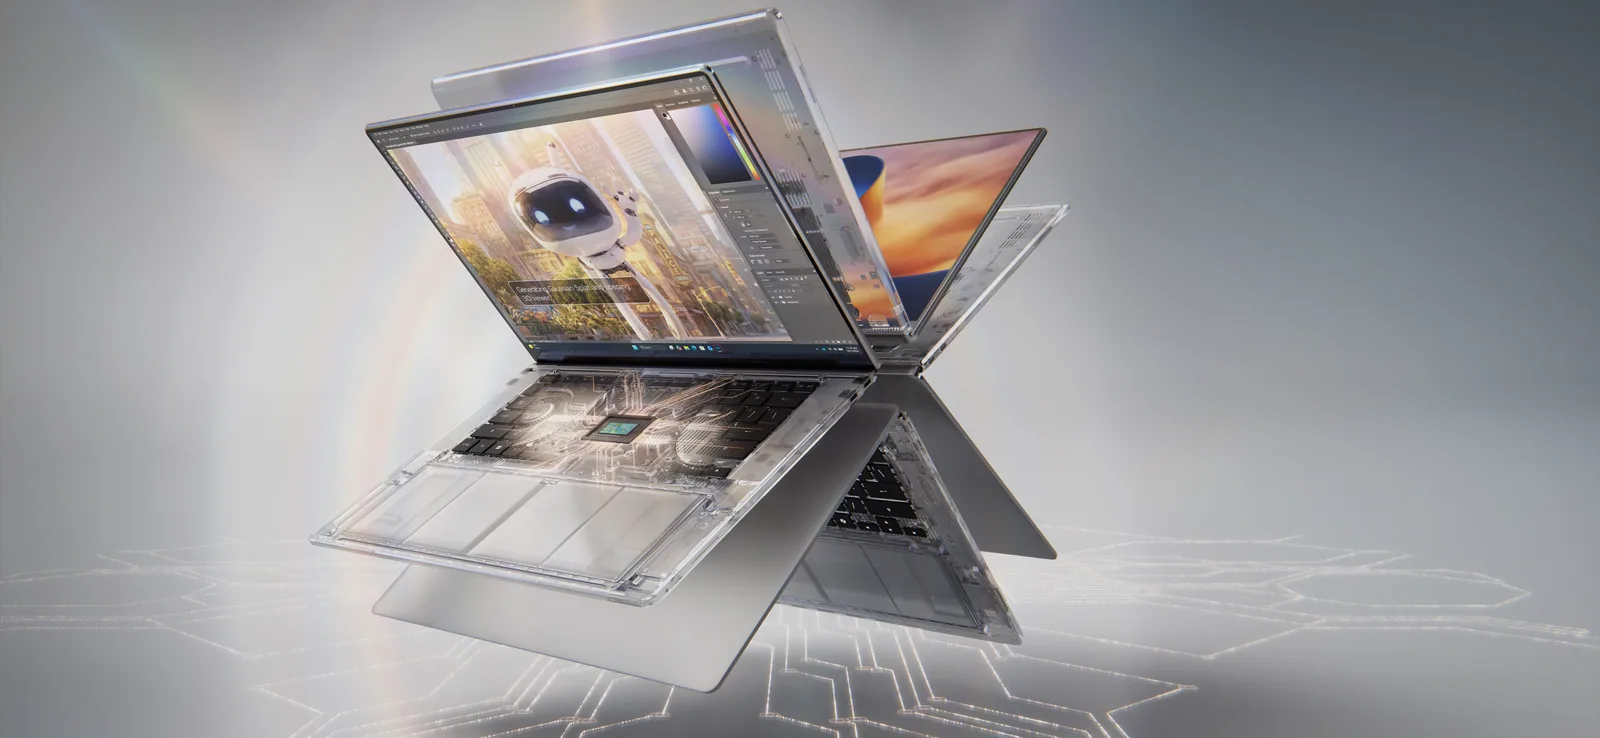
Nvidia RTX Spark
Jedna pula zamiast dwóch
RTX Spark to układ, który Nvidia pokazała na targach Computex na przełomie maja i czerwca 2026 roku, a laptopy z nim trafiły do sprzedaży 16 października. W jednym kawałku krzemu siedzą procesor Grace z 20 rdzeniami w architekturze Arm i grafika Blackwell RTX z 6144 rdzeniami CUDA. Nvidia nazywa to superchipem i sprzedaje pod hasłem jednego petaflopa mocy obliczeniowej dla AI.
Najważniejsze jest jednak to, czego w tym układzie nie ma: osobnej pamięci dla grafiki. Jest jedna pula LPDDR5X, w najwyższej wersji 128 GB, z której biorą i procesor, i grafika. Model językowy nie musi się mieścić w wydzielonych 24 czy 32 gigabajtach karty. Sięga do tej samej pamięci, w której siedzi system, przeglądarka i otwarty projekt wideo.
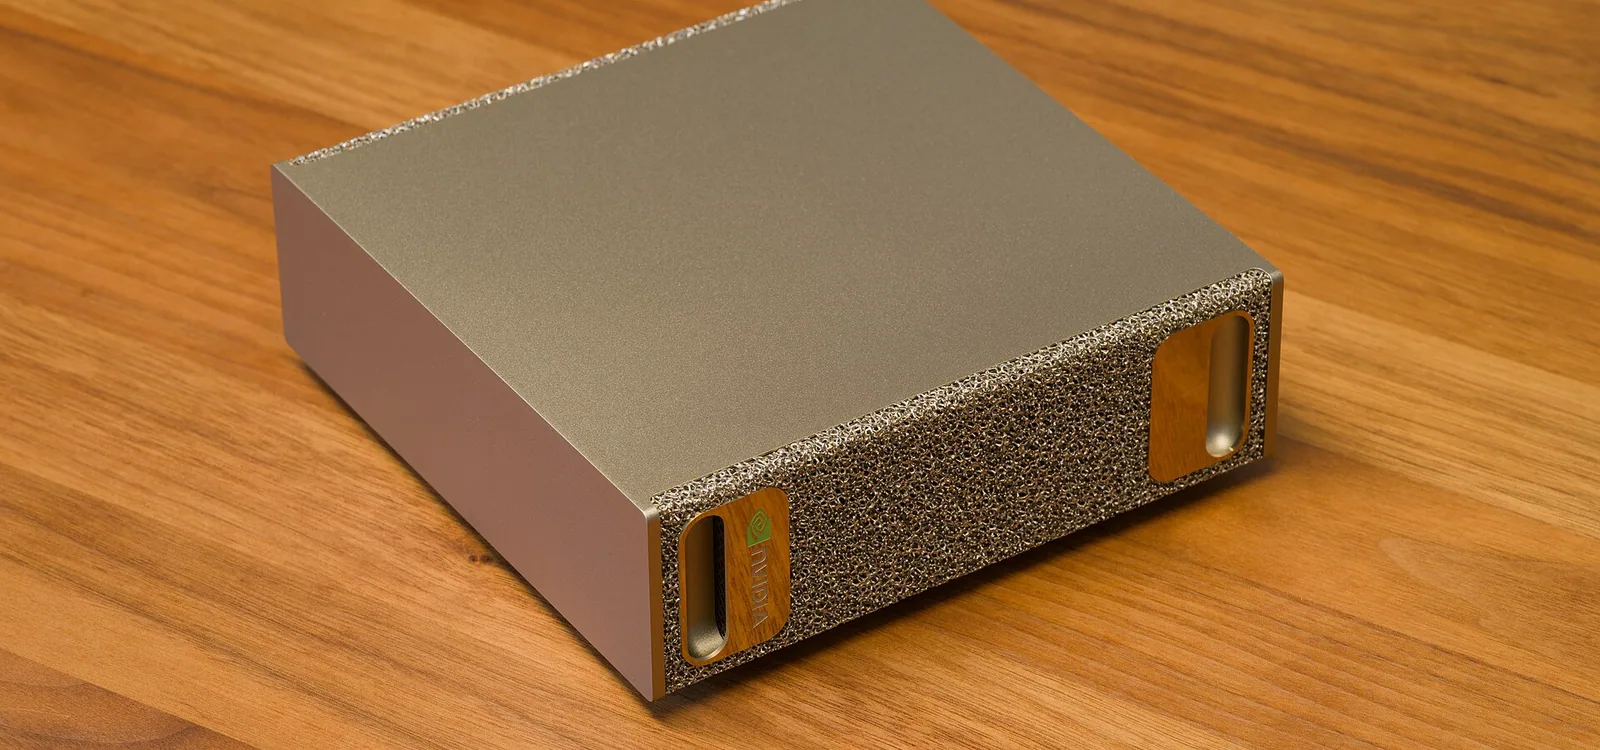
Sam pomysł nie jest nowy. Apple robi tak w swoich komputerach od 2020 roku, a Nvidia od zeszłego roku sprzedaje małe biurkowe pudełko DGX Spark z taką samą pulą 128 GB. Nowe jest połączenie trzech rzeczy naraz: taka pamięć, laptop i Windows z CUDA, czyli z oprogramowaniem, pod które pisze się większość narzędzi do lokalnego AI. Na Macu CUDA nie ma, więc narzędzia pisane pod karty Nvidii trzeba tam uruchamiać innymi drogami.
ASUS wkłada RTX Spark do dwóch laptopów, ProArt P14 i ProArt P16. Większy ma 16-calowy ekran OLED o rozdzielczości 3840 x 2400, akumulator 99,9 Wh i zasilacz USB-C o mocy 140 W. Pamięć jest wlutowana, więc wybiera się ją raz, przy zakupie: 24, 32, 48, 64 albo 128 GB. Wersja podstawowa ma więc dokładnie tyle pamięci, ile moja karta graficzna, tylko że musi się nią podzielić z całym systemem.
Co do możliwości, Nvidia na stronie produktu mieści się w jednym zdaniu: modele do 120 miliardów parametrów z kontekstem miliona tokenów. To deklaracja producenta, bez opisanych warunków pomiaru, bez nazwy modelu i bez prędkości. Takie zdania sprawdza się liczeniem, a potem testem. Na razie mam do dyspozycji to pierwsze.
„Komputery ProArt z RTX Spark mają dość pamięci, żeby duże przepływy obrazu i wideo uruchamiać lokalnie”.
„ProArt RTX Spark PCs have the memory to run big image and video workflows locally”
Dokumentacja Nvidii
Drobny druk: ile z 128 GB dostaje grafika
Zacząłem od pytania, którego nie zadaje żadna reklama: ile z tych 128 GB może zająć model? Odpowiedź znalazłem w przewodniku Nvidii dla programistów, którzy przenoszą aplikacje na RTX Spark. Jest tam wzór.
Pamięć laptopa dzieli się na trzy części. Pierwsza jest wydzielona na stałe dla grafiki i Windows pokazuje ją jako dedykowaną pamięć karty. Druga to pamięć wspólna, po którą może sięgnąć i procesor, i grafika. Trzecia jest tylko dla procesora i grafika jej nie dostanie. Rozmiar części wspólnej Nvidia opisuje tak: od pamięci pozostałej po wydzieleniu odejmuje się 16 GB, a wynik nie może być mniejszy niż połowa i większy niż 80 procent tej pozostałej pamięci.
Rozmiaru części wydzielonej dokumentacja nie podaje, więc policzyłem oba skraje. Jeśli w laptopie ze 128 GB nie ma jej wcale, obowiązuje limit 80 procent i grafika może zająć najwyżej 102,4 GB. Jeśli część wydzielona jest duża, 48 GB albo więcej, działa odejmowanie 16 GB i grafika dostaje 112 GB. Prawda leży gdzieś pomiędzy. W każdym wariancie co najmniej 16 GB zostaje poza zasięgiem modelu.
Na pudełku 128 GB. Dla modelu AI, według wzoru samej Nvidii, od 102,4 do 112 GB.
To nie jest zarzut. Windows, przeglądarka i edytor też muszą gdzieś mieszkać, a na moim komputerze stacjonarnym mieszkają w osobnych 64 GB pamięci, których do karty nie doliczam. Ale to zmienia rachunek. Pięć kart RTX 4090 to 120 GB pamięci tylko dla modeli. Laptop ma dla modeli równowartość od 4,3 do 4,7 takiej karty. Robocze hasło tego tekstu brzmiało „laptop, który ma więcej pamięci na AI niż pięć RTX 4090”. Liczby go nie obroniły, więc go zmieniłem.
W tym samym przewodniku jest druga ważna liczba. Pamięć RTX Spark ma szynę o szerokości 256 bitów i przepustowość 300 GB/s. Wrócę do niej niżej, bo to ona zdecyduje o prędkości.
Rachunek
Co się zmieści
Metoda jest prosta i każdy może ją powtórzyć. Wziąłem dziesięć otwartych modeli, od polskiego Bielika z 11 miliardami parametrów po Qwen3 z 235 miliardami, i spisałem z Hugging Face rozmiary ich plików GGUF. Tam, gdzie były dostępne, w trzech wersjach: czterobitowej, ośmiobitowej i pełnej, szesnastobitowej. Razem 21 plików.
Te wersje to kwantyzacja, czyli zaokrąglenie wag modelu do mniejszej liczby bitów. To najtańszy sposób, żeby duży model zmieścić w małej pamięci, i płaci się za niego jakością: im mniej bitów, tym częstsze pomyłki. Na karcie 24 GB kwantyzacja jest koniecznością. W pamięci ponad 100 GB staje się wyborem. Więcej o samym formacie napisałem w tekście o plikach GGUF.
Do rozmiaru pliku doliczam 20 procent na kontekst rozmowy i bufory. To moje założenie, ostrożniejsze niż to, co zmierzyłem: Gemma 4 31B ma plik 17,65 GB, a po załadowaniu z kontekstem 4096 tokenów zajmuje u mnie 19,2 GB, czyli o 9 procent więcej. Przy długim kontekście narzut rośnie, stąd zapas. Jeśli plik wchodzi do pamięci, ale bez tych 20 procent, oznaczam go jako „na styk”.
102GB
18z 21 wersji mieści się z zapasemnajwiększa: Llama 3.3 70B Q8_0 (74,98 GB)
mieści się z zapasem 20%na styknie mieści sięoś ściśnięta przy dużych wartościach
Rozmiary plików: Hugging Face, odczyt 14.11.2026 (lista repozytoriów w źródłach). Zapas 20% to moje założenie. Dla laptopa 102-112 GB wynika ze wzoru w dokumentacji Nvidii, nie z pomiaru.
W 24 GB mojej karty z zapasem mieści się 7 z 21 plików, a 2 kolejne wchodzą na styk. Największy model, który działa u mnie swobodnie, to Gemma 4 31B w czterech bitach. W laptopie, nawet przy ostrożnej granicy 102,4 GB, mieści się 18 z 21. Nie wchodzą tylko trzy: Llama 3.3 70B w pełnej precyzji i obie wersje Qwen3 235B.
Ciekawsze od liczby jest to, co stoi za tą różnicą. W laptopie mieści się GPT-OSS 120B, którego plik waży 63,39 GB, i zostaje jeszcze 39 GB wolnego. Mieści się Mistral Large ze 123 miliardami parametrów w czterech bitach, 73,22 GB. Mieści się Llama 3.3 70B w ośmiu bitach, 74,98 GB. I mieści się Gemma 4 31B bez żadnej kwantyzacji, 62,36 GB, czyli ten sam model, który u mnie działa tylko po ścięciu do czterech bitów.
Deklarację Nvidii o 120 miliardach parametrów mój rachunek więc potwierdza, i to z zapasem. Miliona tokenów kontekstu na papierze sprawdzić nie umiem, bo zużycie pamięci na kontekst zależy od budowy konkretnego modelu. To będzie jeden z pierwszych testów.
Na liście jest też ciekawostka. Nvidia sama wypuściła model Nemotron 3.5 Bolt o 74 miliardach parametrów ściśnięty do pliku 22,02 GB, z dopiskiem „24GB” w nazwie. Czyli firma, która sprzedaje laptop ze 128 GB, równolegle dba o to, żeby duży model wszedł na kartę taką jak moja. Według mojej reguły wchodzi na styk.
Najedź albo dotknij kółka
Linie: liczba parametrów x bity / 8. Kółka: rozmiary plików GGUF z Hugging Face, odczyt 14.11.2026. Dwie wersje modelu Qwen3 235B o rozmiarze ponad 160 GB są poza skalą. Opracowanie promptowy.com.
Na wykresie widać, co naprawdę zmienia taka pamięć. Małe modele nie zyskują nic, bo i tak mieszczą się wszędzie. Zmienia się klasa 70-120 miliardów parametrów, która na pojedynczej karcie dla graczy w ogóle się nie uruchamia, oraz możliwość puszczenia modeli klasy 30 miliardów bez kwantyzacji.
Jest jeszcze trzecia rzecz, mniej efektowna, a w codziennej pracy może najważniejsza: kilka modeli naraz. Model językowy, model do obrazów i model do mowy trzymane w pamięci jednocześnie, bez wyładowywania jednego, żeby zrobić miejsce drugiemu. U mnie to dziś codzienna żonglerka i każda zmiana narzędzia kosztuje kilkadziesiąt sekund ładowania.
ASUS ProArt P16 (H7607) · dane producenta
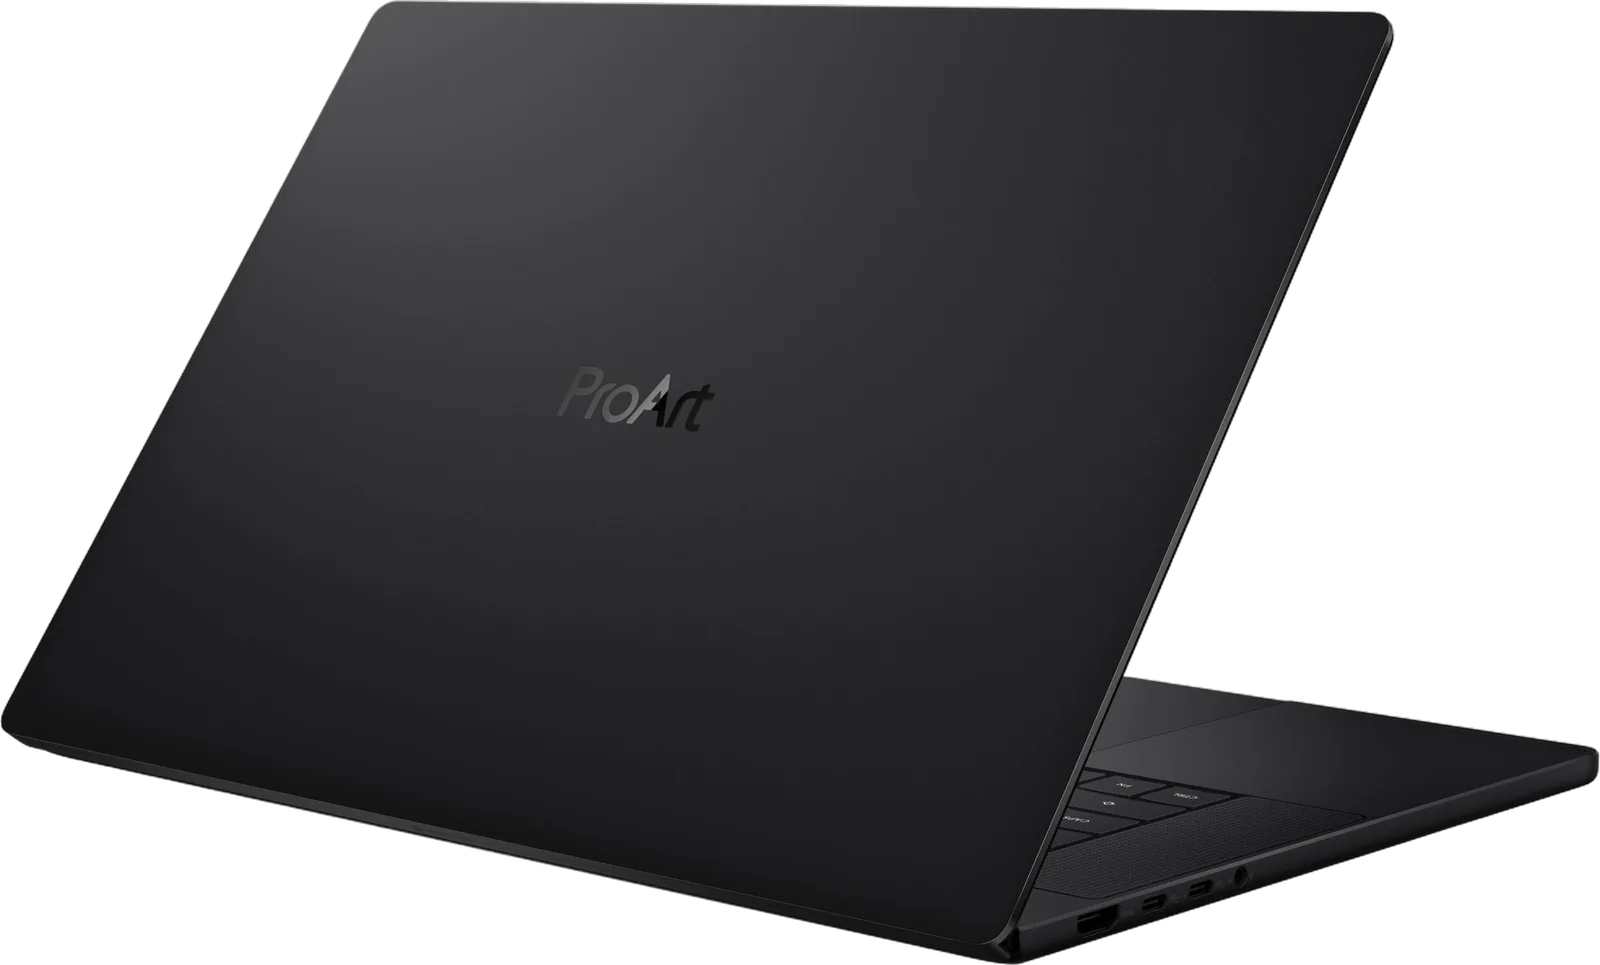
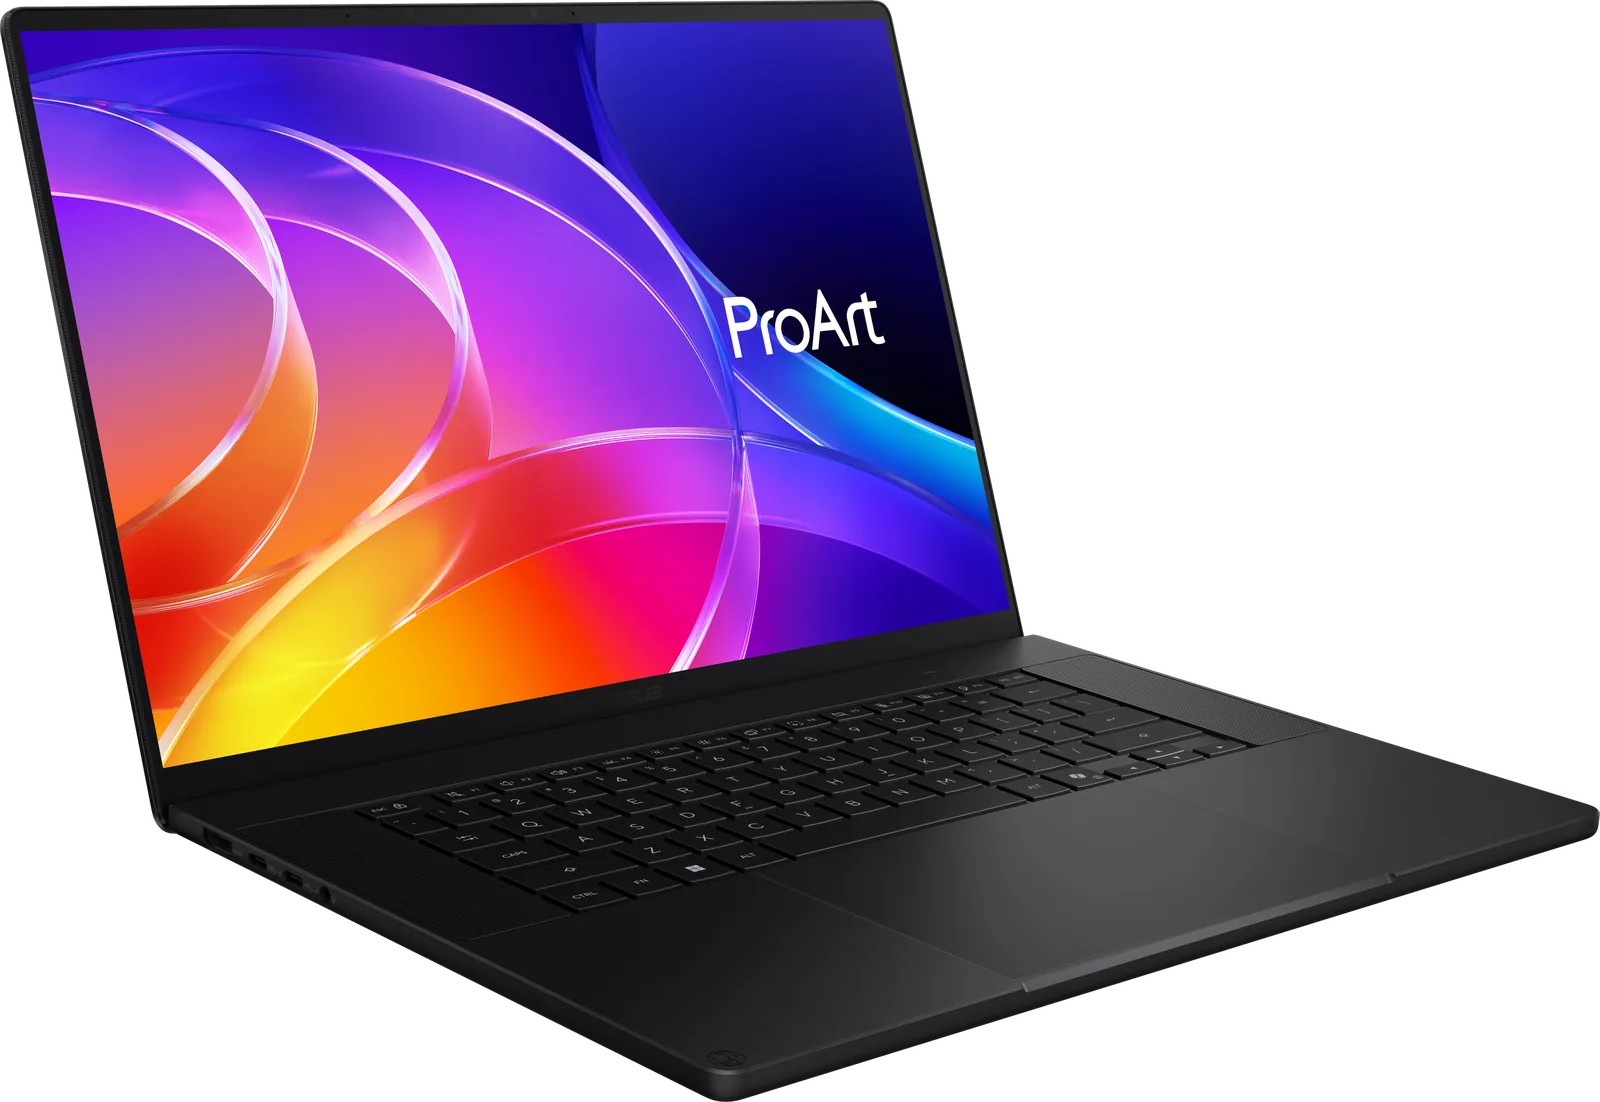
- 1,77 kg12,9 mm grubości według producenta
- 128 GBLPDDR5X wlutowana, wspólna dla procesora i grafiki
- 99,9 Whakumulator, zasilacz USB-C 140 W
- 16 cali, 4KOLED 3840 x 2400, 120 Hz, do 1600 nitów w HDR
Skala
Cztery karty, nie pięć
Żeby poczuć skalę, przeliczyłem pamięć laptopa na sprzęt, który znam. Cztery karty RTX 4090 to 96 GB. Laptop ma dla modelu od 102,4 do 112 GB, czyli cztery karty i od ćwierci do dwóch trzecich piątej.
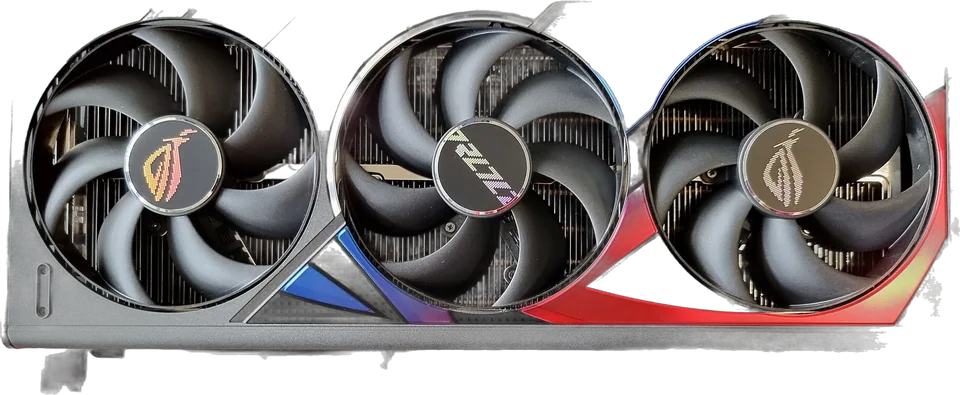 24 GBkarta 148 GBkarta 272 GBkarta 396 GBkarta 4+6,4-16GB
| 4 x RTX 4090 | ProArt P16 | |
|---|---|---|
| Pamięć dla modelu | 96 GB | 102,4-112 GB |
| Przepustowość pamięci | 1008 GB/s | 300 GB/s |
| Moc | 1800 W | 45-80 W |
| Cena | 6 396 USD | 6 999,99 USD |
| Waga | nie mierzyłem | 1,77 kg |
Cztery karty RTX 4090 kosztowały w dniu premiery 6 396 dolarów i same biorą do 1800 W, zanim doliczę płytę główną, procesor, zasilacze i obudowę, w której to wszystko się zmieści. Układ RTX Spark w laptopie ma według Nvidii moc od 45 do 80 W. Takiego zestawienia nie da się zignorować, nawet jeśli porównuję sprzęt z 2022 roku ze sprzętem z 2026.
Tu kończy się jednak to, co działa na korzyść laptopa. Cztery karty to także cztery osobne układy graficzne, każdy z własną, bardzo szybką pamięcią. Laptop ma jeden układ i jedną pamięć, wolniejszą.
RTX Spark: dokumentacja Nvidii dla programistów. DGX Spark: specyfikacja Nvidii. M5 Max z 40-rdzeniową grafiką: specyfikacja Apple. RTX 4090: szyna 384 bity według Nvidii, wartość z mojego zestawienia kart do AI.
Pamięć mojej karty przerzuca 1008 GB/s. Pamięć RTX Spark 300 GB/s, czyli ponad trzy razy mniej. Przy generowaniu tekstu model przy każdym tokenie musi przeczytać z pamięci swoje wagi, więc jej przepustowość wprost ogranicza liczbę tokenów na sekundę. Spodziewam się, że wszystko, co mieści się w 24 GB, na mojej karcie będzie działać szybciej niż na laptopie. Przewaga laptopa zaczyna się tam, gdzie moja karta w ogóle odpada, a wtedy uczciwym punktem odniesienia jest moje 6,9 tokena na sekundę z modelu rozlanego na procesor.
Warto też spojrzeć na Maca, bo w tej tabeli wypada lepiej, niż się spodziewałem. MacBook Pro z układem M5 Max i 40-rdzeniową grafiką ma według Apple 614 GB/s, dwa razy więcej niż RTX Spark. Nie ma za to CUDA.
Pojemność odpowiada na pytanie, czy model się uruchomi. Na pytanie, jak szybko będzie pisał, odpowie dopiero test.
Ceny · 14.11.2026
Ile kosztuje gigabajt
W amerykańskim sklepie ASUS-a wersja ze 128 GB pamięci, dyskiem 2 TB i ekranem 4K kosztuje 6 999,99 dolara. To 54,69 dolara za gigabajt. Wersja z 64 GB i dyskiem 1 TB kosztuje 4 399,99 dolara, czyli 68,75 za gigabajt, więc większa pamięć wychodzi tu taniej w przeliczeniu. Najtańszy ProArt P16 z RTX Spark zaczyna się od 2 799,99 dolara, ale ma 24 GB.
Dla porównania: karta RTX 5090 z 32 GB pamięci miała cenę startową 1 999 dolarów, czyli 62,47 dolara za gigabajt. RTX 4090 w dniu premiery kosztowała 1 599 dolarów, 66,63 za gigabajt. To ceny samych kart, bez komputera, i ceny startowe Nvidii, nie dzisiejsze ceny w sklepach.
Na pierwszy rzut oka laptop wygrywa. Ale wcześniej ustaliłem, że grafika nie dostanie całych 128 GB. Jeśli podzielę cenę przez pamięć, którą naprawdę zobaczy model, wychodzi od 62,50 do 68,36 dolara za gigabajt. To tyle samo, co w kartach graficznych. Różnica jest taka, że w cenie laptopa dostaję do tej pamięci cały komputer z ekranem i akumulatorem, a do kart muszę go dopiero zbudować.
USD: sklep ASUS w USA, sklep Apple w USA, komunikaty Nvidii o cenach startowych kart (2022, 2025), bez podatku od sprzedaży. Polska: Komputronik i sklep Apple, ceny z VAT. Odczyt 14.11.2026. Dla Maca nie wiem, ile pamięci system oddaje grafice, więc liczę tylko nominalnie. Cen kart graficznych w polskich sklepach nie udało mi się wiarygodnie odczytać.
Najciekawiej wypada porównanie z Apple. MacBook Pro 16 z układem M5 Max, 128 GB pamięci i dyskiem 2 TB kosztuje w amerykańskim sklepie Apple 6 999 dolarów. Różnica wobec ASUS-a wynosi 99 centów. Trudno o wyraźniejszy sygnał, w kogo ASUS i Nvidia celują tym laptopem.
W Polsce jest inaczej. ProArt P16 w wersji H7607BA-SE041X, ze 128 GB i dyskiem 2 TB, kosztował 14 listopada w Komputroniku 27 999 zł. MacBook Pro 16 z taką samą pamięcią i dyskiem w polskim sklepie Apple kosztuje 35 999 zł i nie ma w pudełku zasilacza. To 8 000 zł różnicy. Gigabajt w ASUS-ie kosztuje u nas 218,74 zł, w Macu 281,24 zł. Ceny pozostałych laptopów z tym układem są w osobnym zestawieniu: laptopy z RTX Spark, modele i ceny.
Czy 27 999 zł za laptopa to dużo? Bardzo dużo. Porównuję go jednak nie z laptopem do pisania, tylko z dwiema innymi drogami do uruchomienia modelu ze 120 miliardami parametrów u siebie: stacją z kilkoma kartami graficznymi albo Makiem. Na tym tle cena za gigabajt jest podobna do kart, a w Polsce wyraźnie niższa niż u Apple.
Jest też droga czwarta, o której trzeba pamiętać, zanim ktokolwiek wyda takie pieniądze: wynajęcie modelu przez API. Nie wymaga żadnego sprzętu i przy sporadycznym użyciu kosztuje ułamek tej kwoty. Własna pamięć ma sens wtedy, gdy danych nie wolno wysłać na zewnątrz, gdy pracuje się bez sieci albo gdy model chodzi przez wiele godzin dziennie. Liczyłem to osobno w tekście o tym, kiedy lokalny model się opłaca.
Przed testem
Czego nie wiem
Wszystko powyżej to arytmetyka na cudzych tabelkach i moich pomiarach z innego sprzętu. Poniżej lista rzeczy, których z tabelek wyczytać się nie da.
- Ile tokenów na sekundę. Ani Nvidia, ani ASUS nie podają prędkości generowania tekstu dla konkretnego modelu. Mam własne wyniki z RTX 4090: 99 tokenów na sekundę dla Gemmy 4 12B, 47 dla Qwen 3.8 27B, 41-43 dla Gemmy 4 31B. Te same pliki uruchomię na laptopie.
- Ile pamięci naprawdę dostaje grafika. Mój przedział 102,4-112 GB wynika ze wzoru w dokumentacji. Rozmiaru części wydzielonej w tym konkretnym laptopie nie znam i nie wiem, czy da się go zmienić w ustawieniach.
- Zgodność programów. Procesor ma architekturę Arm, więc część programów pisanych pod zwykłe pecety działa przez emulację. Nvidia deklaruje zgodność z 97 procentami z 15 tysięcy najpopularniejszych pakietów Pythona. Pozostałe 3 procent potrafi zepsuć dzień, więc sprawdzę swój zestaw: llama.cpp, Ollamę, ComfyUI z moimi węzłami i Hangar.
- Temperatura i hałas. Do 80 W w obudowie o grubości 12,9 mm trzeba jakoś schłodzić. Jak głośno i jak ciepło robi się przy godzinnym generowaniu wideo, wie tylko ten, kto to zmierzył.
- Praca na baterii. Akumulator ma 99,9 Wh. Ile wytrzyma z modelem liczącym bez przerwy i czy prędkość spada po odłączeniu zasilacza, producent nie podaje.
- Obraz i wideo. Mój rachunek dotyczy modeli językowych. Modele wideo, takie jak Kandinsky 6.0 Pro, który u mnie wylewał się poza kartę, mają inne potrzeby i inaczej korzystają z pamięci. To osobny test.
- Długi kontekst. Milion tokenów z deklaracji Nvidii to dla mnie na razie hasło. Sprawdzę, ile tokenów da się załadować do konkretnego modelu, zanim skończy się pamięć, i jak wtedy spada prędkość.
Mam jedną wskazówkę, ale nie traktuję jej jak wyniku. DGX Spark, biurkowy krewny tego laptopa, ma w specyfikacji Nvidii tę samą liczbę rdzeni procesora, tę samą pulę 128 GB i przepustowość pamięci 273 GB/s. To podobna klasa sprzętu, tyle że w innej obudowie, z innym chłodzeniem i innym systemem. Jego wyników nie przepisuję.
Plan
Co zrobię, gdy przyjedzie
Egzemplarz jest w drodze. Plan mam gotowy, bo to te same skrypty, którymi od września mierzę RTX 4090, więc wyniki da się zestawić jeden do jednego, na tych samych plikach i tych samych pytaniach.
- Te same modele co na karcie. Gemma 4 12B, GPT-OSS 20B, Bielik 11B, Qwen 3.8 27B i Gemma 4 31B. Tokeny na sekundę, czas do pierwszego tokena, zajęta pamięć.
- Modele, których u mnie nie da się uruchomić. GPT-OSS 120B, Llama 3.3 70B w ośmiu bitach, Gemma 4 31B w pełnej precyzji. Tu sprawdzę, czy mój rachunek z suwaka zgadza się z rzeczywistością.
- Granica pamięci. Ile gigabajtów model może zająć, zanim system odmówi, czyli która liczba z przedziału 102,4-112 GB jest prawdziwa.
- Długi kontekst. Rosnąca liczba tokenów na wejściu aż do granicy pamięci, z pomiarem prędkości na każdym kroku.
- Obrazy i wideo w ComfyUI. Te same przepływy co na karcie, z czasem na obraz i na klip, w tym Kandinsky 6.0 Pro, który u mnie nie mieści się w 24 GB.
- Kilka modeli naraz. Język, obraz i mowa trzymane w pamięci jednocześnie.
- Gniazdko, obudowa, bateria. Pobór mocy pod obciążeniem, temperatura, hałas i czas pracy bez zasilacza.
- Polski. Zestaw zadań, na którym oceniałem Bielika.
Wyniki opublikuję obok liczb z RTX 4090, razem z listą rzeczy, które nie zadziałały. Jeśli laptop okaże się wolny, napiszę, że jest wolny. Jeśli wzór z dokumentacji nie zgodzi się z tym, co pokaże system, poprawię ten tekst i zaznaczę, co zmieniłem. Wszystkie teksty o tej platformie zbieram na stronie Nvidia RTX Spark. Dotychczasowe pomiary z mojej karty są w przewodniku Lokalne AI i w zestawieniu kart graficznych do AI.
Krótko
Najczęstsze pytania
Ile pamięci ma ASUS ProArt P16 z Nvidia RTX Spark?
Od 24 do 128 GB wspólnej pamięci LPDDR5X, wlutowanej na stałe. Dostępne wersje: 24, 32, 48, 64 i 128 GB.
Ile z 128 GB może zająć model AI?
Według wzoru z dokumentacji Nvidii od 102,4 do 112 GB, zależnie od rozmiaru części wydzielonej dla grafiki. Co najmniej 16 GB zostaje tylko dla procesora. To wyliczenie, nie pomiar.
Jaki model zmieści się w takim laptopie?
Z mojej listy 21 plików mieści się 18, w tym GPT-OSS 120B (63,39 GB) i Llama 3.3 70B w ośmiu bitach (74,98 GB). W karcie RTX 4090 z zapasem mieści się 7.
Ile kosztuje wersja 128 GB?
6 999,99 USD w sklepie ASUS w USA i 27 999 zł w Komputroniku. Odczyt z 14 listopada 2026 roku.
Czy ten laptop jest szybszy niż RTX 4090?
Nie wiem. Ma ponad cztery razy więcej pamięci dla modelu, ale pamięć o przepustowości 300 GB/s wobec 1008 GB/s w karcie. Sprawdzę to w teście.
Czy to recenzja?
Nie. Sprzętu jeszcze nie mam. Tekst opiera się na danych producentów, cenach ze sklepów i moich pomiarach z RTX 4090.
Źródła
- Nvidia: strona produktu RTX Spark (specyfikacja, deklaracja o 120 mld parametrów)
- Nvidia: komunikat o dostępności laptopów RTX Spark, 16.10.2026
- Nvidia: przewodnik dla programistów RTX Spark, podział pamięci
- Nvidia: przewodnik dla programistów RTX Spark, opis układu (256 bitów, 300 GB/s)
- Nvidia: zgodność oprogramowania z RTX Spark (pakiety Pythona)
- Nvidia: specyfikacja DGX Spark
- Nvidia: specyfikacja GeForce RTX 4090 (24 GB, 450 W)
- Nvidia: cena startowa RTX 4090, komunikat z 20.09.2022
- Nvidia: cena startowa RTX 5090, komunikat z 6.01.2025
- ASUS: strona ProArt P16 (H7607)
- ASUS: komunikat o sprzedaży w USA, 16.10.2026
- ASUS: komunikat o przedsprzedaży, 8.10.2026
- Sklep ASUS w USA: ProArt P16 128 GB / 2 TB (odczyt 14.11.2026)
- Sklep ASUS w USA: ProArt P16 64 GB / 1 TB (odczyt 14.11.2026)
- Komputronik: ASUS ProArt P16 H7607BA-SE041X (odczyt 14.11.2026)
- Apple: konfigurator MacBooka Pro 16, sklep w USA (odczyt 14.11.2026)
- Apple: konfigurator MacBooka Pro 16, sklep w Polsce (odczyt 14.11.2026)
- Apple: specyfikacja MacBooka Pro (przepustowość pamięci)
- Hugging Face: rozmiary plików GGUF (speakleash/Bielik-11B-v3.1-Instruct-GGUF; google/gemma-4-12B-it-qat-q4_0-gguf, unsloth/gemma-4-12b-it-GGUF; ggml-org/gpt-oss-20b-GGUF; unsloth/Qwen3.8-27B-GGUF; google/gemma-4-31B-it-qat-q4_0-gguf, unsloth/gemma-4-31B-it-GGUF; bartowski/Llama-3.3-70B-Instruct-GGUF; nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF; ggml-org/gpt-oss-120b-GGUF; MaziyarPanahi/Mistral-Large-Instruct-2411-GGUF; unsloth/Qwen3-235B-A22B-Instruct-2507-GGUF)
- Moje pomiary na RTX 4090: karty graficzne do AI
- Moje pomiary na RTX 4090: Kandinsky 6.0
Zdjęcia i grafiki
- ASUS ProArt P16 (H7607), zdjęcie produktowe, widok z przodu. Źródło: ASUS, materiał prasowy ASUS Pressroom
- ASUS ProArt P16 (H7607), zdjęcie produktowe, widok z niskiego kąta. Źródło: ASUS, materiał prasowy ASUS Pressroom
- ASUS ProArt P16 (H7607), zdjęcie produktowe, widok z boku. Źródło: ASUS, materiał prasowy ASUS Pressroom
- ASUS ProArt P16 (H7607), zdjęcie produktowe, widok z tyłu (tło usunięte). Źródło: ASUS, materiał prasowy ASUS Pressroom
- ASUS ProArt P16 i P14 w kolorach Nano Black i Neo White (kadr). Źródło: ASUS, materiał prasowy ASUS Pressroom
- Laptopy z układem Nvidia RTX Spark (kadr). Źródło: Nvidia, materiał prasowy Nvidia Newsroom, komunikat z 16.10.2026
- Karta Asus ROG Strix RTX 4090 (tło usunięte). Autor: Benlisquare, CC BY-SA 4.0, Wikimedia Commons
- Płytka karty GeForce RTX 4090 od spodu (kadr). Autor: Fritzchens Fritz, CC0, Wikimedia Commons
- Układ AD102 z karty GeForce RTX 4090 (kadr). Autor: Fritzchens Fritz, CC0, Wikimedia Commons
- Nvidia DGX Spark (kadr). Autor: Daniel Lu (dllu), CC BY-SA 4.0, Wikimedia Commons
- Wykresy i wyliczenia: promptowy.com.


