


Lokalne AI · Wydanie specjalne · Lokalne AI
Darmowe AI na Twoim komputerze dorosłoProgram napisany w jeden wieczór doczekał się wersji 1.0. Stoi pod prawie wszystkim, czym uruchamia się dziś modele językowe na własnym sprzęcie. Policzyłem, co zmieści zwykły PC, ile to kosztuje i gdzie jest sufit.
README.md · 10 marca 2023
## Description
The main goal is to run the model using 4-bit quantization on a MacBook.
This was hacked in an evening - I have no idea if it works correctly.
$ git tag v1.0.0 # 13 listopada 2026, commit numer 12 476
Wieczorem 10 marca 2023 roku bułgarski programista Georgi Gerganov wrzucił na GitHuba kilka plików w języku C. Największy miał 10 324 linie. Kilka godzin później dopisał krótki opis: celem jest uruchomienie modelu LLaMA od Mety na MacBooku, w czterobitowej kwantyzacji, czyli po mocnym odchudzeniu wag. Zaraz pod spodem dodał zdanie, które rzadko widuje się w dokumentacji: napisałem to w jeden wieczór i nie mam pojęcia, czy działa poprawnie.
Działało. W tamtym czasie model językowy kojarzył się z serwerownią i kartami za dziesiątki tysięcy dolarów, a tu odpowiadał na pytania na laptopie, bez internetu i bez konta u kogokolwiek. 13 listopada 2026 roku, po trzech latach i ośmiu miesiącach, ten sam projekt dostał numer 1.0.0. Po drodze zebrał 12 476 zmian w kodzie, ponad 135 tysięcy gwiazdek na GitHubie i stał się czymś, czego jego autor raczej nie planował tamtego wieczoru: fundamentem, na którym stoi prawie całe lokalne AI.
Wersja 1.0 w oprogramowaniu to nie fajerwerki, tylko deklaracja dorosłości. Dlatego zamiast listy nowości chcę odpowiedzieć na trzy pytania, które zadaje każdy, kto pierwszy raz o tym słyszy. Co się zmieści na moim komputerze? Ile to naprawdę kosztuje, skoro jest darmowe? I czego nie dostanę, choćbym kupił najdroższą kartę w sklepie?
01 · Wersja
Co właściwie znaczy jedynka
Przez trzy lata llama.cpp nie miał wersji w zwykłym sensie. Każda zmiana w kodzie dostawała kolejny numer kompilacji, a wydań tego typu zebrało się ponad osiem tysięcy. Dla hobbysty to bez znaczenia. Dla kogoś, kto buduje na tym program, to kłopot: funkcja, z której korzystasz dziś, jutro może zniknąć.
Jedynka to zmienia. Zespół zobowiązał się, że każda zmiana, która psuje zgodność z programami zbudowanymi na bibliotece, będzie oznaczona podbiciem pierwszej cyfry. Przy okazji posprzątano: z publicznego interfejsu wyleciało 35 przestarzałych funkcji, a wbudowany serwer dostał zabezpieczenia przed kilkoma klasami ataków z sieci. Sam Gerganov zapowiadał latem „powolny, stały cykl wydań”.
Do tego liczby, które pokazują skalę. Projekt obsługuje ponad 150 wariantów architektur modeli i 17 różnych zapleczy obliczeniowych: od kart Nvidii i AMD, przez układy Apple, po procesory w telefonach i chińskie akceleratory Huawei. Na Hugging Face leży dziś ponad 222 tysiące modeli w formacie GGUF, który Gerganov wymyślił w sierpniu 2023 roku, żeby cały model mieścił się w jednym pliku.
02 · Fundament
Silnik, którego nie widać
Możliwe, że korzystasz z llama.cpp i o tym nie wiesz. LM Studio, popularny okienkowy program do lokalnych modeli, uruchamia je właśnie tym silnikiem. Jan ma go w zestawie. KoboldCpp jest na nim zbudowany. Docker używa go jako domyślnego silnika w swoim Model Runnerze. Ollama od maja 2025 roku ma własny silnik, ale sama pisze, że opiera go na bibliotece tensorowej GGML, czyli na sercu tego samego projektu.
Od 20 lutego 2026 roku za projektem stoi też firma. Gerganov z zespołem dołączył do Hugging Face, największego repozytorium modeli na świecie, zachowując kierownictwo techniczne. Zapowiedź była jednoznaczna.
„Projekt pozostanie w stu procentach otwarty i prowadzony przez społeczność, tak jak jest teraz.”
Jak daleko to zaszło, pokazuje historia z października. Na Hacker News furorę zrobił projekt, którego autor uruchomił llama.cpp na przerobionej konsoli PlayStation 5. Model Qwen 3.5 w wersji 9 miliardów parametrów odpowiadał z układu graficznego konsoli i obsługiwał laptopa oraz telefon w domowej sieci. To oczywiście sztuczka, ale dobrze ustawia skalę: skoro konsola pod telewizorem robi za serwer AI, zwykły pecet tym bardziej.
03 · Pamięć
Co się u Ciebie zmieści
W lokalnym AI jedna liczba decyduje prawie o wszystkim i nie jest to szybkość procesora. To ilość pamięci, do której model musi się załadować w całości: pamięci karty graficznej, jeśli ją masz, albo zwykłego RAM-u, jeśli liczysz na procesorze lub masz Maca, w którym obie pamięci są jednym. Zasada jest prosta: plik modelu plus zapas na rozmowę musi być mniejszy niż to, czym dysponujesz.
Sprawdź swój sprzęt
Ile masz pamięci na model?
Karta graficzna: wybierz ilość VRAM. Komputer bez karty albo Mac: wybierz ilość RAM i odejmij to, czego potrzebuje system.
- LFM3 1.7BLiquid AI1,10 GB
- Phi-4-miniMicrosoft2,49 GB
- Qwen 3.5 4BAlibaba, 201 języków2,74 GB
- Gemma 4 E2BGoogle3,11 GB
- Gemma 4 E4BGoogle4,98 GB
- Bielik 4.5B v3.0SpeakLeash, polski, plik Q85,06 GB
- Ministral 3 8BMistral5,20 GB
- Qwen 3.5 9BAlibaba5,68 GB
- Bielik 11B v3.1SpeakLeash, polski, 56 języków6,72 GB
- Gemma 4 12BGoogle7,12 GB
- Ministral 3 14BMistral8,24 GB
- gpt-oss-20bOpenAI, plik MXFP412,11 GB
- Devstral Small 2 24BMistral, do kodu14,33 GB
- Qwen 3.8 27BAlibaba16,56 GB
- Qwen 3.6 27BAlibaba16,82 GB
- Gemma 4 26B A4BGoogle16,95 GB
- Gemma 4 31BGoogle18,32 GB
- Qwen 3.6 35B A3BAlibaba22,13 GB
- Llama 3.3 70BMeta42,52 GB
- gpt-oss-120bOpenAI, plik MXFP463,39 GB
- Qwen 3.8 Flash NextAlibaba111 GB
- DeepSeek V4.1 FlashDeepSeek, kwantyzacja 2-bitowa298 GB
Rozmiary plików GGUF odczytane z Hugging Face 17 listopada 2026 roku. Model uznaję za mieszczący się, gdy plik plus 2,7 GB zapasu nie przekracza pamięci. Taki zapas zmierzył Gerganov dla gpt-oss-20b przy kontekście 8 tysięcy tokenów; dłuższy kontekst potrzebuje więcej.
Kilka rzeczy widać od razu. Przy 8 GB, czyli w typowym laptopie albo na starszej karcie, mieszczą się małe modele: wystarczą do streszczeń, tłumaczeń i prostych pytań, mylą się przy dłuższym rozumowaniu. Przy 12 i 16 GB otwiera się klasa średnia, a w niej rzecz ważna dla polskiego czytelnika.
Bielik 11B v3.1, wydany 10 listopada przez fundację SpeakLeash i krakowski Cyfronet, zajmuje w wersji czterobitowej 6,72 GB. Mieści się więc na karcie z 12 GB z dużym zapasem i jest dziś najrozsądniejszym wyborem, jeśli model ma przede wszystkim dobrze pisać po polsku. Sprawdzałem go osobno w tekście o premierze Bielika 3.1. W tej samej klasie jest gpt-oss-20b, otwarty model OpenAI, który producent zaprojektował tak, by działał w 16 GB.
24 GB, czyli RTX 4090 albo używana 3090, to próg, od którego lokalne AI przestaje być zabawką. Mieszczą się modele o 27-31 miliardach parametrów od Google i Alibaby, w tym Qwen 3.8 27B, najczęściej pobierany model z tej listy. Powyżej zaczyna się inna kategoria sprzętu. gpt-oss-120b potrzebuje ponad 64 GB, a wielkie modele chińskich laboratoriów, które wygrywają rankingi otwartych wag, liczą się w setkach gigabajtów nawet po najmocniejszym odchudzeniu. Te są otwarte, ale nie są domowe.
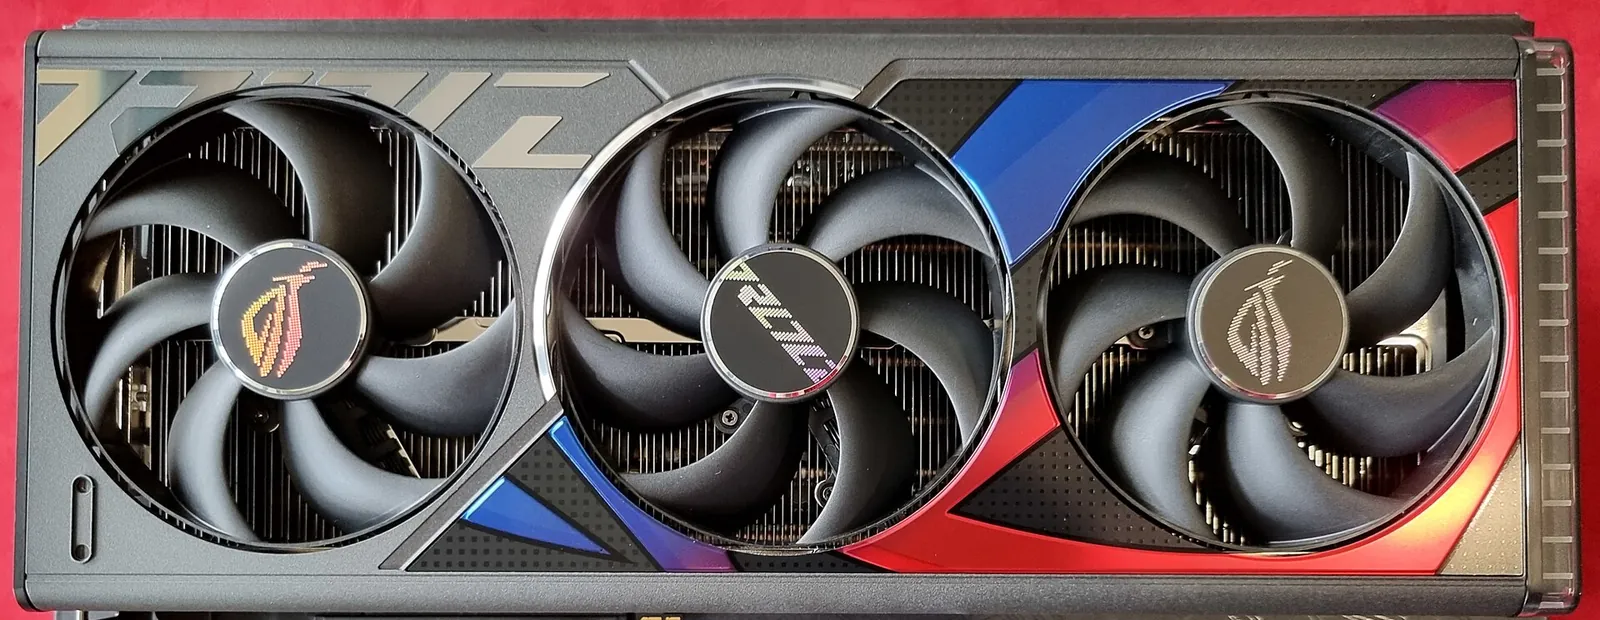
GeForce RTX 4090 z 24 GB pamięci. Nowych kart tego modelu nie ma już w polskich sklepach, używane kosztują od 11 do 20 tysięcy złotych.
04 · Tempo
Jak szybko to odpowiada
Druga liczba to szybkość, mierzona w tokenach na sekundę. Człowiek czyta kilka tokenów na sekundę, więc wszystko powyżej dwudziestu odbiera się jako płynne, a powyżej stu jako natychmiastowe.
gpt-oss-20b, generowanie odpowiedzi
Tokeny na sekundę
Pomiary Georgiego Gerganova z przewodnika po uruchamianiu gpt-oss w llama.cpp, sierpień 2025. Jeden token to mniej więcej trzy czwarte słowa po angielsku, po polsku trochę mniej.
Pomiary Gerganova pokazują coś, co łatwo przeoczyć przy zakupach. Karta sprzed sześciu lat, RTX 3090, jest wolniejsza od 4090 o mniej niż jedną trzecią, a ma tyle samo pamięci. W lokalnym AI pamięć starzeje się dużo wolniej niż moc. To dlatego używane 3090 trzymają cenę, a karta z 16 GB za niecałe trzy i pół tysiąca złotych bywa lepszym zakupem niż szybsza z ośmioma.
Bez karty graficznej też się da, tylko wolniej. Na samym procesorze małe modele odpowiadają wyraźnie wolniej: da się z nimi pracować nad tekstem, dłuższa rozmowa męczy. Wyjątkiem są komputery Apple z układami serii M, gdzie pamięć operacyjna jest jednocześnie pamięcią grafiki: komputer Apple z 36 albo 64 GB daje modelowi więcej miejsca niż jakakolwiek karta dla graczy, choć liczy wolniej.
05 · Rachunek
Ile kosztuje darmowe
Oprogramowanie jest darmowe naprawdę: licencja MIT, zero opłat, zero konta. Modele z listy powyżej też, większość na licencji Apache 2.0. Płaci się za krzem, i tu 2026 rok jest wyjątkowo złym momentem.
Do karty trzeba doliczyć pamięć operacyjną, a ta od roku drożeje w tempie, jakiego rynek nie widział od dawna. Najtańszy zestaw 32 GB DDR5 kosztuje dziś na Ceneo 2150 złotych. Według zestawienia, które opisał PurePC, w Stanach taki zestaw podrożał w rok ze 108 do 572 dolarów. TrendForce prognozuje kolejne 13-18 procent wzrostu cen kontraktowych w tym kwartale. Jest w tym ironia: pamięć wykupują centra danych, w których działa to samo AI, tylko w wersji chmurowej.
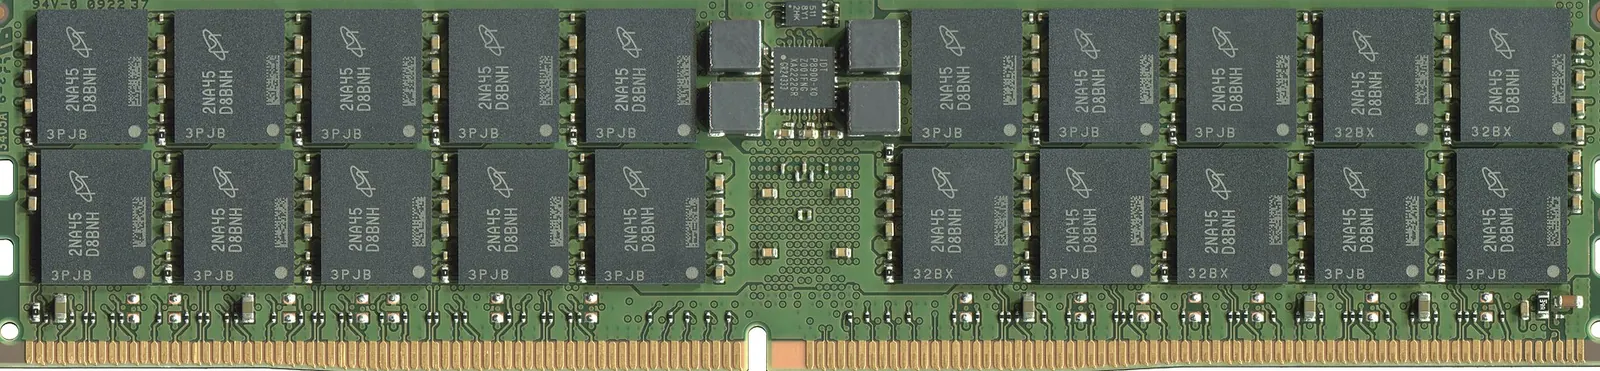
Moduł pamięci DDR5. Zestaw 32 GB kosztuje dziś ponad dwa tysiące złotych.
Uczciwy rachunek wygląda więc tak. Abonament na model w chmurze, na przykład Claude Pro, kosztuje 20 dolarów miesięcznie, czyli przy kursie NBP z 13 listopada niespełna 80 złotych. Używana RTX 4090 za 13 tysięcy to równowartość 163 miesięcy takiego abonamentu, ponad trzynastu lat. Do tego prąd: karta pod pełnym obciążeniem bierze 450 watów, więc cztery godziny pracy dziennie to 54 kilowatogodziny w miesiącu.
Jeżeli ktoś mówi, że lokalne AI kupuje się dla oszczędności, to nie liczył. Kupuje się je z trzech innych powodów. Pierwszy to prywatność: serwer llama.cpp nasłuchuje domyślnie tylko na Twoim komputerze i żaden dokument klienta, wynik badań ani szkic umowy nie opuszcza dysku. Drugi to niezależność: model, który masz w pliku, nie zmieni się z dnia na dzień, nie podrożeje i nie zniknie z oferty. Trzeci to brak limitów: możesz przepuścić przez niego dziesięć tysięcy dokumentów w nocy i nikt nie przyśle rachunku. Jeśli żaden z tych powodów Cię nie dotyczy, abonament jest po prostu tańszy. Sprzęt pod te zastosowania rozbieram na części w tekście RTX 4090 do AI w 2026.
06 · Sufit
Czego nie dostaniesz
Zostaje pytanie, które entuzjaści lokalnych modeli wolą omijać. Jak mądre jest to, co zmieści się w domu?
Artificial Analysis Intelligence Index, wersja 5
Ile inteligencji mieści się w domu
Odczyt z 17 listopada 2026 roku. Wynik to punkty w zbiorczym indeksie niezależnej firmy Artificial Analysis, najwyższe ustawienie każdego modelu.
Zestawienie Artificial Analysis mierzy modele jednym zestawem testów, bez względu na to, kto je zrobił. Najlepsze modele zamknięte, dostępne tylko przez chmurę, mają w nim 57-65 punktów. Najlepszy model z otwartymi wagami, Kimi K3.1 Pro, ma 46, ale do uruchomienia potrzebuje serwera, nie peceta. Najlepszy z tych, które zmieszczą się w 24 GB, ma 20 punktów. Mniej niż jedna trzecia czołówki.
Ta liczba nie znaczy, że lokalny model jest trzy razy głupszy w każdym zadaniu. Do streszczenia dokumentu, wyciągnięcia danych z faktury, przetłumaczenia maila czy podpowiedzi w edytorze kodu modele za 20 punktów nadają się dobrze, i większość codziennej pracy to właśnie takie zadania. Różnica wychodzi tam, gdzie trzeba długo rozumować, pilnować wielu wątków naraz albo samodzielnie prowadzić wieloetapową pracę. Tam chmura jest o klasę wyżej i nic nie wskazuje, żeby dom miał ją dogonić, bo najlepsze otwarte modele rosną szybciej niż pamięć w naszych komputerach.
Dorosłość llama.cpp polega między innymi na tym, że można to wreszcie powiedzieć spokojnie. Lokalne AI nie zastępuje chmury. Jest drugim narzędziem, do innych zadań, i w tych zadaniach jest już w pełni poważne.
07 · Start
Pierwsze uruchomienie w trzech poleceniach
Najlepszą wiadomością wersji 1.0 jest to, jak mało trzeba dziś umieć, żeby zacząć. Na Windowsie otwierasz PowerShell i wklejasz jedno polecenie z oficjalnej instrukcji. Instalator waży około megabajta.
irm https://llama.app/install.ps1 | iexinstalacja na Windowsie; alternatywnie: winget install llama.cppllama cli -hf ggml-org/Qwen3.5-0.8B-GGUFpobiera mały model z Hugging Face i otwiera rozmowę w terminalullama serve -hf ggml-org/Qwen3.5-0.8B-GGUFuruchamia serwer z czatem w przeglądarce pod adresem 127.0.0.1:9931Trzecie polecenie jest ważniejsze, niż wygląda. Serwer mówi tym samym językiem co interfejs OpenAI, więc każdy program, który potrafi rozmawiać z ChatGPT przez API, da się przestawić na Twój komputer zmianą jednego adresu. Przykładowy model z instrukcji jest malutki i służy tylko do sprawdzenia, czy wszystko działa. Potem podmień jego nazwę na coś z kalkulatora powyżej.
Kto woli okienka od terminala, ma LM Studio, Ollamę i resztę rodziny, o których pisałem w tekstach LM Studio czy Ollama i Ollama od podstaw. Szczegółową instalację na Windowsie z kartą Nvidii opisuję w poradniku llama.cpp na Windowsie, a całość tematu, od tekstu po obraz i wideo, zbiera strona Lokalne AI.
08
Jeden wieczór, trzy lata
Historia llama.cpp jest pouczająca z powodu, który nie ma nic wspólnego z techniką. Najważniejszy program lokalnego AI nie powstał w laboratorium z miliardowym budżetem. Napisał go jeden człowiek, wieczorem, z uczciwym dopiskiem, że nie wie, czy działa. Wielkie firmy wydały potem setki miliardów dolarów na centra danych, a równolegle kilkuset ochotników dopisywało linijka po linijce coś, co pozwala uruchomić model na laptopie w pociągu.
Jedno drugiego nie zastąpi. Ale dobrze wiedzieć, że gdy następnym razem abonament podrożeje, usługa padnie albo regulamin zmieni się na gorsze, na dysku może leżeć plik, który odpowie mimo wszystko.
Czytaj dalej
Źródła
- llama.cpp: pierwsze README, 10.03.2023
- llama.cpp: wydanie v1.0.0, GitHub, 13.11.2026
- Hugging Face: llama.cpp v1.0.0, a stronger foundation for the local AI ecosystem, 13.11.2026
- Ollama: nowy silnik, podziękowania dla zespołu GGML, 15.05.2025
- Hugging Face: zespół GGML dołącza do HF, 20.02.2026
- Hacker News: PS5LM, model językowy na PlayStation 5, 16.10.2026
- Georgi Gerganov: przewodnik po uruchamianiu gpt-oss w llama.cpp, 18.08.2025
- PurePC: ceny RAM oderwały się od rzeczywistości, 18.08.2026
- TrendForce: ceny kontraktowe pamięci DRAM w IV kw. 2026, 11.11.2026
- Artificial Analysis: ranking otwartych modeli, Intelligence Index v5, odczyt 17.11.2026
- llama.cpp: README wersji 1.0.0
- llama.cpp: pierwszy commit, 10.03.2023
- GitHub API: statystyki repozytorium llama.cpp, odczyt 17.11.2026
- Georgi Gerganov: zasady wersjonowania ggml i llama.cpp, 08.2026
- llama.cpp: wprowadzenie formatu GGUF, 21.08.2023
- Hugging Face: modele w formacie GGUF, odczyt 17.11.2026
- LM Studio: dokumentacja
- Docker: silniki Model Runnera
- PS5LM: llama.cpp na PlayStation 5
- SpeakLeash: karta modelu Bielik 11B v3.1
- OpenAI: karta modelu gpt-oss-20b
- Alibaba: karta modelu Qwen 3.8 27B
- Google: karta modelu Gemma 4 31B
- Nvidia: specyfikacja GeForce RTX 4090
- Ceneo: ceny kart graficznych, odczyt 17.11.2026
- OLX: używane RTX 4090 i 3090, odczyt 17.11.2026
- Ceneo: pamięci DDR5 32 GB, odczyt 17.11.2026
- Anthropic: cennik planów Claude
- llama.cpp: dokumentacja serwera, wersja 1.0.0
- llama.cpp: instalacja, wersja 1.0.0
Zdjęcia
- Karta graficzna GeForce RTX 4090 - Benlisquare, CC BY-SA 4.0 (kadr przycięty), Wikimedia Commons.
- Moduł pamięci DDR5 - PantheraLeo1359531, CC BY 4.0 (kadr przycięty), Wikimedia Commons.

