llama.cpp na Windowsie: instalacja, czat w przeglądarce i test CUDA
Jedna komenda instaluje llama.cpp, ale wersja z winget była u nas 2-2,6 raza wolniejsza. Jak pobrać wersję CUDA, uruchomić serwer i wyłączyć zapętlone myślenie.
👁 115 przeczytań
llama.cpp to darmowy silnik, na którym działa większość lokalnych modeli językowych, także w LM Studio i Ollamie. Na Windowsie instaluje się go jedną komendą, a razem z nim dostajesz serwer z czatem w przeglądarce i API zgodne z OpenAI. 26 września 2026 roku uruchomiłem go na karcie RTX 4090 z trzema modelami i trafiłem na pułapkę, o której instrukcje milczą: wersja z menedżera winget generowała tekst od 1,9 do 2,6 raza wolniej niż oficjalna wersja na CUDA.
W skrócie
Na karcie Nvidii pobierz z GitHuba paczkę „win-cuda”, a nie wersję z winget. Gemma 4 12B na CUDA pisała 104 tokeny na sekundę, na Vulkanie 54. Bielik 11B: 72 wobec 28. Wczytanie polecenia na CUDA było przy Gemmie 20 razy szybsze. llama.cpp ma sens, gdy chcesz mieć pełną kontrolę nad ustawieniami i własny serwer API. Jeśli wolisz klikać, weź LM Studio albo Ollamę, które korzystają z tego samego silnika.
Co to jest llama.cpp i po co go instalować
llama.cpp to projekt open source na licencji MIT, rozwijany przez organizację ggml-org na GitHubie. Uruchamia modele w formacie GGUF, czyli skompresowane (kwantyzowane) wersje modeli, które mieszczą się w pamięci zwykłej karty graficznej. Z tego samego silnika korzystają LM Studio i Ollama, więc instalując llama.cpp, dostajesz to samo, tylko bez nakładki.
W paczce są trzy programy, których użyjesz na pewno:
- llama-server - serwer z czatem w przeglądarce i API zgodnym z OpenAI (to on jest najważniejszy),
- llama-cli - rozmowa z modelem w oknie terminala,
- llama-bench - pomiar szybkości, który pokaże, czy karta pracuje tak, jak powinna.
Instalacja: dwie drogi i jedna pułapka
Najprostsza droga to jedna komenda w PowerShellu: winget install ggml.llamacpp. Po niej llama-server działa z każdego folderu. Problem w tym, że winget instaluje wersję na Vulkanie. To uniwersalny interfejs graficzny, który działa na kartach Nvidii, AMD i Intela. Na karcie Nvidii jest jednak wyraźnie wolniejszy niż CUDA. Sprawdzisz to komendą llama-server --list-devices: jeśli widzisz „Vulkan0”, masz wersję uniwersalną, a jeśli „CUDA0”, masz wersję pod Nvidię.
Na karcie Nvidii zrób to tak:
- Wejdź na stronę wydań projektu na GitHubie (link w źródłach) i otwórz najnowsze wydanie.
- Pobierz dwa pliki:
llama-bXXXXX-bin-win-cuda-12.4-x64.zip(u mnie 262 MB) icudart-llama-bin-win-cuda-12.4-x64.zip(391 MB, biblioteki CUDA - nie musisz instalować całego CUDA Toolkit). - Rozpakuj oba do jednego folderu, np.
D:\AI\llama-cuda. - W tym folderze uruchom
.\llama-server.exe --list-devices. Powinieneś zobaczyć swoją kartę z dopiskiem CUDA0.
Na kartach AMD i Intela zostań przy Vulkanie z winget, bo tam to właśnie on jest właściwym wyborem. Na Macu z procesorem Apple llama.cpp korzysta z interfejsu Metal i instaluje się go przez Homebrew (brew install llama.cpp).
Ile tracisz na złej wersji: pomiar na RTX 4090
Obie wersje zmierzyłem tym samym narzędziem llama-bench: 512 tokenów polecenia, 128 tokenów odpowiedzi, trzy powtórzenia, cały model na karcie. Wersja z winget miała numer 11149, a paczka CUDA 11194, więc różnica kilkudziesięciu wydań nie tłumaczy dwukrotnej przepaści.
| Model (plik GGUF) | Vulkan: odpowiedź | CUDA: odpowiedź | Vulkan: wczytanie polecenia | CUDA: wczytanie polecenia |
|---|---|---|---|---|
| Gemma 4 12B, Q4_0 (7,0 GB) | 53,8 tok/s | 104,2 tok/s | 381 tok/s | 7667 tok/s |
| Bielik 11B v3, Q8_0 (11,9 GB) | 27,7 tok/s | 71,8 tok/s | 4418 tok/s | 7889 tok/s |
Przy 100 tokenach na sekundę tekst pojawia się szybciej, niż da się go czytać. Przy 28 tokenach dłuższa odpowiedź przychodzi już z wyraźnym opóźnieniem. Wczytanie polecenia ma znaczenie, gdy wklejasz długi dokument: 20 stron to około 10 tysięcy tokenów, czyli ponad 26 sekund czekania na Vulkanie wobec niecałej 1,5 sekundy na CUDA.
Pierwsze uruchomienie: serwer z czatem
Model w formacie GGUF pobierzesz z Hugging Face (np. Gemma 4 12B z oficjalnego repozytorium Google, plik około 7 GB). Potem jedna komenda:
llama-server -m D:\AI\gguf\gemma-4-12b-it-qat-q4_0.gguf -ngl 99 -fa on -c 16384 --jinja
-ngl 99- wszystkie warstwy modelu na karcie graficznej (bez tego model liczy na procesorze i działa kilka razy wolniej),-fa on- szybszy mechanizm uwagi, który oszczędza pamięć karty,-c 16384- kontekst, czyli ile tekstu model widzi naraz; więcej kontekstu to więcej zajętej pamięci,--jinja- szablon rozmowy zapisany w pliku modelu, potrzebny do poprawnego formatu odpowiedzi i narzędzi.
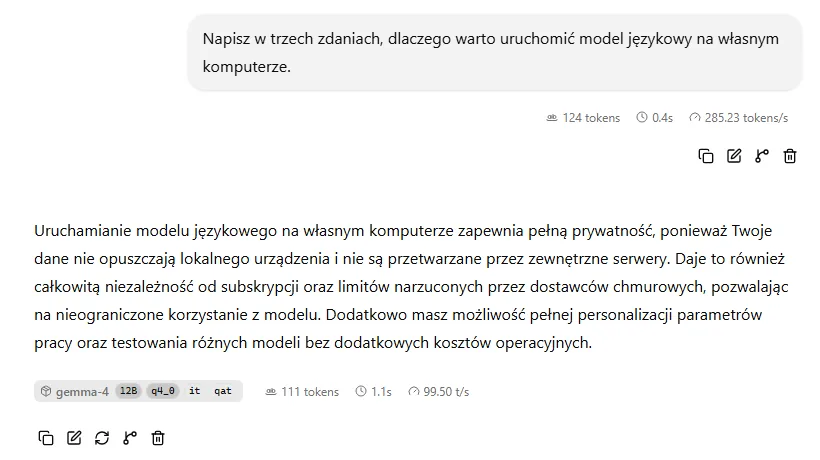
Model 7 GB wczytał się u mnie w 4,6 sekundy. Potem otwierasz w przeglądarce adres http://127.0.0.1:8080 i masz czat, który pod każdą odpowiedzią pokazuje liczbę tokenów i szybkość.
Pułapka numer dwa: model, który myśli w nieskończoność
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Gemma 4 ma wbudowany tryb rozumowania i llama-server z opcją --jinja włącza go domyślnie. W moim teście 13 zadań po polsku model z włączonym myśleniem wygenerował 54 093 tokeny w 570 sekund, a w trzech zadaniach nie oddał odpowiedzi wcale. Zamiast pisać, liczył słowa w swoim szkicu, aż wyczerpał limit. Po wyłączeniu myślenia te same 13 zadań zajęło 53 sekundy i 4710 tokenów, bez ani jednego pustego wyniku.
Myślenie wyłączysz, dopisując do komendy --chat-template-kwargs "{\"enable_thinking\": false}". Ten sam parametr działa w modelach Qwen 3.x. Dla GPT-OSS zamiast tego ustawia się reasoning_effort na low. Szerzej o tym zjawisku piszę w tekście AI myśli za długo po polsku.
Własne API zgodne z OpenAI
llama-server od razu wystawia adres http://127.0.0.1:8080/v1/chat/completions w tym samym formacie co API OpenAI. Każdy program, w którym da się zmienić adres serwera (skrypty w Pythonie, n8n, wtyczki do edytorów), może rozmawiać z lokalnym modelem bez klucza i bez opłat za tokeny. W ten sposób przepuściłem przez lokalne modele cały test 13 zadań po polsku. Odpowiedź zawiera też pole timings z szybkością generowania, co przydaje się do pomiarów.
Ile pamięci karty zajmie model
Poniżej rzeczywiste zajęcie pamięci karty w moim teście, z kontekstem 32 768 tokenów. Od wyniku odjąłem około 5-6 GB, które na tym komputerze zajmowały przeglądarka i system przed startem serwera.
| Model | Plik | Pamięć karty z kontekstem 32k | Szybkość odpowiedzi (CUDA) |
|---|---|---|---|
| Gemma 4 12B Q4_0 | 7,0 GB | ok. 8,2 GB | 104 tok/s |
| Bielik 11B v3 Q8_0 | 11,9 GB | ok. 17,0 GB | 72 tok/s |
| Qwen 3.8 27B Q4_K_M | 16,5 GB | ok. 17,4 GB | 50 tok/s |
Na karcie z 8 GB zmieścisz więc Gemmę 12B z krótszym kontekstem, a na 12-16 GB większość modeli do 14 miliardów parametrów. Więcej o doborze sprzętu jest w poradniku jaki komputer do lokalnego AI.
Najczęstsze pytania
Czy llama.cpp jest darmowy?
Tak. llama.cpp jest na licencji MIT, nie wymaga konta ani klucza i działa bez internetu po pobraniu modelu. Licencję ma też każdy model osobno: Gemma 4, Bielik v3, Qwen 3.8 i GPT-OSS są na Apache 2.0, więc można ich używać komercyjnie.
llama.cpp, LM Studio czy Ollama?
Wszystkie trzy korzystają z tego samego silnika. LM Studio daje okienkowy program z wyszukiwarką modeli, Ollama prostą obsługę z terminala, a llama.cpp pełną kontrolę nad parametrami i najnowsze funkcje od razu po wydaniu.
Skąd mam wiedzieć, czy model liczy na karcie graficznej?
Uruchom llama-server --list-devices i sprawdź, czy karta jest na liście, a w komendzie ustaw -ngl 99. Przy pracy na karcie Menedżer zadań pokazuje wzrost zajętej pamięci GPU o rozmiar pliku modelu.
Czy zadziała na karcie AMD?
Tak, przez Vulkan, czyli wersję z winget albo paczkę „win-vulkan” z GitHuba. Moje pomiary dotyczą karty Nvidii. Na AMD Vulkan jest naturalnym wyborem, a porównanie z CUDA nie ma tam zastosowania.
Źródła i data sprawdzenia
Pomiary własne: RTX 4090 24 GB, Windows 11, llama.cpp 11149 (winget, Vulkan) i b11194 (win-cuda-12.4), llama-bench -p 512 -n 128 -r 3. Wydania i licencja: github.com/ggml-org/llama.cpp. Licencje modeli: karty modeli na Hugging Face (Gemma 4) i Bielik v3. Sprawdzone 26 września 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym