

Lokalny model w VS Code: Ollama bez konta GitHub i mój test agenta
VS Code od wersji 1.122 pozwala używać czatu i trybu agenta z lokalnymi modelami bez konta GitHub, a Continue przestało być rozwijane. Pokazuję konfigurację z rozszerzeniem Ollama i test trzech modeli na małym projekcie.
Spis treści 10
👁 116 przeczytań
Lokalny model w VS Code podłączysz bez konta GitHub: od wersji 1.122 czat i tryb agenta działają z własnymi modelami bez logowania, a oficjalne rozszerzenie Ollama dodaje do wyboru wszystkie modele z Twojego komputera. Continue, przez ostatnie lata popularna droga do tego, w czerwcu 2026 roku trafiło do Cursora i nie jest już rozwijane. Sprawdziłem nową drogę 17 października 2026 roku w VS Code 1.141.2 z Ollamą 0.40.5 na karcie RTX 4090. W moim teście trzy lokalne modele dopisały funkcję i plik testów do małego projektu w Pythonie, a najszybciej poszło GPT-OSS 20B: 1 min 34 s i wszystkie testy zaliczone. Pozostałe lokalne narzędzia opisuję w przewodniku Lokalne AI.
Stan na 17 października 2026
- Najnowszy VS Code to 1.142 z 14 października 2026. Własne modele (BYOK) działają bez konta GitHub i bez planu Copilot od wersji 1.122 z 28 maja 2026.
- Rozszerzenie Ollama od wydawcy Ollama: wersja 0.0.13 z 16 października 2026, licencja MIT, ponad 300 tys. instalacji, wymaga VS Code 1.127 lub nowszego.
- Wbudowany w VS Code dostawca Ollamy jest wycofywany. Dokumentacja Microsoftu każe przejść na rozszerzenie Ollama.
- Continue: strona projektu podaje, że firmę przejął Cursor. Ostatnie wydanie 2.0.0 wyszło 19 czerwca 2026, repozytorium jest tylko do odczytu, dane z usługi Continue Hub można było wyeksportować do 15 lipca 2026.
- VS Code, rozszerzenie i Ollama są darmowe, także do pracy w firmie.
Odpowiedź w skrócie
- Co zainstalować: Ollamę, jeden model z obsługą narzędzi i rozszerzenie Ollama w VS Code.
- Co działa bez konta: czat, tryb agenta (edycja plików, terminal), tytuły rozmów i opisy commitów.
- Czego nie ma: podpowiedzi w trakcie pisania (inline) i wyszukiwania semantycznego. Te funkcje nadal wymagają konta GitHub.
- Jaki model: GPT-OSS 20B na kartę 16 GB i większą, Gemma 4 12B na 8-12 GB.
Co się zmieniło w 2026 roku
Do niedawna lokalny model w VS Code oznaczał Continue: darmowe rozszerzenie, plik config.yaml i Ollama w tle. W czerwcu 2026 roku na stronie Continue pojawiła się informacja, że firmę przejął Cursor. Zespół wydał wersję końcową 2.0.0, a repozytorium przestało być rozwijane. Rozszerzenie z lokalnym plikiem konfiguracji dalej się uruchamia, ale nie dostanie poprawek ani obsługi nowych modeli.
W tym samym czasie Microsoft otworzył wbudowany czat VS Code na modele spoza Copilota. Wersja 1.122 z 28 maja 2026 pozwala używać własnych modeli bez logowania do GitHuba, z myślą o pracy offline i w sieciach odciętych od internetu. Ollama wydała własne rozszerzenie, które dodaje jej modele do listy w czacie. Efekt: masz panel czatu i tryb agenta wbudowane w edytor, liczone na Twojej karcie.
Jak zacząć krok po kroku
- Zainstaluj Ollamę i model z narzędziami. Na przykład
ollama pull gemma4:12b-it-qat(7,2 GB). Modele bez obsługi narzędzi, np. Bielik, działają tylko w zwykłym czacie, nie w trybie agenta. - Zainstaluj rozszerzenie Ollama. W widoku rozszerzeń wpisz „Ollama” i wybierz pozycję od wydawcy Ollama. Z terminala:
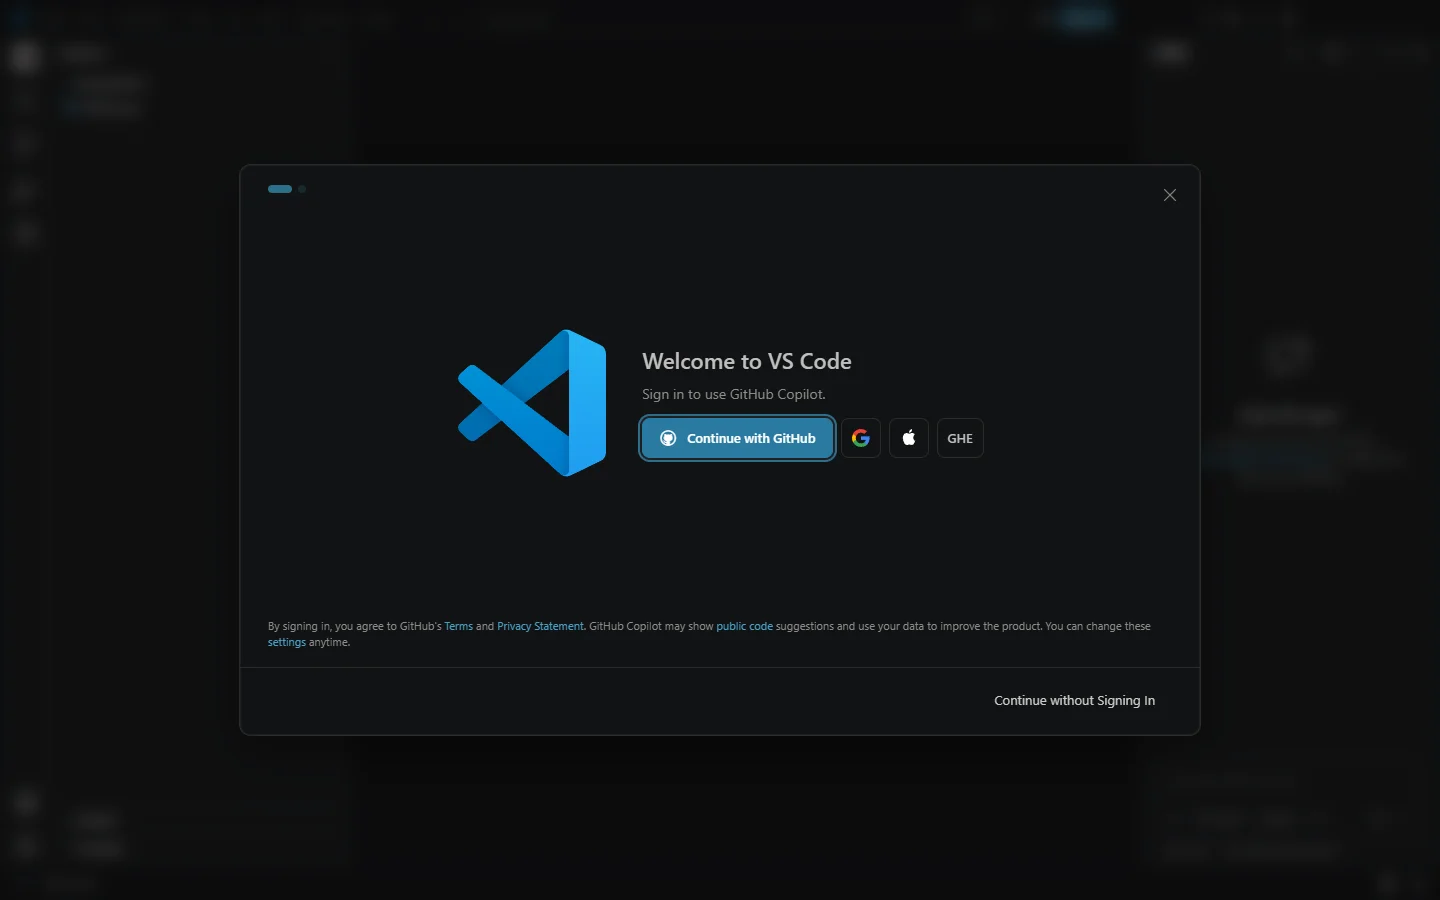
code --install-extension ollama.ollama. - Pomiń logowanie. Na ekranie powitalnym VS Code kliknij na dole Continue without Signing In.
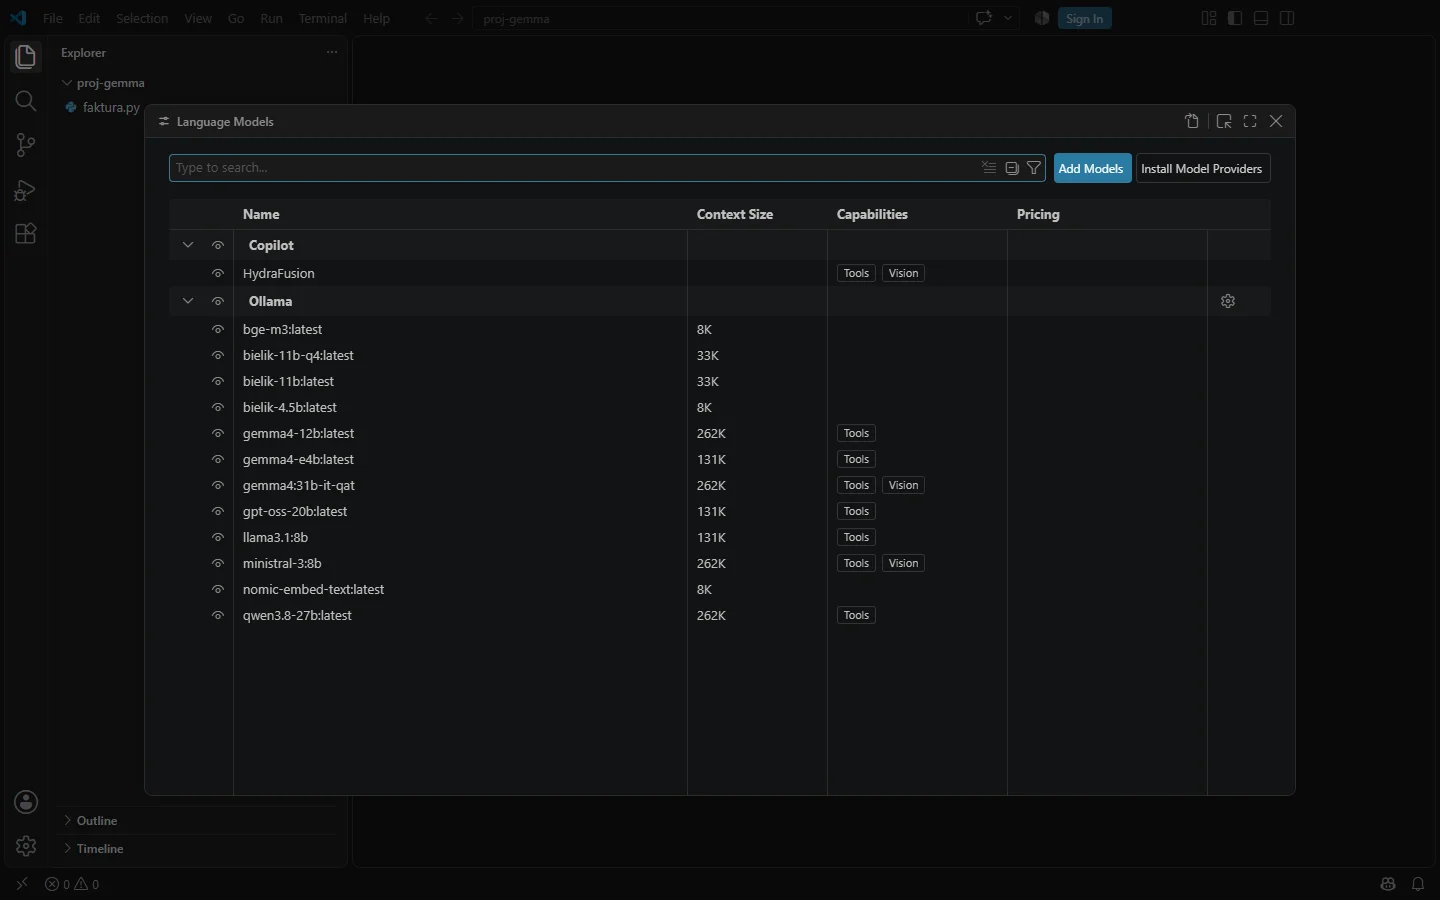
- Sprawdź listę modeli. Paleta poleceń (Ctrl+Shift+P), polecenie Chat: Manage Language Models. U mnie modele z Ollamy pojawiły się od razu, z długością kontekstu i oznaczeniem Tools przy tych, które obsługują narzędzia.
- Wybierz model w czacie. Otwórz czat (Chat: Open Chat), kliknij nazwę modelu pod polem wpisywania i wpisz nazwę z Ollamy.
- Ustaw model do zadań pomocniczych. VS Code pokaże komunikat Set BYOK utility models. Kliknij Configure i wybierz Main Agent Model. W pliku ustawień wygląda to tak:
{
  "chat.byokUtilityModelDefault": "mainAgent",
  "telemetry.telemetryLevel": "off"
}
Bez tego tytuły rozmów i opisy commitów VS Code próbuje generować modelami Copilota, a bez konta te funkcje nie działają. Konkretny model wskażesz też ustawieniami
chat.utilityModelichat.utilitySmallModel.
Żeby nie mieszać w swoim głównym edytorze, testowałem na osobnym profilu (code --user-data-dir i --extensions-dir). W codziennej pracy wystarczy zwykła instalacja.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Mój test: dopisanie funkcji i testów w małym projekcie
17 października 2026 przygotowałem mały projekt: plik faktura.py z funkcjami brutto i suma_faktury. Każdy model dostał w trybie agenta to samo polecenie po polsku: dodaj funkcję netto_z_brutto(brutto, vat=23) z zaokrągleniem do 2 miejsc, utwórz plik test_faktura.py z testami unittest dla trzech funkcji i nie uruchamiaj poleceń w terminalu. Każdy model pracował na osobnej kopii projektu. Testy uruchomiłem potem sam.
| Model | Czas pracy agenta | Testy | Wynik |
|---|---|---|---|
| GPT-OSS 20B | 1 min 34 s (4 kroki) | 6 z 6 zaliczonych | poprawnie |
| Gemma 4 12B | 2 min 14 s (2 kroki) | 3 z 3 zaliczonych | poprawnie |
| Qwen 3.8 27B | 9 min 39 s (2 kroki) | 13 z 14 zaliczonych | funkcja dobra, jeden test błędny |
- Funkcję wszystkie trzy napisały dobrze:
netto_z_brutto(123)zwraca 100,0, anetto_z_brutto(108, 8)też 100,0. GPT-OSS dodał do tego obsługę stawki 0% i opis funkcji, ale po angielsku. - Qwen napisał najwięcej testów (14), ale w jednym sam się pomylił: wpisał, że suma faktury z przykładu to 296 zł, a jest 300 zł. Tak wygląda typowy błąd lokalnego agenta, dlatego testy trzeba przejrzeć, a nie tylko uruchomić.
- Czas Qwena nie jest miarodajny. W trakcie jego próby karta pracowała też dla innych zadań i pamięć była prawie pełna. Gemma 4 12B i GPT-OSS 20B mieszczą się w karcie z zapasem.
- Ostrzeżenie o kontekście. Rozszerzenie pokazało komunikat, że Ollama używa okna 32 tysięcy tokenów, i zaleciło co najmniej 64 tysiące w ustawieniach Ollamy. Tryb agenta wysyła do modelu opis narzędzi i plików, więc przy większych projektach krótki kontekst ucina rozmowę. Przy Gemmie 4 12B dłuższy kontekst kosztuje mało pamięci, przy innych modelach sprawdź to w rankingu najlepszy lokalny model AI po polsku.
- Zmiany trafiają od razu do plików, a VS Code pokazuje je do akceptacji przyciskami Keep i Undo.
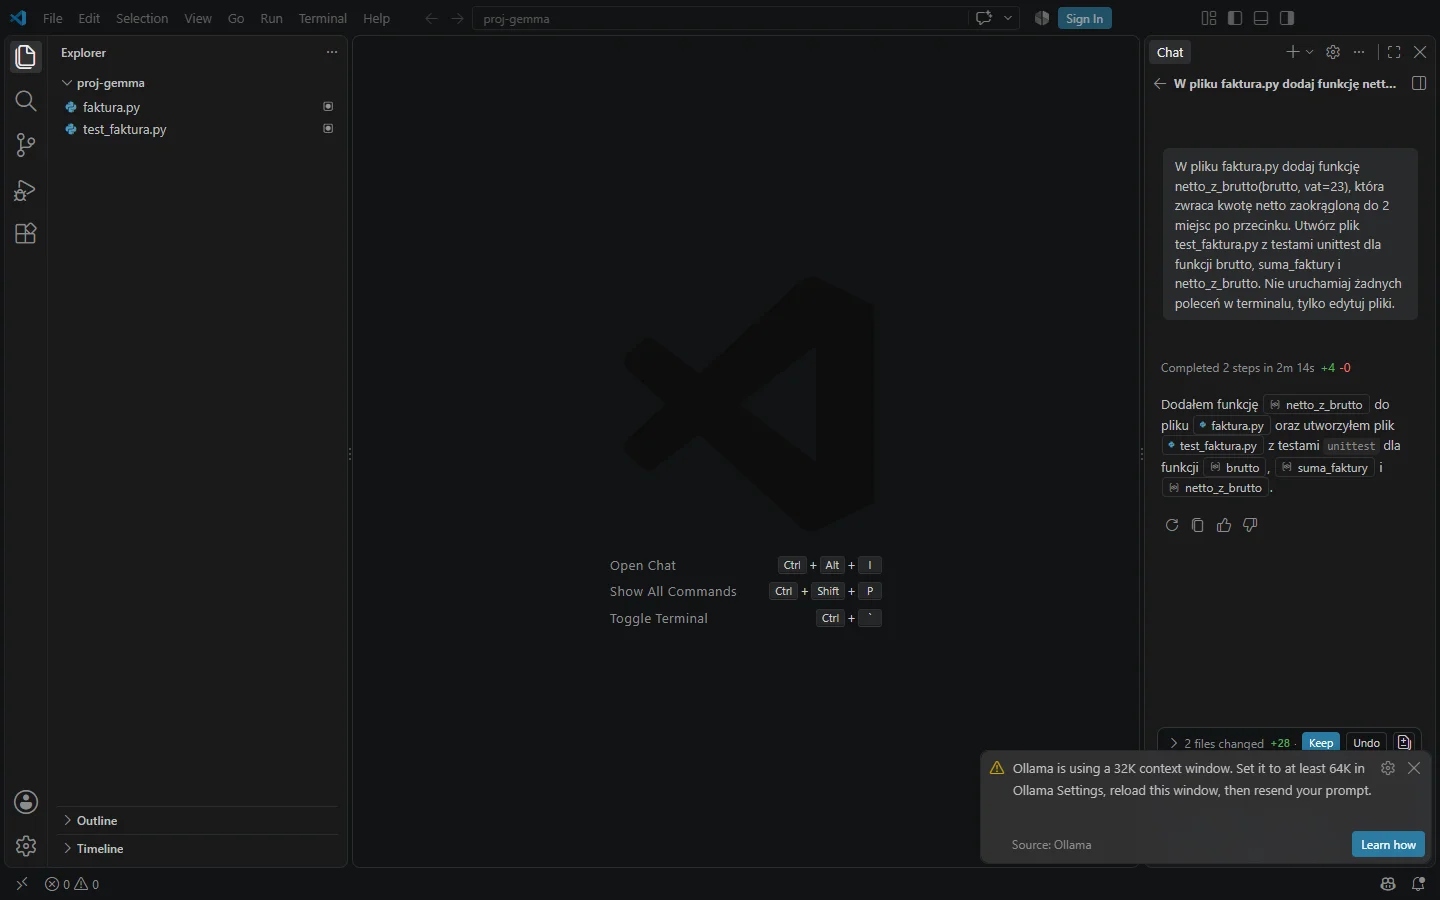
Testowałem na domyślnych uprawnieniach VS Code. Edycje plików w otwartym folderze poszły bez pytania, a terminala żaden model nie użył, bo polecenie tego zabraniało.
Co działa bez konta, a co nie
| Funkcja | Bez konta GitHub, z Ollamą |
|---|---|
| Czat w panelu bocznym | tak |
| Tryb agenta (edycja plików, terminal) | tak, z modelami obsługującymi narzędzia |
| Tytuły rozmów, opisy commitów | tak, po ustawieniu modelu pomocniczego |
| Podpowiedzi w trakcie pisania (inline) | nie, wymagają konta GitHub |
| Wyszukiwanie semantyczne w projekcie | nie, wymaga konta GitHub |
Brak podpowiedzi w trakcie pisania to największa różnica względem dawnego Continue, które miało autouzupełnianie z lokalnego modelu.
Który lokalny model do programowania
W trybie agenta działa tylko model z oznaczeniem Tools. Bielik go nie ma, więc nadaje się wyłącznie do zwykłego czatu.
| Karta | Model | Dlaczego |
|---|---|---|
| 8-12 GB | Gemma 4 12B | 7,5-8,3 GB pamięci, zadanie zrobione poprawnie w 2 min 14 s |
| 16 GB | GPT-OSS 20B | 11,3-12,1 GB, najszybszy w teście, 237 tok/s na RTX 4090 |
| 24 GB | GPT-OSS 20B albo Qwen 3.8 27B | Qwen pisze dokładniejsze testy, ale wolniej |
Pamięć i szybkość to moje pomiary z rankingu modeli po polsku (Ollama, kontekst 4-32 tysiące tokenów). Do pobrania: ollama pull gemma4:12b-it-qat (7,2 GB) albo ollama pull gpt-oss:20b.
Porównanie: wbudowany czat, Continue i inne drogi
| Droga | Stan | Dla kogo |
|---|---|---|
| Czat VS Code + rozszerzenie Ollama | rozwijane, oficjalne | nowe instalacje |
Continue z lokalnym config.yaml | działa, bez poprawek od 19.06.2026 | kto już ma i potrzebuje autouzupełniania |
| LM Studio jako własny adres | przez Custom Endpoint, http://localhost:1234/v1 | kto woli LM Studio |
| Agent w terminalu z Ollamą | poza edytorem | praca w konsoli |
LM Studio nie ma własnego rozszerzenia do VS Code, ale dostawca Custom Endpoint obsługuje API zgodne z OpenAI (Chat Completions i Responses) oraz Anthropic Messages. Różnice między programami opisuję w porównaniu LM Studio czy Ollama. Agentów w terminalu sprawdziłem w teście ten sam kalkulator w Codex, Kimi Code i lokalnie, a płatne edytory z AI zebrałem w tekście alternatywy dla Cursora.
Dla kogo to jest
- Dla firm, które nie mogą wysyłać kodu do chmury. Polecenia trafiają tylko do Ollamy na Twoim komputerze.
- Dla osób z kartą 12-24 GB, które chcą czatu o kodzie i prostych zmian w plikach bez abonamentu.
- Nie dla kogoś, kto liczy na poziom płatnych agentów. Lokalny model na jednej karcie robi proste zadania, ale przy większych projektach chmurowe modele są wyraźnie lepsze.
Najczęstsze pytania
Jak podłączyć Ollamę do VS Code?
Zainstaluj rozszerzenie Ollama od wydawcy Ollama, uruchom Ollamę i wybierz model z sekcji Ollama w wyborze modeli w czacie. Rozszerzenie samo znajduje modele pod adresem http://127.0.0.1:11434.
Czy do AI w VS Code potrzebuję konta GitHub?
Nie, od VS Code 1.122. Na ekranie powitalnym wybierasz „Continue without Signing In”. Konto jest potrzebne tylko do podpowiedzi w trakcie pisania i wyszukiwania semantycznego.
Jaki lokalny model do programowania wybrać?
Do trybu agenta potrzebny jest model z obsługą narzędzi. W moim teście zadanie poprawnie i najszybciej zrobił GPT-OSS 20B (karta 16 GB), a na karcie 8-12 GB dobrze sprawdziła się Gemma 4 12B.
Czy Continue jeszcze działa?
Rozszerzenie z lokalną konfiguracją się uruchamia, ale od czerwca 2026 roku nie jest rozwijane, a repozytorium jest tylko do odczytu. Kod ma licencję Apache 2.0, więc mogą powstać społecznościowe odgałęzienia.
Czy to jest darmowe?
Tak. VS Code, rozszerzenie Ollama (licencja MIT) i Ollama są darmowe. Płacisz tylko prądem za pracę karty.
Czy mój kod wychodzi z komputera?
Przy modelach lokalnych polecenia trafiają tylko do Ollamy. Wyłącz dodatkowo telemetrię VS Code ("telemetry.telemetryLevel": "off"), jeśli nie chcesz wysyłać danych o używaniu edytora.
Źródła i data sprawdzenia
- Dokumentacja VS Code: modele językowe.
- Blog VS Code: własne modele (BYOK).
- Visual Studio Magazine o VS Code 1.122.
- Informacje o wydaniach VS Code (1.142 z 14 października 2026).
- Rozszerzenie Ollama w Visual Studio Marketplace.
- Strona Continue i repozytorium Continue.
- The New Stack o przejęciu Continue przez Cursora.
- Test własny: VS Code 1.141.2, rozszerzenie Ollama 0.0.13, Ollama 0.40.5, RTX 4090, 17 października 2026.
Sprawdzone 17 października 2026.

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Artykuły · Cloudflare Tunnel i Ollama: lokalny model AI w sieci bez portówQuick Tunnel z Cloudflare wystawia lokalną Ollamę pod adresem HTTPS jednym poleceniem. Pokazuję pułapkę z błędem 403, którą sprawdziłem u siebie, i...
 Artykuły · basal lokalnie: Ollama, llama.cpp i Mac. Uruchomiłem polski model decyzyjny na RTX 4090Krok po kroku: basal-omni-1.0-mini w GGUF przez Ollamę na Windowsie, warianty dla llama.cpp i Maca. Mój test na 50 polskich zgłoszeniach obok Jeva i...
 Artykuły · Najlepszy lokalny model AI po polsku: test 10 modeli na 8-24 GB VRAMKtóry lokalny LLM najlepiej radzi sobie z polskim na karcie 8, 12, 16 i 24 GB? Zmierzyłem 10 modeli w Ollamie na RTX 4090: 12 zadań z poprawną...
- przelomowy.plTest 10 modeli AI w zakupach: więcej rozumowania podnosi pewność, nie trafność wyboru
- przewagi.plAgent AI w małej firmie w 2026: co zrobi sam, ile kosztuje (od 14 900 zł netto) i gdzie potrzebny jest człowiek
- generatornia.plŻyczenia świąteczne obrazek: jak zrobić kartkę AI na komunikatory
- jutropis.plKE konsultuje formularz oceny wpływu AI na prawa podstawowe