ACE-Step 1.5 lokalnie: polska piosenka na RTX 4090 - test
ACE-Step 1.5 turbo na RTX 4090: trzy polskie próby (94,0, 94,0 i 98,8% słów), 34-91 s na dwuminutową piosenkę, licencja MIT. Jak uruchomić go w ComfyUI i w Hangarze.
👁 120 przeczytań
- ACE-Step 1.5 zaśpiewał średnio 95,6% polskich słów w trzech próbach (94,0%, 94,0% i 98,8%), co jest najlepszym wynikiem wśród czterech testowanych lokalnych modeli.
- Dwuminutowy utwór na RTX 4090 powstawał w 34-91 sekund, a gdy model był już w pamięci karty, angielska próba zajęła zaledwie 8 sekund.
- Model działa na licencji MIT, która pozwala na użycie komercyjne bez limitów, podczas gdy YuE2 jest tylko do niekomercyjnego użytku, a MiniMax Music 3 wymaga zgody od firm z przychodem powyżej 20 mln USD rocznie.
ACE-Step 1.5 to darmowy model muzyczny na licencji MIT, który na własnej karcie graficznej robi piosenkę z wokalem i tekstem. Polski jest na liście ponad 50 języków, więc 17 października 2026 sprawdziłem go na RTX 4090 tym samym polskim tekstem co YuE2, MiniMax Music 3 i DiffRhythm 2. ACE-Step zaśpiewał średnio 95,6% słów (trzy próby: 94,0, 94,0 i 98,8%), najrówniej z czterech lokalnych modeli, a dwuminutowy utwór powstawał w 34-91 s. Całość lokalnych narzędzi opisuję w przewodniku lokalne AI.
Stan na 17 października 2026
- ACE-Step 1.5 (ACE Studio i StepFun, wagi od stycznia 2026, licencja MIT, także komercyjnie): model dyfuzyjny 2B w wersjach turbo, base i SFT, od 2 kwietnia 2026 także XL (4B).
- Planer (model językowy na bazie Qwen3) w trzech rozmiarach: 0,6B, 1,7B i 4B.
- Wbudowany w ComfyUI: szablon „ACE-Step 1.5” w menu Templates, pliki z repozytorium Comfy-Org.
- Działa też w Hangarze, moim darmowym menedżerze lokalnych modeli (szczegóły niżej).
- Mój test: 17 października 2026, RTX 4090, ComfyUI 0.41, ACE-Step 1.5 turbo z planerem 1.7B, 3 polskie próby i 1 angielska, ocena Whisperem large-v3.
Co to jest ACE-Step 1.5
ACE-Step zamienia opis stylu i tekst piosenki na gotowe nagranie stereo z wokalem. Wersja 1.5 ma dwie części: mały model językowy (planer), który rozpisuje utwór na kody dźwiękowe, i model dyfuzyjny 2B, który z tego planu robi audio. Twórcy deklarują utwory od kilkusekundowych pętli do 10 minut, ponad 50 języków tekstu i pracę na kartach z mniej niż 4 GB pamięci (z odciążaniem). Poza tworzeniem piosenki od zera model robi covery, przerabia fragmenty utworu (repainting) i dokłada podkład do samego wokalu.
Licencja MIT pozwala używać wyników komercyjnie. Wśród otwartych modeli muzycznych to rzadkość: YuE2 jest tylko do użytku niekomercyjnego, a MiniMax Music 3 ma własną licencję z warunkami dla firm.
Najprościej: Hangar
Hangar to moje narzędzie: darmowy menedżer lokalnych modeli obrazu, wideo i muzyki na Windows, bez konta i bez abonamentu. Pod spodem działa ComfyUI. ACE-Step 1.5 Turbo jest w katalogu i generuje w nim piosenki.
- Pobierz instalator (14 MB) ze strony Hangar. Wymagania: Windows 10 lub 11 64-bit, karta Nvidia z CUDA od 8 GB pamięci (najlepiej 12 GB i więcej). Instalator nie jest jeszcze podpisany cyfrowo, więc Windows SmartScreen pokaże ostrzeżenie: kliknij „Więcej informacji”, potem „Uruchom mimo to”.
- Hangar wykrywa kartę i pokazuje, czy dany model się w niej zmieści. Może zainstalować ComfyUI od zera (u mnie trwało to 231 s) albo podpiąć ComfyUI, który już masz.
- Wybierz z katalogu ACE-Step 1.5 Turbo. Hangar pobiera pliki z Hugging Face i sprawdza ich sumy sha256. Przy każdym modelu widać licencję i to, czy wolno go używać w UE.
- Wpisz opis stylu i tekst piosenki, kliknij generuj. W moim teście 17 października 20-sekundowy utwór powstał w 32 s razem z ładowaniem modelu.
Ręcznie: ACE-Step w ComfyUI krok po kroku
- Zainstaluj ComfyUI (poradnik: ComfyUI od zera).
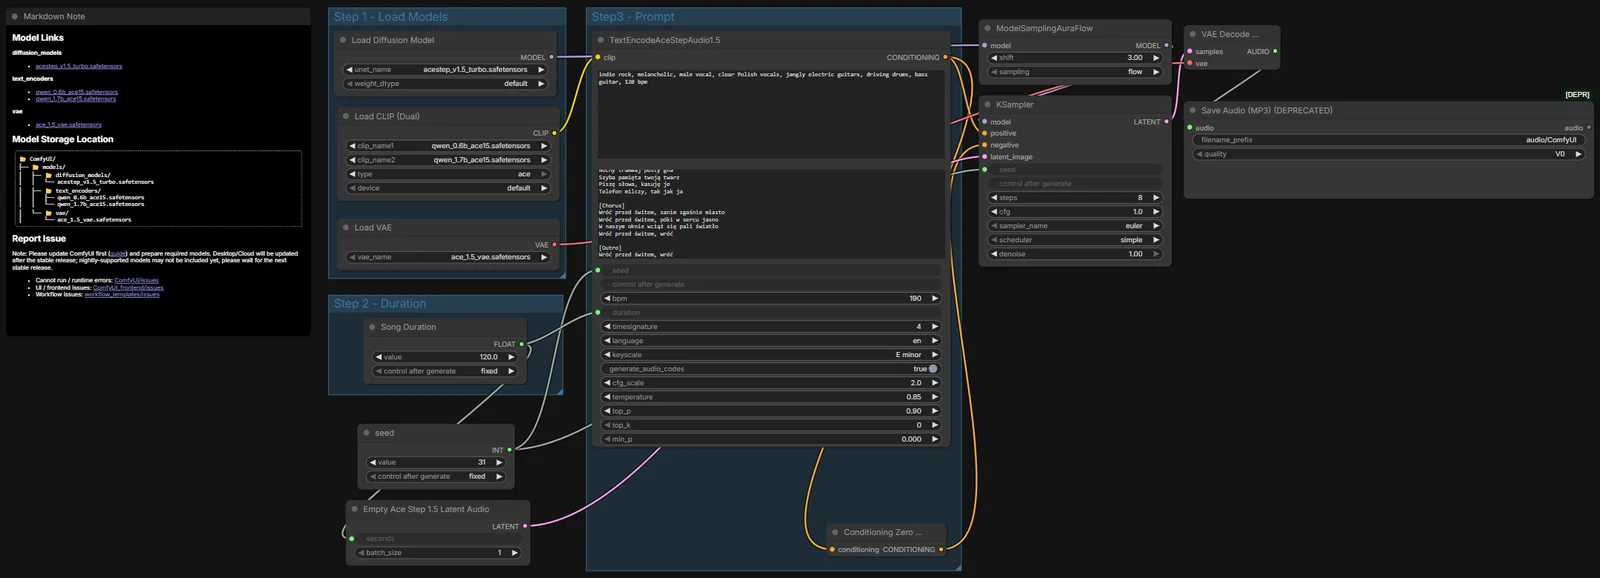
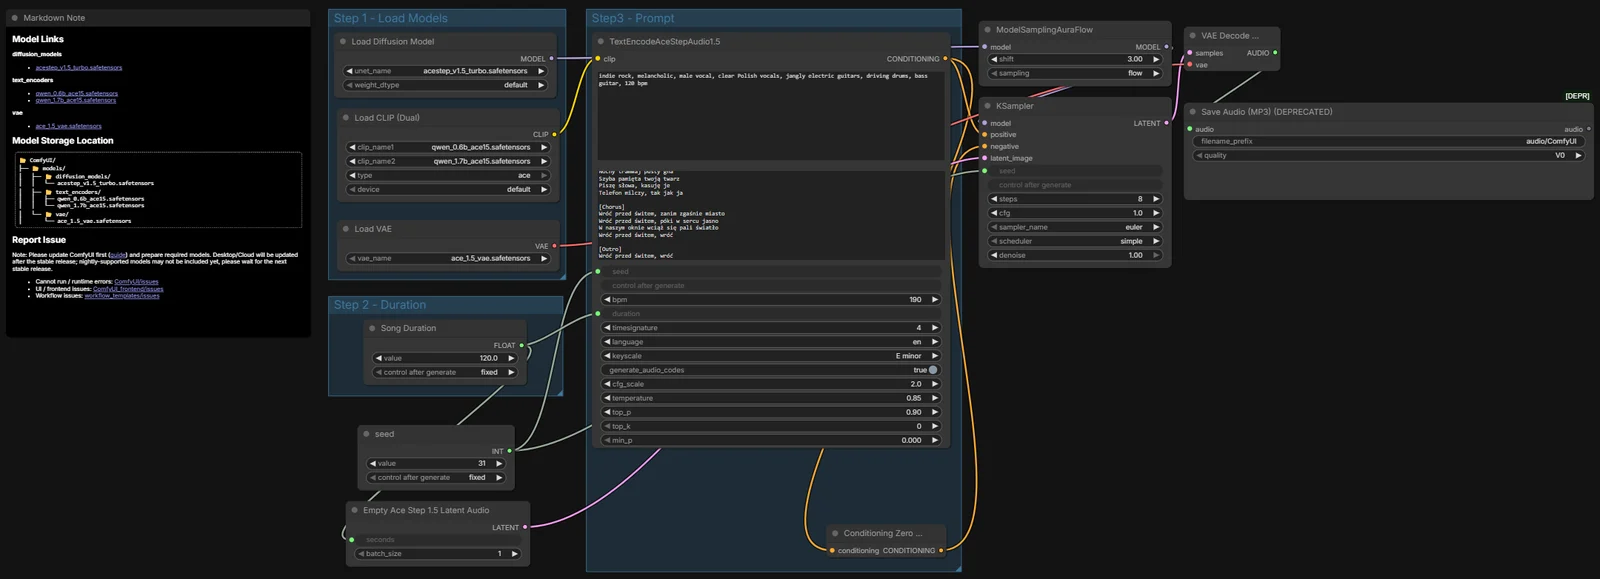
- W menu Templates wpisz „ACE-Step 1.5” i wybierz szablon z rozdzielonymi plikami (split).
- Pobierz cztery pliki z repozytorium Comfy-Org/ace_step_1.5_ComfyUI_files:
acestep_v1.5_turbo.safetensors(4,8 GB) domodels/diffusion_models,qwen_0.6b_ace15.safetensors(1,2 GB) iqwen_1.7b_ace15.safetensors(3,7 GB) domodels/text_encoders,ace_1.5_vae.safetensors(0,3 GB) domodels/vae. Razem 10 GB. - W bloku TextEncodeAceStepAudio1.5 wpisz opis stylu (tags), tekst z sekcjami [verse] i [chorus], tempo, tonację i długość. Ustaw language na pl, bo domyślnie jest en.
- Długość ustaw w bloku tekstowym (duration) i w EmptyAceStep1.5LatentAudio (seconds). W szablonie oba pola są spięte jednym węzłem „Song Duration”.
- Kliknij Run. Plik audio trafi do
ComfyUI/output/audio.
Wersja XL (4B) daje według twórców lepszą jakość, ale sam plik modelu turbo XL w bf16 waży 10 GB, a planer 4B kolejne 8,4 GB. Na karcie 24 GB to wciąż realne, na 12 GB już nie bez odciążania. XL nie testowałem.
Mój test: polska piosenka na RTX 4090
Tekst: dwie zwrotki i refren o deszczu nad Wisłą i jazzie na Pradze, 83 słowa. Styl: „Polish pop ballad, warm female vocals, piano and soft synth pads”. Ustawienia: turbo, 8 kroków, planer 1.7B, language pl, 120 s. Ten sam tekst i styl dostały trzy inne lokalne modele. Każde nagranie przepisał Whisper large-v3, a ja policzyłem, jaki odsetek słów tekstu da się w transkrypcji odnaleźć. Czas to całość od wysłania zadania do gotowego pliku, razem z ładowaniem modeli, a pamięć to szczyt dla całej karty.
| Próba | Słowa zaśpiewane | Czas | Pamięć karty |
|---|---|---|---|
| PL, ziarno 11 | 94,0% (78/83) | 35,2 s | 20,0 GB |
| PL, ziarno 22 | 94,0% (78/83) | 91,4 s | 14,0 GB |
| PL, ziarno 33 | 98,8% (82/83) | 34,1 s | 10,7 GB |
| EN, synthpop | 96,1% (73/76) | 8,0 s | 15,2 GB |
Wnioski z odsłuchu i transkrypcji:
- Polski jest wyraźny i powtarzalny. Wszystkie trzy próby zmieściły się w przedziale 94-99%, bez dziur i bez wymyślonych słów w środku zwrotki.
- Błędy dotyczą pojedynczych głosek. „Na Pradze” wyszło jako „na pracy” albo „na prace”, „szarą mgłę” jako „szarą głęb”, a w jednej próbie „zostań” brzmiało jak „zostaj”. Nazwy miejsc to najsłabszy punkt.
- Czas zależy głównie od ładowania. Angielska próba, gdy model był już w pamięci, zajęła 8 s na dwie minuty muzyki. 91,4 s przy ziarnie 22 to efekt przełączania ComfyUI między modelami, a nie wolniejszej generacji.
- Długość trzyma się ustawienia. ACE-Step dostaje czas utworu z góry i oddaje pełne 2:00. MiniMax Music 3 w tym samym teście ucinał piosenkę po 73-111 s.
Posłuchaj
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Ten sam polski tekst, dwie próby z różnym ziarnem, plus wersja angielska. Nagrania bez obróbki, prosto z ComfyUI.
ACE-Step na tle innych lokalnych modeli
Pełne porównanie z nagraniami wszystkich czterech modeli opisałem w tekście o YuE2. W skrócie (polski tekst, 3 próby, 17 października 2026):
| Model | Polski (średnio) | Licencja | Komercyjnie |
|---|---|---|---|
| ACE-Step 1.5 turbo | 95,6% | MIT | tak |
| YuE2 (3B) | 91,2% | CC BY-NC 4.0 | nie |
| MiniMax Music 3 | 89,2%, ucina utwór | MiniMax-Music3 Community | tak, z warunkami |
| DiffRhythm 2 | 4,8% (1 próba) | Apache 2.0 | tak, ale bez polskiego |
YuE2 miał najlepszą pojedynczą próbę, ale też najsłabszą (84,3%), więc trzeba generować kilka wersji i wybierać. MiniMax Music 3 zajmował całą kartę 24 GB i wtedy wyraźnie zwalniał. Licencja MiniMax Music 3 pozwala na użycie komercyjne pod warunkiem pokazania nazwy modelu w produkcie, a firmy z przychodem powyżej 20 mln USD rocznie potrzebują osobnej zgody (szczegóły: MiniMax Music). Do samych podkładów bez wokalu lepiej sprawdzi się Stable Audio 3 na licencji Stability Community (za darmo do 1 mln USD przychodu rocznie).
Lokalnie czy Suno
Usługi w chmurze wciąż brzmią pełniej: lepszy miks, bardziej ludzki wokal i dłuższe, lepiej zbudowane utwory. Ranking chmurowych generatorów z odsłuchem znajdziesz w zestawieniu ranking generatorów muzyki AI, a samą usługę opisałem w przewodniku Suno.
- ACE-Step wybierz, gdy: robisz dużo krótkich form (dżingle, podkłady do rolek, szkice melodii), chcesz pracować offline, potrzebujesz licencji MIT bez limitów pobrań albo chcesz generować seriami i wybierać najlepsze wersje.
- Chmurę wybierz, gdy: piosenka ma iść do publikacji i liczy się brzmienie radiowe, a utworów jest kilka w miesiącu.
Dla kogo jest ACE-Step 1.5
- Twórcy rolek i podcastów, którzy potrzebują dużo krótkiej muzyki z prawem do użycia komercyjnego.
- Osoby piszące teksty piosenek, które chcą szybko usłyszeć szkic melodii po polsku.
- Posiadacze karty Nvidii z 12-24 GB pamięci. Na słabszych kartach zostaje odciążanie do RAM i dłuższe czekanie.
Najczęstsze pytania
Czy ACE-Step śpiewa po polsku?
Tak. W moim teście 17 października 2026 trzy polskie próby dały 94,0, 94,0 i 98,8% zrozumiałych słów, średnio 95,6%. To najlepszy wynik wśród czterech lokalnych modeli, które sprawdziłem. Warunek: ustaw language na pl, bo domyślnie model śpiewa z angielską wymową.
Ile VRAM potrzebuje ACE-Step 1.5?
Na RTX 4090 szczyt zajętej pamięci całej karty wynosił od 10,7 do 20,0 GB (ComfyUI trzymał w niej przy okazji inne modele). Twórcy podają w repozytorium progi: do 6 GB pamięci model 2B turbo bez planera, z kwantyzacją int8 i odciążaniem; 8-16 GB to turbo lub SFT z planerem 0,6B-1,7B; wersja XL bez odciążania potrzebuje 20-24 GB. Hangar wymaga karty od 8 GB.
Czym różni się ACE-Step 1.5 turbo od base i SFT?
Według twórców turbo generuje w 8 krokach i jest nastawiony na szybkość, a base i SFT pracują na 50 krokach i dają wyższą jakość kosztem czasu. SFT to wersja dodatkowo dostrojona pod jakość. Testowałem tylko turbo, bo przy 8 krokach dwie minuty muzyki powstają w kilka sekund, a to najlepiej pokazuje sens lokalnej pracy.
Czy muzykę z ACE-Step można wykorzystać komercyjnie?
Licencja MIT na model na to pozwala. Platformy streamingowe (Spotify, YouTube Music) mają jednak własne zasady dla muzyki z AI, a utwór wygenerowany w całości przez maszynę może nie podlegać ochronie prawa autorskiego. Własny tekst piosenki pozostaje Twoim utworem.
Czy ACE-Step działa bez karty graficznej?
Według repozytorium twórców tak, ale wolniej. Oficjalny pakiet obsługuje też Maki (MPS), karty AMD (ROCm) i Intel (XPU), a na kartach do 6 GB włącza kwantyzację int8 i pełne odciążanie do procesora. Na samym procesorze nie mierzyłem, więc nie podaję czasu. Szablon w ComfyUI i Hangar zakładają kartę Nvidii.
Jak napisać tekst piosenki, żeby model go zaśpiewał?
Krótkie wersy o podobnej liczbie sylab, sekcje [verse] i [chorus] w osobnych liniach, mało zbitek spółgłosek i nazw własnych (w moim teście właśnie „na Pradze” sprawiało kłopot).
Źródła i data sprawdzenia
- ACE-Step 1.5 na GitHubie (licencja MIT).
- Karta modelu ACE-Step/Ace-Step1.5 na Hugging Face.
- Pliki dla ComfyUI: Comfy-Org/ace_step_1.5_ComfyUI_files.
- MiniMaxAI/MiniMax-Music3 i plik LICENSE (MiniMax-Music3 Community License).
- m-a-p/YuE2-3B (CC BY-NC 4.0).
- Pomiary: moje, 17 października 2026, RTX 4090, ComfyUI 0.41, ocena: Whisper large-v3; test w Hangarze: 17 października 2026.
Sprawdzone 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym