Wiedza w cenie - ile naprawdę kosztuje nauczenie małego modelu przez duży
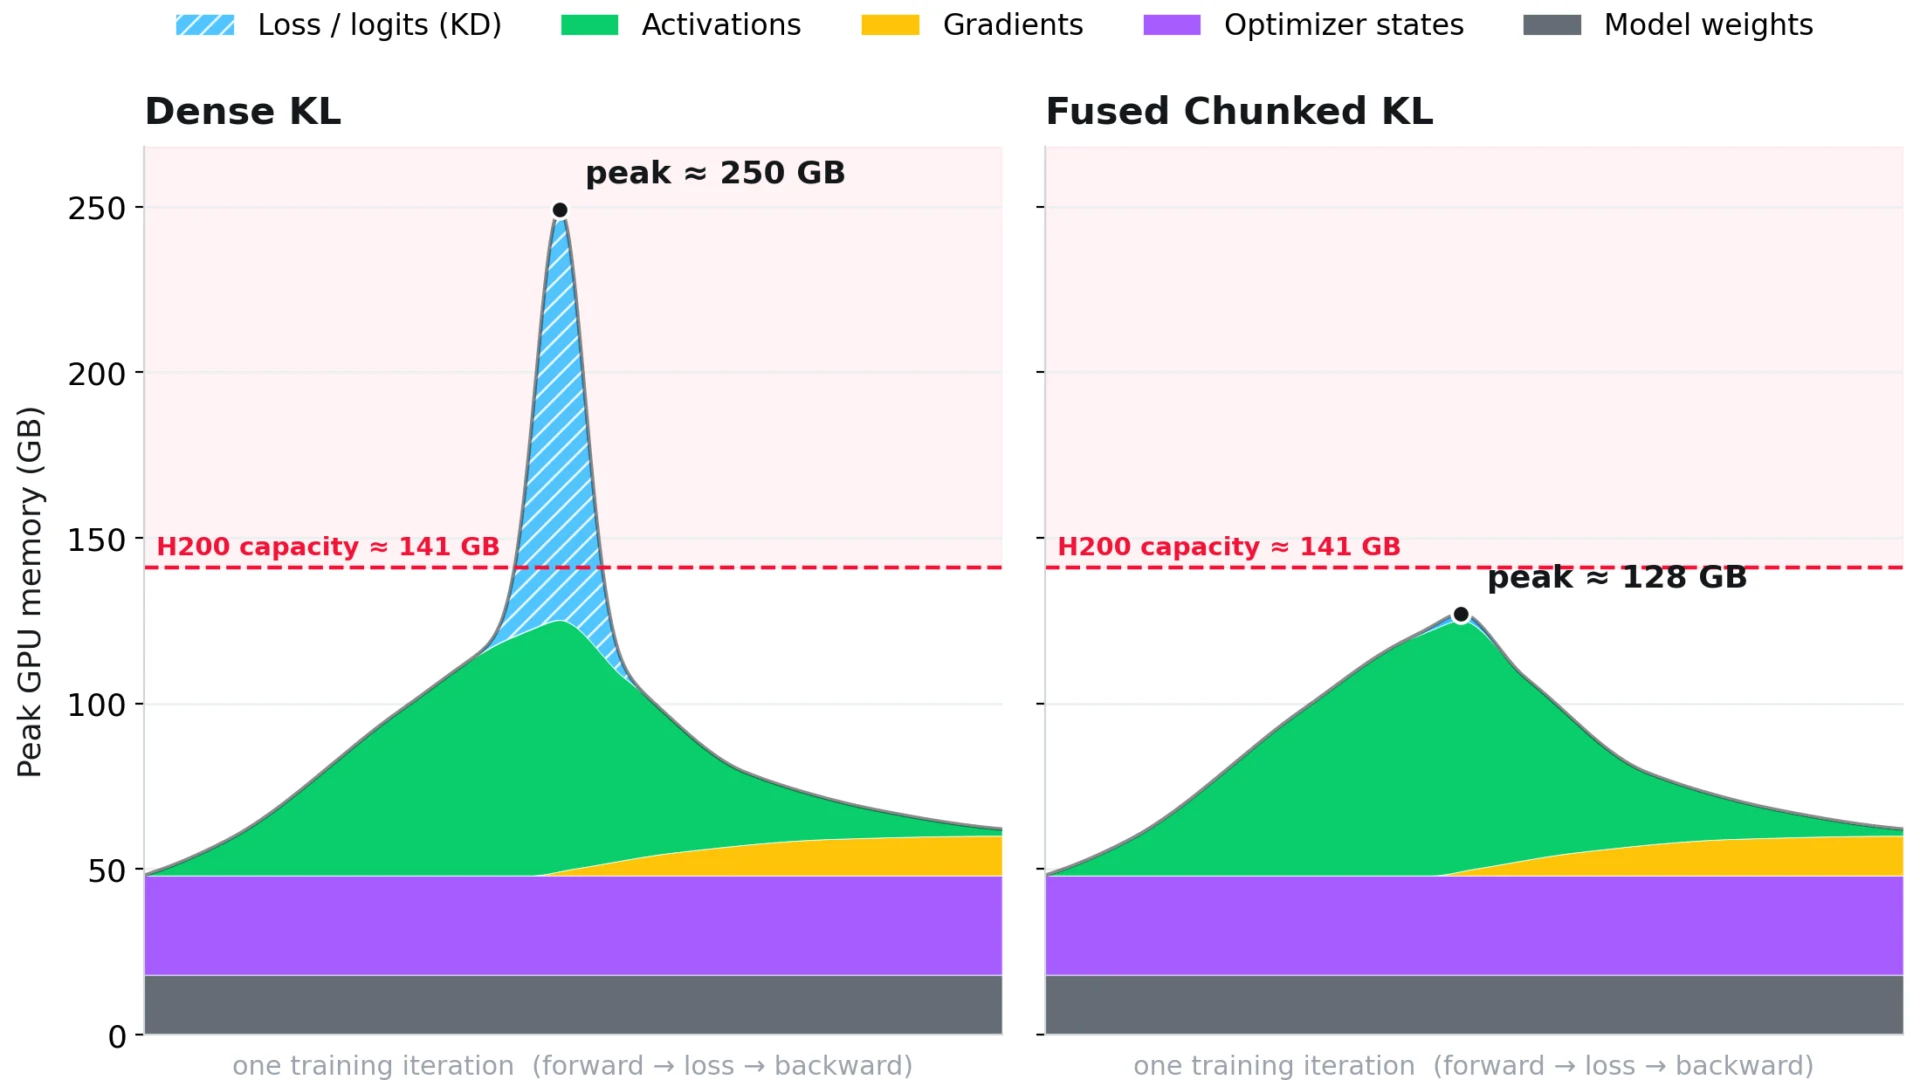
Knowledge distillation - technika przenoszenia wiedzy z dużych modeli AI do mniejszych - wciąż pozostaje zbyt droga, by stosować ją naprawdę masowo, i to właśnie ten problem próbuje rozwiązać nowa praca opublikowana przez MultiverseComputing na Hugging Face.
👁 136 przeczytań
Jest takie założenie w branży AI, które brzmi rozsądnie, dopóki nie zderzy się z rachunkiem za chmurę: że małe modele mogą być prawie tak dobre jak duże, jeśli tylko nauczą się od tych dużych. Technika nazywa się knowledge distillation - destylacja wiedzy - i w teorii jest elegancka. W praktyce okazuje się, że samo „uczenie się od nauczyciela” potrafi być równie kosztowne jak wychowanie własnego ucznia od zera.
Nauczyciel, który kosztuje majątek
Destylacja wiedzy to proces, w którym mały model - „uczeń” - trenuje się nie na surowych danych, lecz na rozkładach prawdopodobieństwa generowanych przez duży model - „nauczyciela”. Zamiast uczyć się, że odpowiedzią na dane pytanie jest słowo „kot”, uczeń uczy się, że nauczyciel widzi tu 73% szans na „kot”, 18% na „pies” i 4% na „zwierzę”. Ta miękka wiedza o strukturze przestrzeni odpowiedzi jest znacznie cenniejsza niż twarde etykiety.
Problem w tym, że by tę wiedzę przekazać w skali, trzeba przepuścić przez nauczyciela - model liczący dziesiątki miliardów parametrów - każdy przykład treningowy. Przy zbiorach danych liczących miliardy tokenów robi się z tego przedsięwzięcie, które finansowo przypomina bardziej budowę elektrociepłowni niż fine-tuning weekendowy projekt.
MultiverseComputing, firma specjalizująca się w obliczeniach dla sektora finansowego i przemysłowego, opublikowała na Hugging Face pracę próbującą rozbić ten węzeł gordyjski. Model nauczyciel w ich podejściu waży 59 miliardów parametrów - to kategoria, w której inferencing sam w sobie nie jest tani.
Skala jako wróg doskonałości
Tu dochodzimy do sedna problemu, który branża konsekwentnie zamiatała pod dywan: destylacja wiedzy była przez lata przedstawiana jako sposób na demokratyzację AI. Małe firmy miały trenować małe modele uczone przez modele duże - i cieszyć się jakością bez kosztów. Tyle że nikomu nie chciało się głośno powiedzieć, że dostęp do nauczyciela też kosztuje.
W praktyce oznacza to, że technika, która miała być furtką dla mniejszych graczy, często pozostaje zarezerwowana dla tych, którzy i tak mogliby sobie pozwolić na trening od zera. To trochę jak demokratyzacja edukacji przez prywatne korepetycje u najdroższego tutora w mieście.
Efektywna destylacja - taka, która redukuje liczbę wywołań nauczyciela, inteligentnie próbkuje dane albo aproksymuje jego rozkłady zamiast obliczać je wprost - staje się więc nie kwestią akademickiej elegancji, lecz ekonomicznej konieczności.
Co naprawdę znaczy „wystarczająco tanie”
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Praca MultiverseComputing dotyka pytania, które rzadko pojawia się w nagłówkach: jaki jest próg opłacalności destylacji? Kiedy warto uczyć ucznia od mądrego nauczyciela, a kiedy taniej i szybciej wychować go samodzielnie na surowych danych?
To pytanie nie jest czysto akademickie. Każda firma rozważająca wdrożenie własnego modelu językowego staje przed nim prędzej czy później. Duże modele fundacyjne są coraz łatwiej dostępne przez API, co oznacza, że „nauczyciel” jest w zasięgu ręki - ale każde wywołanie kosztuje, a przy milionach przykładów treningowych koszty rosną nieliniowo.
Podejście opisane w pracy celuje właśnie w tę szczelinę: wycisnąć maksimum z nauczyciela przy minimalnym budżecie obliczeniowym. To inżynieria kompromisu - sztuka, którą sektor AI zaczyna doceniać dopiero teraz, gdy pierwsza euforia skalowania ustępuje miejsca pytaniom o rentowność.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Destylacja jako nowa normalność
Jest jeszcze jeden wymiar tej historii, który wydaje mi się niedoceniany. Destylacja wiedzy, jeśli stanie się rzeczywiście tania i skalowalna, zmienia nie tylko ekonomię trenowania modeli - zmienia logikę całego ekosystemu. Zamiast wyścigu o największy model, możemy wejść w erę wyścigu o najefektywniejszy transfer wiedzy.
To oznaczałoby, że wartość dużych modeli fundacyjnych nie leży wyłącznie w tym, co same potrafią, lecz w tym, jak dobrymi są nauczycielami. GPT-5 albo kolejna wersja Clauda byłyby oceniane nie tylko przez benchmarki, ale przez jakość modeli, które po nich „dziedziczą”.
Taka perspektywa jest ciekawa i trochę wywrotowa zarazem. Przesuwa ciężar z posiadania mocy obliczeniowej na posiadanie wiedzy o tym, jak tę moc efektywnie przekazywać. I stawia MultiverseComputing - firmę, która nie jest OpenAI ani Google - w miejscu, gdzie można coś naprawdę interesującego powiedzieć.
Czy mówi? Na to odpowie już lektura samej pracy.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →
Podobne tematy na Promptowym