Kto prowadzi w AI w październiku 2026: Meta, OpenAI, Anthropic, Google
Kto prowadzi w AI w połowie października 2026: indeks Artificial Analysis, ranking agentów Areny, ceny API i mój test po polsku w tabelach.
👁 118 przeczytań
- Anthropic prowadzi w październiku 2026: Claude Opus 5.5 ma 58 pkt w indeksie Artificial Analysis, zajmuje 1. i 2. miejsce w rankingu agentów Areny i zdobył 90,1 pkt w teście po polsku.
- Najtańsze modele z czołówki to Claude Sonnet 5.5 i GPT-6.1 Sol w cenie 2 USD za milion tokenów wejściowych i 10 USD za wyjściowe.
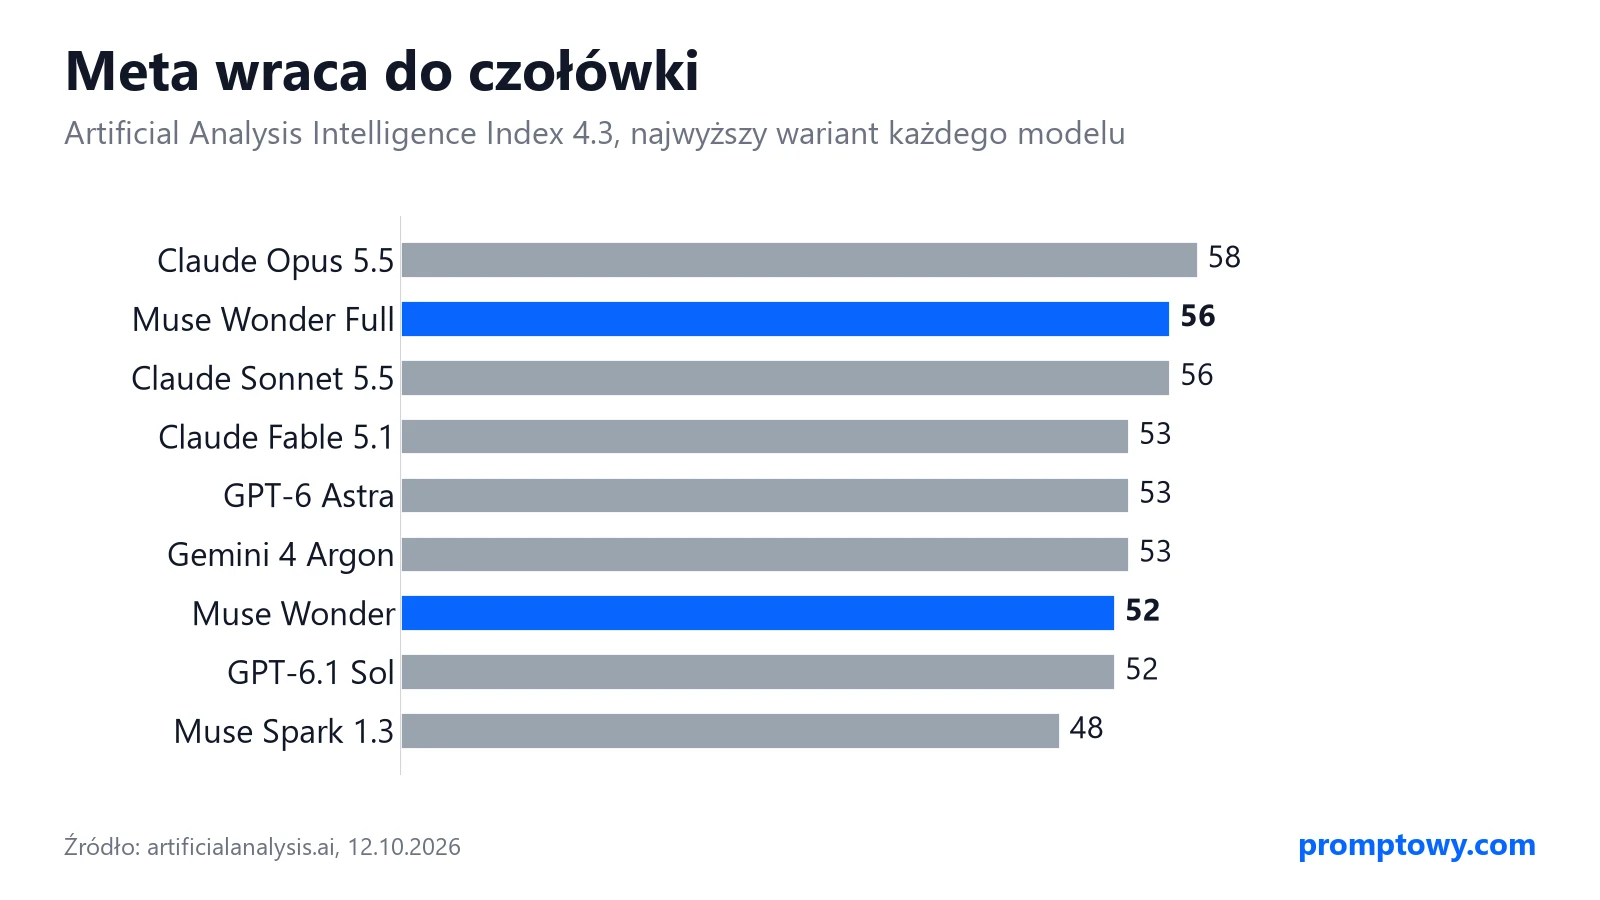
W połowie października 2026 na szczycie nadal jest Anthropic: Claude Opus 5.5 prowadzi w niezależnym indeksie Artificial Analysis (58 pkt) i w rankingu agentów Areny. Meta z Muse Wonder Full (56 pkt) wskoczyła na podium obok Claude Sonnet 5.5, a OpenAI i Google mają po 53 pkt. Ale „kto prowadzi” zależy od pytania: inna jest odpowiedź dla jakości, inna dla ceny, a jeszcze inna dla tego, czym możesz się posłużyć w Polsce. Poniżej wszystko w tabelach. O nowym modelu Mety piszę w przewodniku Muse Wonder.
Stan na 12 października 2026
- Jakość (indeks AA): 1. Anthropic (Opus 5.5, 58), 2. Meta i Anthropic (Wonder Full i Sonnet 5.5, po 56), potem OpenAI i Google (po 53).
- Agenci (Arena): Opus 5.5 na 1. i 2. miejscu, GPT-6 Astra 3., Muse Wondera jeszcze nie ma.
- Po polsku (mój test): Opus 5.5 90,1, Muse Wonder 87,0, GPT-6 Sol 86,4.
Cztery firmy, najlepsze modele
| Firma | Najmocniejszy model | Indeks AA 4.3 | Cena API USD za 1 mln (wejście / wyjście) | Aplikacja w Polsce |
|---|---|---|---|---|
| Anthropic | Claude Opus 5.5 | 58 | 4 / 20 | Claude.ai |
| Meta | Muse Wonder Full | 56 | brak API (Muse Code od 50 USD/mies.) | brak |
| Anthropic | Claude Sonnet 5.5 | 56 | 2 / 10 | Claude.ai |
| Anthropic | Claude Fable 5.1 | 53 | 10 / 50 | Claude.ai |
| OpenAI | GPT-6 Astra | 53 | 10 / 50 | ChatGPT |
| Gemini 4 Argon | 53 | 2 / 10 na start, potem 4 / 20 (zapowiedź) | dostęp ograniczony | |
| Meta | Muse Wonder | 52 | 4 / 20 | brak |
| OpenAI | GPT-6.1 Sol | 52 | 2 / 10 | ChatGPT |
Indeks: Artificial Analysis, najwyższy wariant każdego modelu, odczyt 12.10.2026. Ceny z cenników producentów i OpenRoutera. Gemini 4 Argon: cena zapowiedziana przez Google 30 września, szeroki dostęp do API nadal niepotwierdzony - szczegóły w przewodniku Gemini 4 Argon.
Agenci: ranking Areny
Arena (dawniej LMArena) prowadzi osobny ranking agentów, w którym ludzie oceniają, jak model radzi sobie z zadaniami. Pierwsza dziesiątka 12 października:
- Claude Opus 5.5 (max)
- Claude Opus 5.5 (high)
- GPT-6 Astra (max)
- Claude Fable 5.1 (max)
- Claude Sonnet 5.5 (max)
- GPT-6.1 Sol (max)
- GPT-6 Sol (max)
- Gemini 4 Argon (high)
- Claude Fable 5 (high)
- Claude Opus 5 (max)
Muse Wondera w rankingu jeszcze nie ma - pojawi się, gdy zbierze wystarczająco dużo głosów. Jak czytać takie rankingi, wyjaśniam w tekście LMArena. Meta w swojej tabeli twierdzi, że Wonder Full prowadzi w zadaniach agentowych (Personal Superintelligence Index 59,1 wobec 55,2 Opusa), ale to wewnętrzny test Mety - Arena będzie pierwszą niezależną weryfikacją.
Po polsku: mój ranking
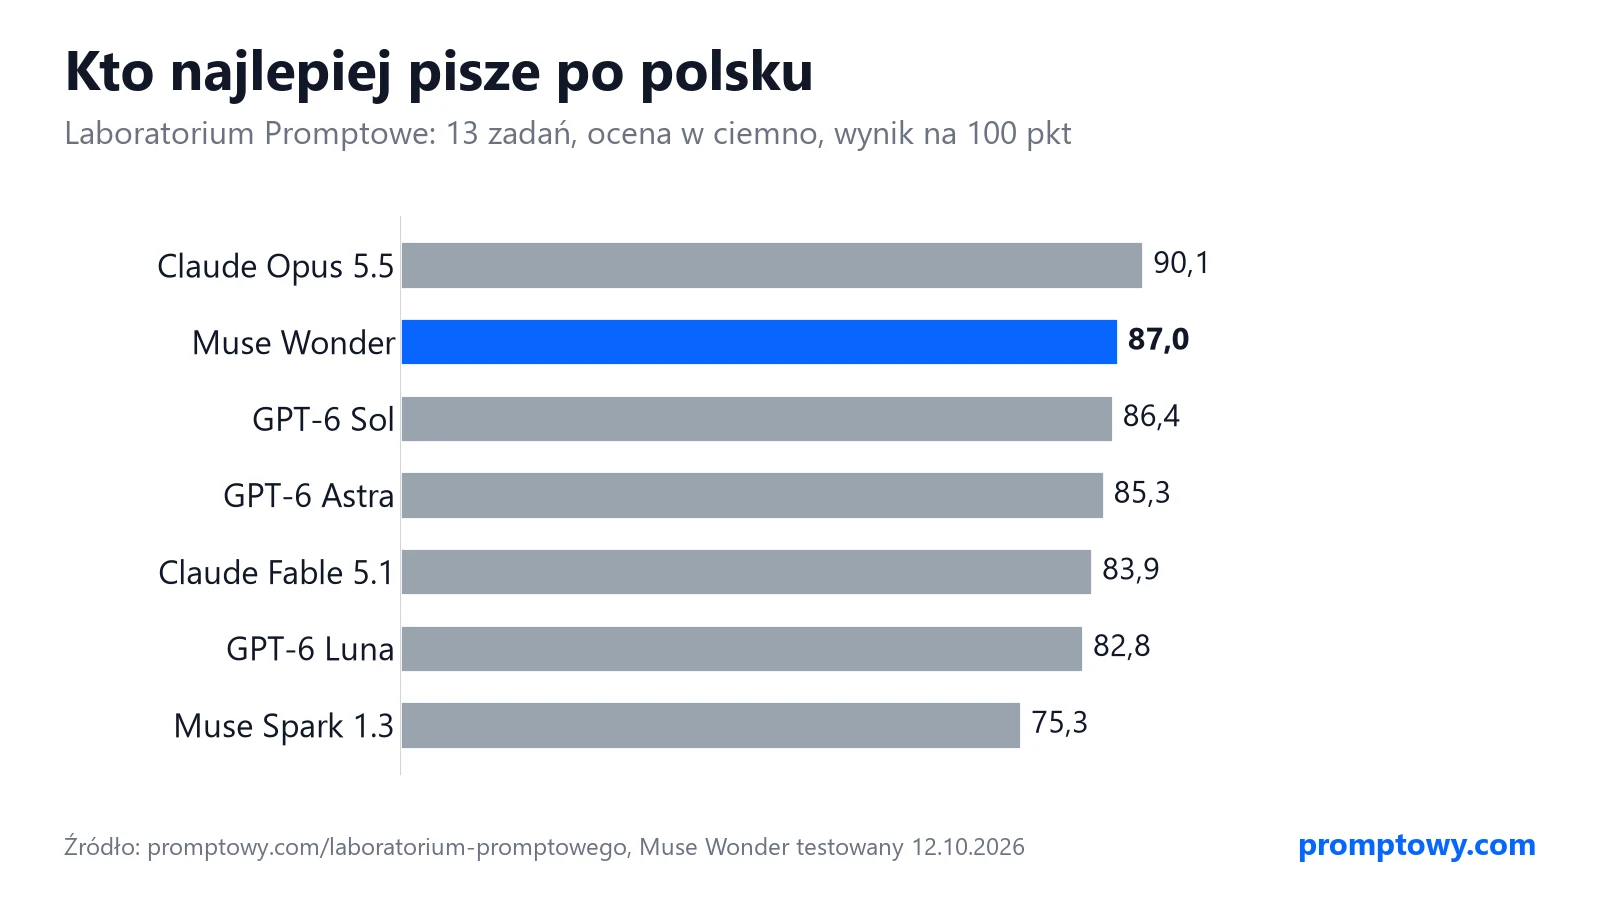
W moim teście pisania po polsku kolejność jest podobna: Opus 5.5 przed Muse Wonder, dalej modele OpenAI i Fable 5.1. Pełny ranking jest w rankingu AI do pisania po polsku.
Cena za token to nie cena za zadanie
Muse Wonder i Claude Opus 5.5 kosztują tyle samo za token, a jednak w moim teście 23 zadań Opus wyszedł o 18% drożej. Powód: tokenizer Claude’a liczy polski tekst prawie dwa razy drożej - ten sam dokument to 87 675 tokenów u Anthropic i 46 929 u Mety. Z drugiej strony Artificial Analysis szacuje koszt zadania w swoim indeksie na 5,98 USD dla Opusa 5.5 i 3,26 USD dla GPT-6 Astra, choć Astra jest 2,5 raza droższa za token - bo zużywa mniej tokenów. Wniosek: porównuj koszt na swoich zadaniach, nie w cenniku.
| Model | Mój test, 23 zadania | Wynik |
|---|---|---|
| Gemini 3.8 Flash | 0,09 USD | 99,5% |
| Muse Wonder | 0,64 USD | 99,7% |
| Claude Opus 5.5 | 0,75 USD | 99,4% |
| GPT-6 Astra | 1,12 USD | 100% |
| Claude Fable 5.1 | 1,71 USD | 99,4% |
Szczegóły: Muse Wonder vs Opus 5.5 vs GPT-6 Astra - mój test na 23 zadaniach.
Kto prowadzi - zależnie od pytania
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Najlepszy model ogółem: Anthropic, Claude Opus 5.5 - prowadzi w AA, w Arenie i w moim teście po polsku.
- Największy skok w październiku: Meta - z 48 pkt (Muse Spark 1.3, 2 września) na 56 (Wonder Full, 12 października) w sześć tygodni.
- Najlepszy stosunek ceny do jakości: Claude Sonnet 5.5 i GPT-6.1 Sol (2 / 10 USD), a do prostych zadań Gemini 3.8 Flash.
- Najszerzej dostępny w Polsce: OpenAI i Anthropic - ChatGPT i Claude.ai działają u nas w pełni. Muse Wonder tylko przez API, Argon z ograniczeniami.
To moja ocena na 12 października 2026. W tym tempie za miesiąc ta tabela może wyglądać inaczej - na bieżąco śledzę to w kalendarzu AI.
Najczęstsze pytania
Jaki jest najlepszy model AI w październiku 2026?
Claude Opus 5.5: 58 pkt w indeksie Artificial Analysis, 1. miejsce w rankingu agentów Areny i 90,1 pkt w moim teście po polsku.
Czy Meta dogoniła OpenAI i Google?
W indeksie AA tak: Muse Wonder Full ma 56 pkt, GPT-6 Astra i Gemini 4 Argon po 53. Ale Wonder Full nie jest dostępny w API, a zwykły Wonder ma 52.
Który model AI jest najtańszy z czołówki?
Claude Sonnet 5.5 i GPT-6.1 Sol po 2 / 10 USD za milion tokenów, przy 56 i 52 pkt w indeksie AA.
Źródła
- Artificial Analysis: ranking modeli (12.10.2026)
- Artificial Analysis: Claude Opus 5.5
- Artificial Analysis: GPT-6 Astra
- Arena: ranking agentów (12.10.2026)
- Meta Model API: cennik
- OpenAI: cennik API
- Anthropic: cennik Claude
- Google: Gemini 4 Argon (30.09.2026)
- Meta: Muse Wonder (12.10.2026)
- Moje testy: Laboratorium Promptowe i test 23 zadań, 12.10.2026
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym