


Inkling 2 Mini wraca do tych samych warstw. Na start wystarczy Mac z 32 GB pamięci
Thinking Machines udostępnia wagi Inkling 2 Mini. Pokazuję, jak działa potrójna pętla i co na Macu oznacza deklarowane przez producenta minimum 32 GB.
👁 111 przeczytań
Producent modeli AI zwykle ma prosty sposób na pokazanie postępu: ogłasza większy model. Thinking Machines zrobiło coś ciekawszego. W opublikowanym 20 listopada Inkling 2 Mini część obliczeń dla każdego tokenu przechodzi jeszcze raz przez te same warstwy. Wagi można pobrać, a firma na start deklaruje obsługę Maców z co najmniej 32 GB pamięci przez Ollama.
Dwanaście warstw pracuje po trzy razy
Rozpisałem architekturę z karty producenta. Model ma 24 warstwy, podzielone na cztery bloki po sześć. Pierwszy i ostatni blok pracują po jednym razie. Środkowe dwa przechodzą wspólnie trzy przebiegi. Daje to łącznie 48 przejść przez warstwy przy przetwarzaniu tokenu. Część parametrów jest wykorzystywana ponownie, więc plik z wagami nie musi zawierać kopii każdej kolejnej operacji.
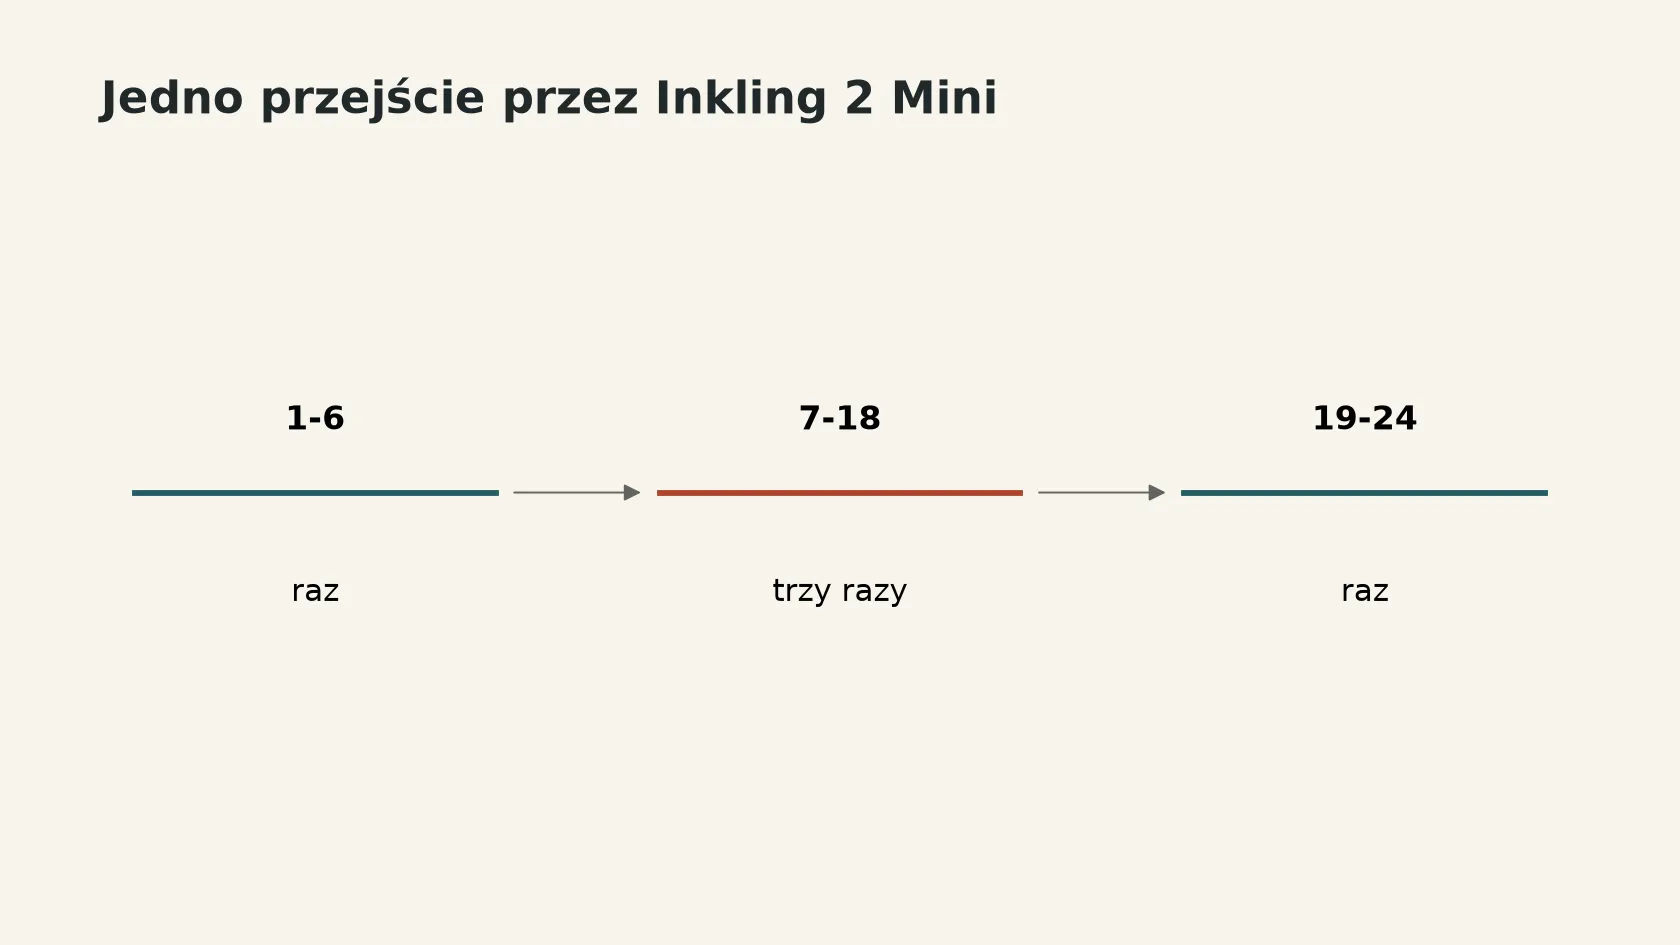
Po co wracać akurat do środka? Zespół porównał ten wariant z powtarzaniem ostatnich dwunastu warstw. Powtarzanie środka przyniosło większą poprawę dokładności w 27 z 28 ocen. To wynik prób konstruktorów dotyczących miejsca pętli. Nie przekłada się na jednakową przewagę w każdym zadaniu użytkownika.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Wagi do pobrania, wynik do sprawdzenia
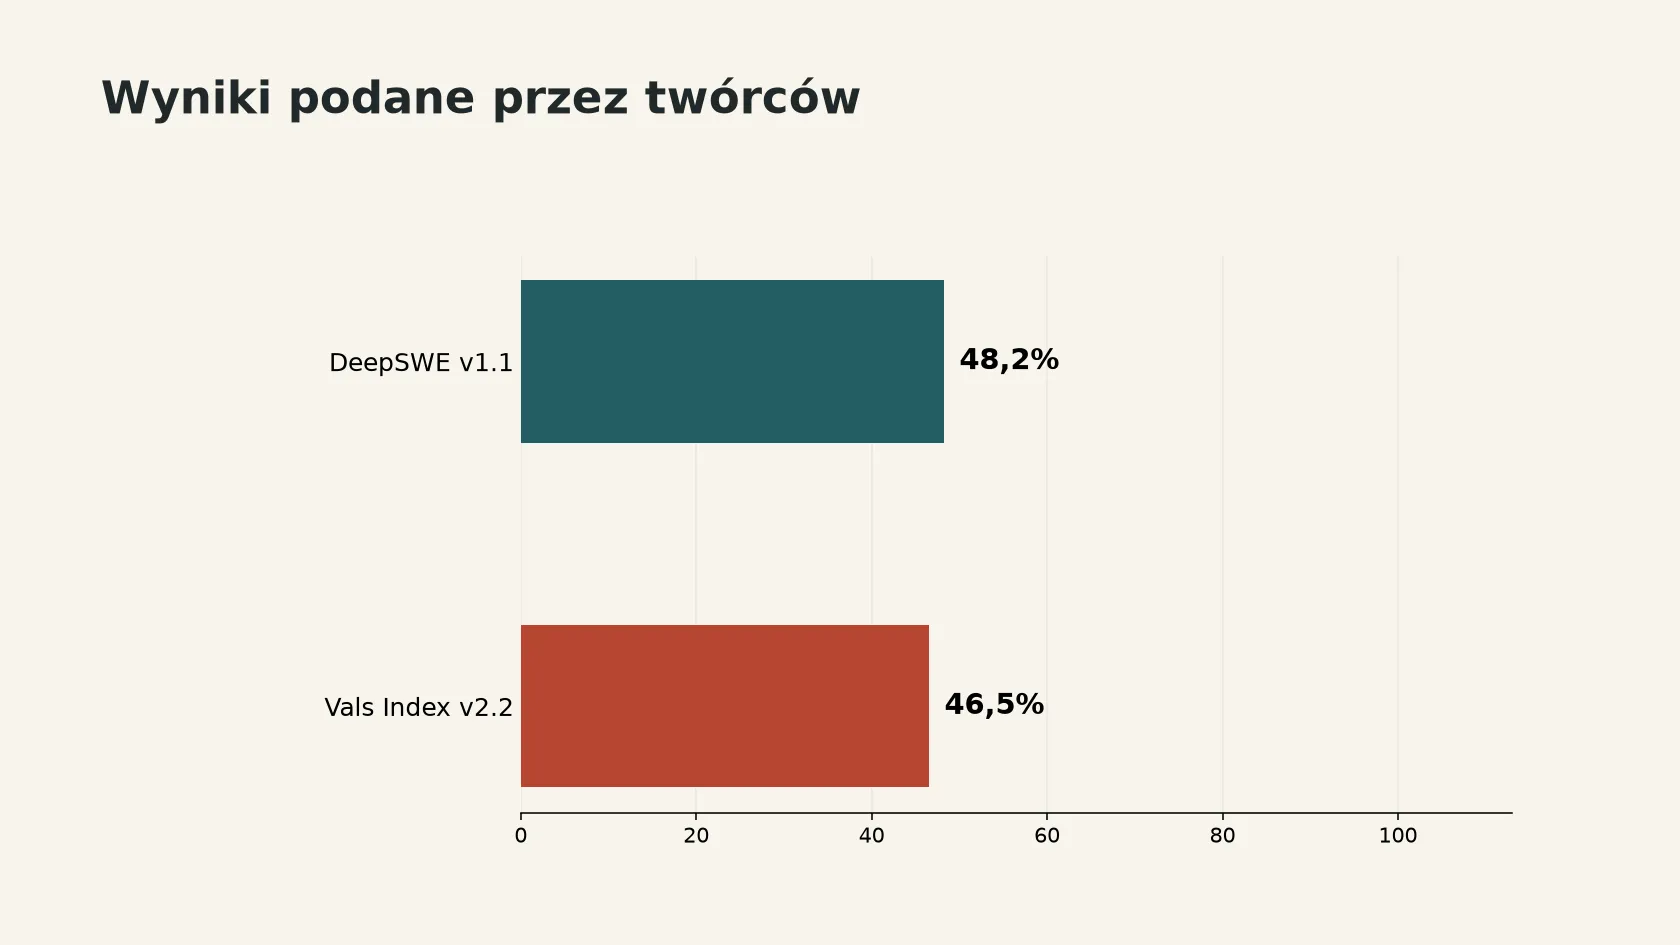
W dwóch przywołanych przez producenta ocenach model osiągnął 48,2% w DeepSWE v1.1 i 46,5% w Vals Index v2.2. Pierwszy wynik opisuje rozwiązywanie zadań programistycznych. Każdy zestaw ma własną procedurę. Warto zachować numer wersji przy porównywaniu z innym modelem.
Repozytorium udostępnia wagi na licencji Apache 2.0. Dla osoby z odpowiednim Makiem oznacza to możliwość samodzielnego porównania wyniku z zadaniem z własnego projektu. Nie podaję szybkości w tokenach na sekundę dla całej rodziny Maców. Sama ilość pamięci nie wyznacza takiej liczby.
Stan na 21.11.2026, godz. 19:33 czasu polskiego.
Źródła

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan
- przewagi.plAutomatyzacja faktur: zacznij od obiegu i wyjątków, potem dodaj AI