Artificial Analysis ocenia modele decyzyjne. Jev 1.13 na czele
Artificial Analysis opublikowało pierwszy ranking modeli decyzyjnych. Jev 1.13 ma 58 pkt, Claude Haiku 5.5 więcej, ale jest 11 razy wolniejszy i 4,4 razy droższy.
👁 121 przeczytań
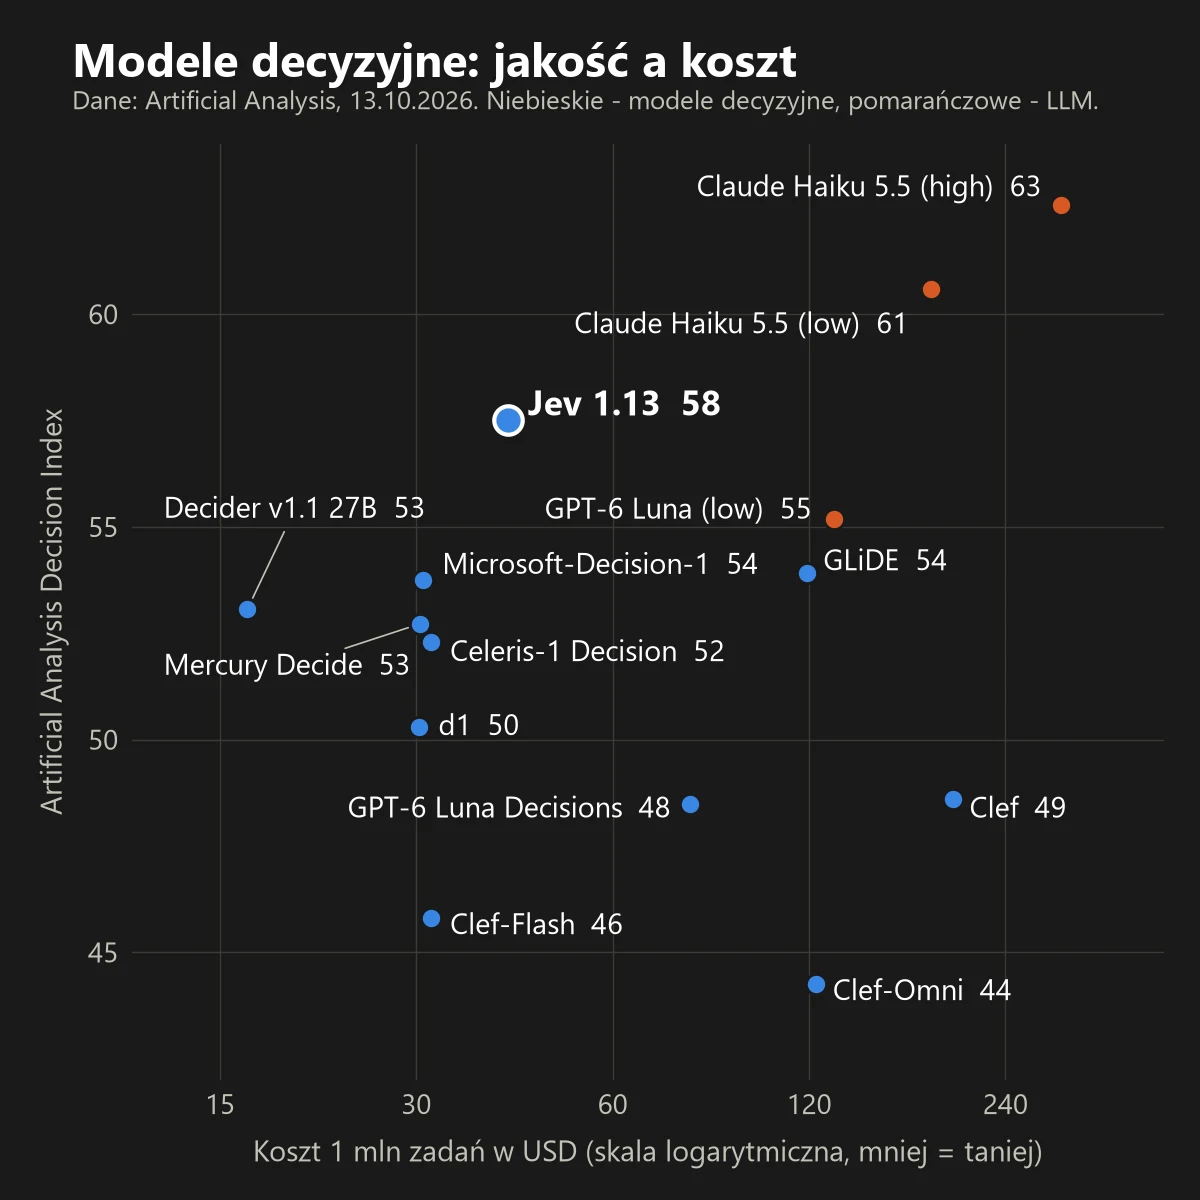
13 października 2026 Artificial Analysis opublikowało Decision Index v1.0, pierwszy niezależny ranking modeli decyzyjnych, czyli modeli AI, które nie piszą tekstu, tylko wybierają odpowiedź z listy i podają prawdopodobieństwo każdej opcji. Prowadzi Jev 1.13 od TypeSafe z wynikiem 58 punktów, przed GLiDE (Fastino) i Microsoft-Decision-1 (po 54). Najtańszy jest Decider v1.1 27B od Perplexity: 17 USD za milion zadań. Zwykły Claude Haiku 5.5 ma wyższy wynik (61), ale według pomiarów AA jest 11 razy wolniejszy i 4,4 razy droższy od lidera.
Najważniejsze liczby (Artificial Analysis, 13.10.2026)
- 11 modeli decyzyjnych w rankingu, w artykule startowym 9 z nich.
- Lider: Jev 1.13 (TypeSafe) - 58 pkt, 42 USD za milion zadań, 0,13 s na zadanie.
- Koszt miliona zadań: od 17 USD (Decider v1.1 27B) do 199 USD (Cloudflare Clef).
- Czas zadania: od 0,06 s (Celeris-1 Decision) do 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low): 61 pkt, 184 USD za milion zadań, 1,4 s na zadanie.
Ujawnienie: model Jev znam z wcześniejszego rozpoznania - we wrześniu napisałem do niego prostego klienta API z myślą o własnych narzędziach redakcyjnych. TypeSafe nie zamawiało ani nie opłaciło tego tekstu, a pozycję Jeva opisuję wyłącznie na podstawie niezależnych pomiarów Artificial Analysis.
Co to jest model decyzyjny
Model decyzyjny dostaje dwie rzeczy: stan (np. treść zgłoszenia klienta) i listę pytań z zamkniętymi odpowiedziami. Zamiast pisać zdanie, zwraca dla każdej dozwolonej opcji prawdopodobieństwo. Artificial Analysis pokazuje to na przykładzie zgłoszenia „wypłaty nie działają od 3 dni, a jutro mam czynsz” i trzech pytań naraz:
- do którego działu - płatności, technika albo konto (wybór z listy),
- czy pilne - tak albo nie,
- jak bardzo zdenerwowany jest klient - spokojny, sfrustrowany, zły (skala).
Model decyzyjny odpowiada na wszystkie trzy w jednym wywołaniu i podaje rozkład prawdopodobieństw. Zwykły LLM musi wygenerować JSON z odpowiedziami, który kod potem parsuje, i nie daje rzetelnej liczby, na ile jest pewny. Szerzej, z moim testem na polskich zgłoszeniach, opisałem to w przewodniku Modele decyzyjne AI.
Ranking: Artificial Analysis Decision Index v1.0
| Model (firma) | Indeks | Koszt 1 mln zadań | Czas zadania |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | 42 USD | 0,13 s |
| GLiDE (Fastino Labs) | 54 | 119 USD | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | 31 USD | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | 17 USD | 0,17 s |
| Mercury Decide (Inception) | 53 | 30 USD | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | 32 USD | 0,06 s |
| d1 (Liquid AI) | 50 | 30 USD | 0,30 s |
| Clef (Cloudflare) | 49 | 199 USD | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | 79 USD | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | 32 USD | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | 123 USD | 0,17 s |
Dla porównania modele językowe w tych samych testach: Claude Haiku 5.5 (low) 61 pkt przy 184 USD i 1,4 s, GPT-6 Luna (low) 55 pkt przy 131 USD i 1,5 s. Czas to mediana na zadanie, koszt to średni koszt zadania według aktualnych cen tokenów pomnożony przez milion. Modele decyzyjne płacą tylko za tokeny wejścia, modele językowe za wejście i wyjście.
Jak liczony jest indeks
Decision Index to średnia ważona czterech testów, każdy po 25%:
- AA-Omniscience-Decision (wiedza i halucynacje) - 500 niepublicznych pytań z pięcioma opcjami: cztery odpowiedzi i „nie wiem”. Połowa wagi to trafność, połowa to odsetek przypadków, w których model zamiast zgadywać wybrał „nie wiem”.
- HLE-MultiChoice (rozumowanie) - 513 tekstowych pytań wielokrotnego wyboru z Humanity’s Last Exam, jednego z najtrudniejszych zestawów dla AI.
- When2Call (narzędzia) - test NVIDII: model widzi rozmowę i listę narzędzi i decyduje, czy odpowiedzieć sam, wywołać narzędzie, dopytać o brakujące dane, czy przyznać, że nie da rady.
- WildGuardTest (klasyfikacja i bezpieczeństwo) - zestaw Ai2: czy prośba użytkownika jest szkodliwa, czy odpowiedź asystenta to odmowa i czy ta odpowiedź jest szkodliwa.
Co pokazały wyniki
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Jev wygrywa rozumowaniem. W HLE-MultiChoice ma 21 pkt, a żaden inny model decyzyjny nie przekracza 15. W wiedzy ma tylko 35% trafności (najlepsze d1 od Liquid AI: 41%).
- Najlepiej mówi „nie wiem” Microsoft-Decision-1 - 40% (Jev 35%, Mercury Decide 32%, reszta poniżej 17%). d1 ma najwyższą trafność w wiedzy, ale prawie nigdy nie przyznaje się do niewiedzy (wynik 2).
- W wyborze narzędzi modele decyzyjne biją LLM-y. W When2Call Celeris-1 Decision i GLiDE mają po 84 pkt, a Claude Haiku 5.5 (low) 73 i GPT-6 Luna (low) 77.
- W klasyfikacji też. W WildGuardTest GLiDE ma 95, Jev i Decider po 94, Claude Haiku 5.5 (low) 93, GPT-6 Luna (low) 89.
- Wszystkie modele decyzyjne są zbyt pewne siebie. AA porównało podawane prawdopodobieństwa z faktyczną trafnością: przy pytaniach o wiedzę i rozumowanie trafność jest niższa niż deklarowana pewność. W klasyfikacji i wyborze narzędzi kalibracja jest według AA „względnie dobra”.
Dlaczego to jest tańsze od LLM-a
Model decyzyjny nie generuje tokenów odpowiedzi. Czyta wejście raz, liczy rozkład dla wszystkich pytań naraz i kończy. Stąd trzy przewagi, które widać w danych AA:
- Płacisz tylko za wejście. Brak tokenów wyjścia i tokenów rozumowania.
- Kilka pytań w jednym wywołaniu zamiast kolejnych pól JSON-a pisanych słowo po słowie.
- Czas liczony w setkach milisekund. 0,06-0,5 s na zadanie wobec 1,4-1,5 s u małych LLM-ów w trybie low.
Różnica rośnie z każdym milionem zadań. Na samej klasyfikacji (WildGuardTest) AA policzyło milion zadań na 12,1 USD dla Decidera i 22,8 USD dla Jeva wobec 91,5 USD dla Claude Haiku 5.5 (low).
Kiedy model decyzyjny się opłaca, a kiedy nie
Opłaca się, gdy odpowiedź jest z zamkniętej listy i decyzji jest dużo:
- klasyfikacja i routing zgłoszeń, maili, dokumentów,
- moderacja komentarzy i wykrywanie szkodliwych próśb,
- wybór narzędzia w agencie i decyzja „wywołać czy dopytać”,
- bramki jakości: przepuścić, poprawić, eskalować do człowieka.
Nie opłaca się, gdy liczy się wiedza o świecie albo potrzebny jest tekst. W pytaniach o wiedzę Claude Haiku 5.5 (low) ma 52% trafności, GPT-6 Luna (low) 66%, a modele decyzyjne 28-41%. Model decyzyjny nie napisze też odpowiedzi do klienta - to nadal robota dla LLM-a.
Co dalej
Artificial Analysis prowadzi ranking na żywo i zaprasza kolejnych producentów do zgłaszania modeli. Pełną tabelę z wynikami w każdym z czterech testów, ceny API każdego modelu, dostęp z Polski i mój test na polskich zgłoszeniach zebrałem w hubie Modele decyzyjne AI. Wcześniej opisałem już Jeva od TypeSafe, Cloudflare Clef i Strands Decider 2B od AWS.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła
- Artificial Analysis: Artificial Analysis Decision Index v1.0 (13.10.2026)
- Artificial Analysis: Decision Index - ranking na żywo (dane pobrane 13.10.2026 wieczorem)
- Artificial Analysis: metodologia Decision Index
- Artificial Analysis na X (wpis z 13.10.2026)
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym