


Co robi OpenAI, gdy ChatGPT zwalnia? Codex ustalił przyczyny ponad 600 problemów
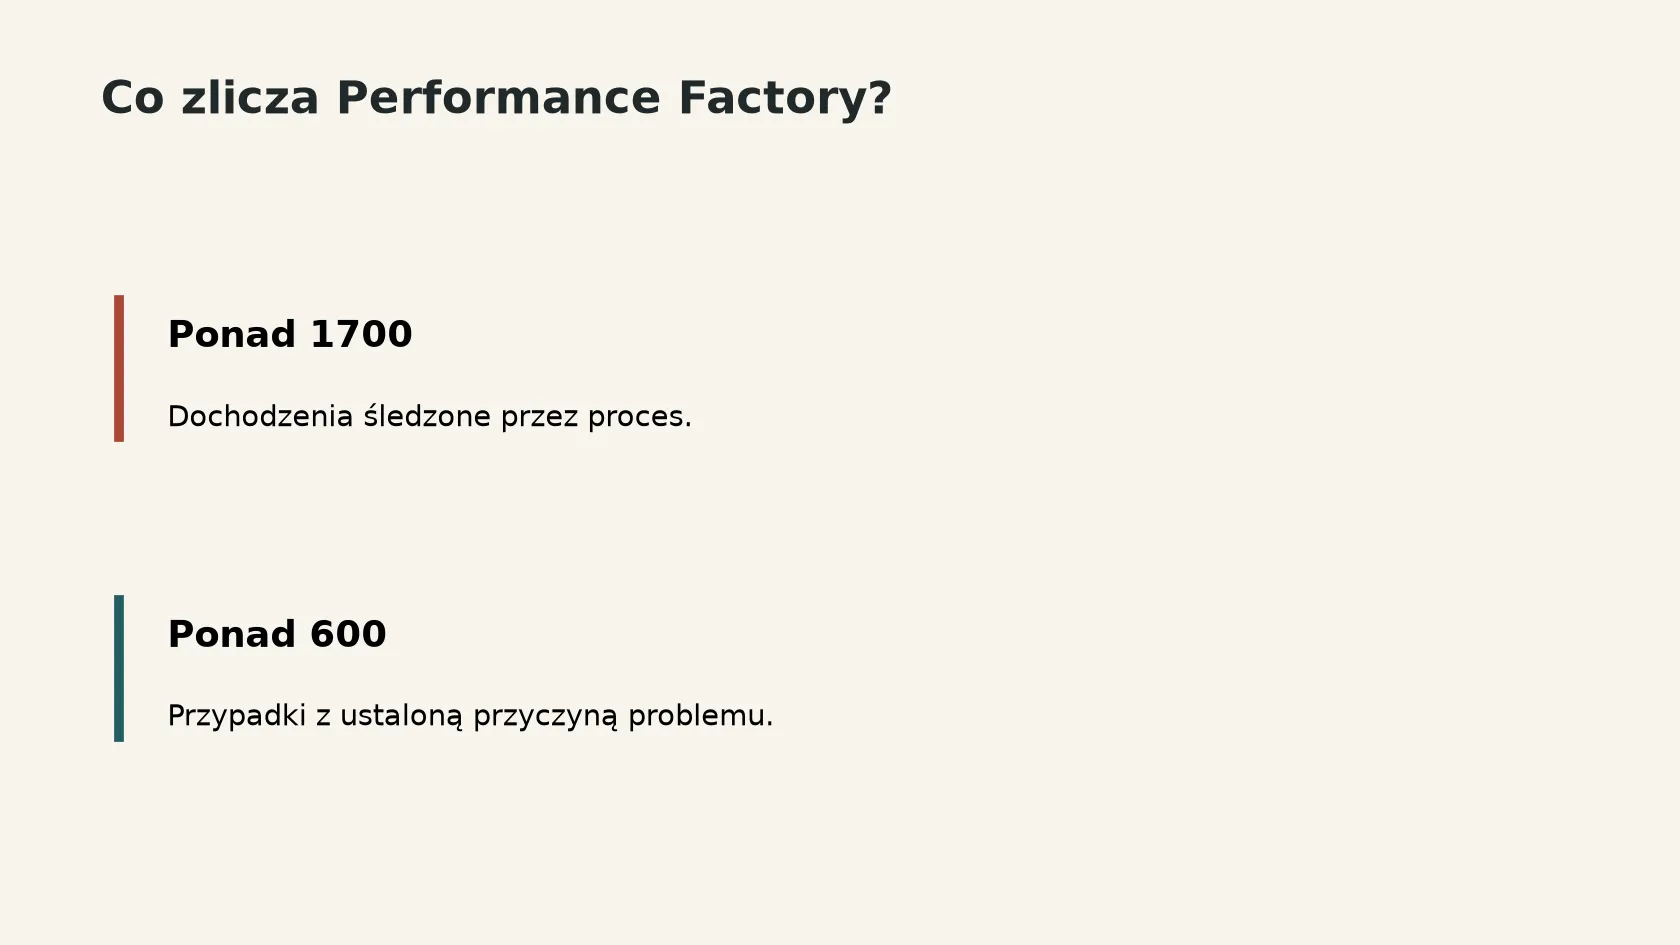
OpenAI opisało Performance Factory. W ponad trzy miesiące system śledził ponad 1700 dochodzeń wydajnościowych. Po wdrożeniu agent wraca do pomiarów.
👁 111 przeczytań
Najbardziej odczuwalne opóźnienie w czacie potrafi pojawić się, zanim zobaczysz pierwsze słowo. 19 listopada OpenAI pokazało, jak bada takie przypadki we własnej usłudze. Alarm o pogorszeniu wydajności zakłada zadanie dla agenta. Agent zagląda do pomiarów, proponuje poprawkę, a po jej wdrożeniu system wraca do tego samego zgłoszenia.
Kto sprawdza poprawkę
Inżynierowie wcześniej ręcznie zestawiali metryki, ślady wykonania i zmiany w kodzie. W Performance Factory część tej pracy przejął Codex. Ustalenia trafiają do wspólnego zadania, więc kolejna osoba albo agent widzi, jakie tropy już sprawdzono. Zatwierdzenie propozycji wciąż należy do inżyniera.
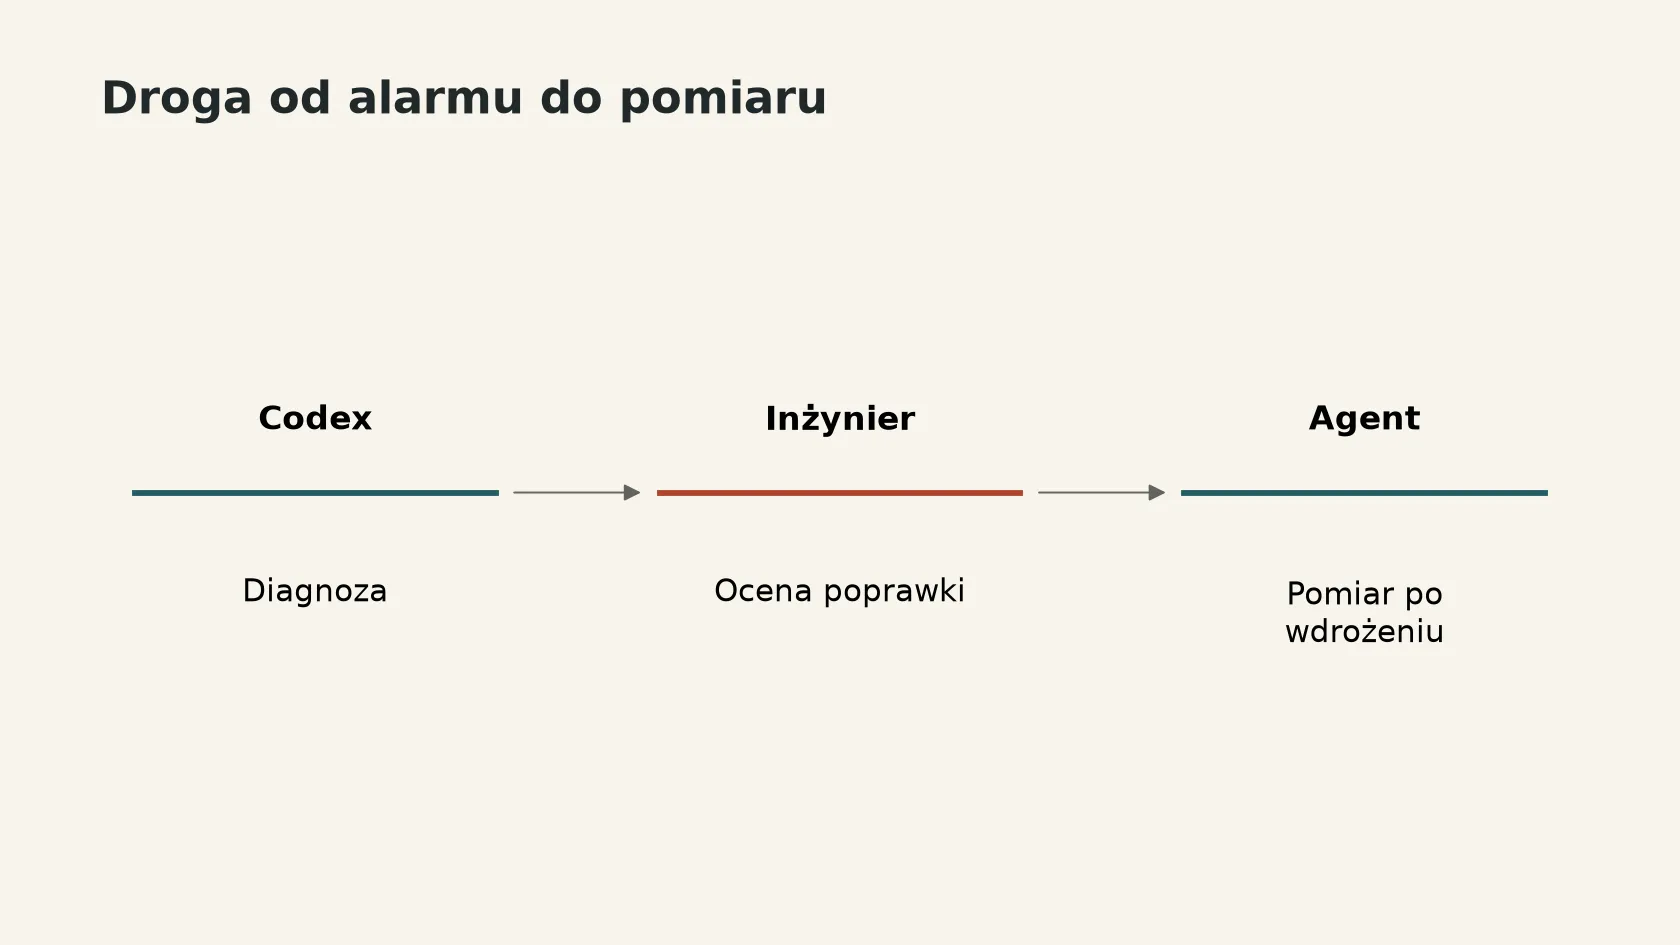
Najciekawszy jest dla mnie moment po wdrożeniu. Poprawka może wyglądać rozsądnie podczas przeglądu kodu, a mimo to nie usunąć opóźnienia odczuwanego przez użytkowników. Po wdrożeniu kolejny agent sprawdza, czy wydajność wróciła do wcześniejszego poziomu. Do zamknięcia zadania potrzebuje sygnału z działającej usługi.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Dwa liczniki, dwa różne wyniki
W nieco ponad trzy miesiące system śledził ponad 1700 dochodzeń. W ponad 600 przypadkach ustalił przyczynę pogorszenia. Firma podaje także tempo około 17 zautomatyzowanych dochodzeń dziennie. Warto przeczytać podpisy tych liczb. Liczba diagnoz nie jest liczbą napraw wdrożonych u użytkowników, a oba progi „ponad” nie wystarczają do obliczenia dokładnego odsetka skuteczności.
OpenAI opisuje własną infrastrukturę. Dla użytkownika w Polsce pozostaje prosta granica tego wyniku: z samej publikacji nie dowiemy się, o ile sekund skróciło się oczekiwanie na jego konkretną odpowiedź. Podane liczby mówią za to, jak często system musiał wracać do pytania o źródło spowolnienia.
Stan na 21.11.2026, godz. 19:34 czasu polskiego.
Źródła

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan
- przewagi.plChatGPT Ads czy Google Ads w 2026: jak podzielić budżet i ile dać na test
- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plBlack Friday 2026 na narzędzia AI: ceny z cenników, z którymi porównasz rabat