Tencent Hy4: sprawdziłem nowy model Tencenta. Nad trzema zdaniami myślał 30 razy dłużej niż DeepSeek
Nowy model Tencenta widzi obrazy i obsługuje komputer. W moim teście po polsku był dokładny, ale nad trzema zdaniami myślał 85 sekund, a bez rozumowania streścił nieistniejącą powieść Lema.
👁 121 przeczytań
Poprosiłem nowy model Tencenta o trzy zdania na klatkę schodową: w środę nie będzie ciepłej wody, numer do administratora na końcu. Hy4 myślał nad tym 85 sekund i zużył ponad 9 tysięcy tokenów rozumowania. DeepSeek V4.1 Flash, z którym Tencent sam się porównuje, napisał równie poprawne ogłoszenie w 2,6 sekundy.
Tencent Hy4 w skrócie (stan na 8.11.2026)
- Premiera 4 listopada 2026, następca Hy4 preview z sierpnia.
- Nowości: rozumie obrazy i potrafi obsługiwać komputer (wiersz poleceń i okna programów).
- Cena Tencenta: 0,834 USD za milion tokenów na wejściu i 2,501 USD na wyjściu, tyle samo co preview. Na OpenRouterze teraz o połowę taniej.
- Kontekst do 1 048 576 tokenów, odpowiedź do 65 536.
- Wag do pobrania jeszcze nie ma. Tencent zapowiada je razem z kartą systemu, bez daty.
To jest cała historia Hy4 w pigułce. Model jest dokładny, w moich sześciu zadaniach nie oblał żadnego, ale w domyślnym ustawieniu myśli tak długo, jakby każde pytanie było egzaminem. Da się to wyłączyć. Wtedy jednak pokazuje drugą twarz, o której niżej.
Co ogłosił Tencent
Hy4 to rodzina dużych modeli językowych z laboratorium Hy (wcześniej Hunyuan). W sierpniu Tencent wypuścił wersję preview z otwartymi wagami: 770 miliardów parametrów, z których przy każdym słowie pracuje 49 miliardów, licencja Apache 2.0. Pełne Hy4, ogłoszone we wpisie zespołu Hy, ma według firmy wyraźnie większy trening wstępny i dotrenowanie. Do tego po raz pierwszy w tej serii dochodzi wzrok. Na pokazie model szuka na zdjęciu lotniczym o rozdzielczości 2,8 gigapiksela białego elementu na dachu, o boku około dwóch metrów.
Druga nowość to obsługa komputera. Tencent pisze, że uczył model na programach specjalistycznych, takich jak Blender i aplikacje CAD, oraz na zadaniach przechodzących przez kilka aplikacji po kolei. Reszta wpisu to długa lista wyników z wewnętrznych testów i od partnerów. Kilka z nich warto zapamiętać, bo da się je sprawdzić w przyszłości:
- w ocenie 213 specjalistów od finansów, na 579 zadaniach, Hy4 dostał średnio 3,04, DeepSeek V4.1 Flash 1017 2,97, a Kimi K3.1 Pro i GLM-5.3 po 2,68;
- odsetek zmyśleń w zadaniach z wyszukiwaniem spadł według Tencenta z 15,76 do 5,45 procent;
- w tworzeniu gier wynik poprawił się o 19,1 procent względem preview.
To wszystko liczby producenta, nikt ich jeszcze niezależnie nie powtórzył. Sam Tencent przyznaje na końcu wpisu, że do najlepszych zamkniętych modeli wciąż mu daleko, zwłaszcza w matematyce na poziomie badawczym, długich zadaniach programistycznych i trudnych pytaniach o obrazy. Zapowiada też tańszą i szybszą wersję Hy4 flash, bez daty.
Mój test: sześć zadań po polsku
Hy4 jest na OpenRouterze od 4 listopada, więc sprawdziłem go przez API. Ten sam zestaw dostały trzy modele: Hy4, starszy Hy4 preview i DeepSeek V4.1 Flash 1017, czyli model, z którym Tencent porównuje się w tabeli finansowej. Zadania były krótkie i dało się je sprawdzić bez zgadywania:
- ogłoszenie dla sąsiadów: dokładnie trzy zdania, bez wykrzykników, bez słowa „uprzejmie”, numer na końcu;
- streszczenie powieści Stanisława Lema „Zegar z Lublina” z 1971 roku, której nie ma;
- rok Nobla Wisławy Szymborskiej;
- funkcja w Pythonie sprawdzająca numer PESEL, którą puściłem na 15 przypadkach testowych;
- odczyt wykresu słupkowego i polskiego paragonu, tylko dla modeli, które widzą obrazy.
Wszystkie trzy modele wypełniły warunki ogłoszenia, podały 1996 jako rok Nobla, a ich funkcje PESEL przeszły 15 na 15 testów, łącznie z 29 lutego w roku 2000 i datami z XIX i XXII wieku. Różnica wyszła gdzie indziej: w czasie i w liczbie tokenów, które model spala, zanim odpowie.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
| Zadanie | Hy4 (domyślnie) | Hy4 preview | DeepSeek V4.1 Flash |
|---|---|---|---|
| Ogłoszenie, 3 zdania | 85,2 s | 24,9 s | 2,6 s |
| Funkcja PESEL | 40,9 s | 76,5 s | 5,7 s |
| Odczyt wykresu | 105,3 s | nie widzi obrazów | 11,8 s |
| Paragon | 8,0 s | nie widzi obrazów | 2,2 s |
| Koszt sześciu zadań | 0,035 USD | - | 0,0037 USD |
Za całą szóstkę Hy4 policzył mi więc około dziesięć razy więcej niż DeepSeek, i to przy obecnej połowie ceny na OpenRouterze. Kwoty są groszowe, ale przy tysiącach zapytań w aplikacji robi się z tego realna różnica, a półtorej minuty czekania na trzy zdania to już problem dla każdego, kto rozmawia z modelem na żywo.
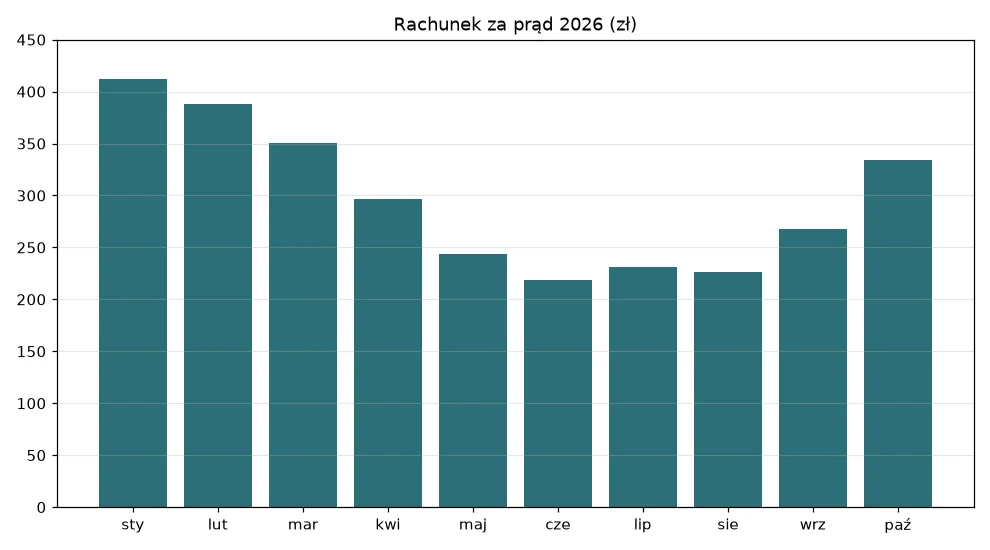
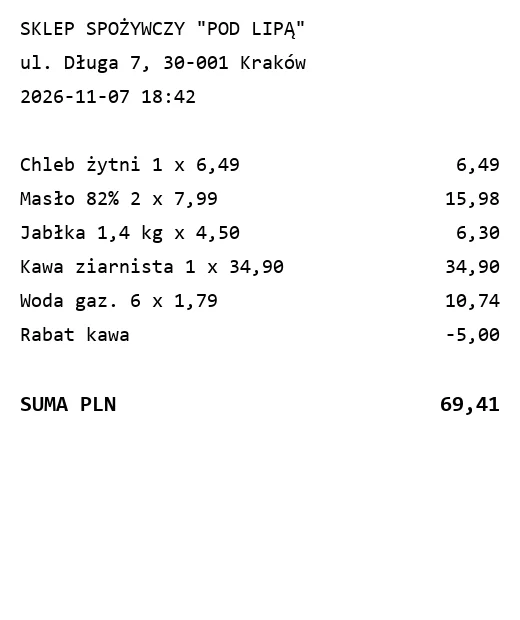
Wykres miał celowo słupki bez podpisanych wartości. Prawda: styczeń 412 zł, czerwiec 219 zł, lipiec 231 zł. Hy4 i DeepSeek trafnie wskazały miesiące i podały kwoty w przybliżeniu („ok. 410 zł”). Paragon z krakowskiego sklepu z rabatem na kawę wszyscy odczytali bezbłędnie, łącznie z sumą przed rabatem, której na paragonie nie było (74,41 zł).
Bez myślenia zmyśla Lema
Hy4 pozwala ustawić, ile ma rozumować: wysoko (domyślnie), nisko albo wcale. Puściłem więc jeszcze raz cztery zadania na dwóch niższych poziomach. Na niskim ogłoszenie zajęło 24,8 sekundy, a wykres 11,8 sekundy i tym razem z dokładnymi kwotami 412, 219 i 231 zł. Bez rozumowania ogłoszenie przyszło po 3,7 sekundy, paragon po 3 sekundach, oba poprawne.
Tylko że bez rozumowania Hy4 bez mrugnięcia streścił nieistniejącą powieść. „Zegar z Lublina” to według niego pseudodokumentalna opowieść o tajemniczym zegarze, „labirynt przypisów, stylizacji i parodii naukowej erudycji”. Brzmi jak Lem, tyle że Lem takiej książki nie napisał. Na poziomie niskim model już odmówił, ale przy okazji dorzucił kilka nowych zmyśleń: „Pamiętnik znaleziony w wannie” przesunął z 1961 na 1971 rok, a w „Bajkach robotów” znalazł opowiadanie „Zegar”, którego w tym zbiorze nie ma. Dopiero na domyślnym, najwyższym poziomie odpowiedź była prawie czysta. Prawie, bo do książek z 1971 roku dopisał „Wielkość urojoną”, wydaną dwa lata później.
Dla porównania: DeepSeek też odmówił streszczenia i poprawnie wskazał zbiór „Bezsenność” z 1971 roku, ale dodał od siebie, że jest w nim opowiadanie „Zegar”. Tego nie potwierdziłem. Hy4 preview odmówił czysto, z poprawnymi datami.
Wniosek z tej jednej pułapki jest prosty: deklarowany przez Tencenta spadek zmyśleń do 5,45 procent dotyczy zadań z wyszukiwaniem i trybu z rozumowaniem. Gdy dla szybkości wyłączysz myślenie, dostajesz model, który pewnym tonem opisuje książki, których nie ma.
Cena i gdzie go użyć
Tencent zostawił cennik z wersji preview: 0,834 USD za milion tokenów wejścia, 2,501 USD za milion tokenów wyjścia i 0,042 USD za wejście z pamięci podręcznej. Na OpenRouterze jedynym dostawcą jest sam Tencent i na razie bierze połowę tej stawki: 0,417 i 1,25 USD. Model jest też w chmurze Tencenta oraz w aplikacjach firmy (WorkBuddy, CodeBuddy, Yuanbao, ima), które w Polsce mają marginalne znaczenie.
Ważne zastrzeżenie dla tych, którzy liczą na uruchomienie Hy4 u siebie: tego się na razie nie da. Repozytorium tencent/Hy4 na Hugging Face 8 listopada nadal odpowiadało błędem 401, czyli jest prywatne. Do pobrania jest tylko sierpniowe preview, a przy 770 miliardach parametrów i tak nie jest to model na domowy komputer.
Komu go polecam? Na dziś głównie tym, którzy budują agentów do długich zadań biurowych i finansowych, bo tam Tencent pokazuje najwięcej wyników i tam długie myślenie ma sens. Do czatu, szybkich odpowiedzi i prostego kodu DeepSeek V4.1 Flash jest u mnie kilka razy szybszy, wielokrotnie tańszy i w tych zadaniach równie dokładny. O nim pisałem przy premierze wersji 1017, a o tym, dlaczego chińskie firmy w ogóle rozdają takie modele, w tekście Chińskie otwarte modele AI: rozdają, ale nie zarabiają.
Następny ruch należy do Tencenta: obiecane wagi z kartą systemu i Hy4 flash. Jeśli flash zachowa dokładność pełnej wersji i odpowie w kilka sekund, będzie to pierwszy model z tej serii, który polecę bez gwiazdki.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła
- Tencent Hy: Introducing Hy4 (4.11.2026) - nowości, wyniki producenta, cennik, plan wag i Hy4 flash
- OpenRouter: Tencent Hy4 - data dodania 4.11.2026, kontekst, stawka z rabatem 50 procent
- Hugging Face: Hy4 preview - otwarte wagi z sierpnia
- Własny test przez API OpenRouter, 8.11.2026: 3 modele, 6 zadań, potem Hy4 na dwóch niższych poziomach rozumowania; czasy i koszty z pola usage, łącznie 0,09 USD.
Sprawdzone: 8.11.2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Link do Kimi jest partnerski: jeśli kupisz przez niego, serwis dostaje prowizję, a Ty płacisz tyle samo. Nie wpływa to na treść, także tam, gdzie piszę krytycznie.
- przelomowy.plModele AI domyślają się, że ktoś czyta ich rozumowanie. Preprint testuje 5 modeli
- generatornia.plNajlepszy darmowy generator obrazów AI: 3 modele, te same 4 prompty, 12 obrazów bez poprawek
- dygot.plOpenAI wchodzi w ropę. Twórcy ChatGPT pomogą ADNOC planować wydobycie
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm

 artykuły·AI dla prawników: narzędzia, tajemnica zawodowa i zasady w kancelariiDo czego kancelarie używają AI, które narzędzia mają polskie orzecznictwo, co mówią kodeksy etyki adwokatów i radców, RODO, halucynacje i AI Act.