Qwen: modele Alibaby, Qwen3.8 Max, ceny, po polsku i mój test
Przewodnik po modelach językowych Qwen: Qwen3.8 Max i otwarte Qwen3.8-2.4T i 27B, darmowy czat i aplikacja, ceny API, uruchamianie lokalnie, Qwen Code oraz wyniki mojego testu po polsku obok Kimi, GLM i DeepSeeka.
👁 220 przeczytań
- Qwen3.8 Max zdobył 82,5 pkt na 100 w teście sześciu zadań po polsku, co bez jednej pustej odpowiedzi dałoby mu najlepszy wynik w stawce.
- Flagowy model ma 2,4 biliona parametrów, kontekst 1 miliona tokenów i kosztuje 2,00 USD za milion tokenów wejścia w API.
- Główną słabością jest nadmierne myślenie: przy limicie 8000 tokenów model zużył cały budżet w 171 sekund i nie napisał ani słowa odpowiedzi.
Qwen to rodzina modeli językowych Alibaby: od małych, które uruchomisz na własnej karcie graficznej, po Qwen3.8 Max z 2,4 biliona parametrów, który w API kosztuje 2 USD za milion tokenów wejścia. Za darmo porozmawiasz z nim na chat.qwen.ai i w aplikacji Qwen na Androida. Po polsku pisze poprawnie i najlepiej z chińskich modeli poprawia błędy, ale potrafi przemyśleć cały limit tokenów i nic nie odpowiedzieć.
Stan na 3 października 2026
- Flagowiec: Qwen3.8 Max, premiera 3 sierpnia 2026, aktualna migawka 0902 (2 września) dotrenowana pod kod i agentów. 2,4 bln parametrów, 95 mld aktywnych, kontekst 1 mln tokenów.
- Otwarte wagi: pierwszy raz w historii Qwena model klasy Max ma otwartą wersję - Qwen3.8-2.4T-A95B (własna licencja). Mniejszy Qwen3.8 27B jest na Apache 2.0.
- Ceny API: Qwen3.8 Max 2,00 / 6,00 USD, Qwen3.8 Flash 0,15 / 0,47 USD za milion tokenów wejścia / wyjścia.
- Nowości z września: Qwen3.8 Omni Flash (tekst, obraz, dźwięk, wideo), tłumacz na żywo LiveTranslate, Qwen-Image-2.1. Alibaba potwierdziła, że trenuje Qwen4.
- Mój test: Qwen3.8 Max zdobył 82,5 pkt na 100 w sześciu zadaniach po polsku. Bez jednej pustej odpowiedzi miałby najlepszy wynik w stawce.
Ten przewodnik dotyczy modeli językowych. Model do obrazów ma osobny przewodnik: Qwen-Image-2.1.
Co to jest Qwen
Qwen (po chińsku Tongyi Qianwen) to modele rozwijane od 2023 roku przez zespół Qwen w Alibaba Cloud. Rodzina jest szeroka: modele tekstowe w wielu rozmiarach, modele multimodalne (Omni), do kodu, do mowy, tłumacz na żywo i generator obrazów Qwen-Image. Większość mniejszych modeli ma otwarte wagi na Hugging Face, dlatego Qwen jest jedną z najczęściej pobieranych rodzin otwartych modeli i bazą dla tysięcy modeli pochodnych.
Dla użytkownika to cztery wejścia:
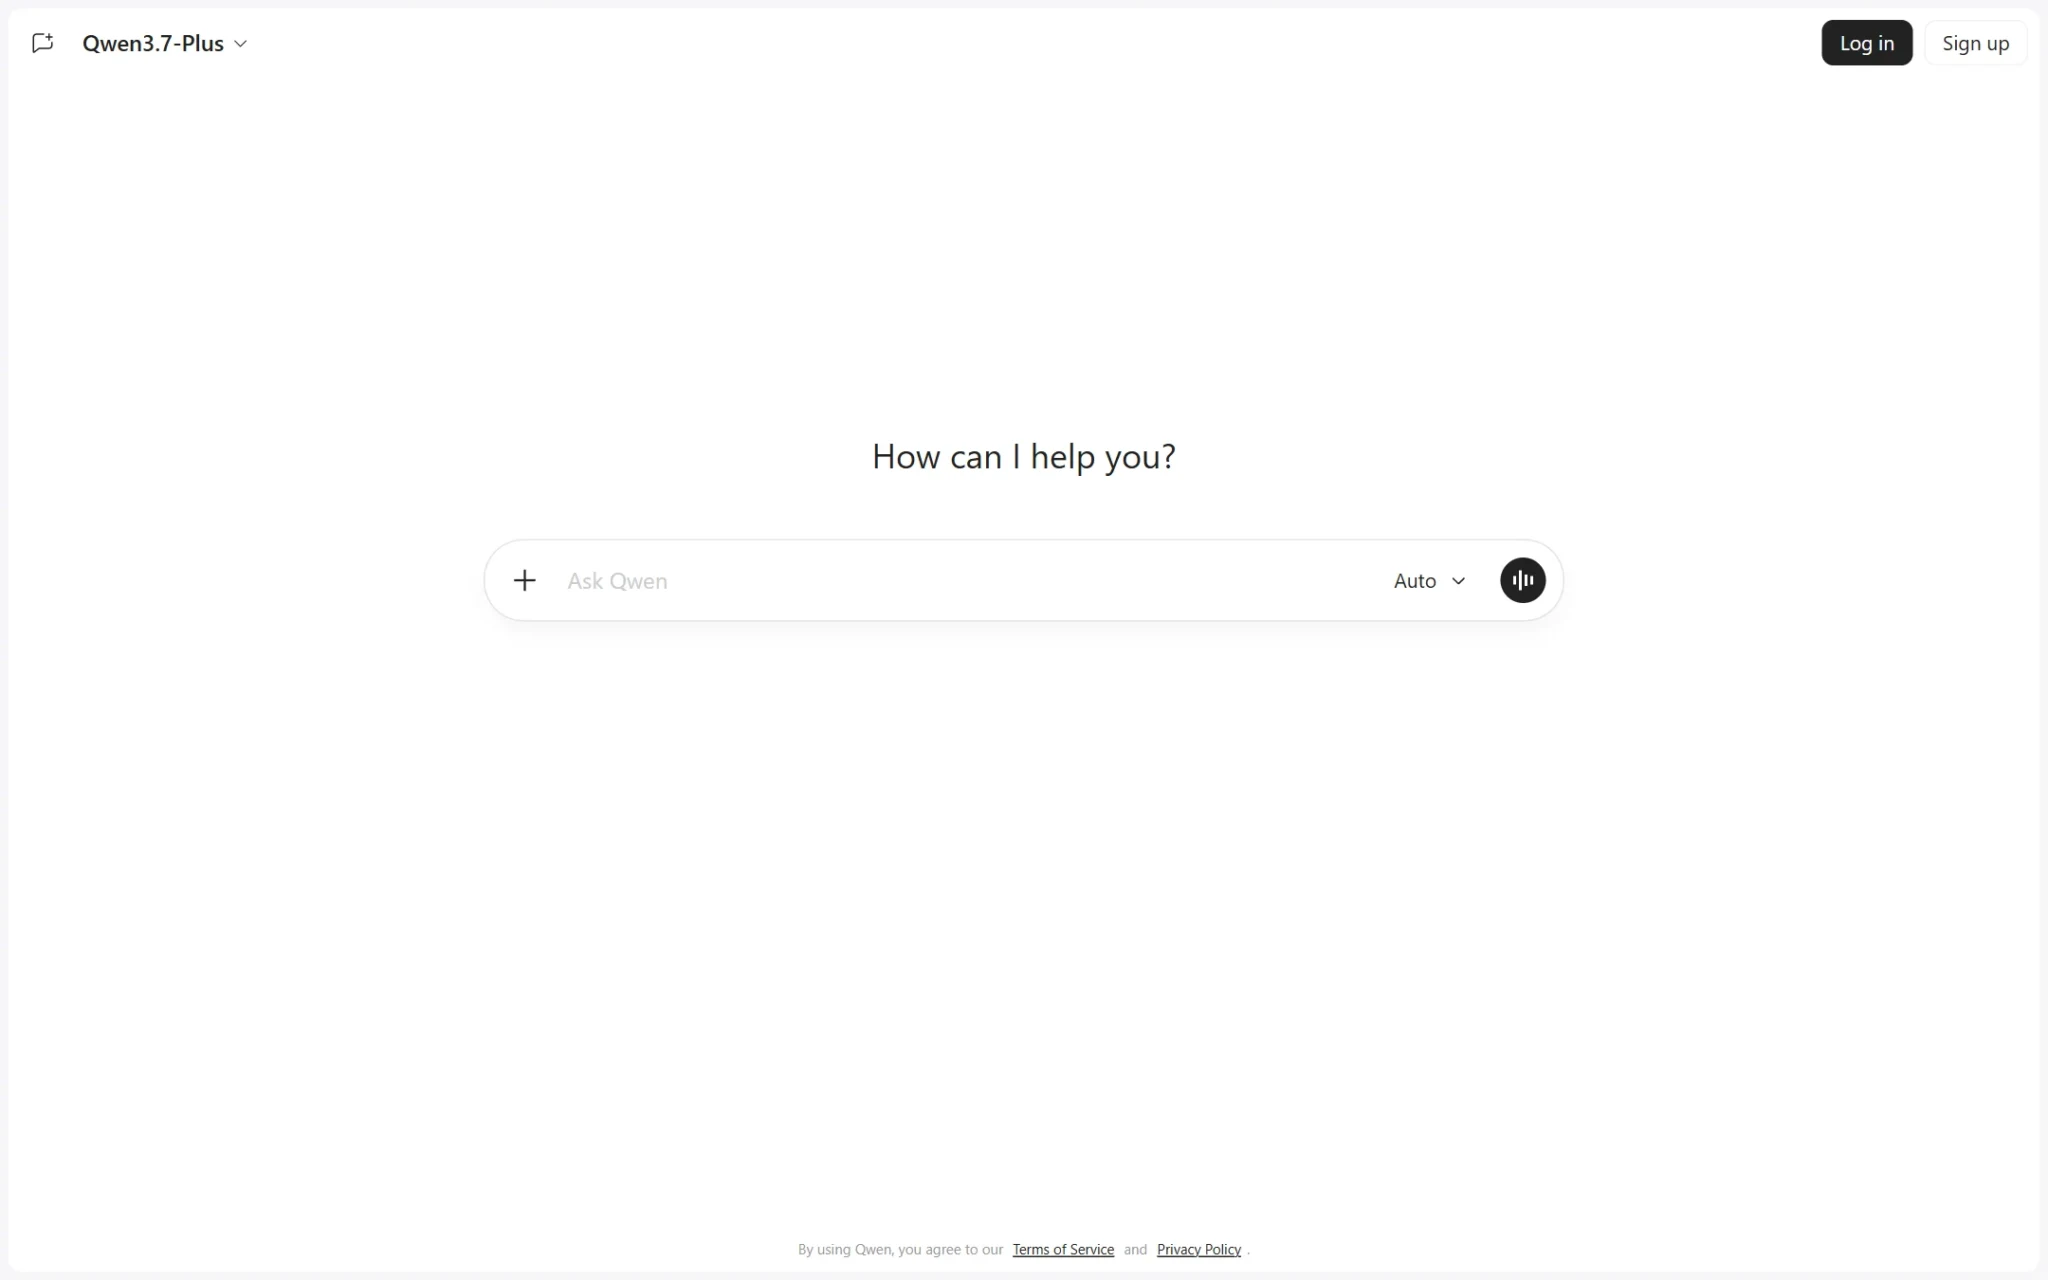
- Qwen Chat / Qwen Studio (chat.qwen.ai) - darmowy czat w przeglądarce, z wyborem modelu,
- aplikacja Qwen - na Androidzie „Qwen - Alibaba AI Assistant” od Qwen Team (ponad 5 mln pobrań, zakupy w aplikacji); w polskim App Store wyszukiwarka nie zwróciła mi oficjalnej aplikacji,
- API Qwen Cloud / Alibaba Cloud Model Studio - płatne za tokeny, region międzynarodowy w Singapurze,
- modele lokalne - wagi z Hugging Face uruchamiane przez Ollamę, llama.cpp albo vLLM.
Jak zacząć krok po kroku
- Otwórz chat.qwen.ai i załóż konto. Wybierz model Qwen3.8 Max z listy i pisz po polsku - odpowiada w języku pytania.
- Na telefonie z Androidem zainstaluj aplikację „Qwen - Alibaba AI Assistant” z Google Play. Sprawdź wydawcę (Qwen Team) - w sklepach jest sporo nakładek o podobnych nazwach.
- Do API najprościej przez OpenRoutera: model
qwen/qwen3.8-max-0902, jedynym dostawcą jest Alibaba. Alternatywa to konto w Alibaba Cloud Model Studio (wersja międzynarodowa, płatność kartą), gdzie masz natywne parametryenable_thinkingithinking_budget. - Ustaw limit myślenia. Przy pisaniu po polsku daj poziom
lowi limit odpowiedzi z dużym zapasem (16 tys. tokenów i więcej) - inaczej możesz zapłacić za pustą odpowiedź. - Do kodu zainstaluj Qwen Code - otwartego agenta w terminalu (Apache 2.0). W PowerShellu:
irm https://qwen-code-assets.oss-cn-hangzhou.aliyuncs.com/installation/install-qwen-standalone.ps1 | iex, potemqwenw katalogu projektu i/auth, żeby podać dostawcę i klucz. Obsługuje API Qwen, OpenAI, Anthropic, Gemini i modele lokalne z Ollamy. - Lokalnie: Qwen3.8 27B w kwantyzacji Q4_K_M zajmuje 17 GB pamięci karty i na RTX 4090 generuje około 50 tokenów na sekundę. Instrukcje: Ollama i lokalne AI.
Modele Qwen w październiku 2026
| Model | Premiera | Parametry | Wagi | Do czego |
|---|---|---|---|---|
| Qwen3.8 Max (0902) | 3 sierpnia 2026, migawka 2 września | 2,4 bln, 95 mld aktywnych | API; bazowe wagi otwarte | flagowiec: kod, agenci, analiza |
| Qwen3.8-2.4T-A95B | sierpień 2026 | 2,4 bln, 95 mld aktywnych | otwarte, licencja Qwen3.8-Max | tekst, kontekst 262 tys. (do 1 mln) |
| Qwen3.8 27B | sierpień 2026 | 27 mld | otwarte, Apache 2.0 | lokalnie, tekst, obraz i wideo |
| Qwen3.8 Flash | 26 sierpnia 2026 | nie podano | API (jest też otwarty Flash-Next) | tanie zadania masowe, multimodalny |
| Qwen3.8 Omni Flash | 18 września 2026 | nie podano | API | tekst, obraz, dźwięk i wideo, 1 mln kontekstu |
| Qwen3.8 LiveTranslate | 17 września 2026 | nie podano | API | tłumaczenie mowy na żywo z 60 języków |
| Qwen-Image-2.1 | wrzesień 2026 | - | otwarte | obrazy, osobny przewodnik |
Qwen3.8 Max w API to wersja z dodatkami: wejściem obrazu, trybem bez myślenia, domyślnym kontekstem 1 mln tokenów i wbudowanymi narzędziami. Otwarte wagi Qwen3.8-2.4T-A95B to ten sam model bazowy, ale tylko tekstowy. Licencja jest zbliżona do MIT z dwoma warunkami: produkt z ponad 100 mln użytkowników miesięcznie albo 20 mln USD przychodu miesięcznie musi pokazywać nazwę modelu, a firma z usługą „model jako serwis” albo asystentem do kodu i biura z przychodem ponad 50 mln USD rocznie potrzebuje osobnej licencji. Do użytku wewnętrznego warunków nie ma.
Na OpenRouterze jest jeszcze Qwen3.8 Max Prime (od 23 września): ten sam model podawany szybciej, za 4 / 12 USD, czyli dwa razy drożej. O premierze i benchmarkach pisałem w tekstach Qwen3.8-Max: wszystko, co wiadomo i gdzie wygrywa, a gdzie przegrywa.
Benchmarki
W tabeli Alibaby Qwen3.8 Max ma 92,6% w GPQA Diamond, 86,6% w Terminal-Bench 2.1, 67,7% w SWE-bench Pro i 82,8% w IFBench (wykonywanie instrukcji), gdzie wyprzedza GPT-5.6 Sol (72,7%) i Claude Fable 5 (63,5%). To liczby producenta. W niezależnym indeksie Artificial Analysis migawka 0902 ma 45 pkt, tyle co GLM-5.3 i o punkt więcej niż Kimi K3. Ta sama strona pokazuje słabość: 39 tokenów na sekundę i 5,41 USD za zadanie z indeksu, najwięcej w czołówce, bo model generuje bardzo dużo tokenów myślenia.
Ile kosztuje Qwen
| Model (API) | Wejście (USD za 1 mln) | Wyjście (USD za 1 mln) | Kontekst |
|---|---|---|---|
| Qwen3.8 Max (0902) | 2,00 | 6,00 | 1 mln |
| Qwen3.8 Max Prime | 4,00 | 12,00 | 1 mln |
| Qwen3.8 27B | 0,42 | 3,00 | 1 mln |
| Qwen3.8 Flash | 0,15 | 0,47 | 1 mln |
| Qwen3.8 Omni Flash | 0,15 | 0,47 | 1 mln |
| Qwen3.7 Flash | 0,03 | 0,13 | 1 mln |
Ceny z listy modeli OpenRoutera, 3 października 2026. Qwen3.8 Max kosztuje tyle samo u Alibaby (Model Studio, region Singapur, odczyt z pamięci podręcznej 0,25 USD), a Alibaba nie dzieli ceny na progi długości kontekstu. Na OpenRouterze Qwen3.8 27B ma też darmowy wariant z kontekstem 262 tys. tokenów. Ceny w złotych i trzy scenariusze pracy policzyłem w tekście ile kosztuje Qwen3.8-Max w złotówkach.
Czat chat.qwen.ai i pobranie otwartych wag są bezpłatne. Aplikacja na Androida ma zakupy w aplikacji, ale Alibaba nie publikuje polskiego cennika planów czatu, więc cen w złotych nie podaję.
Qwen po polsku
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Qwen3.8 Max pisze po polsku poprawnie i bardzo dokładnie trzyma się reguł z polecenia. We wrześniowym teście 13 zadań w moim Laboratorium zdobył 76,4 pkt na 100 (68,2 przy równych limitach tokenów) i jako jedyny z chińskich modeli spełnił wszystkie 26 reguł. Szczegóły w tekście Qwen3.8 Max po polsku. W październikowym teście:
- poprawił wszystkie 14 błędów w korekcie i jako bonus usunął pleonazm „wróciłem z powrotem”,
- bezbłędnie odpowiedział na 20 pytań o Polsce, łącznie z obecnym prezydentem (Karol Nawrocki) i dwiema stolicami województwa lubuskiego,
- idiomy przetłumaczył naturalnie („wziąć byka za rogi”, „złapmy się w poniedziałek”), ale zostawił „onboardowanie”,
- w mailu zaproponował „czwartek, 3 października” - to była sobota.
Słabość to myślenie. Nawet na poziomie low Qwen myślał przy każdym zadaniu: 17,8 tysiąca tokenów rozumowania w ośmiu krótkich zapytaniach, czyli ponad 8 razy więcej niż Kimi K3. Najgorzej przy dokładnych liczbach i długości tekstu - we wrześniu wersja Prime liczyła w myślach każde słowo i nie zdążyła odpowiedzieć.
Mój test: Qwen3.8 Max kontra Kimi, GLM i DeepSeek
3 października 2026 dałem Qwenowi i czterem innym chińskim modelom sześć tych samych zadań po polsku przez OpenRoutera, z rozumowaniem low, limitem 8000 tokenów i dostawcą Alibaba. Pełny opis w tekście Kimi K3, GLM-5.3, Qwen3.8 Max i DeepSeek po polsku: test.
| Zadanie | Qwen3.8 Max | Najlepszy w teście |
|---|---|---|
| Pisanie maila (0-10) | 8 | Kimi K3 - 8,5 |
| Korekta 14 błędów | 14/14 | 4 modele - 14/14 |
| Kod: NIP i odmiana „złoty” (29 testów) | 29/29 | wszyscy - 29/29 |
| Logika i kalendarz (4 pytania) | 1/4 (pusta odpowiedź) | DeepSeek V4.1 Flash i V4 Pro - 4/4 |
| Wiedza o Polsce (20 pytań) | 20/20 | GLM, Qwen, DeepSeek V4.1 Flash - 20/20 |
| Tłumaczenie z idiomami (0-10) | 9 | DeepSeek V4.1 Flash i V4 Pro - 9,5 |
| Wynik (0-100) | 82,5 | DeepSeek V4.1 Flash i V4 Pro - 93,3 |
| Czas 8 zapytań | 448 s | GLM-5.3 - 77 s |
| Koszt 8 zapytań | 0,1213 USD | GLM-5.3 - 0,0227 USD |
Pusta odpowiedź dotyczyła trzech pytań z datami. Qwen myślał 171 sekund, zużył wszystkie 8000 tokenów i nie napisał ani słowa, a ja zapłaciłem 0,048 USD. Przy powtórce z limitem 16 tysięcy wystarczyło mu 2212 tokenów myślenia i 57 sekund, a wszystkie trzy odpowiedzi były poprawne. Gdyby liczyć powtórkę, Qwen miałby 57 na 60 punktów i wygrałby test. Liczę jednak pierwszą próbę, jak u wszystkich.
Qwen a konkurencja
| Qwen3.8 Max | Kimi K3 | GLM-5.3 | DeepSeek V4.1 Flash | |
|---|---|---|---|---|
| Firma | Alibaba | Moonshot AI | Z.ai (Zhipu) | DeepSeek |
| Wagi | bazowe otwarte (2.4T), API z dodatkami | otwarte, licencja Kimi K3 | otwarte, licencja GLM-5.3 | otwarte, MIT |
| API: wejście / wyjście (USD za 1 mln) | 2,00 / 6,00 | 3,00 / 15,00 | 1,40 / 4,40 | 0,15 / 0,60 |
| Indeks Artificial Analysis (4.3) | 45 | 44 | 45 | - |
| Mój test po polsku (0-100) | 82,5 | 89,2 | 80,1 | 93,3 |
| Tokeny myślenia w teście | 17 827 | 2 092 | 2 580 | 15 093 |
| Mały model do uruchomienia w domu | tak, 27B i mniejsze | nie | Flash (320 mld) - nie na domowy sprzęt | nie |
Przewodniki po pozostałych: Kimi, GLM, DeepSeek. Krótsze wprowadzenie z września jest w tekście Qwen AI: co to jest.
Dla kogo jest Qwen
- Do korekty i zadań z twardymi regułami - Qwen najdokładniej wykonuje polecenia z chińskich modeli.
- Do uruchomienia u siebie - Qwen3.8 27B na Apache 2.0 to jeden z dwóch najlepszych lokalnych modeli po polsku w moim teście na RTX 4090 (72,2 pkt, tuż za Gemmą 4 12B).
- Do zadań multimodalnych - Omni Flash przyjmuje dźwięk i wideo za 0,15 USD za milion tokenów wejścia.
- Nie tam, gdzie liczy się czas odpowiedzi. 448 sekund na osiem zapytań to najwolniej w moim teście.
- Nie do danych wrażliwych w czacie - dane trafiają na serwery Alibaby. Lokalna wersja niczego nie wysyła. W USA trwa dyskusja o zakazie chińskich modeli, w tym Qwena.
Najczęstsze pytania
Qwen - co to jest?
Qwen to rodzina modeli AI firmy Alibaba: czat chat.qwen.ai, aplikacja mobilna, API i otwarte modele do pobrania. Najnowszy flagowiec to Qwen3.8 Max z sierpnia 2026, z migawką 0902 z września.
Czy Qwen jest za darmo?
Czat chat.qwen.ai jest bezpłatny, a otwarte modele pobierasz z Hugging Face bez opłat. Płatne jest API: Qwen3.8 Max kosztuje 2 USD za milion tokenów wejścia i 6 USD za milion wyjścia.
Czy Qwen działa po polsku?
Tak. W moim teście Qwen3.8 Max poprawił 14 z 14 błędów i odpowiedział bezbłędnie na 20 pytań o Polsce. Pisze poprawnie, choć czasem zostawia anglicyzmy jak „onboardowanie”.
Ile kosztuje Qwen3.8 Max?
2,00 USD za milion tokenów wejścia i 6,00 USD za milion wyjścia, bez progów długości kontekstu. Wersja Prime kosztuje dwa razy więcej.
Czy Qwen jest open source?
Większość modeli tak. Qwen3.8 27B ma licencję Apache 2.0, a Qwen3.8-2.4T-A95B, czyli bazowy model klasy Max, własną licencję z ograniczeniami tylko dla dużych firm. Wersja Qwen3.8 Max z API ma dodatki, których w otwartych wagach nie ma.
Qwen czy DeepSeek?
W moim teście DeepSeek V4.1 Flash zdobył 93,3 pkt, a Qwen3.8 Max 82,5, głównie przez pustą odpowiedź Qwena. Qwen lepiej trzyma się reguł i ma małe modele do uruchomienia w domu, DeepSeek jest tańszy i nie zawiesza się na myśleniu.
Czy Qwen jest bezpieczny?
Modele uruchomione lokalnie nie wysyłają danych. Czat i API przetwarzają dane na serwerach Alibaby. Do dokumentów firmowych wybierz wersję lokalną albo dostawcę z UE.
Jak uruchomić Qwen lokalnie?
Najprościej przez Ollamę albo llama.cpp. Qwen3.8 27B w kwantyzacji Q4_K_M potrzebuje około 17 GB pamięci karty - mieści się na RTX 4090 i 3090.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Chcesz zrobić film po polsku? ZWID - od 3 zł →
Źródła i data sprawdzenia
- Parametry
- licencje i benchmarki producenta: karty modeli Qwen3.8-2.4T-A95B i Qwen3.8-27B na Hugging Face oraz plik LICENSE. Daty premier: changelog modeli Qwen Cloud i karta modelu na OpenRouterze. Ceny: lista modeli OpenRoutera i cennik Alibaba Cloud Model Studio. Indeks i prędkość: Artificial Analysis (odczyt z 27 września 2026). Aplikacja: Google Play i wyszukiwarka polskiego App Store. Qwen Code: repozytorium QwenLM/qwen-code na GitHubie. Wyniki testów to moje pomiary przez OpenRouter (3 października 2026) i lokalnie na RTX 4090 (26 września 2026). Sprawdzone 3 października 2026
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →
Podobne tematy na Promptowym