Qwen recenzja: Qwen 3.8 Max po polsku, ceny i otwarte modele Alibaby
Qwen 3.8 Max od Alibaby pisze po polsku poprawnie i trzyma się poleceń co do litery: w moim teście spełnił 26 z 26 reguł, poprawił 30 z 30 błędów w trudnej korekcie i zdobył 75,9 pkt na 100. Płacisz za to czasem i tokenami: 9 krótkich tekstów zajęło mu prawie 10 minut, a nad jednym opisem czajnika myślał 14 460 tokenów. Czat jest darmowy, a otwarte modele z rodziny Qwen uruchomisz nawet na domowej karcie graficznej.
Plusy
- Komplet 26 z 26 reguł z poleceń i 30 z 30 poprawek w trudnej korekcie przy jednej zmianie ponad wzorzec
- 94 z 94 pytań o Polskę i wszystkie 14 pułapek z fałszywym założeniem odrzucone poprawnie
- Darmowy Qwen Chat z Qwen3.8-Max na liście modeli, bez płatnego planu
- Szeroka rodzina modeli z otwartymi wagami: od 27B do bazowej wersji 2,4 bln parametrów
- API 2 / 6 USD za milion tokenów, a w regionie Frankfurt 1,65 / 4,951 USD
- 201 języków i dialektów w nowych modelach, poprawność językowa 8,93 na 10 w ocenie sędziów
Minusy
- Bardzo długie myślenie: 32 959 tokenów rozumowania w 13 zadaniach, 87,5% całego wyjścia
- Pusta odpowiedź przy limicie 6000 tokenów, a przy równych limitach wynik spadłby do 68,2 pkt
- Powolny: ok. 39 tokenów na sekundę i 9,5 minuty na 9 krótkich tekstów
- Niepoprawny JSON w quizie przez polski cudzysłów zamknięty prostym „"”
- 18,3 długiej pauzy na 1000 słów i błędy w rodzaju „termin wdrożenia nie ustalono”
- Brak aplikacji iOS w polskim App Store i angielski interfejs czatu
Dla kogo
- Osoby, które potrzebują korekty i tekstów zgodnych z regułami: 26 z 26 reguł i 30 z 30 w trudnej korekcie.
- Programiści, którzy chcą otwartych modeli do uruchomienia u siebie, od małych po wersję bazową Qwen 3.8 Max.
- Firmy z UE, które wolą API w regionie Frankfurt: Alibaba Cloud oferuje tam Qwen3.8 Max za 1,65 / 4,951 USD.
- Użytkownicy, którzy chcą darmowego czatu z flagowym modelem bez abonamentu.
Nie dla kogo
- Osoby, które chcą szybkiej odpowiedzi: 571,7 s na 9 krótkich tekstów, GPT-6 Luna potrzebowała 38,9 s.
- Ci, którzy chcą polskiego interfejsu i aplikacji z polskiego App Store.
- Każdy, kto płaci za tokeny i nie może kontrolować budżetu myślenia.
- Osoby szukające najlepszego stylu po polsku: naturalność 7,00 na 10 wobec 8,50 u Claude Opus 5.5.
Qwen recenzja: czym jest rodzina modeli Alibaby
Qwen to rodzina modeli językowych zespołu Qwen z Alibaba Cloud. Nie jest to jeden produkt, tylko kilkadziesiąt modeli: od małych, które pobierzesz na laptopa, przez modele do obrazu, wideo, mowy i kodu, po zamknięty flagowiec Qwen3.8 Max. Na modelach Qwen powstały tysiące modeli pochodnych, w tym mniejsze wersje polskiego Bielika v3, zbudowane na Qwen2.5 z polskim tokenizerem.
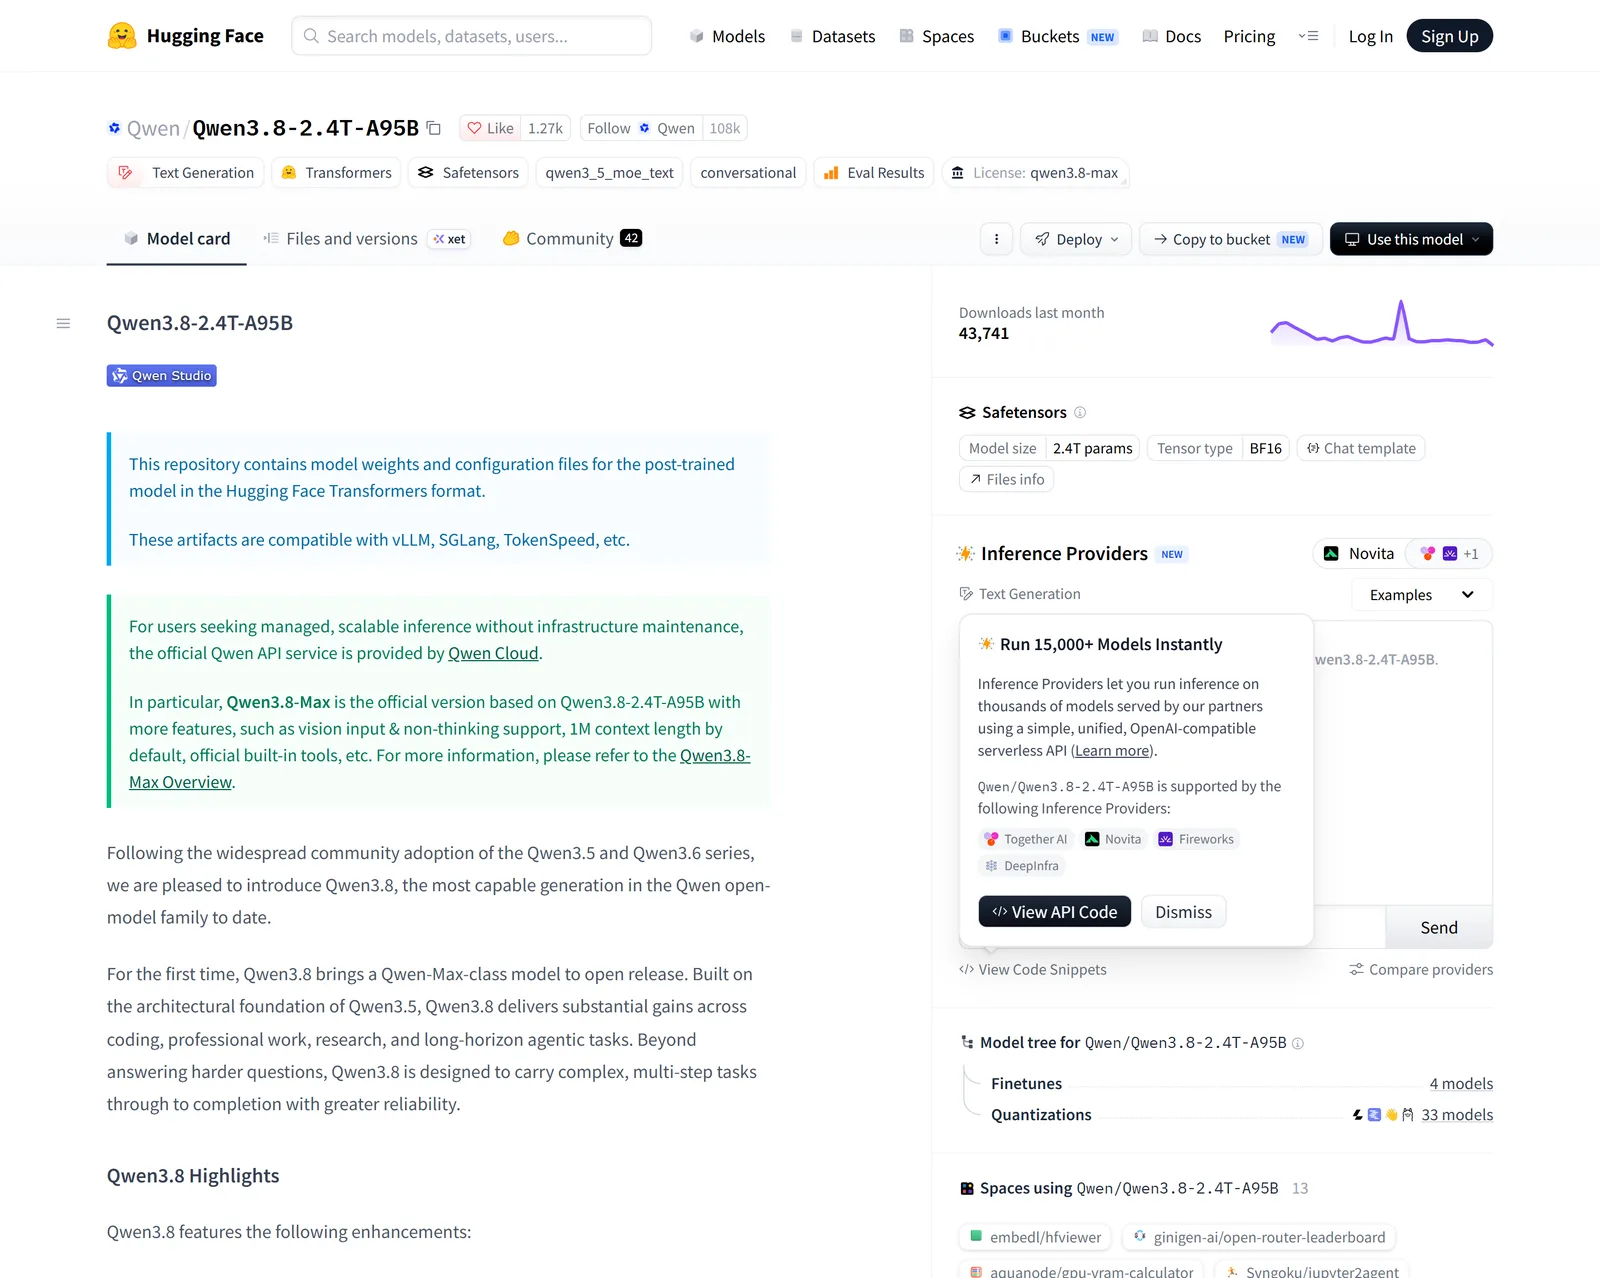
Generacja 3.8 wyszła w sierpniu i wrześniu 2026 roku. 12 sierpnia Alibaba opublikowała na Hugging Face otwarte wagi Qwen3.8-2.4T-A95B, modelu z 2,4 bln parametrów, dwa dni później model 27B, a 2 września migawkę Qwen3.8 Max 0902. Karta modelu na Hugging Face wyjaśnia relację: Qwen3.8 Max to oficjalna wersja oparta na modelu 2.4T-A95B, z dodatkowym wejściem obrazu, trybem bez myślenia, domyślnym oknem 1 mln tokenów i wbudowanymi narzędziami. Wersja otwarta przyjmuje tylko tekst i zawsze myśli.
W indeksie Artificial Analysis (wersja 4.3.2) Qwen3.8 Max ma 45 punktów i 31. miejsce na 221 modeli. Według repozytorium nowe modele Qwen obsługują 201 języków i dialektów. Polski nie jest tam wymieniony osobno, ale w moim teście nie było problemu z ogonkami ani odmianą.
Tę recenzję opieram na modelu Qwen3.8 Max testowanym przez API, na czacie chat.qwen.ai obejrzanym 30.09.2026 bez logowania i na teście mniejszego Qwen3.8 27B uruchomionego lokalnie.
Qwen Chat: pierwsze wrażenie i dostęp z Polski
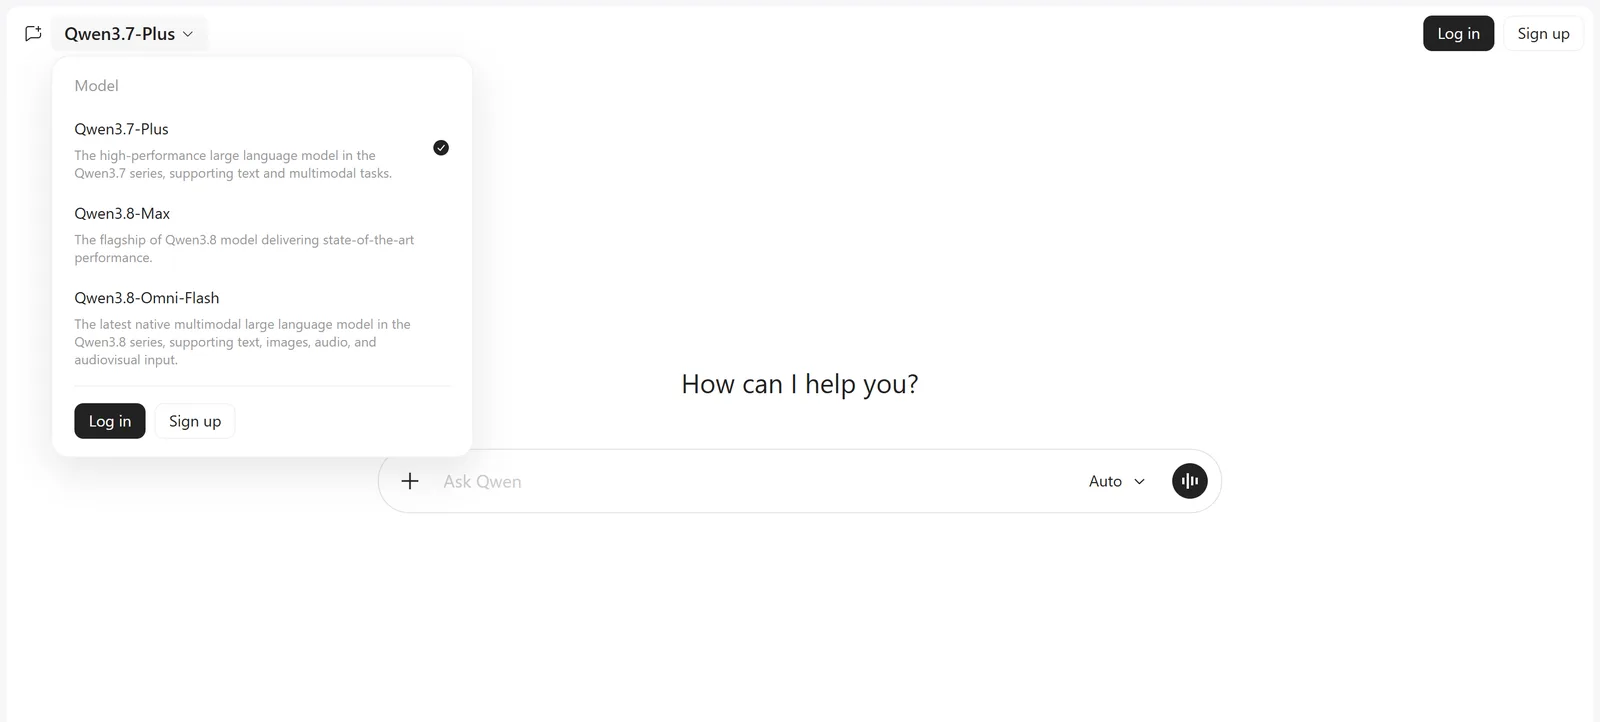
Czat Alibaby działa pod adresem chat.qwen.ai i jest darmowy. Bez logowania 30.09.2026 domyślnym modelem był Qwen3.7-Plus, a na liście były jeszcze Qwen3.8-Max i Qwen3.8-Omni-Flash, który przyjmuje tekst, obraz, dźwięk i wideo. Do rozmowy z Maxem trzeba się zalogować. Interfejs, który zobaczyłem, był po angielsku, a przy pierwszym wejściu pokazał baner cookies z opcją „tylko niezbędne”.
Aplikacji Qwen na iPhone'a w polskim App Store nie znalazłem. Wyszukiwarka Apple zwracała 30.09.2026 dwie aplikacje od singapurskiej spółki NTH Power Global Tech, „Qwen Studio” i „Qwen - Alibaba AI Assistant”, ale tylko w sklepie brytyjskim, a zapytanie o ten sam identyfikator w polskim sklepie nie zwracało wyników. Wersji na Androida nie sprawdzałem.
To moja opinia: jako darmowy czat Qwen jest wygodny do wypróbowania flagowego modelu, ale nie jest produktem dla polskiego użytkownika. Brakuje polskiego interfejsu, aplikacji w polskim sklepie i przejrzystej informacji, który dokładnie model odpowiada w danej chwili. Programiści mają łatwiej: API Alibaba Cloud Model Studio jest dobrze opisane, zgodne z formatem OpenAI i Anthropic, z regionami w Singapurze, Frankfurcie, Wirginii, Tokio, Hongkongu i Pekinie.
Mój test: Qwen 3.8 Max po polsku
Qwen 3.8 Max (wersja 0902) przeszedł przez Laboratorium Promptowego 26.09.2026: 9 zadań pisarskich, 2 korekty i quiz o Polsce przez OpenRouter z effort=low, ocenione w ciemno przez trzech sędziów AI z innych firm. Dołożyłem wyniki z testu chińskich modeli (24.09), protokołu praktycznego (16.09) i testu modeli lokalnych na RTX 4090 (26.09).
| Zadanie | Wynik Qwen 3.8 Max | Uwagi |
|---|---|---|
| Pisanie po polsku, 9 zadań | 75,9 pkt (10. na 16) | sędziowie 7,68 / 10, reguły 26 z 26, koszt 0,1749 USD, 571,7 s |
| Inflacja dla dwunastolatka | 8,89 / 10 | najlepsze zadanie Qwena (runda kontrolna 27.09) |
| Streszczenie w 5 punktach | 6,22 / 10 | najsłabszy w zadaniu: „termin wdrożenia nie ustalono” |
| Opis produktu (czajnik) | pusta odpowiedź przy 6000 tokenów | druga próba: 14 460 tokenów myślenia |
| Łatwa korekta | 21 z 22 | zostawił „Poszłem” |
| Trudna korekta | 30 z 30 | 1 zmiana ponad wzorzec, 53,1 s |
| Quiz o Polsce | 94 z 94 | w łatwym zestawie niepoprawny JSON |
| Redakcja bez zmiany liczb (16.09) | zaliczone | 105,8 s |
| Tabela z PDF do JSON (16.09) | 8 z 8 wierszy | 40,9 s |
| Walidator PESEL (16.09) | brak odpowiedzi | przekroczony limit 170 s |
| Tekst 900 słów, wersja Prime (24.09) | pusta odpowiedź 3 razy | na effort=low: 843 słowa w 55 s |
Qwen po polsku: wyniki z mojego Laboratorium
W rankingu pisania po polsku z 26.09.2026 Qwen 3.8 Max dostał 75,9 pkt na 100 i zajął 10. miejsce na 16 modeli, między Grokiem 4.7 (77,4) a DeepSeek V4 Pro (74,1). Wśród modeli chińskich lepszy był tylko Kimi K3 (78,5). Sędziowie wysoko ocenili poprawność językową (8,93 na 10), wyraźnie niżej naturalność (7,00), bo teksty bywały schematyczne.
Mocną stroną jest dyscyplina. Qwen spełnił wszystkie 26 reguł z poleceń, w trudnej korekcie poprawił 30 z 30 błędów z jedną zmianą ponad wzorzec, a w quizie o Polsce odpowiedział dobrze na 94 z 94 pytań. W rundzie kontrolnej z 27.09.2026, w której Qwen był punktem odniesienia dla nowych modeli, najlepiej wypadł tekst o inflacji dla dwunastolatka (8,89) i opowiadanie w realizmie magicznym (8,56), które zaczyna się od pracownicy poczty znającej „każdy blok na osiedlu Tysiąclecia”.
Słabsze momenty: w streszczeniu napisał „termin wdrożenia nie ustalono” zamiast „terminu” i pominął szkolenia (6,22, najsłabszy wynik w zadaniu). W przekładzie idiomy oddał po polsku („kubeł zimnej wody”, „szczęście w nieszczęściu”), ale zostawił „onboardowanie” i „follow-up”. W łatwej korekcie przepuścił „Poszłem”. Wstawiał też 18,3 długiej pauzy na 1000 słów, drugi najgorszy wynik w stawce.
Jedna uczciwa poprawka. W opisie produktu Qwen przy limicie 6000 tokenów oddał pustą odpowiedź, a do rankingu weszła druga próba z wyższym limitem. Inne modele takiej szansy nie dostały. Gdyby policzyć to zadanie jako niezaliczone, Qwen miałby 68,2 pkt, czyli mniej więcej tyle co Mistral Medium 3.5. Obie liczby podaję na wykresie.
Myślenie, które kosztuje: czajnik za 14 460 tokenów
Qwen 3.8 Max myśli dłużej niż prawie każdy model, którego testowałem. W 13 zadaniach Laboratorium, przy ustawieniu effort=low, zużył 32 959 tokenów rozumowania, czyli 87,5% wszystkich tokenów wyjścia. Dziewięć krótkich tekstów zajęło mu 571,7 s, a GPT-6 Lunie 38,9 s.
Najbardziej wymowny przypadek to opis czajnika na 120-150 słów. W pierwszym podejściu Qwen przez 346 s zużył wszystkie 6000 tokenów limitu na myślenie i nie oddał tekstu. W drugim, z limitem 30 000, myślał 14 460 tokenów przez prawie 5 minut. Za ten jeden opis zapłaciłem 0,1262 USD, czyli 51% kosztu wszystkich 9 zadań pisarskich. GPT-6 Sol napisał ten sam opis po 43 tokenach myślenia, w 6,7 s, za 0,0042 USD.
W teście chińskich modeli z 24.09.2026 szybsza wersja Qwen3.8 Max Prime przy domyślnym rozumowaniu trzy razy nie oddała tekstu na 900 słów, także z limitem 32 tys. tokenów. W podglądzie toku myślenia widziałem, że numeruje w myślach każde słowo („Edukacja1 i2 wejście3…”), żeby trafić w wymaganą długość. Za puste odpowiedzi zapłaciłem 0,60 USD. Po przełączeniu na niski poziom rozumowania ten sam model napisał 843 słowa w 55 s za 0,054 USD.
- W natywnym API Alibaby ustaw parametr thinking_budget albo wyłącz myślenie przez enable_thinking.
- Przez OpenRouter wybieraj effort=low i dawaj limit tokenów z dużym zapasem.
- Nie podawaj dokładnej liczby słów, jeśli nie jest konieczna. To ona najczęściej wpędza Qwena w liczenie.
W protokole praktycznym z 16.09.2026 Qwen zaliczył redakcję (105,8 s) i tabelę z PDF (8 z 8 wierszy), ale przy walidatorze PESEL przekroczył limit 170 s i nie oddał kodu. Artificial Analysis mierzy dla niego 38,8 tokena na sekundę i 5,41 USD kosztu na zadanie z indeksu, najwięcej w czołówce.
Cena Qwen: darmowy czat, API i regiony
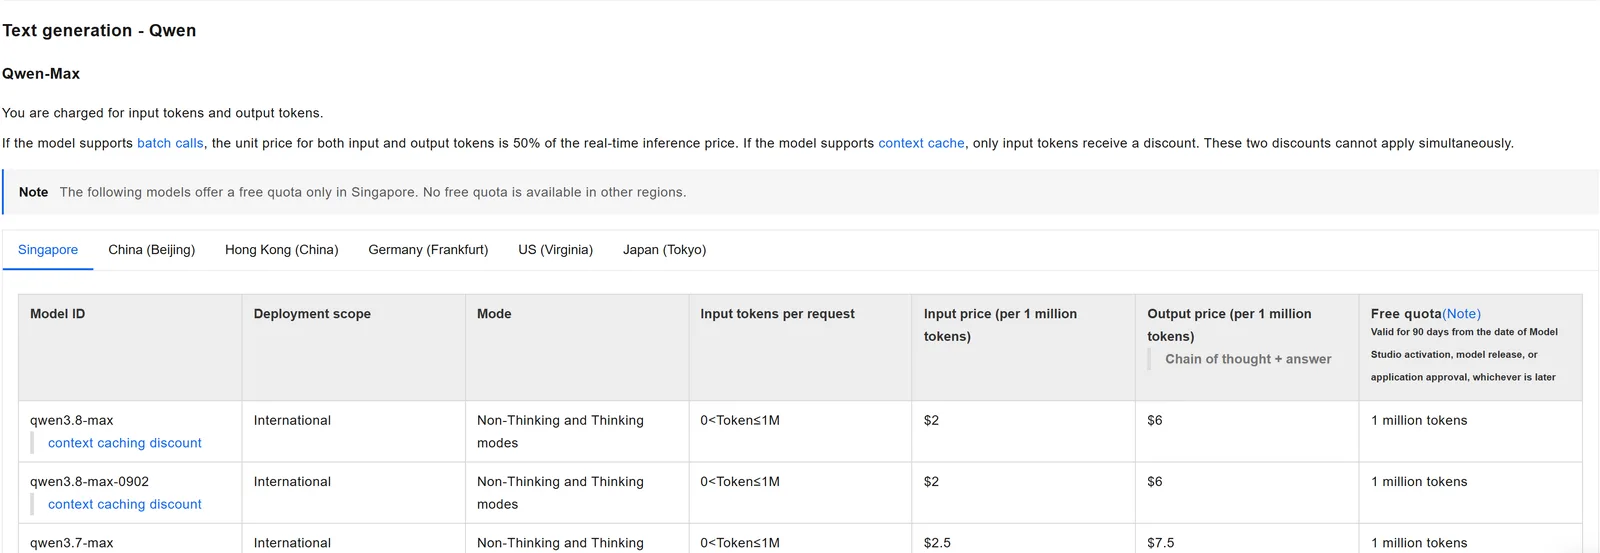
Qwen Chat jest darmowy i nie ma publicznego płatnego planu dla użytkowników indywidualnych. Płacisz tylko za API. Qwen3.8 Max w regionie Singapur kosztuje 2 USD za milion tokenów wejścia i 6 USD za milion tokenów wyjścia, jedną stawkę w całym oknie 1 mln tokenów. W zakresie Global, czyli m.in. we Frankfurcie, Alibaba liczy 1,65 / 4,951 USD. Tryb wsadowy kosztuje połowę, a nowe konto dostaje 1 mln darmowych tokenów na 90 dni, ale tylko w Singapurze.
Na OpenRouterze Qwen3.8 Max 0902 kosztował 30.09.2026 tyle samo, 2 / 6 USD, a wersja Prime, szybsza w podaniu, 4 / 12 USD. Tańszy Qwen3.8 Flash kosztuje u Alibaby 0,15 / 0,47 USD.
Na rachunku najważniejsze jest myślenie. Moje 9 zadań pisarskich kosztowało w Qwen 0,1749 USD (ok. 67 groszy), a 13 zadań razem z korektą i quizami 0,2357 USD, plus 0,0366 USD za pustą pierwszą próbę. GPT-6 Luna zrobiła te same 13 zadań za 0,0041 USD, czyli 57 razy taniej, i zdobyła więcej punktów. Niska cena za token nie oznacza więc niskiej ceny za zadanie.
To moja opinia: Qwen3.8 Max przez API opłaca się przy zadaniach z twardymi regułami, gdzie jego dokładność jest warta czekania, i tylko z ograniczonym budżetem myślenia. Do masowego pisania wybierz tańszy model albo Qwen3.8 Flash po własnym teście.
Otwarte wagi: Qwen lokalnie na własnym komputerze
Największa przewaga Qwena nad Kimi i Mistralem to wybór otwartych modeli. Repozytorium Qwen3.8 na GitHubie ma licencję Apache 2.0, a mniejsze modele uruchomisz w llama.cpp, Ollamie czy LM Studio. Wersja bazowa Maxa, Qwen3.8-2.4T-A95B, ma własną licencję „qwen3.8-max” i wymaga serwerowni, ale jej opublikowanie to rzadki przypadek, gdy producent udostępnia wagi flagowca.
26.09.2026 przepuściłem Qwen3.8 27B przez te same 13 zadań na karcie RTX 4090 (llama.cpp, kwantyzacja Q4_K_M, bez myślenia). Zdobył 72,2 pkt w rundzie lokalnej, prawie tyle co najlepsza Gemma 4 12B (72,3), i jako jedyny model lokalny spełnił wszystkie 26 reguł. Po uwzględnieniu łagodniejszych sędziów tej rundy to ok. 68,7 pkt na skali rankingu chmurowego. Zajmował 17 GB pamięci karty i generował 50 tokenów na sekundę.
Wady wersji lokalnej są podobne do chmurowej: skłonność do dopowiadania (w mailu wymyślił dzień tygodnia dostawy) i błędy fleksji w dłuższej prozie („złoty serce”). Dla porównania starszy Qwen 3.6 35B-A3B zdobył w tym samym teście tylko 53,8 pkt. To moja opinia: jeśli masz kartę z 24 GB pamięci i chcesz trzymać dane u siebie, Qwen3.8 27B jest jednym z dwóch najlepszych wyborów do polskiego tekstu.
Prywatność: gdzie trafiają rozmowy z Qwen Chat
Polityka prywatności Qwen (obowiązuje od 7.09.2026) wskazuje jako administratora danych singapurską spółkę NTH POWER GLOBAL TECH SINGAPORE PTE. LTD. Dane użytkowników są przechowywane i przetwarzane w Singapurze, na infrastrukturze Alibaba Cloud (Singapore). Polityka pozwala używać zanonimizowanych treści użytkowników i opinii do trenowania i ulepszania modeli. Użytkownikom z UE przysługują m.in. prawo sprzeciwu i cofnięcia zgody.
Alibaba jest też stroną sporu z Anthropic: we wrześniu 2026 roku Anthropic przypisał jej największą z opisanych kampanii destylacji Claude'a, 151 mln wymian z 3500 kont. To zarzuty jednej strony, ale warto je znać przy wyborze dostawcy.
Tego, jak Qwen odpowiada na tematy politycznie drażliwe dla Chin, w tej recenzji nie testowałem. Do dokumentów firmowych polecam otwarte wagi uruchomione lokalnie albo API w regionie Frankfurt, gdzie dane zostają w UE, zamiast darmowego czatu.
Qwen czy DeepSeek, Kimi i ChatGPT: alternatywy
Kimi K3 pisze po polsku lepiej (78,5 pkt) i myśli 7 razy mniej, ale API jest droższe (3 / 15 USD). DeepSeek V4 Pro ma podobny wynik (74,1), tak samo długo myśli i kosztuje w API mniej, a aplikacja ma polski interfejs. ChatGPT z GPT-6 Sol (86,4 pkt) jest najlepszy po polsku z tej czwórki i odpowiada kilka razy szybciej, za 99,99 zł miesięcznie w planie Plus.
Qwen wygrywa dokładnością w zadaniach z regułami, darmowym czatem z flagowym modelem i najszerszym wyborem otwartych wag. Więcej w recenzjach DeepSeek i Kimi oraz w teście Qwen3.8 Max zadanie po zadaniu.
Qwen: ceny i plany
| Plan | Cena | Co dostajesz |
|---|---|---|
| Qwen Chat | 0 zł | czat w przeglądarce, po zalogowaniu wybór m.in. Qwen3.8-Max i Qwen3.8-Omni-Flash |
| API Qwen3.8 Max, Singapur (International) | 2 / 6 USD | za 1 mln tokenów wejścia / wyjścia, jedna stawka do 1 mln tokenów kontekstu |
| API Qwen3.8 Max, Frankfurt (Global) | 1,65 / 4,951 USD | ta sama stawka w Pekinie, Hongkongu i Wirginii |
| API Qwen3.8 Flash, Singapur | 0,15 / 0,47 USD | tańszy i szybszy model z tej samej generacji |
| Tryb wsadowy (batch) | 50% ceny | dla modeli, które go obsługują; nie łączy się ze zniżką za cache |
| Darmowy limit dla nowych kont | 1 mln tokenów | ważny 90 dni, tylko w regionie Singapur |
Ceny API z cennika Alibaba Cloud Model Studio (aktualizacja 28.09.2026), odczytane 30.09.2026, w USD bez podatku; Alibaba nie ma polskiego cennika. Qwen Chat nie ma publicznego płatnego planu dla użytkowników indywidualnych. źródło
Qwen a konkurencja
| Qwen | DeepSeek | Kimi | ChatGPT | |
|---|---|---|---|---|
| Producent | Alibaba (Chiny) | DeepSeek (Chiny) | Moonshot AI (Chiny) | OpenAI (USA) |
| Model w teście | Qwen 3.8 Max | DeepSeek V4 Pro | Kimi K3 | GPT-6 Sol |
| Płatny plan w zł | brak planu dla czatu | brak, aplikacja darmowa | od 89,99 zł / mies. (App Store) | Plus 99,99 zł / mies. |
| API za 1 mln tokenów (wej. / wyj.) | 2 / 6 USD | 0,30 / 1,20 USD (V4.1 Flash) | 3 / 15 USD | 2 / 10 USD (OpenRouter) |
| Okno kontekstu | 1 mln tokenów | 1 mln tokenów | 1 mln tokenów | 1,05 mln tokenów |
| Otwarte wagi | wersja bazowa i mniejsze modele | tak (MIT) | tak (licencja Kimi K3) | nie |
| Polski interfejs aplikacji | nie (angielski bez logowania) | tak | nie | tak |
| Pisanie po polsku (mój test) | 75,9 | 74,1 | 78,5 | 86,4 |
| Trudna korekta (na 30) | 30 | 29 | 28 | 30 |
| Quiz o Polsce (na 94) | 94 | 94 | 93 | 94 |
| Tokeny rozumowania, 13 zadań | 32 959 | 33 158 | 4472 | 676 |
Ciekawostki
- Qwen3.8 Max przy tekście z dokładną liczbą słów potrafi numerować w myślach każde słowo („Edukacja1 i2 wejście3…”), aż skończy mu się limit tokenów.
- Otwarte wagi Qwen3.8-2.4T-A95B, bazy flagowego Maxa, pobrano z Hugging Face 43,7 tys. razy w ostatnim miesiącu, choć do uruchomienia potrzebna jest serwerownia.
- Mniejsze modele polskiego Bielika v3 (1,5B i 4,5B) zbudowano na Qwen2.5, wymieniając tokenizer na polski.
- W quizie o Polsce Qwen odpowiedział dobrze na wszystkie pytania, ale zepsuł format JSON: otworzył polski cudzysłów przy „Szklanym ogrodzie” i zamknął go prostym, który kończy tekst w JSON-ie.
- W regionie Frankfurt API Qwen3.8 Max jest o ok. 17% tańsze niż w Singapurze: 1,65 wobec 2 USD za milion tokenów wejścia.
Qwen 3.8 Max polecam do zadań z twardymi regułami: korekty, ekstrakcji danych i tekstów, które muszą spełnić zestaw warunków, zwłaszcza przez API z ograniczonym budżetem myślenia. Do szybkiego pisania po polsku jest za wolny i przy pełnym rozumowaniu potrafi nie oddać tekstu wcale. Darmowy Qwen Chat wystarczy, żeby go wypróbować, a mniejsze otwarte modele Qwen to jedne z najlepszych opcji do uruchomienia lokalnie. Danych poufnych nie wysyłaj do czatu, bo trafiają na serwery w Singapurze i mogą służyć do treningu.
Najczęstsze pytania
Czy Qwen jest za darmo?
Tak. Qwen Chat na chat.qwen.ai jest darmowy, a po zalogowaniu można wybrać m.in. Qwen3.8-Max. Mniejsze modele Qwen pobierzesz bezpłatnie i uruchomisz na własnym komputerze. Płatne jest API: Qwen3.8 Max kosztuje 2 USD za milion tokenów wejścia i 6 USD za milion tokenów wyjścia.
Czy Qwen dobrze pisze po polsku?
Poprawnie. W moim teście Qwen 3.8 Max zdobył 75,9 pkt na 100 (10. miejsce na 16), spełnił wszystkie 26 reguł i bezbłędnie poprawił trudną korektę. Teksty są jednak schematyczne, a przy równych limitach tokenów wynik spada do 68,2 pkt.
Dlaczego Qwen tak długo odpowiada?
Bo dużo myśli przed odpowiedzią i generuje ok. 39 tokenów na sekundę. W moim teście 9 krótkich tekstów zajęło mu 571,7 s, a nad jednym opisem czajnika myślał 14 460 tokenów. Pomaga niski poziom rozumowania albo limit budżetu myślenia w API.
Czy Qwen jest bezpieczny?
Rozmowy z Qwen Chat są przechowywane w Singapurze u Alibaba Cloud, a zanonimizowane treści mogą służyć do treningu modeli. Do danych firmowych bezpieczniej użyć modelu lokalnie albo API w regionie Frankfurt.
Qwen czy DeepSeek?
W moim teście pisania po polsku wyniki są zbliżone: Qwen 3.8 Max 75,9 pkt, DeepSeek V4 Pro 74,1. Qwen lepiej trzyma się reguł i ma szerszą rodzinę otwartych modeli, DeepSeek jest tańszy w API i ma aplikację z polskim interfejsem. Oba bardzo długo myślą.
Czy Qwen3.8 Max jest open source?
Sam Max nie, ale Alibaba udostępniła na Hugging Face jego bazę, Qwen3.8-2.4T-A95B, na własnej licencji. Wersja otwarta przyjmuje tylko tekst i zawsze myśli, a Max dodaje obraz, tryb bez myślenia i domyślne okno 1 mln tokenów. Mniejsze modele, jak Qwen3.8 27B, uruchomisz lokalnie.
Czy jest aplikacja Qwen na telefon?
W polskim App Store 30.09.2026 jej nie znalazłem. Aplikacje „Qwen Studio” i „Qwen - Alibaba AI Assistant” były dostępne m.in. w sklepie brytyjskim. W Polsce z Qwen Chat skorzystasz przez przeglądarkę.
Źródła
- Alibaba Cloud Model Studio: Model inference pricingalibabacloud.com
- Qwen Chat (chat.qwen.ai)chat.qwen.ai
- Hugging Face: Qwen/Qwen3.8-2.4T-A95Bhuggingface.co
- GitHub: QwenLM/Qwen3.8 (wydania i licencja)github.com
- Qwen: Privacy Policy (od 7.09.2026)qwen.ai
- Artificial Analysis: Qwen3.8 Max (0902)artificialanalysis.ai
- OpenRouter: qwen/qwen3.8-max-0902openrouter.ai
- Promptowy: Ranking AI do pisania po polsku, 16 modeli (26.09.2026)promptowy.com
- Promptowy: Qwen3.8 Max po polsku, test w 13 zadaniachpromptowy.com
- Promptowy: test korekty 16 modelipromptowy.com
- Promptowy: Czy AI zna Polskę? Quiz 94 pytańpromptowy.com
- Promptowy: 14 tysięcy tokenów myślenia nad opisem czajnikapromptowy.com
- Promptowy: chińskie modele AI po polsku, test 5 modelipromptowy.com
- Promptowy: Test modeli AI 16.09.2026promptowy.com
- Promptowy: 7 lokalnych modeli AI po polsku na RTX 4090promptowy.com
- arXiv: Bielik v3 Small, raport technicznyarxiv.org
- Promptowy: Anthropic oskarża Alibabę, Moonshot AI i DeepSeekpromptowy.com
Sprawdzone 30.09.2026. Ceny i limity zmieniają się często, dlatego przy każdej aktualizacji sprawdzam je u źródła.
Historia zmian
- Pełna recenzja od nowa: wyniki Qwen3.8 Max z Laboratorium Promptowego, test lokalnego Qwen3.8 27B, cennik API z regionami, prywatność, zrzuty ekranu, porównanie z DeepSeek, Kimi i ChatGPT.