Ile pamięci karty potrzebuje Qwen-Image-2.1? Tabela wszystkich wariantów
Koder tekstu jest większy od samego modelu obrazowego. To na nim się oszczędza, nie na generatorze.
👁 220 przeczytań
Qwen-Image-2.1 występuje w kilku wariantach precyzji, a różnica między najcięższym a najlżejszym zestawem to 31,7 GB wobec 13,6 GB. Od tego, który wybierzesz, zależy, czy model w ogóle wejdzie na Twoją kartę. Zebrałem wszystkie pliki z rozmiarami i policzyłem, co się gdzie mieści.
Werdykt w jednym akapicie
Na karcie z 24 GB bierz wariant int8: 16,6 GB i zapas na resztę. Zmierzyłem u siebie - ComfyUI melduje 6 920 MB na model obrazowy i 644 MB na dekoder, więc miejsca zostaje sporo. Na karcie z 16 GB zejdź z koderem tekstu do wariantu czterobitowego, co daje 13,6 GB. Na 12 GB i mniej trzeba przerzucić koder tekstu do pamięci komputera - model wtedy zadziała, ale każde nowe polecenie kosztuje kilka sekund więcej. Pełna precyzja to 31,7 GB i nie wejdzie na żadną kartę konsumencką.
Wszystkie pliki z rozmiarami
Model generujący obraz
| Plik | Precyzja | Rozmiar |
|---|---|---|
qwen_image_2.1_bf16 | pełna | 14,2 GB |
qwen_image_2.1_int8_convrot | ośmiobitowa | 7,26 GB |
Koder tekstu - to on decyduje o rachunku za pamięć
| Plik | Precyzja | Rozmiar |
|---|---|---|
qwen3vl_8b_bf16 | pełna | 17,5 GB |
qwen3vl_8b_int8_convrot | ośmiobitowa | 9,35 GB |
qwen3vl_8b_w4a8 | czterobitowa | 6,31 GB |
To jest rzecz, którą warto zauważyć: w pełnej precyzji koder tekstu jest większy od samego modelu obrazowego - 17,5 GB wobec 14,2 GB. Model obrazowy ma 7 miliardów parametrów, a koder to osobny model wielomodalny o ośmiu miliardach.
Dekoder i warianty z ulepszaczem poleceń
| Plik | Rozmiar | Po co |
|---|---|---|
qwen_image_2.1_vae_bf16 | 676 MB | Obowiązkowy, jeden wariant |
qwen3.5_9b_...pe_t2i.int8 | 9,47 GB | Ulepszacz poleceń, tekst na obraz |
qwen3.5_9b_...pe_i2i.int8 | 9,47 GB | Ulepszacz poleceń, obraz na obraz |
Dwa ostatnie to wariant dziewięciomiliardowy przepisujący Twoje polecenie na bogatsze. Nie są konieczne - u mnie model działa bez nich i wszystkie zmierzone czasy dotyczą zestawu bez ulepszacza.
Co wejdzie na Twoją kartę
| Zestaw | Razem | Karta |
|---|---|---|
| Pełna precyzja | 31,7 GB | Poza zasięgiem kart konsumenckich |
| Model pełny + koder int8 | 24,2 GB | Na granicy nawet przy 24 GB |
| Oba int8 | 16,6 GB | 24 GB z zapasem, 16 GB na styk |
| Model int8 + koder czterobitowy | 13,6 GB | 16 GB z zapasem |
| Model int8, koder na procesorze | 7,9 GB | 8-12 GB |
Rozmiary plików to nie to samo co zużycie pamięci w trakcie pracy - dochodzą jeszcze dane pośrednie, rosnące z rozdzielczością. Do każdego wiersza doliczaj około 2 GB zapasu przy pracy w 2K.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Moje pomiary na RTX 4090
Karta ma 24 564 MB. Wariant int8, 25 kroków, próbnik euler:
- ComfyUI zameldował 6 920 MB przygotowane na model obrazowy i 644 MB na dekoder.
- Obraz 2048×2048 - 44 sekundy. 2752×1536 - 46 sekund. 1024×1024 przy 12 krokach - 8,4 sekundy, czyli 4,8 kroku na sekundę.
- Przy żadnej rozdzielczości nie było przerzucania danych między kartą a pamięcią komputera.
Co wychodzi z wariantu int8
Cała dyskusja o precyzji ma sens tylko wtedy, gdy widać wynik. Wszystkie obrazy w tym tekście i w całym tym cyklu powstały na wariancie ośmiobitowym - tym, który mieści się na karcie z 24 GB z zapasem.
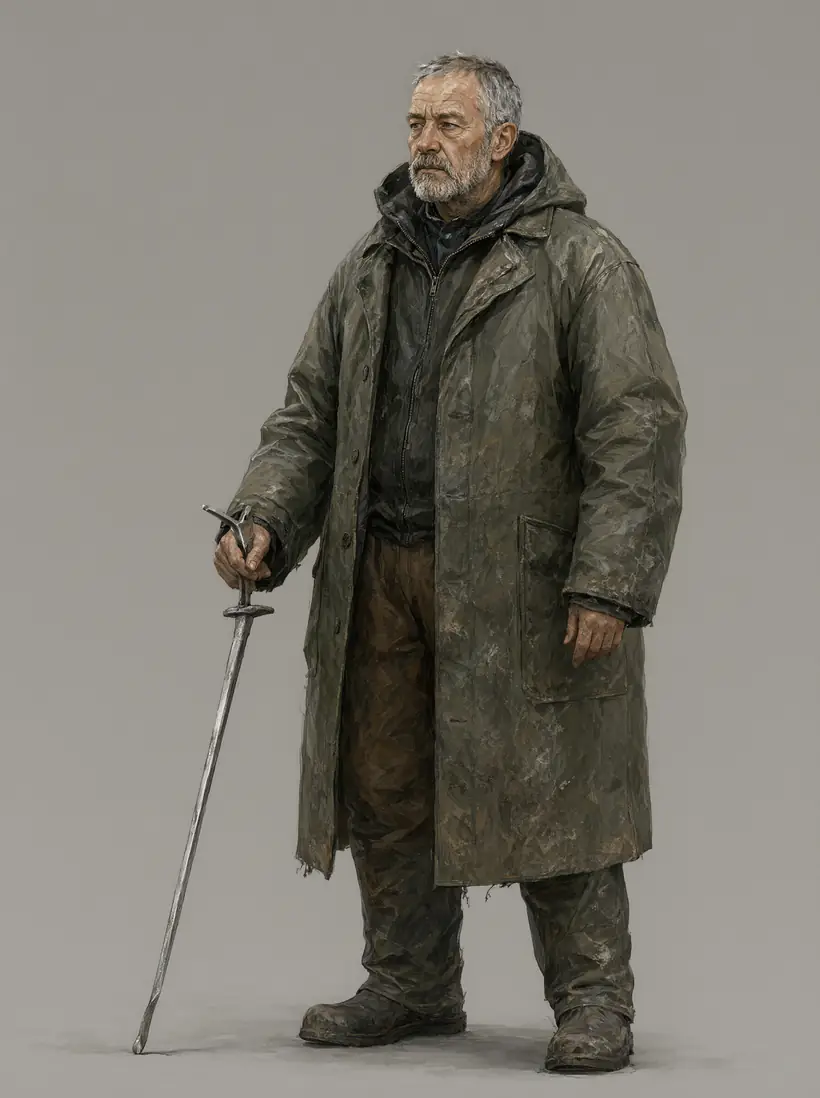
Projekt postaci z wariantu int8 - detal twarzy i materiału bez widocznej utraty jakości.
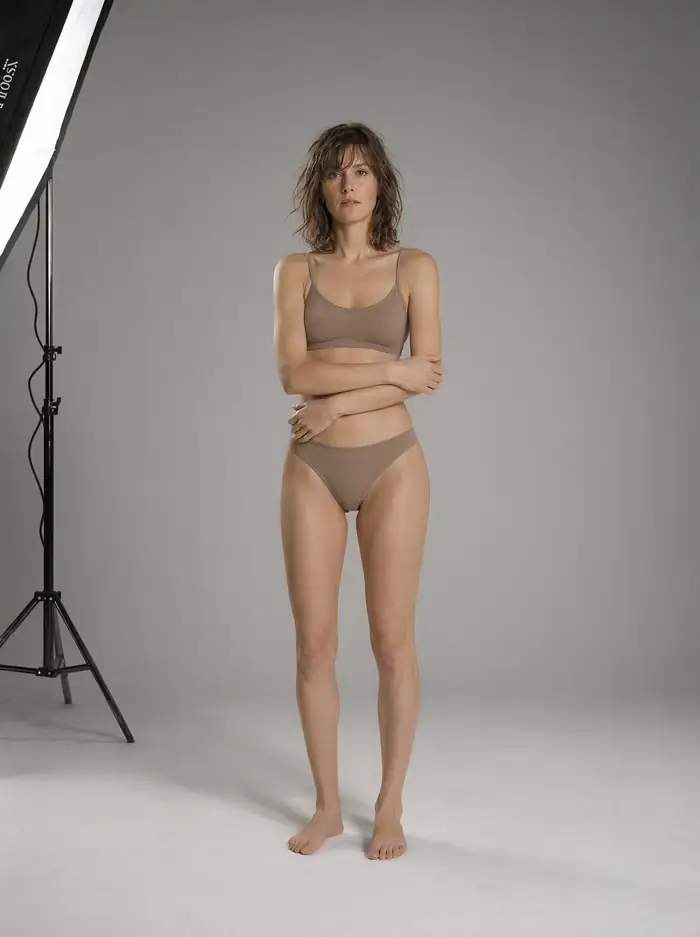
Studio ze średniego formatu: miękkie przejścia tonalne, które przy zbyt agresywnej kwantyzacji pękają jako pasma.
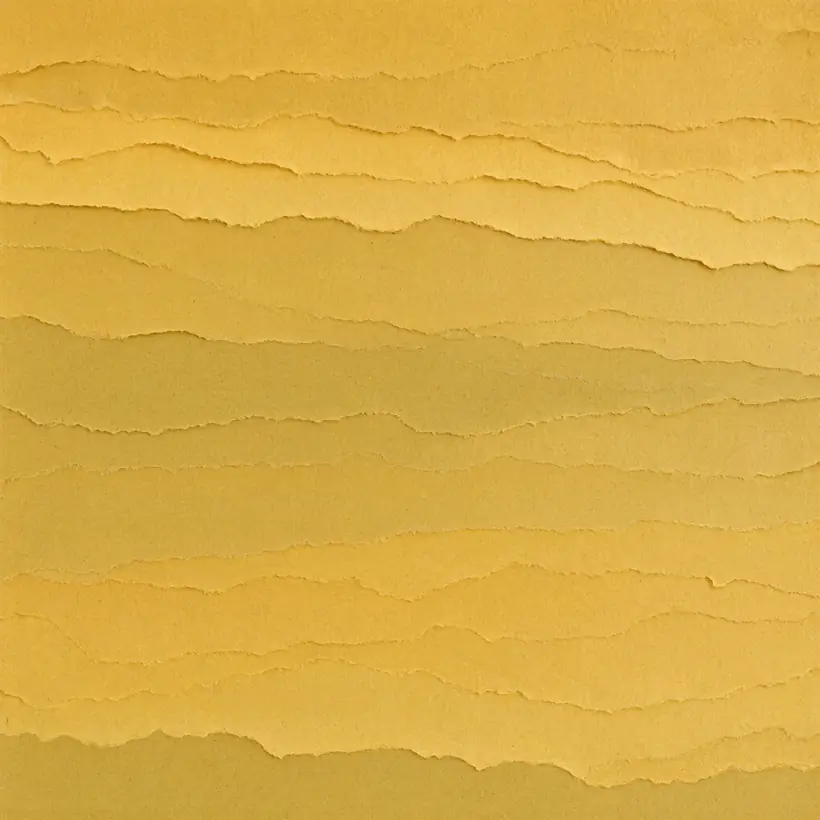
Tekstura papieru czerpanego - test na szum i banding w płaskich obszarach.
Sztuczka dla słabszych kart: koder tekstu na procesor
Koder tekstu wykonuje swoją pracę raz na polecenie, a potem stoi bezczynnie przez wszystkie kroki generowania. To najlepszy kandydat do przeniesienia poza kartę.
W ComfyUI węzeł ładujący koder ma ustawienie urządzenia - przestawiasz je z domyślnego na procesor. Zyskujesz od 6,31 do 17,5 GB pamięci karty zależnie od wariantu, a tracisz kilka sekund na każde nowe polecenie.
Kiedy to się opłaca: gdy generujesz wiele obrazów z tego samego polecenia - koder liczy raz, a Ty dostajesz całą pamięć karty na generowanie. Kiedy nie: gdy przy każdym obrazie zmieniasz opis.
Trzy zasady doboru wariantu
- Zaczynaj od int8. Różnica jakości wobec pełnej precyzji jest przy większości zastosowań niewidoczna, a pamięci zajmuje o połowę mniej.
- Oszczędzaj na koderze, nie na modelu obrazowym. To koder jest większy, a jego udział w wyglądzie obrazu jest pośredni.
- Nie mieszaj pełnej precyzji z int8 na karcie 24 GB. Zestaw 24,2 GB jest teoretycznie w zasięgu, ale w praktyce zabraknie miejsca na dane pośrednie przy 2K.
Jak to wszystko poskładać w działającą instalację, opisałem w osobnej instrukcji - razem z pułapką, przez którą model uruchamia się na procesorze mimo dobrej karty.
Najczęstsze pytania
Ile VRAM potrzebuje Qwen-Image-2.1?
16,6 GB w wariancie int8 na komplet plików. Karta z 24 GB ma zapas, z 16 GB jest na granicy, poniżej trzeba przenieść koder tekstu na procesor.
Czy zadziała na karcie z 12 GB?
Tak, z koderem tekstu na procesorze - na karcie zostaje wtedy 7,9 GB plików. Każde nowe polecenie kosztuje kilka sekund więcej.
Czy wariant int8 psuje jakość?
W moich testach nie zauważyłem różnic przy typowych zastosowaniach, ale nie porównywałem obu wariantów na tym samym ziarnie - to jest obserwacja, nie pomiar.
Po co są pliki z ulepszaczem poleceń?
Przepisują Twoje polecenie na bogatsze przed podaniem go modelowi. Nie są konieczne, model działa bez nich.
Dlaczego koder tekstu jest większy od modelu obrazowego?
Bo to osobny model wielomodalny o ośmiu miliardach parametrów, a część generująca obraz ma siedem miliardów i prostszą budowę.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła i data sprawdzenia
Rozmiary plików odczytane 22 września 2026 z repozytorium Comfy-Org/Qwen-Image-2.1. Zużycie pamięci, czasy generowania i obserwacje o przerzucaniu danych to moje pomiary na RTX 4090 z 24 564 MB. Sumy w tabeli zestawów to proste dodawanie rozmiarów plików i nie uwzględniają danych pośrednich w trakcie pracy.
 Pentagon broni xAI w sądzie: „Grok jest potrzebny do wojny”Newsy
 AI w newsroomach potrzebuje redaktora, nie autopilota. Najcenniejszy będzie dobry filtrPremium
 Robotyka potrzebuje mniej humanoidów, a więcej zdrowego rozsądku. Prawdziwa rewolucja zacznie się od magazynuPremium
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →- przewagi.plAgent AI w małej firmie w 2026: co zrobi sam, ile kosztuje (od 14 900 zł netto) i gdzie potrzebny jest człowiek
- dobieracz.plNano Banana (Gemini Image)
- przelomowy.plNeurIPS 2026 w trzech miastach naraz. Przed startem 178 prac odpadło przez detektor tekstu AI
- generatornia.plList do świętego mikołaja szablon AI: wzory i prompty do druku