Qwen-Image-2.1 w rankingu: pełna tabela 29 modeli obrazowych z liczbami
Siódme miejsce na 29 modeli, a przed nim wyłącznie modele zamknięte. Ciekawsze jest to, kogo zostawił za sobą.
👁 112 przeczytań
- Qwen-Image-2.1 zajmuje siódme miejsce w rankingu Qwen-Image-Bench z wynikiem 60,28 punktu, a przed nim są wyłącznie modele zamknięte o nieujawnionym rozmiarze.
- Model ma 7 miliardów parametrów i bije Hunyuan Image 3.0 (80 miliardów parametrów, wynik 50,81) o ponad 9 punktów, mieszcząc się przy tym na jednej karcie konsumenckiej RTX 4090.
- Lider rankingu, GPT Image 2.5 Sunburst, osiąga 67,01 punktu, więc Qwen-Image-2.1 traci do niego 6,73 punktu, a nie kilkadziesiąt jak jeszcze w poprzednich generacjach.
Producent Qwen-Image-2.1 opublikował przy premierze wykres porównujący 29 modeli obrazowych - otwartych i zamkniętych. Nikt nie podał go w formie tabeli, więc odczytałem liczby z wykresu i zestawiłem je z rozmiarami modeli. Wynik jest ciekawszy niż samo miejsce w rankingu.
Werdykt w jednym akapicie
Qwen-Image-2.1 zajmuje siódme miejsce z wynikiem 60,28 punktu w rankingu Qwen-Image-Bench. Przed nim są wyłącznie modele zamknięte, których producenci nie ujawniają rozmiaru. Ciekawsze jest to, co dzieje się za nim: wyprzedza Nano Banana 2.0, GPT Image 1.5, Seedream 5 Pro i Nano Banana Pro, a także FLUX 2 Max, który jest od niego czterokrotnie większy, i Hunyuan Image 3.0 - większy jedenastokrotnie. To jest model o 7 miliardach parametrów bijący model o osiemdziesięciu o ponad dziewięć punktów.
Pełny ranking Qwen-Image-Bench
Liczby odczytane z wykresu opublikowanego przez producenta. Kolumna z rozmiarem jest pusta tam, gdzie producent modelu go nie ujawnia - na wykresie zaznaczono to kłódką.
| # | Model | Wynik | Rozmiar |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67,01 | nieujawniony |
| 2 | GPT Image 2 | 64,69 | nieujawniony |
| 3 | Grok Imagine 2.0 | 63,47 | nieujawniony |
| 4 | Qwen Image 3 Pro | 62,36 | nieujawniony |
| 5 | Muse Image | 62,34 | nieujawniony |
| 6 | MAI Image 2.5 Pro | 61,02 | nieujawniony |
| 7 | Qwen-Image-2.1 | 60,28 | 7B |
| 8 | Nano Banana 2.0 | 59,82 | nieujawniony |
| 9 | GPT Image 1.5 | 59,65 | nieujawniony |
| 10 | Seedream 5 Pro | 59,53 | nieujawniony |
| 11 | Nano Banana Pro | 59,45 | nieujawniony |
| 12 | Grok Imagine Quality | 58,47 | nieujawniony |
| 13 | Qwen Image 2.0 Pro | 57,84 | nieujawniony |
| 14 | Seedream 5.0 | 57,22 | nieujawniony |
| 15 | Seedream 4.5 | 56,78 | nieujawniony |
| 16 | Seedream 4.0 | 56,21 | nieujawniony |
| 17 | FLUX 2 Max | 55,33 | 32B |
| 18 | FLUX 2 Pro | 54,57 | 32B |
| 19 | GPT Image 1 | 54,07 | nieujawniony |
| 20 | Qwen Image 2512 | 52,06 | 20B |
| 21 | Imagen 4.0 Ultra | 51,99 | nieujawniony |
| 22 | Boogu | 51,40 | 10B |
| 23 | Hunyuan Image 3.0 | 50,81 | 80B |
| 24 | Imagen 4.0 | 50,29 | nieujawniony |
| 25 | Qwen Image | 49,23 | 20B |
| 26 | Kling Image 2.1 | 48,26 | nieujawniony |
| 27 | GLM Image | 48,19 | 16B |
| 28 | LongCat | 46,34 | 6B |
| 29 | HiDream O1 | 46,17 | około 8B |
Zastrzeżenie, które trzeba postawić wprost: to jest benchmark opublikowany przez producenta jednego z ocenianych modeli. Traktuj go jak materiał producenta, bo nim jest. Nie znaczy to, że liczby są zmyślone - znaczy, że zestaw zadań i sposób punktowania wybrała strona zainteresowana wynikiem.
Trzy rzeczy, które widać dopiero po zestawieniu z rozmiarem
1. Skok wewnątrz własnej rodziny
| Wydanie | Rozmiar | Wynik |
|---|---|---|
| Qwen Image | 20B | 49,23 |
| Qwen Image 2512 | 20B | 52,06 |
| Qwen-Image-2.1 | 7B | 60,28 |
Prawie trzykrotnie mniejszy model dostaje o 8,22 punktu więcej od bezpośredniego poprzednika. To nie jest zwykła aktualizacja, tylko inna architektura - warstwy jednostrumieniowe, mieszana ziarnistość uwagi i ponowne użycie pamięci podręcznej.
2. Rozmiar przestał być przepustką do czołówki
Hunyuan Image 3.0 ma 80 miliardów parametrów i wynik 50,81. Qwen-Image-2.1 ma 7 miliardów i 60,28. Różnica to jedenastokrotność rozmiaru na korzyść przegranego.
Praktyczna konsekwencja dla kogoś, kto liczy sprzęt: model, który daje lepszy wynik, mieści się na jednej karcie konsumenckiej, a ten większy wymaga serwerowni. To jest opinia: dla większości zastosowań to zamyka dyskusję o tym, który wybrać.
3. Zamknięte modele wciąż prowadzą, ale przewaga stopniała
Do lidera brakuje 6,73 punktu, do trzeciego miejsca - 3,19. Model otwarty, który da się uruchomić w domu, jest dziś pięć punktów za czołówką, a nie dwadzieścia. Za nim zostały natomiast modele, za które płaci się za każdy obraz.
Co model dostał w tym wydaniu
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Producent wymienia cztery zmiany:
- Zwarta architektura - 32 warstwy DiT, mieszana ziarnistość uwagi, ponowne użycie pamięci podręcznej kluczy i wartości przy wielu obrazach wejściowych.
- Natywna przezroczystość - możliwość wpisania w polecenie, że obraz ma mieć kanał alfa, oraz wycinanie obiektów ze zdjęć jako warstw. Sprawdziłem to pomiarem.
- Edycja - do dziesięciu obrazów odniesienia, wskazywanie miejsca edycji kółkiem, zamalowaniem albo maską, zachowanie tożsamości osób i wyglądu produktów.
- Tekstury i typografia - lepsze światło na portretach i układ napisów uwzględniający krój oraz kompozycję.
Do tego panoramy z pojedynczego zdjęcia, infografiki i scenorysy z arkusza postaci.
Jak to sprawdziłem u siebie
Postawiłem model lokalnie na RTX 4090 i puściłem sześć testów. Dwa wnioski, których w materiałach producenta nie ma:
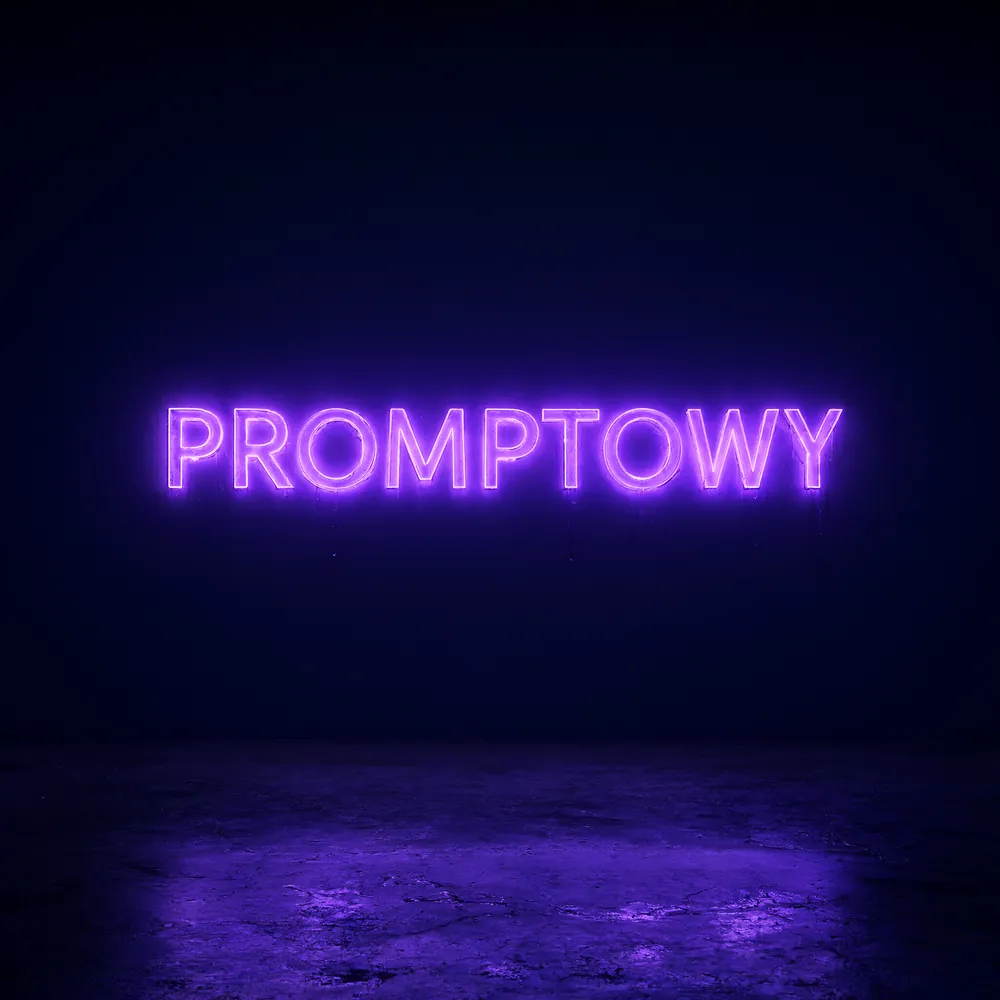
Neon z napisem PROMPTOWY wygenerowany lokalnie w rozdzielczości 2048×2048 - napis wyszedł bezbłędnie za pierwszym razem.
- Napisy faktycznie się zgadzają. Neon z napisem PROMPTOWY w 2048×2048 wyszedł bezbłędnie za pierwszym razem.
- Polecenia dotyczące wieku postaci bywają ignorowane. Prośba o portret kobiety po trzydziestce dała osobę wyraźnie starszą - technicznie znakomitą, ale niezgodną z poleceniem.
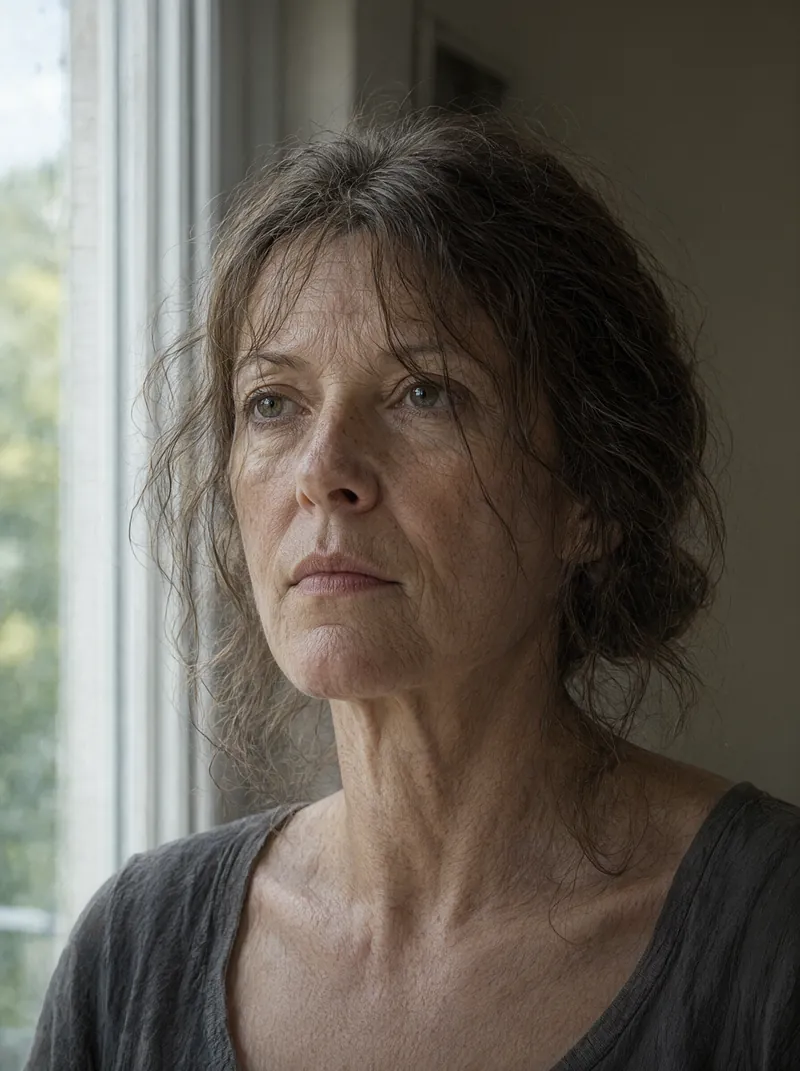
Portret z polecenia o kobiecie po trzydziestce. Faktura skóry i światło bez zarzutu, wiek postaci wyraźnie wyższy od zamówionego.
Czasy, ustawienia i gotowy skrypt są w instrukcji instalacji, a całość zebrałem w przewodniku po modelu.
Najczęstsze pytania
Jaki wynik ma Qwen-Image-2.1 w benchmarku?
60,28 punktu w Qwen-Image-Bench, siódme miejsce wśród 29 porównanych modeli.
Czy to najlepszy otwarty model obrazowy?
W tym zestawieniu tak - wyprzedza FLUX 2 Max (55,33), Hunyuan Image 3.0 (50,81) i GLM Image (48,19). Pamiętaj, że ranking pochodzi od producenta.
Ile ma parametrów?
7 miliardów w części generującej obraz, w 32 warstwach DiT jednostrumieniowych.
Który model wygrywa ranking?
GPT Image 2.5 Sunburst z wynikiem 67,01, przed GPT Image 2 (64,69) i Grok Imagine 2.0 (63,47).
Czy jest lepszy od Nano Banana?
Według tego rankingu tak: 60,28 wobec 59,82 dla Nano Banana 2.0 i 59,45 dla Nano Banana Pro. Różnica jest jednak niewielka.
Źródła i data sprawdzenia
Wyniki odczytane 22 września 2026 z wykresu Qwen-Image-Bench opublikowanego w ogłoszeniu premiery na qwen.ai; opis architektury i funkcji z tego samego ogłoszenia oraz z karty modelu Qwen/Qwen-Image-2.1. Producent podał te dane w formie wykresu, nie tabeli - liczby w tabeli powyżej to odczyt redakcji z tego wykresu. Obserwacje o napisach i wieku postaci pochodzą z moich własnych testów na RTX 4090.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Jakie miejsce zajmuje Qwen-Image-2.1 w rankingu modeli obrazowych?
Qwen-Image-2.1 zajmuje siódme miejsce spośród 29 porównanych modeli z wynikiem 60,28 punktu w Qwen-Image-Bench. Wszystkie sześć modeli przed nim to modele zamknięte, których producenci nie ujawnili rozmiaru.
Czy Qwen-Image-2.1 działa na domowym sprzęcie, np. RTX 4090?
Tak, model uruchamia się lokalnie na RTX 4090. Autor artykułu przeprowadził na tej karcie sześć własnych testów, w tym generowanie neonu z napisem PROMPTOWY w rozdzielczości 2048x2048.
Ile parametrów ma Qwen-Image-2.1 i jak wypada na tle większych modeli?
Qwen-Image-2.1 ma 7 miliardów parametrów w 32 warstwach DiT. Dla porównania FLUX 2 Max ma 32 miliardy parametrów i wynik 55,33, a Hunyuan Image 3.0 ma 80 miliardów i wynik 50,81 - oba niższe niż 60,28 Qwena.
Czy benchmark Qwen-Image-Bench jest wiarygodny?
Ranking został opublikowany przez producenta jednego z ocenianych modeli, czyli Qwen, co oznacza, że zestaw zadań i sposób punktowania wybrała strona zainteresowana wynikiem. Autor artykułu zastrzega wprost, że należy traktować go jak materiał producenta, a nie niezależny test.
Podobne tematy na Promptowym