Nowe lokalne modele AI, październik 2026: wideo, obraz, muzyka
Nowe otwarte modele z października 2026 na moim RTX 4090: Kandinsky 6 do wideo z dźwiękiem, Qwen Turbo i FLUX 3 Klein do obrazów, YuE2 do piosenek.
👁 119 przeczytań
- Spośród czterech testowanych modeli do generowania piosenek najrówniejszy wynik po polsku osiągnął ACE-Step 1.5 ze średnią 95,6% rozpoznanych słów i licencją MIT.
- Qwen-Image 2.1 Turbo skraca generowanie obrazu do 3-4 sekund zamiast 13-20 sekund, ale ma licencję wyłącznie do badań, bez możliwości użytku komercyjnego.
W październiku 2026 wyszło kilka otwartych modeli, które warto mieć na własnym komputerze: Kandinsky 6.0 do wideo z dźwiękiem, Qwen-Image 2.1 Turbo i FLUX 3 Image Klein do obrazów oraz YuE2 do piosenek z wokalem. Pobrałem je na RTX 4090, uruchomiłem w ComfyUI i zmierzyłem czasy, pamięć i to, jak radzą sobie z polskim. Poniżej zbiorcza lista z wynikami i linkami do pełnych testów.
Stan na 17 października 2026, w skrócie
- Wideo: Kandinsky 6.0 Lite robi klip 5 s z dźwiękiem w ok. 2 min, Pro w ok. 6,5 min. Licencja MIT.
- Obrazy: Qwen-Image 2.1 Turbo robi obraz w 3-4 s zamiast 13-20 s. Licencja tylko do badań.
- Muzyka: YuE2 śpiewa po polsku wyraźnie (średnio 91,2% słów z 3 prób), ale najrówniejszy był ACE-Step 1.5 (95,6%) na licencji MIT.
- FLUX 3 Klein: 6-7 s na obraz przy zaledwie 7,5 GB VRAM, czyli zmieści się też na kartach 8-12 GB.
Na czym testowałem
- Karta RTX 4090 24 GB, 64 GB RAM, procesor i9-14900KF, Windows 11.
- ComfyUI 0.41.0 (zaktualizowany z 0.37, bo starszy nie obsługuje FLUX 3, YuE2 i Qwen Turbo).
- Modele na dysku SSD 8 TB po USB. Z dysku NVMe pierwsze ładowanie byłoby krótsze.
- Czas liczę od wysłania zadania do zapisanego pliku. VRAM to szczyt zajętości całej karty z nvidia-smi.
Tabela zbiorcza
| Model | Do czego | Wynik na RTX 4090 | Licencja |
|---|---|---|---|
| Kandinsky 6.0 Lite | wideo 5 s + dźwięk | 1:51-2:28 min, 19-20 GB | MIT |
| Kandinsky 6.0 Pro (int8) | wideo 5 s + dźwięk | 6:18-6:52 min, 21 GB + 29 GB w RAM | MIT |
| Qwen-Image 2.1 Turbo | obrazy | 3-4 s na obraz, 17-19 GB | Qwen Research |
| YuE2 | piosenki z wokalem | piosenka 2 min w 1-2 min, 13-16 GB | CC BY-NC 4.0 |
| DiffRhythm 2 | piosenki z wokalem | ok. 1 min na 2 min piosenki, tylko EN/ZH | Apache 2.0 |
| FLUX 3 Image Klein | obrazy i edycja | 6-7 s na obraz, 7,5 GB | FLUX Kommunity |
Wideo: Kandinsky 6.0
Najciekawsza nowość miesiąca. Kandinsky 6.0 od Kandinsky Lab generuje obraz i dźwięk w jednym przebiegu: mowę z ruchem ust, odgłosy i muzykę w tle. Wersja Lite ma 3 mld parametrów i mieści się w 24 GB, Pro ma 29 mld i na RTX 4090 działa tylko z częścią wag w RAM.
- Pro wypowiedział polskie zdanie „Dzień dobry! Jabłka prosto z sadu, słodkie jak miód!” w 7 słowach na 9, angielskie bezbłędnie.
- Lite jest ponad 3 razy szybszy, ale mowę po polsku przekręca.
- Licencja MIT bez wyłączeń krajów. To ważne, bo konkurencyjny MiniMax H3 ma wagi, których w UE używać nie wolno.
Osiem klipów z dźwiękiem, tabela czasów i instrukcja instalacji są w teście Kandinsky 6.0 Video lokalnie.
Obrazy: Qwen-Image 2.1 Turbo
Destylowana wersja najlepszego otwartego modelu obrazowego z rankingu Artificial Analysis. 8 kroków zamiast 25, a różnicę w jakości trudno zobaczyć bez zestawienia obok siebie. W moim teście „JAZZ NAD ODRĄ” i „OCET 12 zł” wyszły poprawnie, „Wrocław” stracił „ł”.
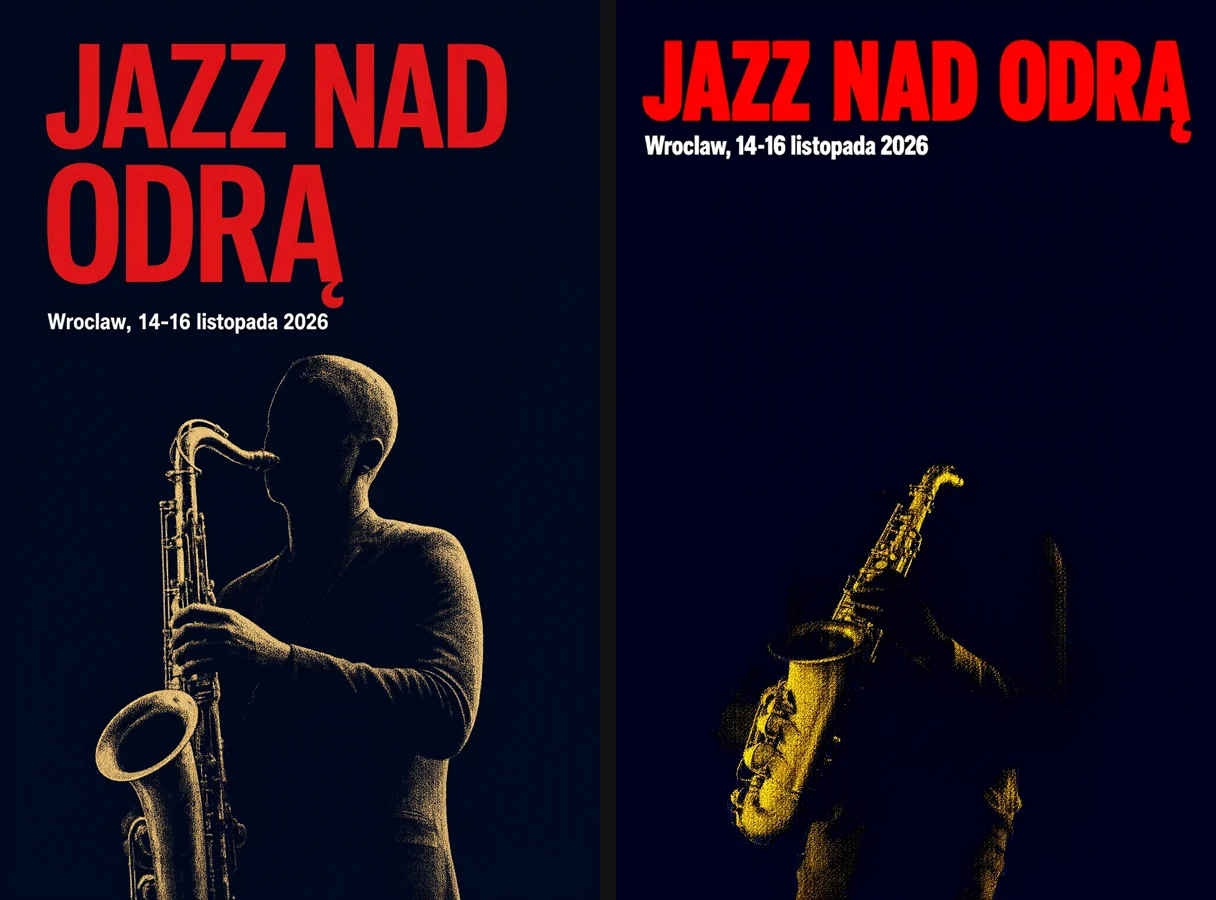
Pełne porównanie czterech poleceń: Qwen-Image 2.1 Turbo lokalnie.
Obrazy: FLUX 3 Image Klein
Black Forest Labs wypuściło 13-15 października pierwszy otwarty model z rodziny FLUX 3. Klein ma 5,6 mld parametrów, robi obrazy z tekstu, edycję i kompozycje z maksymalnie 10 obrazów referencyjnych. Enkoderem tekstu jest Qwen3-VL-4B, a VAE jest ten sam co we FLUX.2. ComfyUI obsługuje go natywnie od wersji 0.41.
- Pliki do ComfyUI: model int8 5,83 GB, enkoder int8 4,86 GB, VAE 0,34 GB.
- Producent wprost zaleca rozbudowę polecenia przed generowaniem (osobny „prompt upsampler” na Qwen 3.5 9B albo dowolny model językowy). Krótkie polecenie daje generyczny obraz.
- Repozytorium jest za akceptacją licencji FLUX Kommunity, więc do pobrania potrzebne jest konto i token Hugging Face.
Mój pomiar: 6-7 s na obraz 1024×1536 (15 kroków, int8) i szczyt 7,5 GB VRAM na całej karcie, ponad dwa razy mniej niż Qwen Turbo. Polskie napisy wypadły tak samo jak w Qwen Turbo: „ODRĄ” i „12 zł” poprawnie, „Wrocław” bez „ł”. Porównanie na tych samych poleceniach i instrukcja pobrania są w teście FLUX 3 Image Klein lokalnie, a wersja w chmurze w przewodniku FLUX 3 Image po polsku.
Muzyka: YuE2 i porównanie czterech modeli
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Ten sam polski tekst (ballada, dwie zwrotki, dwa refreny) dałem czterem lokalnym modelom i przepuściłem wynik przez Whisper large-v3. Liczyłem, jaki procent słów z tekstu da się rozpoznać w nagraniu.
| Model | Polski: rozpoznane słowa | Angielski | Licencja |
|---|---|---|---|
| ACE-Step 1.5 | 95,6% (średnia z 3) | 96,1% | MIT |
| YuE2 | 91,2% (84-99%) | 100% | CC BY-NC 4.0 |
| MiniMax Music 3 | 89,2%, ucina piosenki | 92,1% | MiniMax Community |
| DiffRhythm 2 | 4,8% (brak polskiego) | 100% | Apache 2.0 |
YuE2 ma najlepszą pojedynczą próbę po polsku (98,8%) i jest bezbłędny po angielsku, ale ma duży rozrzut i licencję bez zarabiania. ACE-Step 1.5 wypadł najrówniej i można go używać komercyjnie. Szczegóły, próbki do odsłuchania i ustawienia są w teście YuE2 po polsku.
Co jeszcze wyszło, a czego nie pobrałem
- MiniMax H3 (wideo z dźwiękiem, 33B): licencja wag wyłącza UE, USA, Wielką Brytanię i Koreę Płd., więc w Polsce nie ma prawa do używania. Nawet przycięta wersja FastH3 na 8 GB VRAM tego nie zmienia.
- HY Image 3.5 Preview od Tencenta: obsługa w ComfyUI od 13.10. Opisałem go w teście polskich napisów i edycji.
- MAGI-2 i LTX-2.5: porównanie w tekście Otwarte modele wideo 2026.
Od czego zacząć
- Zainstaluj albo zaktualizuj ComfyUI do 0.41: poradnik ComfyUI od zera.
- Na start pobierz FLUX 3 Klein (ok. 11 GB, działa nawet na kartach 8-12 GB) albo Qwen-Image 2.1 Turbo (7,3 GB + 10 GB wspólnych plików, najszybszy na 24 GB).
- Do wideo weź Kandinsky 6.0 Lite (6,4 GB + ok. 18 GB wspólnych plików).
- Do piosenek ACE-Step 1.5 (najrówniejszy po polsku, MIT) albo YuE2 (7,8 GB + 1,4 GB) do angielskich tekstów i do użytku prywatnego.
Pełną listę modeli, które sprawdziłem lokalnie, łącznie z modelami językowymi, mam w przewodniku Lokalne AI.
Najczęstsze pytania
Czy wystarczy karta 16 GB?
Do Qwen Turbo, YuE2 i Kandinsky Lite tak, ale z przerzucaniem części wag do RAM i wolniej, niż w moich pomiarach. Kandinsky 6 Pro na 16 GB odradzam.
Które z tych modeli można używać komercyjnie?
Kandinsky 6.0 (MIT), DiffRhythm 2 (Apache 2.0) i ACE-Step 1.5 (MIT). Qwen-Image 2.1 Turbo ma licencję tylko do badań, YuE2 CC BY-NC 4.0. FLUX 3 Klein ma własną licencję FLUX Kommunity, zanim zaczniesz na nim zarabiać, przeczytaj jej warunki.
Ile miejsca na dysku to zajmuje?
Wszystko z tej listy (z Kandinsky Pro w int8, bez oficjalnego bf16) to ok. 100 GB. Sam Kandinsky Pro w int8 to 30,5 GB, w bf16 60,3 GB.
Czy to działa na Macu?
Testowałem tylko na Windowsie z kartą NVIDIA. Część modeli ma wersje MLX na Maca (np. YuE2 i Qwen Turbo), ale ich nie sprawdzałem.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła
- Kandinsky 6.0 na Hugging Face
- Qwen-Image 2.1 Turbo na Hugging Face
- FLUX 3 Image Klein na Hugging Face
- YuE2 na Hugging Face
- DiffRhythm 2 na GitHubie
- Lista zmian ComfyUI
- Pomiary własne na RTX 4090, 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym