Lejek Karpathy’ego. Dlaczego Polska nie dogaduje się o AI?
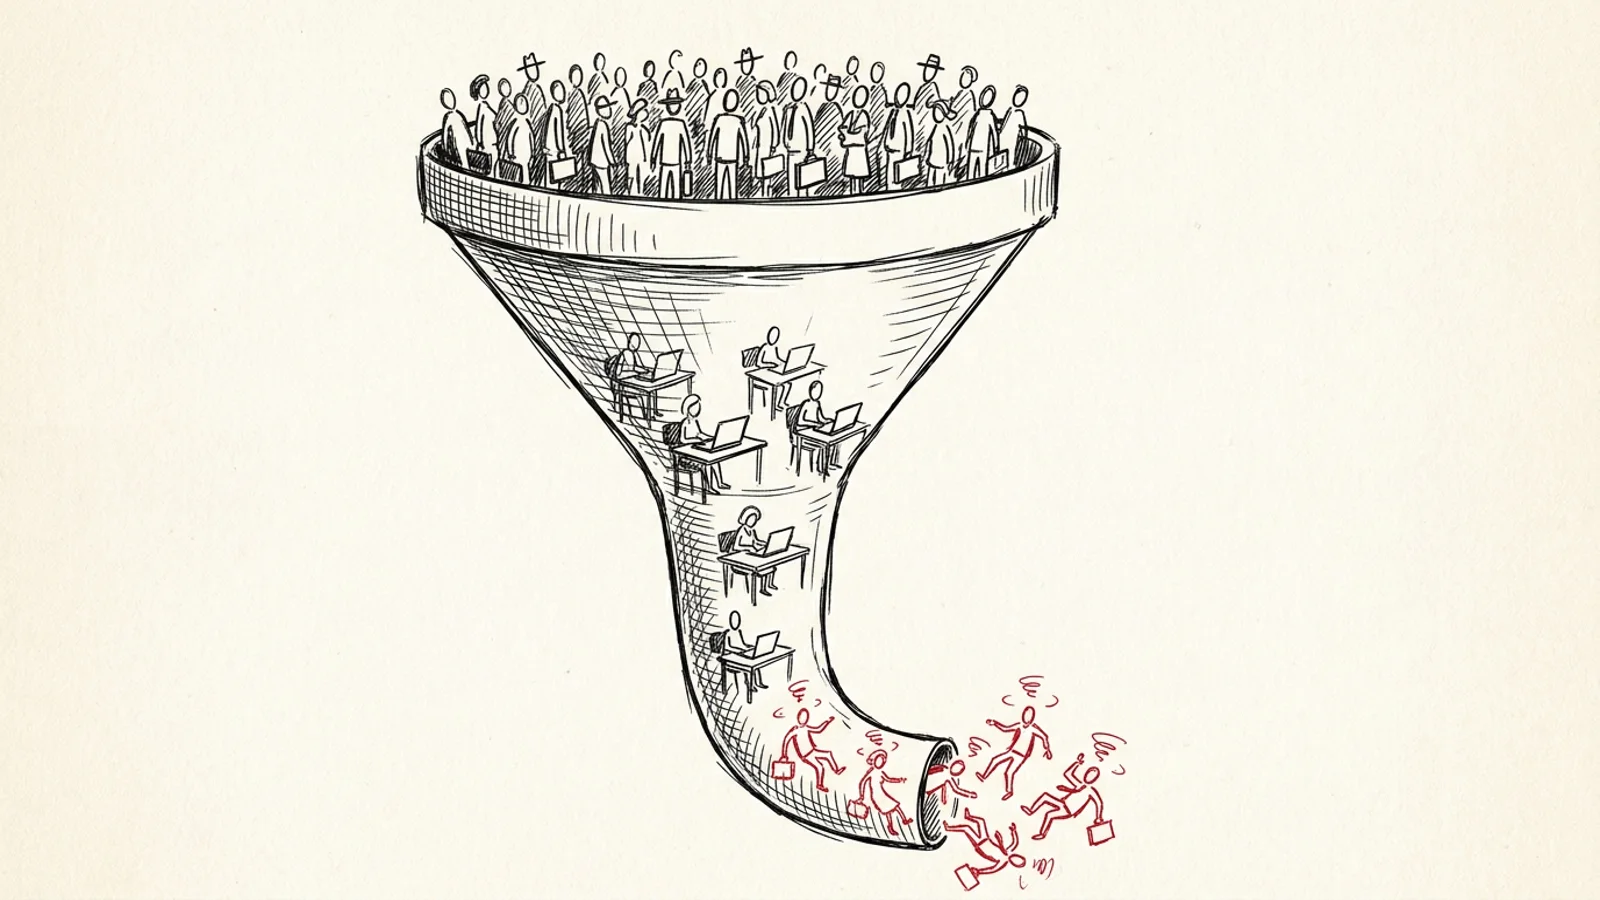
Użytkownicy AI obserwują różne możliwości, zadania i poziomy dostępu. Lejek Karpathy’ego tłumaczy część sporów, ale nie daje ekspertom monopolu na ocenę przyszłości.
👁 120 przeczytań
- Polska debata o AI jest często konfliktem pozycji obserwacyjnych, bo każdy ocenia narzędzie w innym fragmencie pracy i z innym kryterium sukcesu.
- Karpathy szacuje, że z zaawansowanych LLM profesjonalnie korzysta ok. 20 mln ludzi, a dostęp wewnętrzny do najlepszych systemów ma zaledwie ok. 5 tys. osób.
- Według raportu Microsoft Global AI Diffusion Q2 2026 Polska i Niemcy mają identyczny wynik 32,3%, podczas gdy USA osiągają 33,0%, a ZEA aż 73,3%.
Polski spór o AI często przypomina rozmowę o różnych urządzeniach prowadzoną pod wspólną nazwą. Lejek Andreja Karpathy’ego pomaga zrozumieć rozjazd doświadczeń, ale nie daje nikomu prawa do ogłoszenia się właścicielem przyszłości tylko dlatego, że ma droższy dostęp.
Można wyobrazić sobie rozmowę przy stole. Programista opowiada o zadaniu, które powierzył systemowi, właścicielka małej firmy wspomina rozczarowującą próbę napisania oferty, a ktoś inny przyznaje, że właściwie z takich narzędzi nie korzysta. Każda z tych osób używa słowa AI. Każda przynosi inny zakres doświadczenia i inne kryterium sukcesu. To scena umowna, nie relacja ze spotkania. Wystarczy jednak, żeby dostrzec podstawową trudność: spór zaczyna się, zanim uczestnicy ustalą, co właściwie porównują.
Najłatwiejszym wyjaśnieniem jest zarzut niewiedzy. Entuzjasta uzna, że sceptyk nie spróbował odpowiedniego narzędzia. Sceptyk odpowie, że entuzjasta pomylił demonstrację z normalną pracą. Obaj mogą wskazać prawdziwe doświadczenia, a mimo to mówić obok siebie. Moja teza brzmi tak: część polskiej debaty o AI jest konfliktem pozycji obserwacyjnych. Żeby była użyteczna, trzeba ujawnić warunki obserwacji, zanim prywatne doświadczenie zamieni się w uniwersalny sąd.
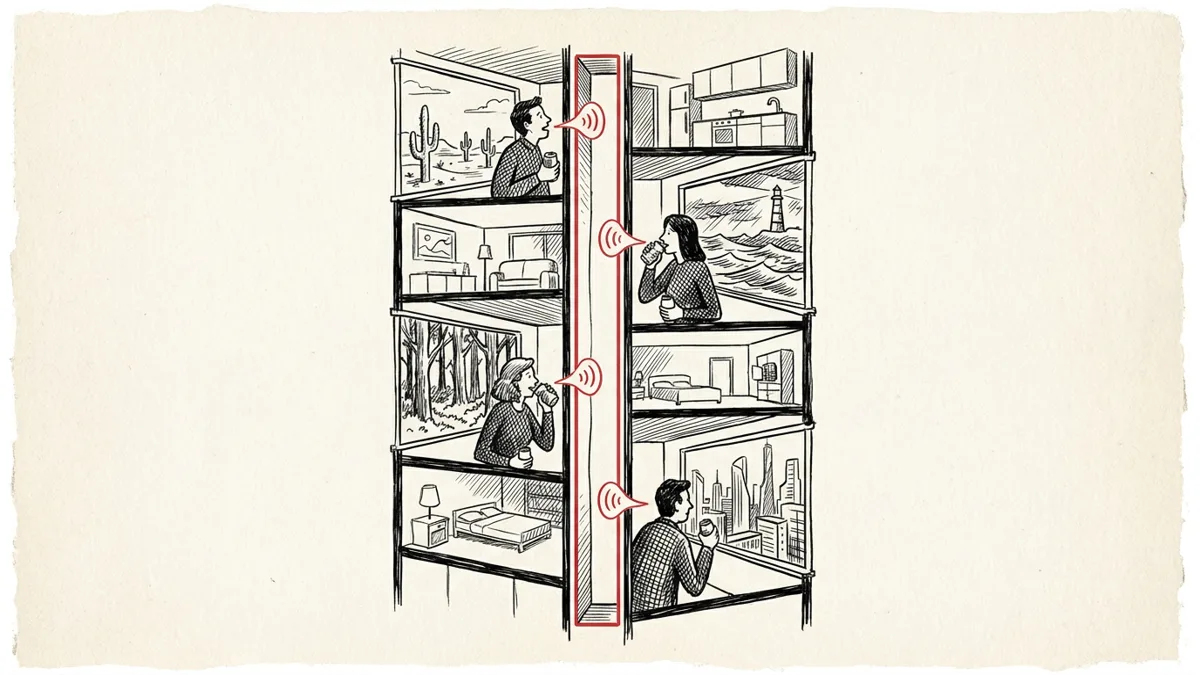
Lejek jest szkicem, nie spisem ludności
„Teraz to mniej dwie grupy mówiące obok siebie, a bardziej ostry lejek”
- Andrej Karpathy, X, 11.10.2026, tłumaczenie własne
11 października 2026 roku Karpathy, którego sylwetkę opisywałem w tekście o Andreju Karpathym, odświeżył na X swój wpis z 9 kwietnia. W kwietniu pisał, że wiele osób wyrobiło sobie zdanie o AI na podstawie darmowej wersji czatu sprzed roku. W październiku dodał, że rozjazd się pogłębia, i rozpisał go na piętra lejka. Liczby nazywa wprost „rachunkami na serwetce”: to jego szacunki, nie wynik badania. Kończy obrazem, który dobrze streszcza całość: większość ludzi widzi niezgrabnego czatbota, większość profesjonalistów widzi umiarkowaną pomoc, a wąska grupa ma zawrót głowy od krzywej, która idzie pionowo w górę.
W liczbach
- Około 6 mld - ludzie prawie niemający kontaktu z LLM, według szacunku Karpathy’ego.
- 1-2 mld - okazjonalni użytkownicy darmowych czatów, według tego samego szacunku.
- Około 20 mln - profesjonalni użytkownicy zaawansowanych LLM w matematyce i programowaniu, według Karpathy’ego.
- Około 5 tys. - osoby z wewnętrznym dostępem do zaawansowanych systemów, według Karpathy’ego; liczba niezależnie niepotwierdzona.
W tej metaforze ważny jest kształt różnic, nie dokładność granic. Nie wiadomo, jak przypisać do jednej grupy osobę, która zawodowo intensywnie używa systemu, ale poza matematyką i programowaniem. Nie wiadomo też, kiedy okazjonalne korzystanie staje się profesjonalne. Nie należy sumować tych liczb jak wyników rozłącznych kategorii badania populacyjnego. Taki zabieg zamieniłby sugestywny opis w pozór statystyki.
Trzeba również rozdzielić kontakt z AI od rozumienia AI. Intensywny użytkownik może dobrze znać własny sposób pracy, a niewiele wiedzieć o społecznych skutkach jego upowszechnienia. Osoba nieużywająca czatu może z kolei trafnie dostrzegać problem odpowiedzialności lub nierównego dostępu. Lejek mówi coś o widoczności możliwości technicznych. Nie jest automatycznie rankingiem rozsądku ani wiarygodności uczestników debaty.
Skala zadania zmienia to, co człowiek widzi
Karpathy wskazuje trzy osie rozjazdu: ambicję zadania, nierówność zdolności modeli oraz poziom dostępu. To użyteczne rozróżnienie, bo tłumaczy, dlaczego samo polecenie, aby ktoś spróbował AI, niewiele załatwia. Ocenę kształtuje nie tylko wynik, ale również punkt wyjścia. Inaczej wygląda narzędzie, które poprawia zdanie, a inaczej narzędzie uczestniczące w rozwiązaniu problemu, nad którym użytkownik pracował już długo.
Przykładem może być hipotetyczna osoba odpowiedzialna za ofertę handlową. Jeśli zasadniczą trudnością jest wynegocjowanie warunków z partnerem, płynnie napisany akapit może nie zmienić wiele. Dla specjalisty, którego problem można rozłożyć na dużą liczbę sprawdzalnych operacji, podobny interfejs może otworzyć zupełnie inne możliwości. Nie jest sprzecznością, że pierwsza osoba widzi umiarkowaną pomoc, a druga przełom. Obie oceniają narzędzie w innym fragmencie pracy.
Entuzjasta ma jednak skłonność do przedstawiania własnego problemu jako reprezentatywnego. Kiedy system pomaga przy zadaniu, które uważa za trudne, łatwo przejść od zachwytu do tezy, że podobnie zmieni każdą profesję. To przejście wymaga dodatkowego dowodu. Trudność techniczna nie jest tą samą rzeczą co trudność organizacyjna, odpowiedzialność za decyzję czy konieczność zdobycia czyjegoś zaufania. Sukces w jednym obszarze nie rozstrzyga automatycznie pozostałych.
Przydatna debata powinna więc zaczynać się od opisu zadania. Co było problemem, co zrobił system, jak sprawdzono wynik i kto ponosił koszt korekty? Takie pytania odbierają wypowiedzi część widowiskowości, ale dodają porównywalność. Relacja o sukcesie staje się wtedy informacją, z której może skorzystać ktoś spoza środowiska autora, zamiast kolejnym świadectwem przynależności do obozu entuzjastów.
Poszarpane zdolności psują prostą drabinę
Karpathy wiąże szczególnie szybkie postępy w kodzie i matematyce z możliwością uzyskania sprawdzalnego sygnału nagrody w uczeniu przez wzmacnianie. To jego wyjaśnienie, nie pełna teoria rozwoju wszystkich modeli. Praktyczne znaczenie tej obserwacji jest jednak czytelne: tam, gdzie rezultat można poddać jednoznacznej kontroli, warunki rozwijania i oceniania systemu różnią się od sytuacji wymagających niejednoznacznego osądu.
Metafora poszarpanego krajobrazu jest pod tym względem lepsza od drabiny. System może zachwycić w zadaniu sprawdzanym formalnie i zawieść przy wyczuciu kontekstu rozmowy. Nie trzeba uznawać jednego z doświadczeń za pomyłkę. Wystarczy zrezygnować z założenia, że istnieje pojedynczy poziom inteligencji, który wyjaśnia każdą odpowiedź. Dla użytkownika liczy się profil możliwości w jego konkretnym środowisku, wraz z rodzajem błędów, które potrafi zauważyć.
To ważne dla polskiej rozmowy zawodowej, bo język debaty łatwo pożycza kryteria od grup najbardziej aktywnych w internecie. Jeśli demonstracje pochodzą głównie z pracy nad kodem, inne profesje stają się widownią. Kiedy ich przedstawiciele mówią, że narzędzie nie rozwiązuje najważniejszego problemu, można ich niesłusznie potraktować jako spóźnionych użytkowników. Być może po prostu pracują tam, gdzie sukces ma mniej wygodną definicję niż przejście testu.
Równie niewłaściwy byłby ruch odwrotny: odrzucenie mierzalnego sukcesu technicznego dlatego, że model zawiódł w pozornie prostym pytaniu. Pojedyncza wpadka może obalić tezę o bezbłędności, ale nie unieważnia każdego zastosowania. Rozmowa staje się uczciwsza, gdy uczestnicy przestają używać wybranych przykładów jako zastępstwa dla zakresu twierdzenia. Sukces potrzebuje określenia warunków, a porażka potrzebuje wyjaśnienia, co rzeczywiście podważa.
Polska blisko Niemiec, ale co właściwie zmierzono
Raport Microsoftu Global AI Diffusion za drugi kwartał 2026 roku podaje dla Polski 32,3% oraz 24. miejsce wśród 147 gospodarek. Niemcy mają również 32,3%, USA 33,0%, a Zjednoczone Emiraty Arabskie 73,3%. Miara dotyczy osób w wieku 15-64 lat korzystających z generatywnej AI. Powstaje z zagregowanej telemetrii z korektami, między innymi dotyczącymi udziałów urządzeń i dostępu do internetu. Nie jest egzaminem kompetencji.
Dane mówią także o luce między globalną Północą a Południem: 12,6 punktu procentowego w drugim kwartale 2026 roku wobec 10,6 w drugim półroczu 2025 roku. W poprzednim kwartale wynosiła ona 12,1 punktu. Bez nazwania okresów porównania łatwo nadać poprawnej liczbie błędny sens.
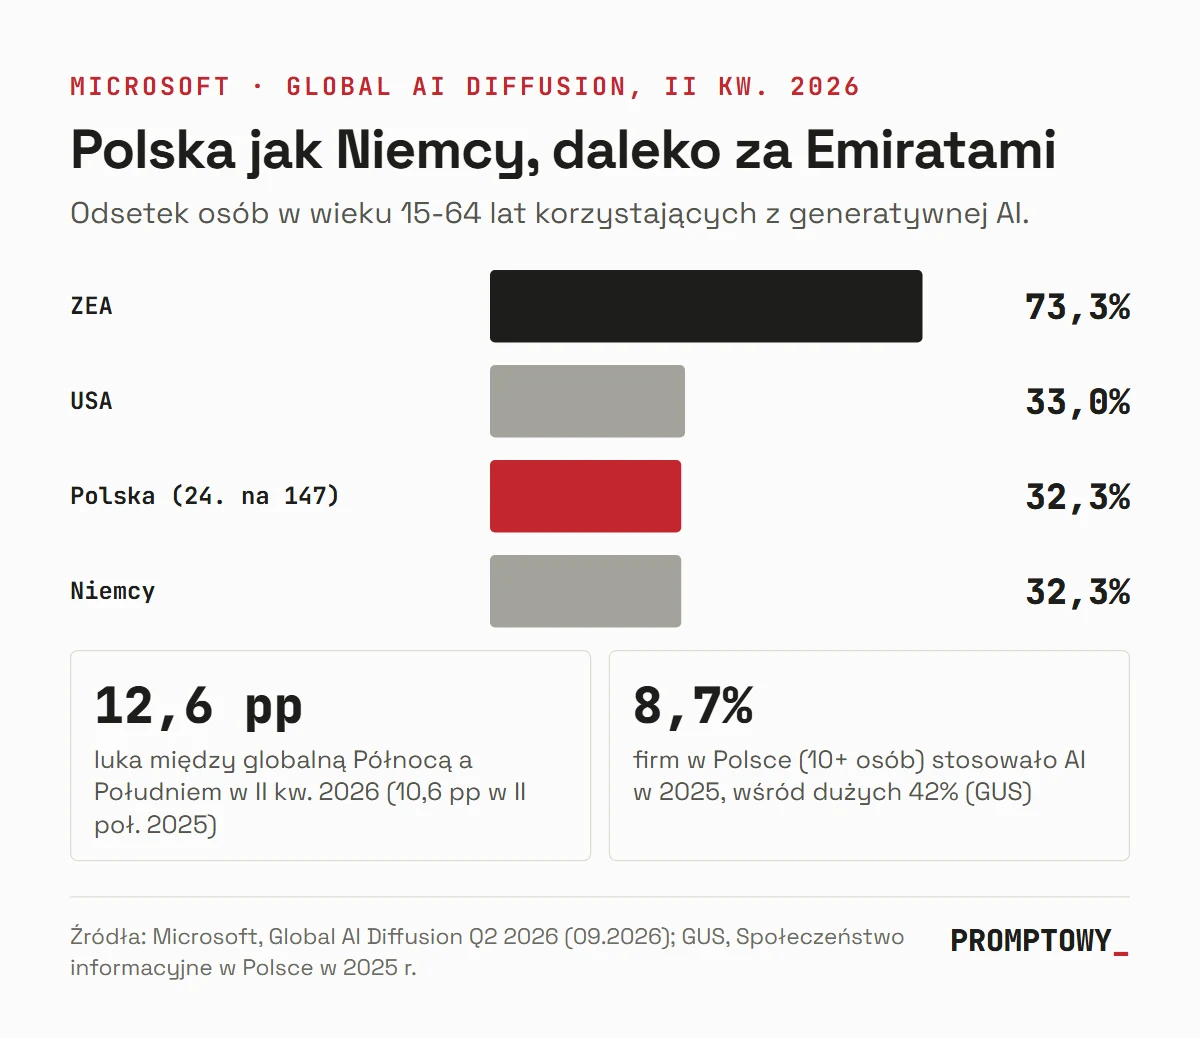
Zestawienie z Niemcami może być dla polskiego czytelnika miłym zaskoczeniem, ale nie pozwala ogłosić równej dojrzałości wdrożeń. Korzystanie z narzędzia nie mówi jeszcze, jak trudne zadania mu powierzono, czy wynik był sprawdzany ani czy zmienił organizację pracy. To rozróżnienie nie odbiera wartości pomiarowi Microsoftu. Chroni go przed użyciem do odpowiedzi na pytanie, którego autorzy wskaźnika nie zadali.
GUS opisuje inny obiekt: przedsiębiorstwa. W publikacji Społeczeństwo informacyjne w Polsce w 2025 r., opublikowanej 15 grudnia 2025 roku, korzystanie z technologii AI deklarowało 8,7% firm objętych badaniem, z co najmniej 10 pracującymi. Wśród dużych podmiotów, z co najmniej 250 pracującymi, było to 42%. Zakres AI jest tu szerszy niż same generatywne czaty. Tych odsetków nie można odjąć od danych Microsoftu i nazwać wyniku luką wdrożeniową.
Można natomiast postawić hipotezę o rozjeździe doświadczenia prywatnego i instytucjonalnego. Człowiek może intensywnie używać asystenta, pracując w organizacji, która nie zmieniła formalnych procesów. Duża firma może wdrażać AI, podczas gdy konkretny pracownik prawie jej nie widzi. To możliwe sytuacje, nie wnioski o ich częstości. Dobre pytanie badawcze zaczyna się właśnie tam, gdzie kończy się możliwość prostego zestawienia procentów.
Dostęp daje doświadczenie, nie mandat
Co sam z tego zbudowałem
Osiem narzędzi, które powstały z problemów opisywanych na tym blogu - razem z tym, czego nie udało się dowieźć.
Najbardziej polityczna część lejka dotyczy dostępu wewnętrznego. Jeśli ktoś może obserwować systemy niedostępne publicznie, jego relacja jest cenna, ale trudniejsza do sprawdzenia. Odbiorca musi ufać opisowi warunków, selekcji przykładów i kryterium sukcesu. Nie powinno to prowadzić ani do automatycznej wiary, ani do automatycznego odrzucenia. Potrzebne jest rozróżnienie między świadectwem osoby mającej szczególny dostęp a wiedzą, którą inni mogą odtworzyć.
W tym miejscu lejek łatwo zamienia się w opowieść o wtajemniczeniu. Kto nie widzi przełomu, rzekomo nie ma jeszcze odpowiedniego dostępu; kto go kwestionuje, potwierdza własne oddalenie od centrum. Taka konstrukcja chroni tezę przed krytyką, ale nie wzmacnia jej dowodów. Uczciwy ekspert powinien umieć wskazać również to, czego jego uprzywilejowana pozycja nie pozwala ustalić: tempo wdrożeń poza laboratorium, lokalne koszty albo gotowość instytucji do ponoszenia odpowiedzialności.
Polskiej debacie potrzebna jest zatem zmiana zwyczaju rozmowy. Zamiast ustalać, kto należy do wyższego piętra, warto uzgadniać warunki porównania doświadczeń. W publicznym pokazie powinno być jasne, jaki był dostęp, jakie zadanie powierzono systemowi i ile pracy wykonano poza kadrem. W krytyce powinno być jasne, czy dotyczy ona zdolności narzędzia, jego opłacalności, czy prawa do użycia go w danej sytuacji. To odmienne zarzuty i wymagają odmiennych odpowiedzi.
Różnica dostępu nie zniknie od samej uprzejmości. Można jednak ograniczyć jej wpływ na jakość rozmowy, tworząc wspólne warunki obserwacji. Niezależne ewaluacje, opisane przypadki użycia i możliwość zgłoszenia błędów są ważniejsze niż spór o to, czy AI jest przełomowa. Zamiast wymagać wiary w cudzą codzienność, pozwalają ustalić, które elementy tej codzienności są przenoszalne.
Potrzebna jest też zgoda na to, że ktoś może znać narzędzie i świadomie nie chcieć go używać. Wybór może wynikać z charakteru pracy, odpowiedzialności, preferencji lub kosztów organizacyjnych. Nie każda odmowa jest dowodem zacofania. Dopiero oddzielenie tych powodów od zwykłego braku kontaktu pozwala sensownie rozmawiać o upowszechnianiu technologii. W przeciwnym razie wskaźnik adopcji staje się plebiscytem lojalności wobec przyszłości.
Lejek Karpathy’ego pomaga wyjaśnić, dlaczego uczestnicy debaty widzą tak różne rzeczy. Nie powinien służyć do rozstrzygania, komu wolno zabierać głos. Jeśli rozmowa o AI ma wyjść poza wymianę świadectw, każde piętro potrzebuje okna, przez które inni będą mogli sprawdzić widok.
Źródła
- Andrej Karpathy, X: wpis o lejku dostępu i doświadczeń; adres oryginału, odczyt poprzez wskazaną poniżej kopię (11.10.2026)
- Post-Cutoff: Karpathy: the gap in shared understanding of LLM capability; nieoficjalna kopia wpisu z X (archiwizacja: 12.10.2026)
- CellCog: Karpathy’s AI Funnel: Only 5,000 See the Frontier; kontekst wpisu z 09.04.2026 (11.10.2026)
- Microsoft: Global AI Diffusion, Q2 2026 Trends and Insights (09.2026; dostęp: 19.10.2026)
- Microsoft: repozytorium danych wskazane w raporcie; wartości sprawdzone w tabelach PDF (dostęp: 19.10.2026)
- A. Misra i in.: Measuring AI Diffusion: A Population-Normalized Metric for Tracking Global AI Usage; opis metodologii przywołany przez Microsoft (04.11.2025)
- GUS: Społeczeństwo informacyjne w Polsce w 2025 r., rozdział o wykorzystaniu ICT w przedsiębiorstwach (15.12.2025)
- GUS: karta publikacji potwierdzająca datę wydania (15.12.2025)
Sprawdzone 19 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Dlaczego entuzjaści i sceptycy AI nie mogą dojść do porozumienia?
Obie strony opisują prawdziwe doświadczenia, ale z różnych pozycji obserwacyjnych - ocenę kształtuje nie tylko wynik, lecz zadanie, które ktoś AI powierzył. Entuzjasta pracujący nad kodem i właściciel firmy piszący ofertę używają tego samego słowa AI, ale oceniają narzędzie w zupełnie innych fragmentach pracy.
Czym jest lejek Karpathy'ego i co oznaczają podawane w nim liczby?
Lejek to szkic opisujący rozjazd doświadczeń z AI: od ok. 6 mld ludzi prawie niemających kontaktu z LLM, przez 1-2 mld okazjonalnych użytkowników, do ok. 20 mln profesjonalistów i ok. 5 tys. osób z wewnętrznym dostępem. Karpathy sam nazywa te liczby rachunkami na serwetce - to jego szacunki z października 2026 roku, nie wynik badania populacyjnego, więc nie należy sumować ich jak rozłącznych kategorii.
Jak wypadają polskie firmy w statystykach dotyczących AI?
Według GUS z publikacji z 15 grudnia 2025 roku AI deklarowało 8,7% firm z co najmniej 10 pracującymi, ale wśród dużych podmiotów z min. 250 pracownikami odsetek wynosił już 42%. Zakres pojęcia AI użyty przez GUS jest przy tym szerszy niż same generatywne czaty, więc tych danych nie można bezpośrednio porównywać z wynikami Microsoftu.
Dlaczego AI lepiej radzi sobie z kodem i matematyką niż z innymi zadaniami?
Karpathy wiąże szybsze postępy w tych dziedzinach z możliwością uzyskania sprawdzalnego sygnału nagrody w uczeniu przez wzmacnianie. Tam, gdzie rezultat można poddać jednoznacznej kontroli, warunki rozwijania modelu różnią się od sytuacji wymagających niejednoznacznego osądu, co sprawia, że profil możliwości systemu jest nierówny.
Podobne tematy na Promptowym