Gemini Omni 1.2 mówi po polsku? Sprawdziłem lip-sync na czterech scenach i pięciu rywalach
Test polskiej mowy i synchronizacji ust w Gemini Omni 1.2 Flash, z porównaniem do Veo, Wan, Seedance i Klinga.
👁 114 przeczytań
W dokumentacji Gemini Omni 1.2 Flash jest jedno zdanie, które polski użytkownik powinien przeczytać przed wszystkim innym: w pełni obsługiwany jest angielski, a pozostałe języki „nie były oceniane” i mogą dawać zmienne wyniki. Google nie obiecuje więc, że Omni powie cokolwiek po polsku. Sprawdziłem to sam, w dniu premiery, na czterech scenach i pięciu rywalach.
Metoda była prosta. Każdy klip z dialogiem puściłem przez rozpoznawanie mowy Whisper large-v3 i porównałem wynik słowo po słowie z tym, co napisałem w poleceniu. Ruch warg oceniałem na oko, klatka po klatce.
Omni 1.2: cztery sceny, cztery wyniki
| Scena | Długość | Co powiedział model |
|---|---|---|
| Nauczycielka przy tablicy | 8 s | całość, słowo w słowo |
| Wigilia, trzy osoby | 10 s | całość, trzy różne głosy |
| Działkowcy przy grillu | 6 s | zgubione „nie z Lidla” |
| Ta sama działka, z obrazu | 6 s | całość |
Nauczycielka historii mówi: „Grunwald, rok tysiąc czterysta dziesiąty. Zapiszcie to sobie, bo w piątek kartkówka.” Liczba przeczytana poprawnie, akcent naturalny, bez śladu angielskiej melodii. Ruch ust zgadza się z mową przez cały klip.
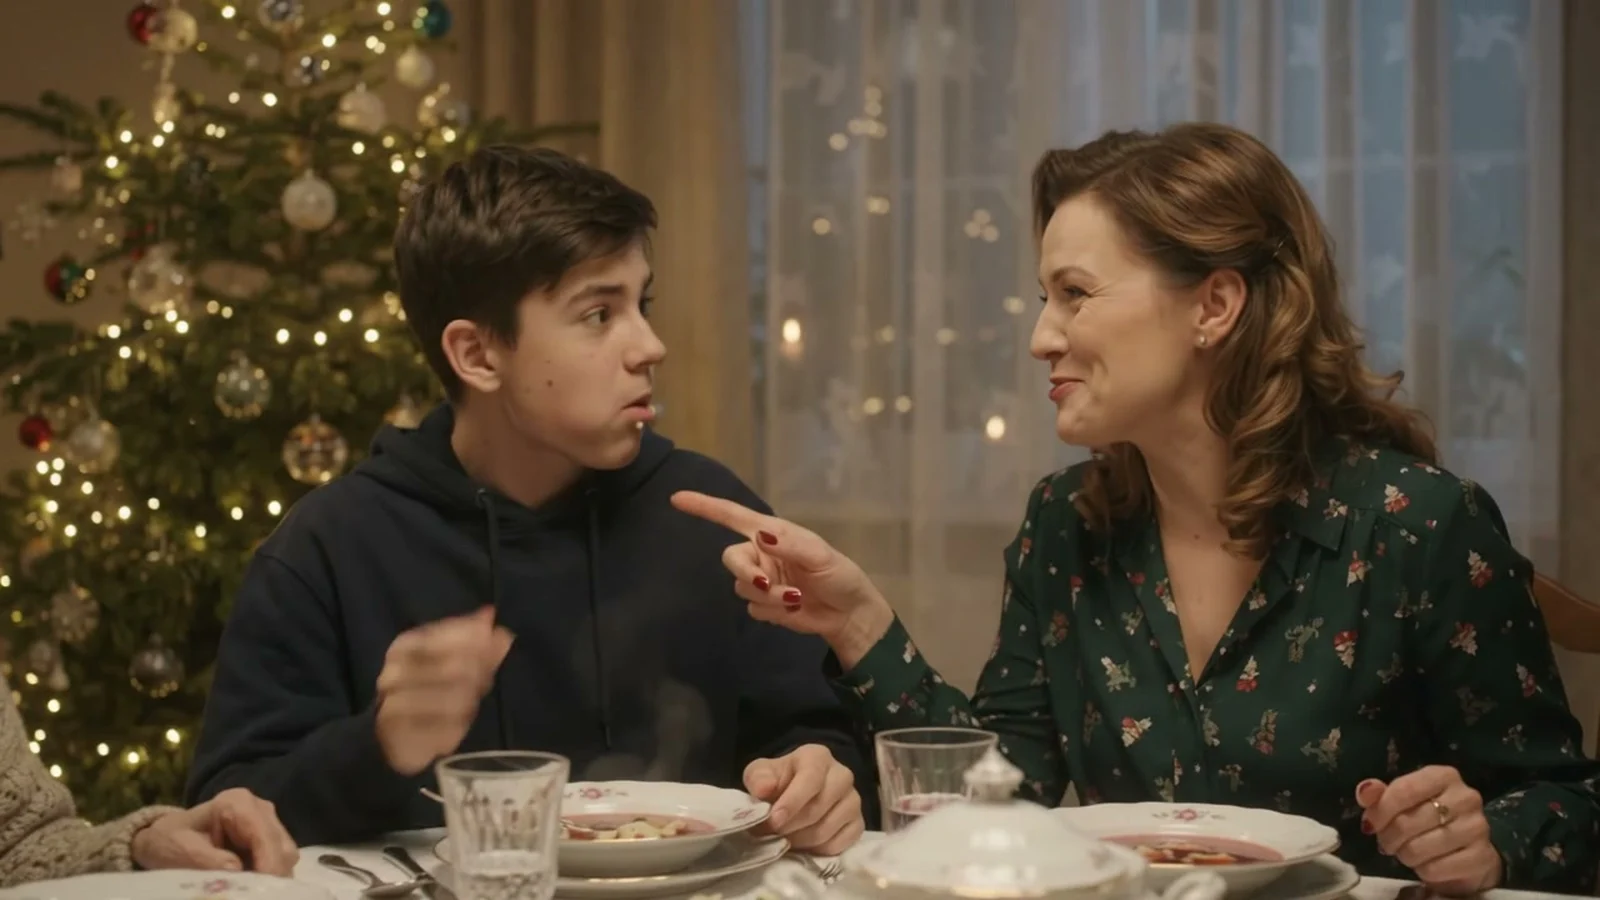
Wigilia to trudniejszy test, bo Google chwali się w 1.2 rozróżnianiem wielu mówców. Babcia, nastolatek z pełną buzią i mama. Każde z nich ma swój głos, kwestie padają w dobrej kolejności, a kamera przeskakuje na tego, kto akurat mówi. Rozpoznawanie mowy oddało wszystkie trzy kwestie bez jednego błędu.
Wpadka zdarzyła się przy grillu. Dwie kwestie w sześciu sekundach to dla modelu za mało i z pierwszej wypadło „nie z Lidla”. Przy tej samej scenie zbudowanej z kadru jako obrazu referencyjnego cały tekst się zmieścił. Wniosek praktyczny: licz około dwóch sekund na krótkie zdanie i nie oszczędzaj na długości klipu, jeśli każde słowo ma znaczenie.
Nie przepłacaj za subskrypcje AI
Prowadzę sklep z rocznymi dostępami do narzędzi AI, taniej niż w cenniku producenta. Sprawdź, co jest teraz na stanie.
Rywale na tym samym dialogu
Kłótnię przy grillu puściłem też w pięciu innych modelach. Tak brzmiały zapisy z Whispera:
- Veo 3.1 Lite: „Mówiłem ci, że kiełbasa ma być z Biedronki, nie z Lidla. Zjesz i nie będziesz marudził.” Bezbłędnie.
- Wan 3.0: identycznie, bezbłędnie.
- Omni 1.1: też cały tekst, ale scena pocięta na trzy ujęcia z podmienioną postacią.
- Seedance 2.0 Fast: „kielbana ma być z biedynki, nie z lita”. Rozpoznawalne, ale do publikacji się nie nadaje.
- Kling 3.0 Standard: „Powiedziałem ci, że kiełbasa powinna być z Biedronki, a nie z Lidla. Gdzieś to i nie skargił się.” Model przerobił tekst po swojemu, a druga kwestia nie ma sensu.
Na polskiej mowie Omni 1.2 jest więc w czołówce razem z Veo i Wanem, ale nie sam na podium. Jego przewaga leży gdzie indziej: w scenach z kilkoma osobami i ruchem kamery postacie nie zmieniają twarzy i głosu. W wersji 1.1 i w Seedance to się zdarzało.
Czego nie da się zrobić
Tu zaczynają się ograniczenia, które trzeba znać przed zaplanowaniem projektu.
- Własnego głosu nie podasz. Dokumentacja API mówi wprost, że dźwięk jako materiał wejściowy i referencje audio nie są obsługiwane. Google na blogu pokazuje przykład z jednosekundowymi próbkami głosu, ale w API, z którego korzystają programiści, tej opcji dziś nie ma.
- Nie poprawisz samego głosu. Edycja głosu w gotowym klipie nie jest obsługiwana. Jeśli model źle akcentuje słowo, generujesz klip od nowa.
- Nie dograsz dialogu do własnego nagrania. Przedłużenie wgranego filmu o scenę z mową nie działa, a w Unii Europejskiej przedłużania i edycji wgranych filmów nie ma w ogóle.
- Nie każda postać przejdzie. Prezenterki pogody w studiu telewizyjnym model nie zrobił mi ani razu. Dwie próby, dwie odmowy bez podanego powodu. Nauczycielka z prawie tym samym tekstem przeszła od razu.
Jeśli potrzebujesz konkretnego głosu, na przykład lektora marki albo własnego, lepiej zrobić obraz w Omni bez dialogu („No dialogue” w poleceniu), a mowę i synchronizację ust dołożyć osobnym narzędziem. Porównanie takich narzędzi po polsku jest w tekście OmniHuman 2.0 kontra Kling i VEED.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Jak pisać dialogi, żeby wyszły
- Każdą kwestię daj w cudzysłowie, po dwukropku, z opisem, kto mówi: „Pierwszy, w kaszkiecie, mówi po polsku: …”.
- Napisz wprost „mówi po polsku”, nawet jeśli całe polecenie jest po polsku.
- Liczby i daty zapisuj tak, jak mają być wymówione („tysiąc czterysta dziesiąty”), a nie cyframi.
- Licz około dwóch sekund na krótkie zdanie. Trzy kwestie zmieściły się bez problemu w 10 sekundach.
- Opisz głos: wiek, emocję, tempo. „Z pretensją”, „spokojnie”, „z pełną buzią” działały.
Więcej gotowych poleceń jest w tekście prompty do Gemini Omni 1.2, a cała premiera w hubie Gemini Omni Flash.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →- dobieracz.plNajlepsze AI do notatek ze spotkań - Granola, Gemini, monday.com i Notion
- generatornia.plZdjęcie z mikołajem AI: jak zrobić świąteczny portret ze swojego selfie
- dygot.plLidl i Europa: plan na własną AI. Właściciel dyskontów buduje zaplecze z twórcą superkomputerów
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm

 artykuły·Ile kosztuje Gemini Omni 1.2 Flash? Cena za sekundę w złotówkach i drabina od 360p do 4KCennik Gemini Omni 1.2 Flash w złotówkach, moja drabina rozdzielczości i ceny rywali za sekundę.