Jan AI i GPT4All: najprostszy lokalny czat AI dla laika (test)
Zainstalowałem Jan i GPT4All, dwa najprostsze programy do rozmowy z lokalnym modelem AI. Pokazuję instalację krok po kroku, zgody przy starcie, wczytanie własnych modeli i to, dlaczego GPT4All od lutego 2025 stoi w miejscu.
👁 120 przeczytań
- Jan 0.8.6 jest lepszym wyborem niż GPT4All, bo GPT4All od 25 lutego 2025 nie dostał żadnej nowej wersji i nie wczytuje modeli takich jak Gemma 3 czy Qwen3.
- Jan oferuje polski interfejs, instalator 556 MB i pobieranie modeli jednym kliknięciem bez konta, konfiguracji ani terminala.
- Do polszczyzny ważniejszy od programu jest model - w Janie można wczytać Bielika 11B v3 lub Gemmę 4 12B z pliku GGUF.
Jan to dziś najprostszy darmowy czat z lokalnym modelem dla laika: instalator, przycisk „Download” przy modelu i rozmowa, bez konta i bez terminala. GPT4All wygląda podobnie, ale od 25 lutego 2025 nie dostał żadnej nowej wersji i nie wczytuje nowszych modeli, więc na start go nie polecam. Oba zainstalowałem 3 października 2026 na Windowsie 11 i wczytałem do nich te same pliki modeli. Poniżej instalacja krok po kroku, moje zrzuty i stan obu projektów na dziś. Pełny przegląd programów do lokalnego AI jest w przewodniku Lokalne AI.
Stan na 17 października 2026
- Jan 0.8.6 z 9 października 2026, autor Menlo Research, licencja Apache 2.0 (komercyjnie można). Repozytorium jest aktywne, ostatnie zmiany 16 października.
- GPT4All 3.10.0 z 25 lutego 2025, autor Nomic AI, licencja MIT (komercyjnie można). Ostatnia zmiana w repozytorium to 27 maja 2025.
- Mój test robiłem na Janie 0.8.4 i GPT4All 3.10.0. Od tamtej pory Jan dostał dwie wersje (opisuję zmiany niżej), GPT4All żadnej.
- Żaden z programów nie wymaga konta. Oba przy pierwszym starcie pytają o zgodę na zbieranie danych. Odmówiłem i niczego to nie blokuje.
Werdykt w trzech punktach
- Wybierz Jan, jeśli chcesz programu, który działa z dzisiejszymi modelami, ma polski interfejs i nie wymaga żadnej konfiguracji.
- GPT4All zostaw tylko wtedy, gdy już go używasz ze starszym modelem i zależy Ci na funkcji LocalDocs. Nowych modeli, takich jak Gemma 3 czy Qwen3, ten program nie wczytuje.
- Do polszczyzny ważniejszy od programu jest model. W Janie wczytasz Bielika albo Gemmę 4 z pliku GGUF.
Jan krok po kroku
- Pobierz instalator ze strony jan.ai albo z GitHuba (dla wersji 0.8.6 plik
Jan_0.8.6_x64-setup.exe, 556 MB). Możesz też wpisać w terminaluwinget install Jan.Jan. - Przejdź przez kreator pierwszego uruchomienia. Od wersji 0.8.5 Jan prowadzi przez powitanie, silnik, pierwszy model i stronę zgody na anonimowe dane. W wersji 0.8.4, którą testowałem, program od razu otwierał czat i w okienku proponował pobranie swojego modelu Jan V3.5 (2,8 GB). Na zbieranie danych możesz się nie zgodzić.
- Wejdź w Hub. To katalog modeli z Hugging Face. Przy każdym widać rozmiar i ocenę, czy zmieści się w Twoim sprzęcie (zielone Fits). Klikasz Download i czekasz.
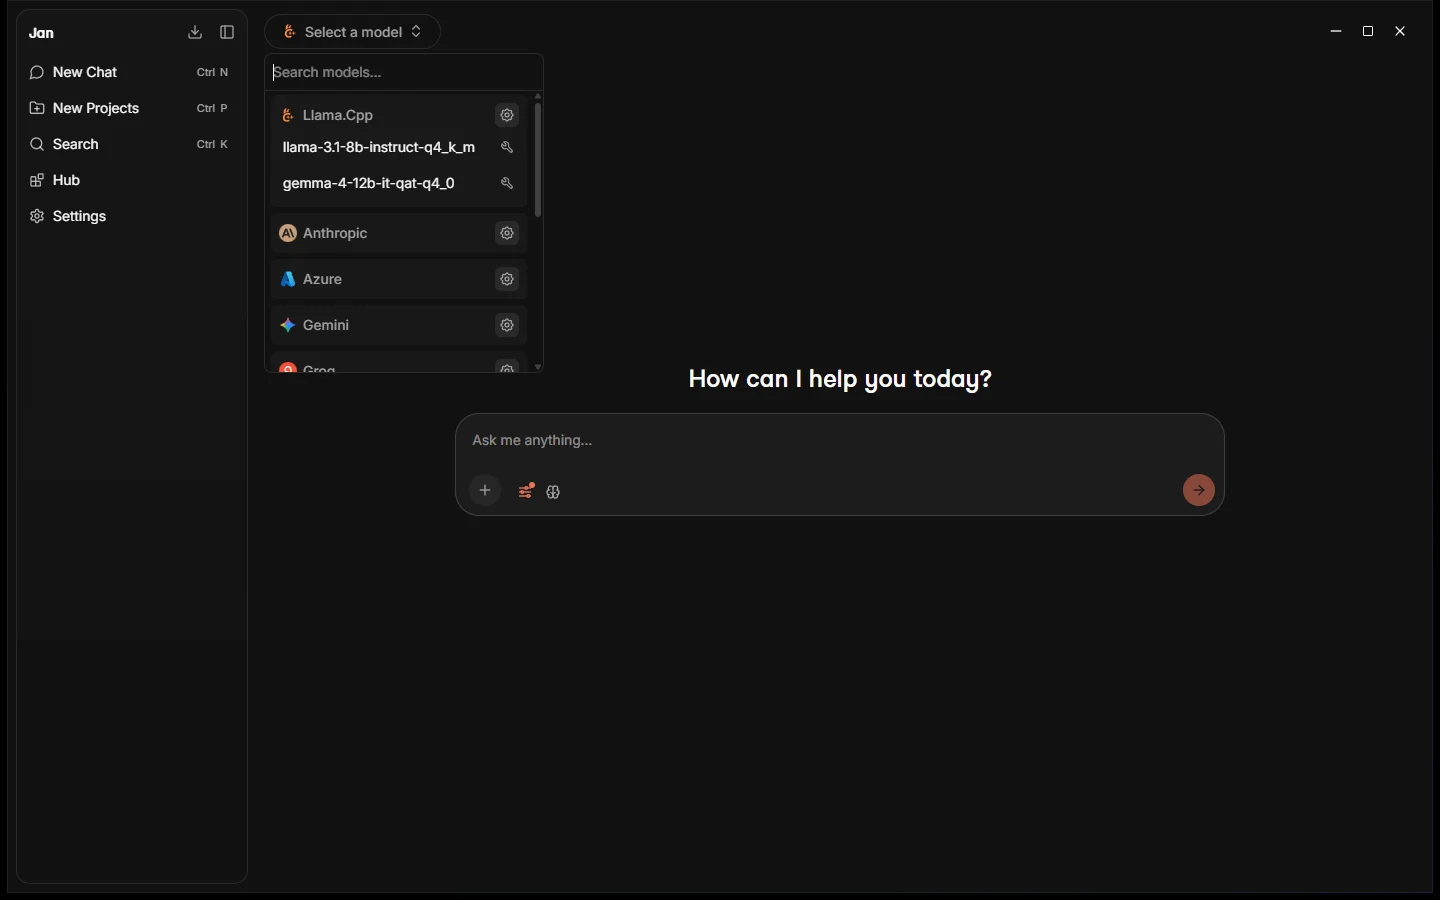
- Wybierz model z listy Select a model nad polem rozmowy i pisz.
- Polski interfejs włączysz w Settings, General, Language. Polskie tłumaczenie jest w kodzie programu obok kilkunastu innych języków.
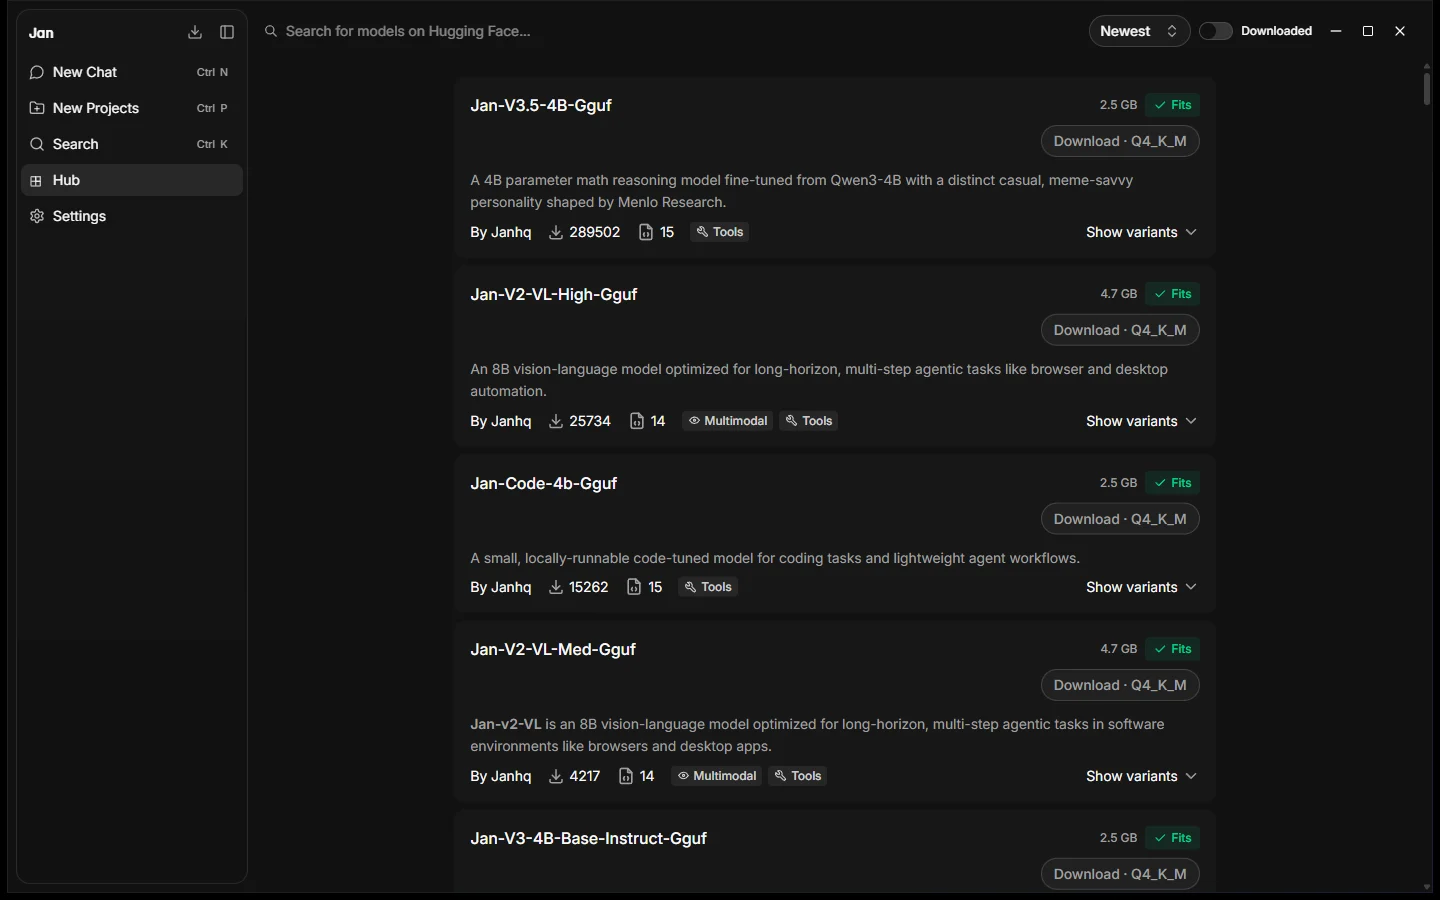
Własny plik GGUF dodasz przyciskiem importu. Ja zrobiłem to ręcznie, bo modele miałem już na dysku: w folderze %APPDATA%\Jan\data\llamacpp\models utworzyłem podfolder z plikiem model.yml, w którym wskazałem ścieżkę do pliku. Po restarcie Llama 3.1 8B i Gemma 4 12B pojawiły się na liście obok dostawców chmurowych (Anthropic, Gemini, Groq), których bez klucza API nie da się użyć.
Co zmieniło się w Janie od mojego testu
- Silnik jest w instalatorze. Jan 0.8.4 zajął u mnie 218 MB i przy pierwszym starcie dociągnął silnik llama.cpp z obsługą CUDA (819 MB). Od 0.8.5 silnik jest wbudowany i aktualizuje się razem z programem, stąd większy instalator.
- Karty Nvidii korzystają z wbudowanej wersji CUDA 13. Starsze karty, np. GTX 10xx, przechodzą na Vulkan.
- Polecenie
janw terminalu nie jest już częścią programu i instaluje się osobno. - Wersja 0.8.6 to same poprawki, m.in. dla kart GTX 16xx i RTX 20xx oraz spowolnienia Qwena 3.8 na kartach 12 GB.
GPT4All krok po kroku
- Pobierz instalator ze strony nomic.ai albo z GitHuba (
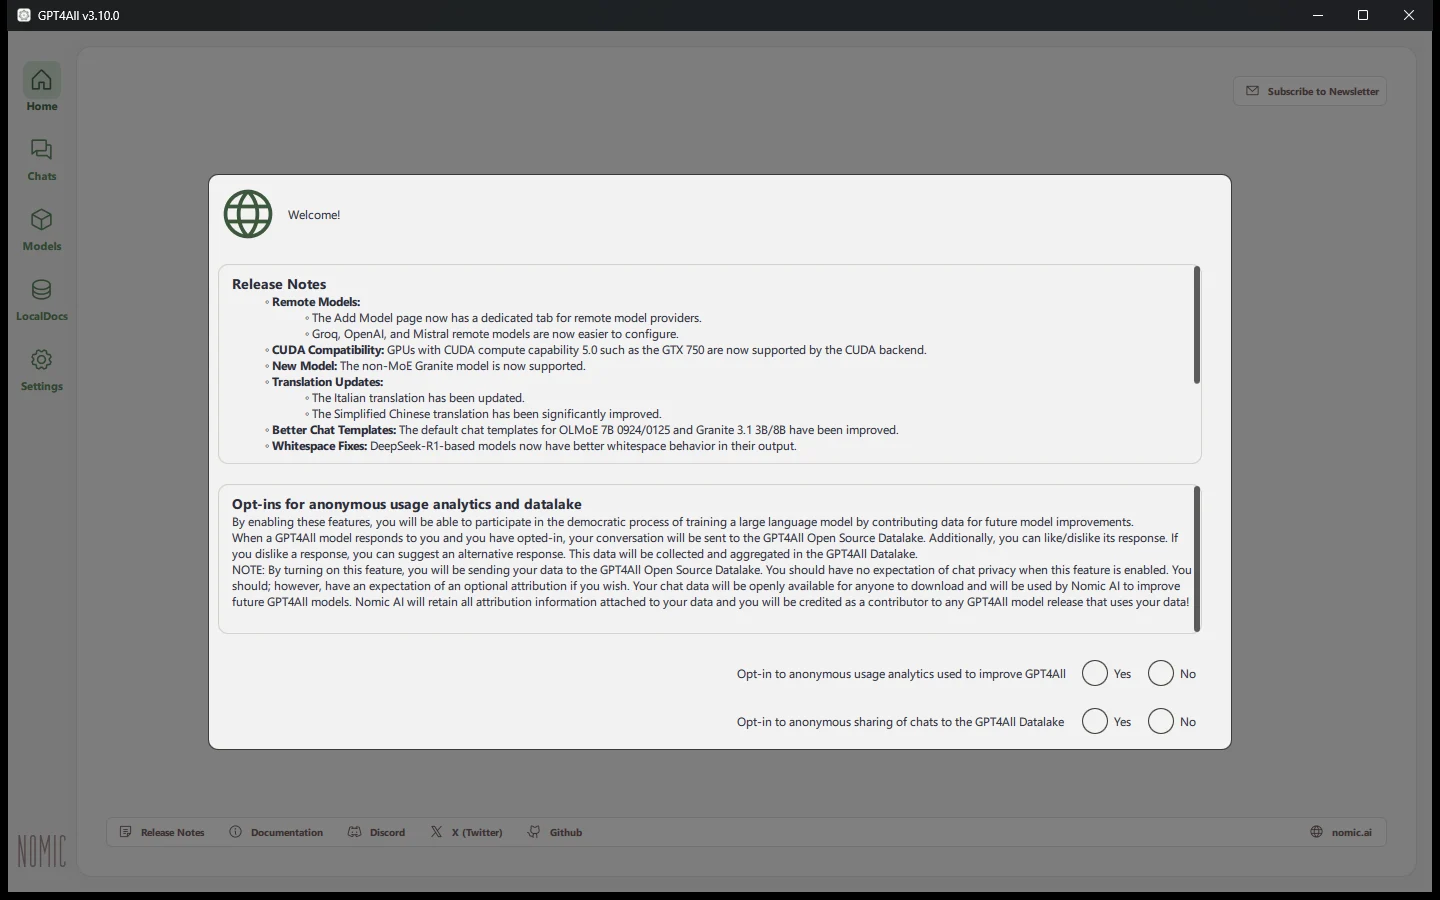
gpt4all-installer-win64-v3.10.0.exe, 744 MB) albo wpiszwinget install nomic.gpt4all. Po instalacji program zajmował u mnie 1,8 GB w folderze użytkownika. - Przy pierwszym starcie pojawia się okno z dwiema zgodami: anonimowe statystyki i udostępnianie rozmów do zbioru Nomic (Datalake). Druga zgoda oznacza, że Twoje rozmowy trafiają do publicznie dostępnego zbioru danych. Zaznacz No przy obu.
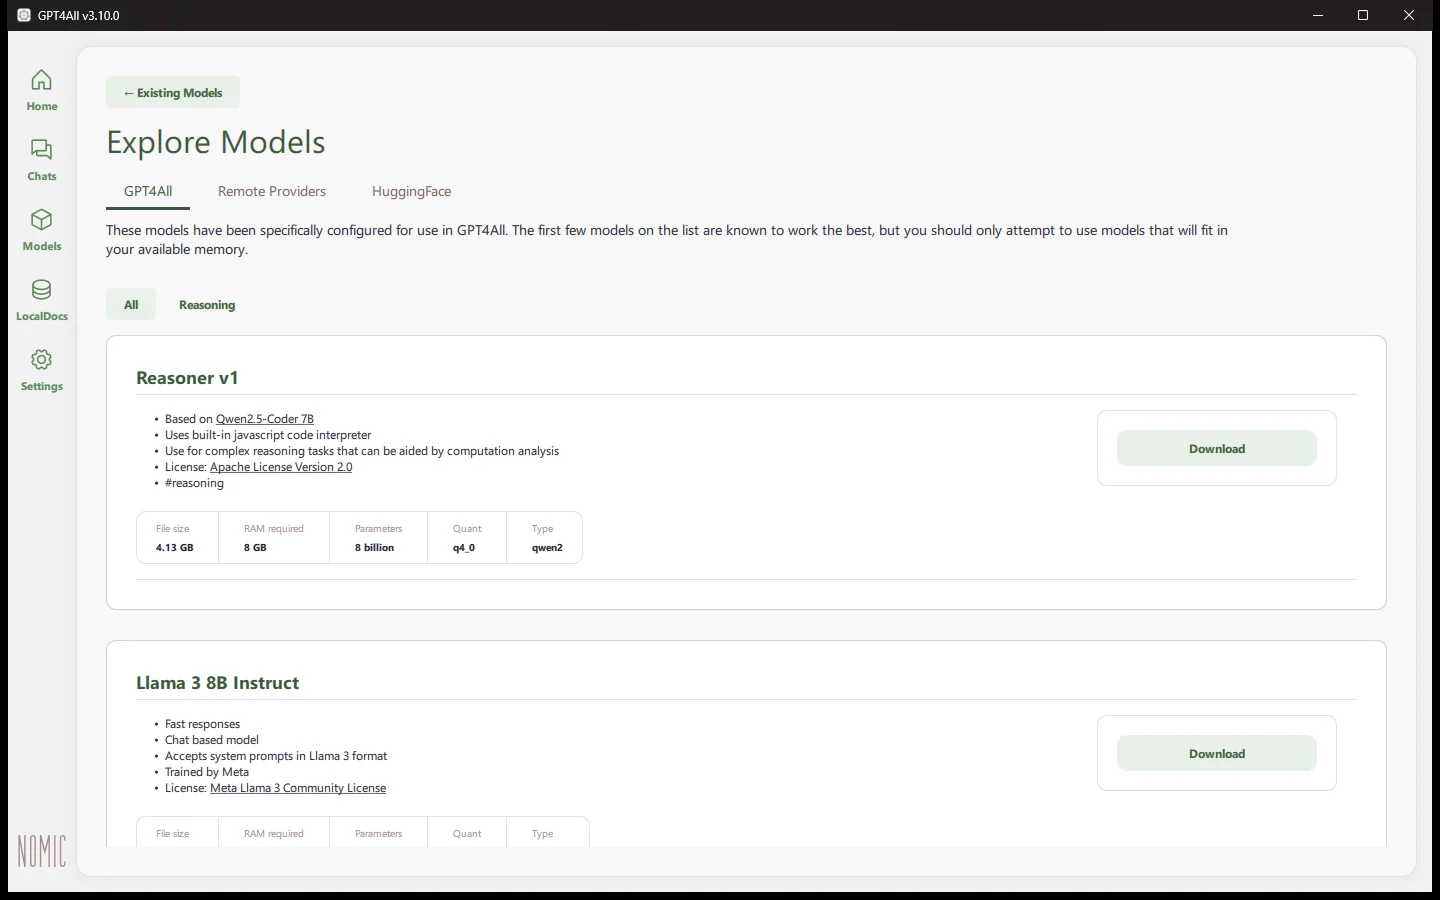
- Zakładka Models, przycisk Add Model: lista polecanych modeli, dostawcy w chmurze albo wyszukiwarka Hugging Face.
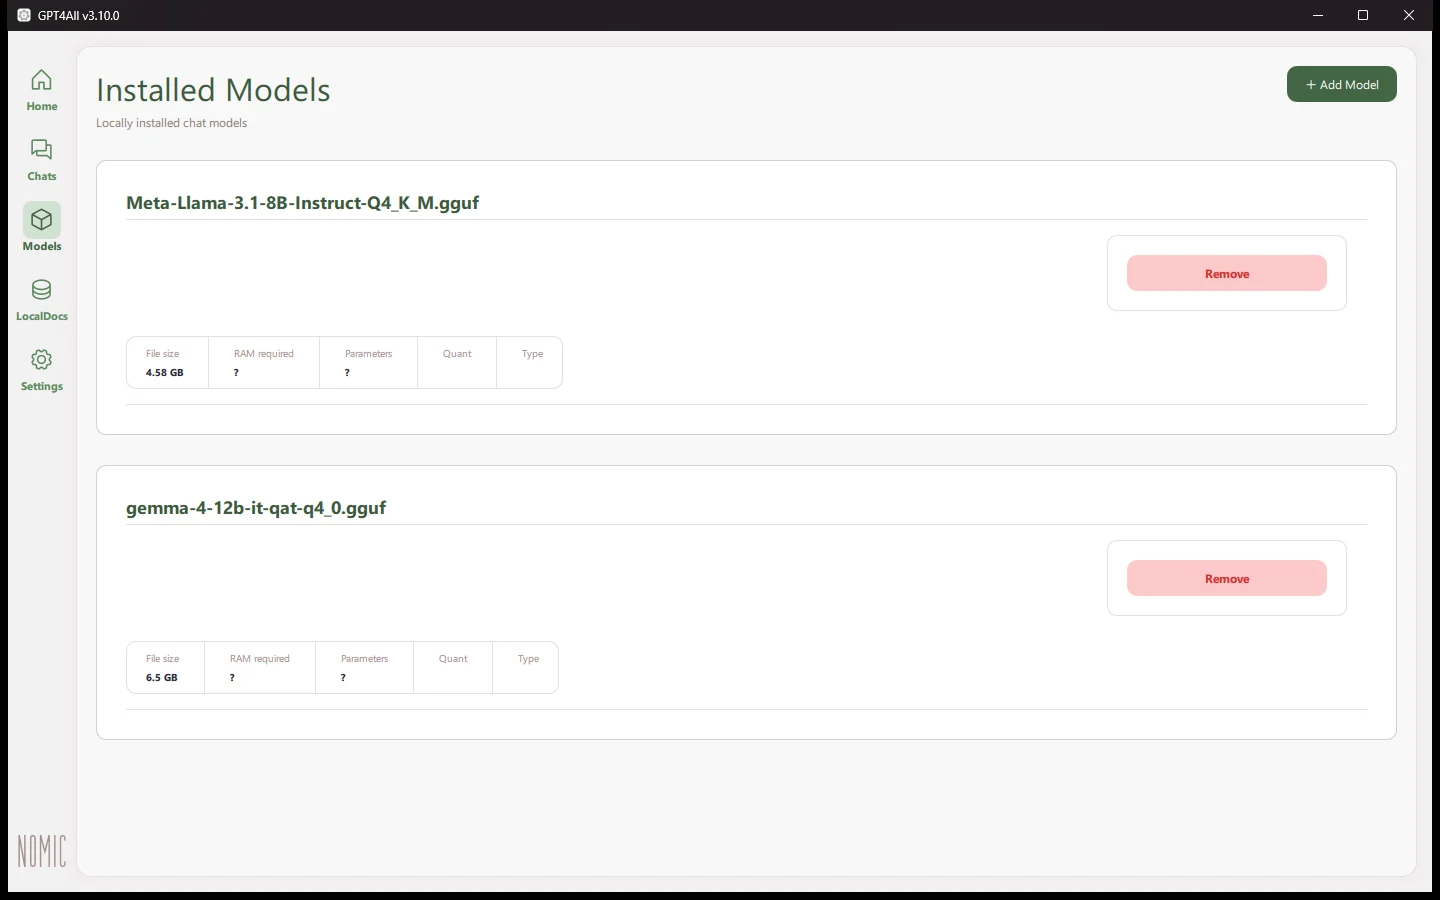
- Własne pliki GGUF wrzucasz do folderu modeli (ścieżka w Settings, Download Path). Ja wskazałem folder z Llamą 3.1 8B i Gemmą 4 12B i oba pliki pojawiły się na liście, ale bez danych o liczbie parametrów i wymaganej pamięci.
- Interfejsu po polsku nie ma. Tłumaczenia to angielskie, hiszpańskie, włoskie, portugalskie (Brazylia), rumuńskie i dwa chińskie.
Mój test: co sprawdziłem, a czego nie
Zakres testu z 3 października 2026 (Windows 11, RTX 4090 24 GB, 64 GB RAM):
- instalacja obu programów przez
wingetz oficjalnych instalatorów, bez konta, - pierwsze uruchomienie i okna zgód (oba programy działają po odmowie),
- katalog modeli w każdym z programów,
- wczytanie tych samych plików GGUF: Llama 3.1 8B (Q4_K_M, 4,9 GB) i Gemma 4 12B (Q4_0 QAT, 7,0 GB),
- stan rozwoju obu projektów na GitHubie, sprawdzony ponownie 17 października 2026.
Szybkości odpowiedzi w Janie i w GPT4All nie zmierzyłem, a dziś nie mam już ich na komputerze, więc nie podaję tu tokenów na sekundę. Jako punkt odniesienia: te same pliki w Ollamie liczyły 3 października 158 tok/s (Llama 3.1 8B) i 99 tok/s (Gemma 4 12B). Jan używa tego samego silnika llama.cpp, ale tempa w nim nie sprawdzałem.
Porównanie: Jan czy GPT4All
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
| Cecha | Jan | GPT4All |
|---|---|---|
| Ostatnia wersja | 0.8.6, 9.10.2026 | 3.10.0, 25.02.2025 |
| Licencja | Apache 2.0 | MIT |
| Polski interfejs | tak | nie |
| Nowe modele (Gemma 3, Qwen3 i nowsze) | tak, silnik aktualizowany z programem | nie, silnik z lutego 2025 |
| Rozmowa z dokumentami | pliki w projektach | LocalDocs (folder dokumentów) |
| Zgody przy starcie | anonimowe dane | statystyki i Datalake |
| Instalator Windows | 556 MB | 744 MB |
| Lokalne API dla innych programów | tak | tak |
Jeśli potrzebujesz więcej ustawień i wygodnej wyszukiwarki modeli, zobacz LM Studio. Jeśli chcesz czatu w przeglądarce dla kilku osób, z historią i dokumentami, jest Open WebUI. Różnice między dwoma najpopularniejszymi silnikami pokazuję w porównaniu LM Studio czy Ollama.
Czy GPT4All jest porzucony?
Oficjalnie nikt tego nie ogłosił. Fakty z 17 października 2026:
- ostatnia wersja 3.10.0 wyszła 25 lutego 2025, a ostatnia zmiana w repozytorium to aktualizacja konfiguracji testów z 27 maja 2025,
- zgłoszenia „Development stopped?” (kwiecień 2025), „Is GPT4all dead?” (sierpień 2025) i „IS this development dead?” (lipiec 2026) nie mają żadnej odpowiedzi zespołu Nomic,
- od marca 2025 otwarte jest zgłoszenie o błędzie „Unsupported model architecture gemma3”, a od maja 2025 prośba o obsługę Qwen3,
- lista polecanych modeli w programie zaczyna się od Reasoner v1 i Llamy 3 8B.
Program dalej działa ze starszymi modelami i ma przydatną funkcję LocalDocs. Nie licz jednak na obsługę nowych modeli ani na poprawki bezpieczeństwa.
Dla kogo który program i model
- Laik, który chce po prostu porozmawiać: Jan i jeden model z Huba z oznaczeniem Fits.
- Karta z 8 GB albo laptop: Gemma 4 E4B (zajęła u mnie 5,4 GB pamięci karty) albo Llama 3.1 8B (6,0 GB). Obie na licencjach pozwalających na użytek komercyjny.
- Karta z 12 GB i więcej: Gemma 4 12B (7,5 GB, Apache 2.0) jako ogólny wybór.
- Polszczyzna i wiedza o Polsce: Bielik 11B v3 (Apache 2.0). Jak go wczytać, opisuję w tekście Bielik AI lokalnie.
Ile pamięci karty potrzebuje który model, pokazuję w tekście co to VRAM, a porównanie jakości modeli po polsku jest w teście lokalnych modeli AI.
Najczęstsze pytania
Czy Jan AI jest darmowy?
Tak, program jest darmowy i ma otwarty kod na licencji Apache 2.0. Płacisz tylko, jeśli podłączysz do niego płatne API w chmurze, np. OpenAI albo Anthropic.
Czy GPT4All jest bezpieczny?
Instalator z oficjalnej strony i z GitHuba jest w porządku, a modele działają lokalnie. Pilnuj zgody na Datalake przy pierwszym starcie, bo jej włączenie wysyła rozmowy do publicznego zbioru danych. Pamiętaj też, że program od lutego 2025 nie dostaje poprawek.
Czy Jan i GPT4All działają bez internetu?
Tak, po pobraniu modelu. Internet jest potrzebny tylko do pobierania modeli i aktualizacji.
Czy GPT4All jest po polsku?
Interfejs nie. Program ma kilka tłumaczeń (m.in. hiszpańskie, włoskie, rumuńskie), polskiego wśród nich nie ma. Odpowiedzi po polsku zależą od modelu, a nowszych modeli dobrze piszących po polsku GPT4All nie wczytuje.
Czy działają bez karty graficznej?
Tak, oba potrafią liczyć na procesorze. Bez karty wybieraj najmniejsze modele, bo większe odpowiadają wtedy wyraźnie wolniej. W tym teście procesora osobno nie mierzyłem.
Jan czy LM Studio?
Jan jest prostszy i ma otwarty kod. LM Studio ma więcej ustawień i lepszą wyszukiwarkę modeli, ale jego kod jest zamknięty. Dla osoby, która chce tylko porozmawiać z modelem, Jan wystarczy.
Czy mogę rozmawiać z dokumentami?
W GPT4All służy do tego LocalDocs, w Janie pliki w projektach. Do polskich dokumentów lepiej sprawdza się podejście z poradnika lokalny czat z PDF, gdzie wybierasz model wyszukiwania znający polski.
Źródła i data sprawdzenia
- Jan na GitHubie: wydania (0.8.4, 0.8.5 i 0.8.6 z opisami zmian).
- Strona Jana.
- GPT4All na GitHubie: wydania (3.10.0 z 25.02.2025).
- GPT4All, zgłoszenie #3558 „Development stopped?”.
- GPT4All, zgłoszenie #3605 „Is GPT4all dead?”.
- GPT4All, zgłoszenie #3690 z lipca 2026.
- GPT4All, zgłoszenie #3540 „Gemma 3 support”.
- Instalacja i zrzuty własne: Windows 11, RTX 4090, Jan 0.8.4 i GPT4All 3.10.0, 3 października 2026. Pomiary Ollamy: 3 października 2026, Ollama 0.35.1.
Sprawdzone 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym