Open WebUI: ChatGPT offline na własnym komputerze krok po kroku
Open WebUI daje okno czatu jak ChatGPT dla modeli z Ollamy, także bez internetu. Pokazuję instalację krok po kroku na Windowsie, moje pomiary rozmowy z Gemmą 4 12B, test rozmowy z PDF-em i gotowy skrypt startowy.
👁 118 przeczytań
- Open WebUI to interfejs WWW działający lokalnie na porcie 8080, który przekazuje pytania do Ollamy i umożliwia rozmowę z modelami AI bez internetu.
- Wersja 0.12 dokłada do każdego zapytania opisy wbudowanych narzędzi, przez co liczba tokenów rośnie z 95 do 569 - na kartach 8 GB może to uniemożliwić załadowanie modelu.
- W teście RAG z ustawą o prawach konsumenta Open WebUI 0.12.3 z modelem bge-m3 i Gemmą 4 12B udzielił 8 z 10 poprawnych odpowiedzi, podczas gdy Gemma bez dokumentu trafiła tylko 5 razy.
Open WebUI to okno czatu w przeglądarce, które wygląda i działa jak ChatGPT, ale rozmawia z modelami na Twoim komputerze, także bez internetu. Pod spodem pracuje Ollama, a Open WebUI dokłada historię rozmów, wybór modelu, rozmowę z dokumentami, konta dla kilku osób i polski interfejs. 17 października 2026 zaktualizowałem go do wersji 0.12.3 jednym poleceniem, bez Dockera i bez zakładania konta, i zmierzyłem rozmowę z Gemmą 4 12B oraz pracę z PDF-em. Szerszy obraz lokalnych modeli jest w przewodniku Lokalne AI.
Stan na 17 października 2026
- Najnowsza wersja: Open WebUI 0.12.3 z 16 października 2026. Seria 0.12 wyszła 10 października.
- Wymaga Pythona 3.11 albo 3.12, na 3.13 nie ruszy. Instaluję przez
uv, który sam pobiera właściwą wersję. - Licencja to „Open WebUI License”: zasady BSD-3 plus zakaz usuwania nazwy i logo Open WebUI. Wolno je zmienić tylko przy najwyżej 50 użytkownikach w ciągu 30 dni, za zgodą autorów albo z licencją firmową. Używać, także w firmie, możesz za darmo.
- Program na dysku: 1,8 GB (bez modeli). Serwer zajmował u mnie około 800 MB RAM.
Co to jest Open WebUI
To serwer z interfejsem WWW. Uruchamiasz go na swoim komputerze i otwierasz w przeglądarce pod adresem http://localhost:8080. Sam nie liczy odpowiedzi. Przekazuje pytania do Ollamy albo do API zgodnego z OpenAI (także LM Studio, llama.cpp czy płatnych usług w chmurze) i pokazuje wyniki. Co dostajesz w porównaniu z gołą Ollamą:
- historię rozmów, foldery, wyszukiwarkę i eksport czatów,
- wybór modelu z listy i porównanie dwóch modeli na tym samym pytaniu,
- wgrywanie plików i bazy wiedzy, czyli rozmowę z własnymi dokumentami (RAG),
- konta dla kilku osób z uprawnieniami, gdy komputer ma służyć całemu biuru,
- polski interfejs, który włączył się sam według języka przeglądarki.
Instalacja krok po kroku (Windows, bez Dockera)
- Zainstaluj Ollamę i pobierz model. Instrukcja jest w przewodniku Ollama. Do testu używałem Gemmy 4 12B (plik Q4_0 QAT, 7,0 GB). Polski model Bielik opisuję w tekście Bielik AI lokalnie.
- Zainstaluj uv, menedżer Pythona od firmy Astral:
winget install astral-sh.uv. - Zainstaluj Open WebUI jako osobne narzędzie z Pythonem 3.11:
uv tool install --python 3.11 open-webuiPierwsza instalacja 3 października trwała u mnie 59 sekund, aktualizacja z 0.11.4 do 0.12.3 poleceniem
uv tool upgrade open-webui1 minutę i 55 sekund. - Uruchom serwer (wersja dla jednej osoby, bez logowania):
$env:WEBUI_AUTH = "False" $env:DATA_DIR = "$HOME\open-webui-dane" open-webui serve --host 127.0.0.1 --port 8080WEBUI_AUTH=Falsewyłącza ekran logowania,DATA_DIRwskazuje folder na czaty i ustawienia, a--host 127.0.0.1sprawia, że czat działa tylko na tym komputerze. - Jeśli terminal nie widzi polecenia
open-webui, wpisz razuv tool update-shelli otwórz nowe okno PowerShella. - Poczekaj na pierwszy start. Na pustym folderze danych serwer był gotowy po 81 sekundach, przy kolejnym czystym starcie po 31 sekundach.
- Otwórz
http://localhost:8080. Jeśli Ollama działa, modele są na liście od razu.
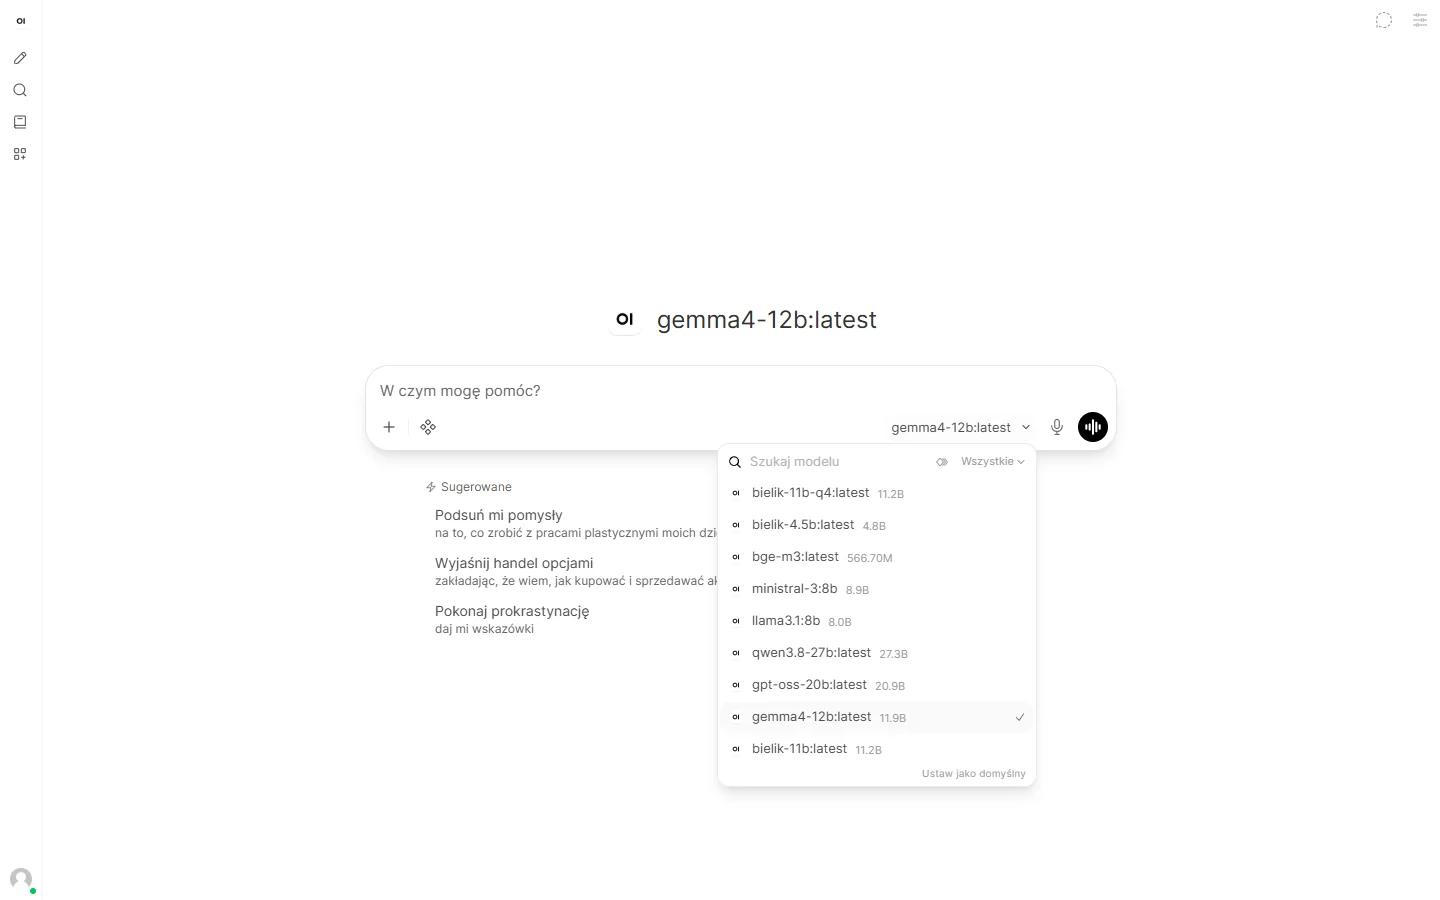
Wersja z kontem dla kilku osób: bez WEBUI_AUTH=False program przy pierwszym wejściu poprosi o założenie konta administratora. To konto lokalne, zapisane w folderze DATA_DIR. Gdy serwer ma być dostępny w sieci firmowej, uruchom go z --host 0.0.0.0.
Wersja z Dockerem: oficjalne polecenie z dokumentacji to docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data -e WEBUI_SECRET_KEY=twoj-klucz --name open-webui --restart always ghcr.io/open-webui/open-webui:main, a czat jest wtedy pod http://localhost:3000. Dockera nie mam, więc tej drogi nie sprawdzałem.
Mój test: rozmowa po polsku
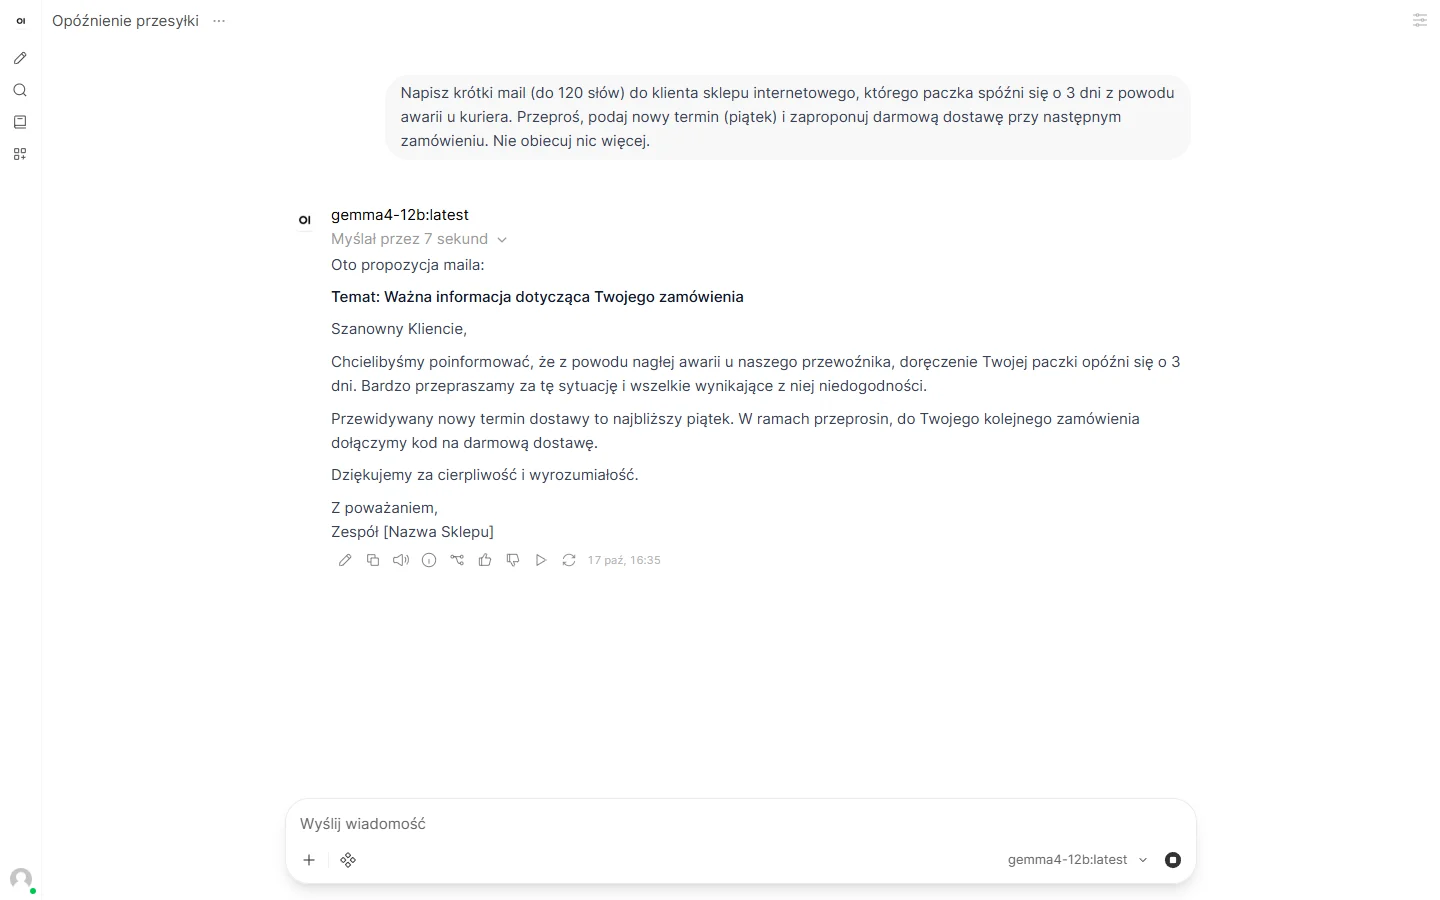
Wybrałem Gemmę 4 12B i zadałem pytanie, które zadaję wszystkim modelom w testach: krótki mail do klienta o spóźnionej paczce. Gemma przed odpowiedzią „myślała” 7 sekund, a potem napisała poprawny mail ze wszystkimi trzema elementami: przeprosiny, nowy termin w piątek i darmowa dostawa przy następnym zamówieniu.
| Pomiar (17.10.2026) | Open WebUI | Sama Ollama |
|---|---|---|
| Czas pierwszej odpowiedzi (model z dysku) | 36,8 s | - |
| w tym wczytanie modelu | 19,9 s | - |
| Czas kolejnej odpowiedzi | 17,4 s | 12,4 s |
| Szybkość pisania | 80-85 tok/s | 91,3 tok/s |
| Tokeny pytania | 5694 | 95 |
| Szczyt pamięci karty | 9,7 GB | - |
Sprzęt: RTX 4090 24 GB, i9-14900KF, 64 GB RAM, Windows 11, Ollama 0.40.5. Modele trzymam na dysku USB, stąd długie pierwsze wczytanie. Przed testem karta miała zajęte 1,4 GB, więc sam model z rozmową zajął około 8,4 GB.
Najciekawsza liczba to tokeny pytania. W samej Ollamie moje polecenie miało 95 tokenów, a w Open WebUI 569. Wersja 0.12 dokleja do każdej rozmowy opisy wbudowanych narzędzi (pamięć, notatki, przeszukiwanie czatów i plików), żeby model mógł z nich korzystać. Na karcie z dużą ilością pamięci to tylko kilka sekund i 10% wolniejsze pisanie. Na karcie 8 GB te dodatkowe tysiące tokenów kontekstu mogą przesądzić, czy model zmieści się w pamięci. Wbudowane narzędzia można wyłączyć w ustawieniach modelu. Ile pamięci zajmuje kontekst, pokazuję w tekście co to VRAM.
Mój test: rozmowa z PDF-em
Open WebUI tnie wgrany dokument na kawałki, zamienia je na wektory i przy każdym pytaniu dokleja do polecenia najbardziej pasujące fragmenty. Domyślnie robi to model all-MiniLM-L6-v2, trenowany na tekstach angielskich. Do polskich dokumentów ustawiłem bge-m3 z Ollamy:
- W Ollamie:
ollama pull bge-m3(1,2 GB). - W Open WebUI: ikona profilu w lewym dolnym rogu, ustawienia, sekcja Administrator, Dokumenty. W polu Silnik modelu embeddingów wybierz Ollama, w polu Model embeddingów wpisz
bge-m3:latesti kliknij Zapisz. - Wgrane wcześniej dokumenty zaindeksuj ponownie, bo ich wektory policzył stary model.
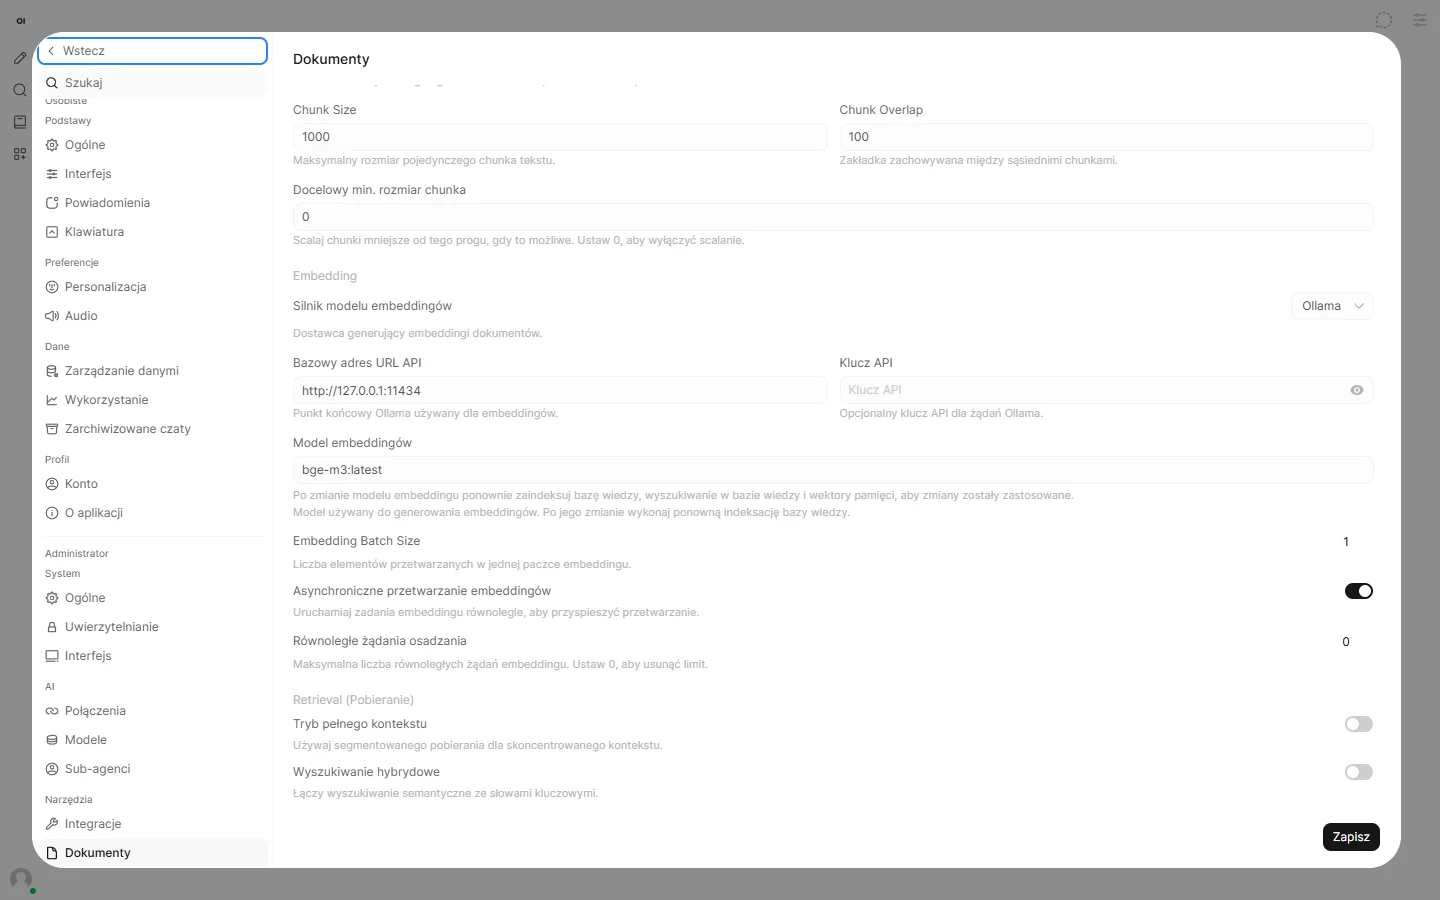
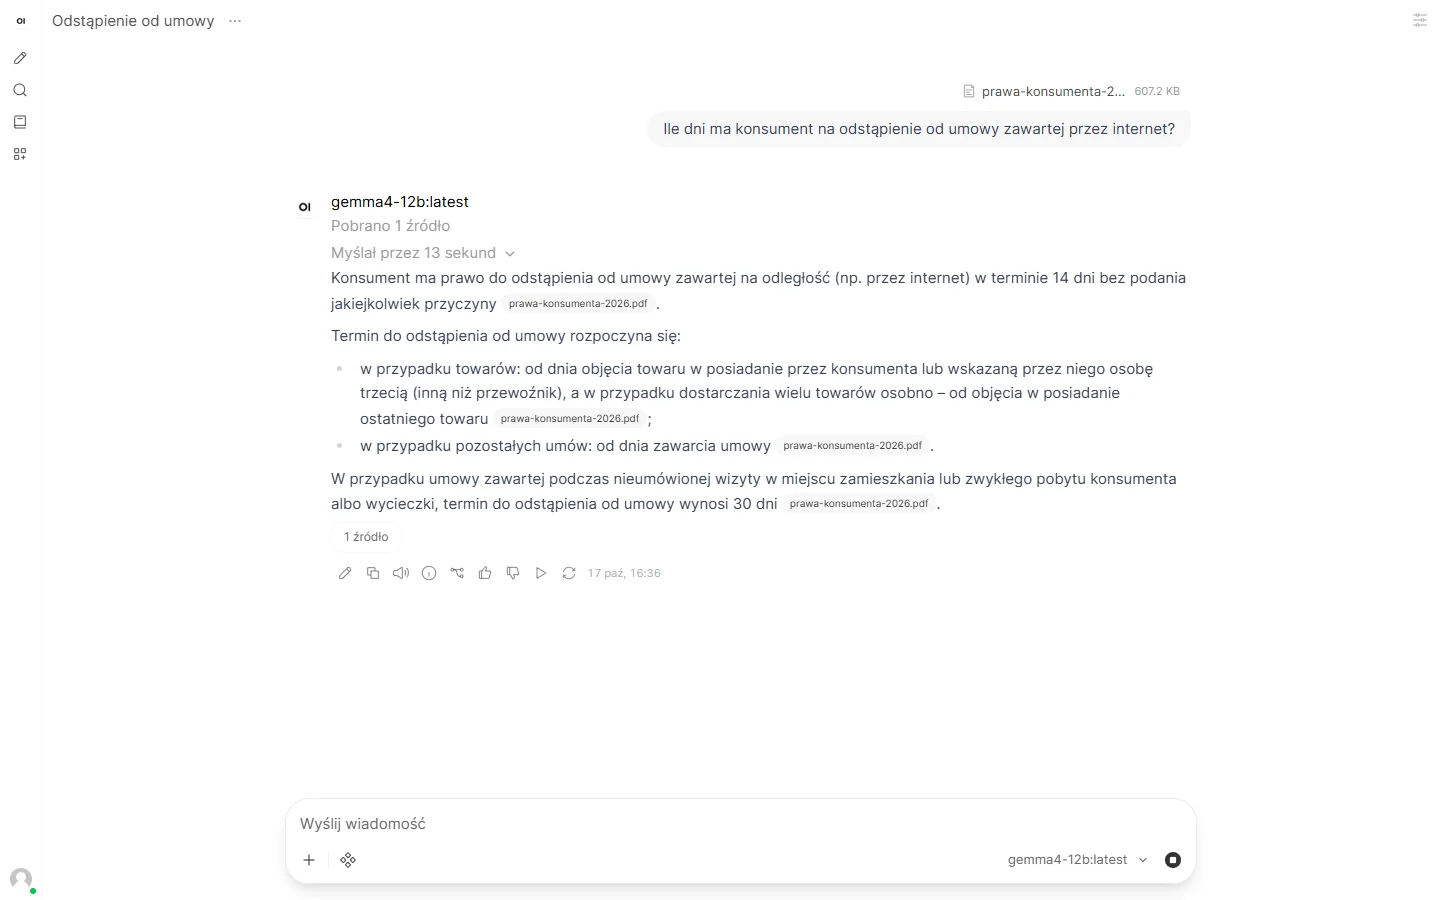
RAG_EMBEDDING_ENGINE=ollama i RAG_EMBEDDING_MODEL=bge-m3:latest przy pierwszym starcie.Do testu wgrałem ustawę o prawach konsumenta (PDF, 607 KB) i zadałem 10 pytań z konkretną odpowiedzią w przepisach, tych samych co w moim teście skryptu RAG z 3 października. Indeksowanie pliku trwało 6,6 s.
- Open WebUI 0.12.3 z ustawieniami domyślnymi i bge-m3, Gemma 4 12B: 8 z 10 trafnych odpowiedzi (sprawdzałem ręcznie). Model nie znalazł terminu na odesłanie towaru i kwoty 50 zł, poniżej której ustawy nie stosuje się do umów zawieranych poza lokalem. W obu przypadkach uczciwie napisał, że w dokumencie tego nie widzi.
- Mój skrypt z 3 października (cięcie ustawy po artykułach, ta sama Gemma): 9 z 10.
- Gemma bez dokumentu (3 października): 5 z 10.
Odpowiedź na jedno pytanie trwała 12-39 s (pierwsza, z wczytaniem modeli, 76 s), a przy zdaniach Open WebUI pokazuje, z którego pliku pochodzą. Szczyt pamięci karty z Gemmą i bge-m3 naraz: 10,8 GB. Jak zbudować własny czat z PDF-ami i dlaczego cięcie po artykułach pomaga, opisuję w poradniku lokalny czat z PDF.
Gotowy skrypt
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Skrypt open-webui-start.ps1 sprawdza Ollamę, w razie potrzeby instaluje uv, Open WebUI i bge-m3, ustawia tryb jednej osoby bez telemetrii i otwiera przeglądarkę, gdy serwer jest gotowy. Sprawdziłem go 17 października 2026 w Windows PowerShell na czystym folderze danych: serwer był gotowy po 31 sekundach. Uruchomienie: powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1, zatrzymanie: Ctrl+C.
# open-webui-start.ps1 - instaluje (jesli trzeba) i uruchamia Open WebUI z Ollama na Windows 10/11.
# Opis: https://promptowy.com/open-webui/   Stan na 17.10.2026 (Open WebUI 0.12.3, Ollama 0.40).
# Uzycie (PowerShell):  powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1
# Opcje: -Folder "D:\czaty"  -Port 8081  -BezPrzegladarki
# Zatrzymanie: Ctrl+C w tym oknie.
param(
    [string]$Folder = "$HOME\open-webui-dane",
    [int]$Port = 8080,
    [switch]$BezPrzegladarki
)
$ErrorActionPreference = 'Stop'

function Test-Url($u) {
    try { Invoke-RestMethod -Uri $u -TimeoutSec 3 | Out-Null; return $true } catch { return $false }
}

# 1. Ollama musi byc zainstalowana i uruchomiona
if (-not (Get-Command ollama -ErrorAction SilentlyContinue)) {
    Write-Host 'Brak Ollamy. Zainstaluj ja poleceniem:  winget install Ollama.Ollama' -ForegroundColor Red
    exit 1
}
if (-not (Test-Url 'http://127.0.0.1:11434/api/version')) {
    Write-Host 'Ollama nie odpowiada. Uruchom aplikacje Ollama i sprobuj ponownie.' -ForegroundColor Red
    exit 1
}

# 2. uv (menedzer Pythona od Astral) - sam pobierze Pythona 3.11
if (-not (Get-Command uv -ErrorAction SilentlyContinue)) {
    Write-Host 'Instaluje uv przez winget...'
    winget install --id astral-sh.uv -e
    $env:Path = [Environment]::GetEnvironmentVariable('Path', 'User') + ';' + [Environment]::GetEnvironmentVariable('Path', 'Machine')
}

# 3. Open WebUI jako osobne narzedzie (nie rusza Twojego Pythona)
$exe = Join-Path $HOME '.local\bin\open-webui.exe'
if (-not (Test-Path $exe)) {
    Write-Host 'Instaluje Open WebUI (ok. 1,8 GB, kilka minut)...'
    uv tool install --python 3.11 open-webui
}

# 4. Model do wyszukiwania w dokumentach, ktory zna polski
$modele = @((Invoke-RestMethod -Uri 'http://127.0.0.1:11434/api/tags').models | ForEach-Object { $_.name })
if ($modele -notcontains 'bge-m3:latest') {
    Write-Host 'Pobieram bge-m3 do dokumentow (1,2 GB)...'
    ollama pull bge-m3
}
if (@($modele | Where-Object { $_ -ne 'bge-m3:latest' }).Count -eq 0) {
    Write-Host 'Uwaga: w Ollamie nie ma jeszcze modelu do rozmowy. Jak go pobrac: https://promptowy.com/ollama/' -ForegroundColor Yellow
}

# 5. Ustawienia: jeden uzytkownik bez logowania, tylko ten komputer, bez telemetrii
New-Item -ItemType Directory -Force -Path $Folder | Out-Null
$env:DATA_DIR = $Folder
$env:WEBUI_AUTH = 'False'
$env:OLLAMA_BASE_URL = 'http://127.0.0.1:11434'
$env:ENABLE_OPENAI_API = 'False'
$env:RAG_EMBEDDING_ENGINE = 'ollama'
$env:RAG_EMBEDDING_MODEL = 'bge-m3:latest'
$env:ANONYMIZED_TELEMETRY = 'false'
$env:DO_NOT_TRACK = 'true'
$env:SCARF_NO_ANALYTICS = 'true'
$env:PYTHONIOENCODING = 'utf-8'

# 6. Start serwera i otwarcie przegladarki, gdy bedzie gotowy
Write-Host "Startuje Open WebUI na http://localhost:$Port (pierwszy start trwa 1-2 minuty)..."
$p = Start-Process -FilePath $exe -ArgumentList @('serve', '--host', '127.0.0.1', '--port', "$Port") -NoNewWindow -PassThru
$t = Get-Date
while (-not (Test-Url "http://127.0.0.1:$Port/health")) {
    if ($p.HasExited) { Write-Host 'Open WebUI zakonczyl sie bledem - sprawdz komunikaty wyzej.' -ForegroundColor Red; exit 1 }
    Start-Sleep -Seconds 2
}
Write-Host ("Gotowe po {0:N0} s. Czaty i ustawienia: {1}" -f ((Get-Date) - $t).TotalSeconds, $Folder) -ForegroundColor Green
if (-not $BezPrzegladarki) { Start-Process "http://localhost:$Port" }
Wait-Process -Id $p.Id
Open WebUI, LM Studio czy Jan
| Cecha | Open WebUI | LM Studio | Jan |
|---|---|---|---|
| Forma | strona w przeglądarce | program okienkowy | program okienkowy |
| Silnik | Ollama lub dowolne API | własny | własny (llama.cpp) |
| Kilka kont, dostęp z sieci | tak | nie | nie |
| Instalacja | polecenie w terminalu | instalator | instalator |
| Licencja | Open WebUI License | darmowy, kod zamknięty | Apache 2.0 |
Dla kogo
- Open WebUI: gdy chcesz czatu jak ChatGPT z historią i dokumentami albo jeden komputer z kartą ma obsłużyć kilka osób w domu czy biurze.
- LM Studio: gdy wolisz program okienkowy z wygodną wyszukiwarką modeli.
- Jan: gdy chcesz najprostszej drogi bez terminala, z otwartym kodem.
Jeśli nie chcesz terminala, zacznij od LM Studio albo od programów z tekstu Jan i GPT4All. Różnice między dwoma silnikami pokazuję w porównaniu LM Studio czy Ollama.
Najczęstsze problemy
- „Python 3.13 is not supported”: użyj
uv tool install --python 3.11 open-webui, które nie rusza Twojego Pythona. - Pusta lista modeli: Ollama nie działa albo nasłuchuje pod innym adresem. Sprawdź
ollama listi ustawOLLAMA_BASE_URL. - Port 8080 zajęty: uruchom z
--port 8081. - Odpowiedzi wolniejsze niż w terminalu: to długie instrukcje wbudowanych narzędzi i dodatkowe zadania po rozmowie (tytuł czatu, podpowiedzi pytań, tagi). Te zadania wyłączysz w ustawieniach administratora, w sekcji Interfejs.
Najczęstsze pytania
Czy Open WebUI jest darmowe?
Tak, także w firmie. Płatna jest tylko licencja firmowa dla tych, którzy chcą usunąć nazwę i logo Open WebUI przy ponad 50 użytkownikach.
Czy to jest ChatGPT offline?
W praktyce tak, to lokalny ChatGPT: okno wygląda jak ChatGPT, a odpowiada model z Twojego komputera. Po pierwszym uruchomieniu rozmowy nie wychodzą z komputera. Zmienna OFFLINE_MODE=True wyłącza też sprawdzanie aktualizacji i pobieranie modeli. Jakość odpowiedzi zależy od modelu, a lokalne modele są słabsze od najnowszych modeli w chmurze.
Jak połączyć Open WebUI z Ollamą?
Na tym samym komputerze nie trzeba nic robić: Open WebUI sam znajduje Ollamę pod http://127.0.0.1:11434. Gdy Ollama działa na innym komputerze, podaj jej adres w zmiennej OLLAMA_BASE_URL albo w ustawieniach połączeń.
Czy Open WebUI jest po polsku?
Tak, interfejs ma polskie tłumaczenie i włączył się u mnie automatycznie. Odpowiedzi są tak dobre po polsku, jak model, który wybierzesz.
Czy potrzebuję Dockera?
Nie. Instalacja przez uv albo pip działa bez Dockera. Ja używałem uv.
Czy mogę podłączyć ChatGPT albo Claude?
Tak, w ustawieniach połączeń dodajesz adres API i klucz. Wtedy rozmowy idą do tej usługi i płacisz za tokeny według jej cennika.
Jak zaktualizować Open WebUI?
Poleceniem uv tool upgrade open-webui. Historia rozmów zostaje w folderze DATA_DIR. U mnie aktualizacja z 0.11.4 do 0.12.3 przeszła bez utraty ustawień.
Źródła i data sprawdzenia
- Open WebUI na GitHubie: wydania (0.12.0 z 10.10.2026, 0.12.3 z 16.10.2026).
- Open WebUI License i historia licencji.
- Dokumentacja Open WebUI: szybki start (wymagany Python, polecenie Dockera).
- Pakiet open-webui na PyPI.
- Instalacja, zrzuty i pomiary własne: Windows 11, RTX 4090, Ollama 0.40.5, Open WebUI 0.12.3, 17 października 2026 (pierwsza instalacja 3 października 2026).
Sprawdzone 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym