Qwen-Image 2.1 Turbo lokalnie: 4 s na obraz na RTX 4090
Uruchomiłem Qwen-Image 2.1 Turbo lokalnie w ComfyUI: 8 kroków, 4 s na obraz, porównanie ze zwykłym 2.1 i test polskich napisów.
👁 120 przeczytań
- Qwen-Image 2.1 Turbo generuje obraz 1024x1536 w 4 sekundy na RTX 4090, czyli 4-5 razy szybciej niż zwykły Qwen-Image 2.1, który potrzebuje 20 sekund.
- Model wymaga szczytu 16,8-18,6 GB VRAM w wersji int8, a plik diffusion_models waży 7,26 GB - reszta plików jest wspólna z wersją 2.1.
- Licencja Qwen Research zakazuje użycia komercyjnego bez zgody Alibaby, więc do zarobkowych projektów trzeba sięgnąć po alternatywę jak Z-Image Turbo na Apache 2.0.
Qwen-Image 2.1 Turbo to przyspieszona wersja Qwen-Image 2.1, którą Alibaba wydała 9 października 2026. Zamiast 25 kroków robi 8. Uruchomiłem ją lokalnie w ComfyUI na RTX 4090 i puściłem te same cztery polecenia co w zwykłej wersji 2.1. Turbo robi obraz 1024×1536 w 4 sekundy, zwykły 2.1 w 20. Jakość jest bardzo blisko, a w dwóch testach z polskim napisem Turbo wypadło nawet lepiej.
Stan na 17 października 2026
- Czas na RTX 4090: 3-4 s na obraz (zwykły 2.1: 13-20 s), czyli 4-5 razy szybciej.
- Pamięć: szczyt 16,8-18,6 GB VRAM na całej karcie, wersja int8.
- Plik modelu: 7,26 GB. Enkoder tekstu i VAE są te same co w 2.1, więc jeśli masz już 2.1, dociągasz tylko ten jeden plik.
- Licencja: Qwen Research, czyli bez użycia komercyjnego.
- ComfyUI: obsługa natywna od wersji 0.41, gotowy szablon w przeglądarce szablonów.
Seria: lokalne AI na RTX 4090, testy z 17 października 2026
Co to jest Qwen-Image 2.1 Turbo
To ten sam model co Qwen-Image 2.1 (7B, najlepszy otwarty model obrazowy w rankingu Artificial Analysis z początku października), tylko po destylacji. Destylacja uczy model dochodzić do gotowego obrazu w mniejszej liczbie kroków. Zespół Qwen opublikował wagi na Hugging Face 9 października, a Comfy-Org dzień później dodał paczkę gotową do ComfyUI z wersją int8 i bf16.
Turbo działa na stałym harmonogramie: 8 kroków z ręcznie ustawionymi wartościami sigma, sampler euler i CFG 1. Nie ustawia się tu „kroków” jak w zwykłym KSamplerze, bo szablon ComfyUI podaje gotową listę.
Mój test: Turbo kontra zwykły 2.1
Sprzęt: RTX 4090 24 GB, 64 GB RAM, Windows 11, ComfyUI 0.41.0, modele int8 na dysku SSD po USB. Obie wersje dostały te same cztery polecenia i to samo ziarno (7). Turbo ma 8 kroków i CFG 1, zwykły 2.1 ma 25 kroków i CFG 3. Czas liczyłem od wysłania zadania do zapisanego pliku, a VRAM odczytywałem z nvidia-smi co pół sekundy.
| Polecenie | Rozdzielczość | Turbo | Zwykły 2.1 |
|---|---|---|---|
| Plakat z polskim napisem | 1024×1536 | 45,4 s* | 38,1 s* |
| Portret rybaka | 1024×1536 | 4,0 s | 20,1 s |
| Sklep z lat 80. | 1536×1024 | 4,0 s | 20,1 s |
| Zdjęcie produktu | 1024×1024 | 3,0 s | 13,0 s |
* Pierwszy obraz w serii zawiera ładowanie modelu z dysku do pamięci karty. Czysta generacja Turbo to te same 4 sekundy co w kolejnych obrazach.
Plakat z polskim napisem
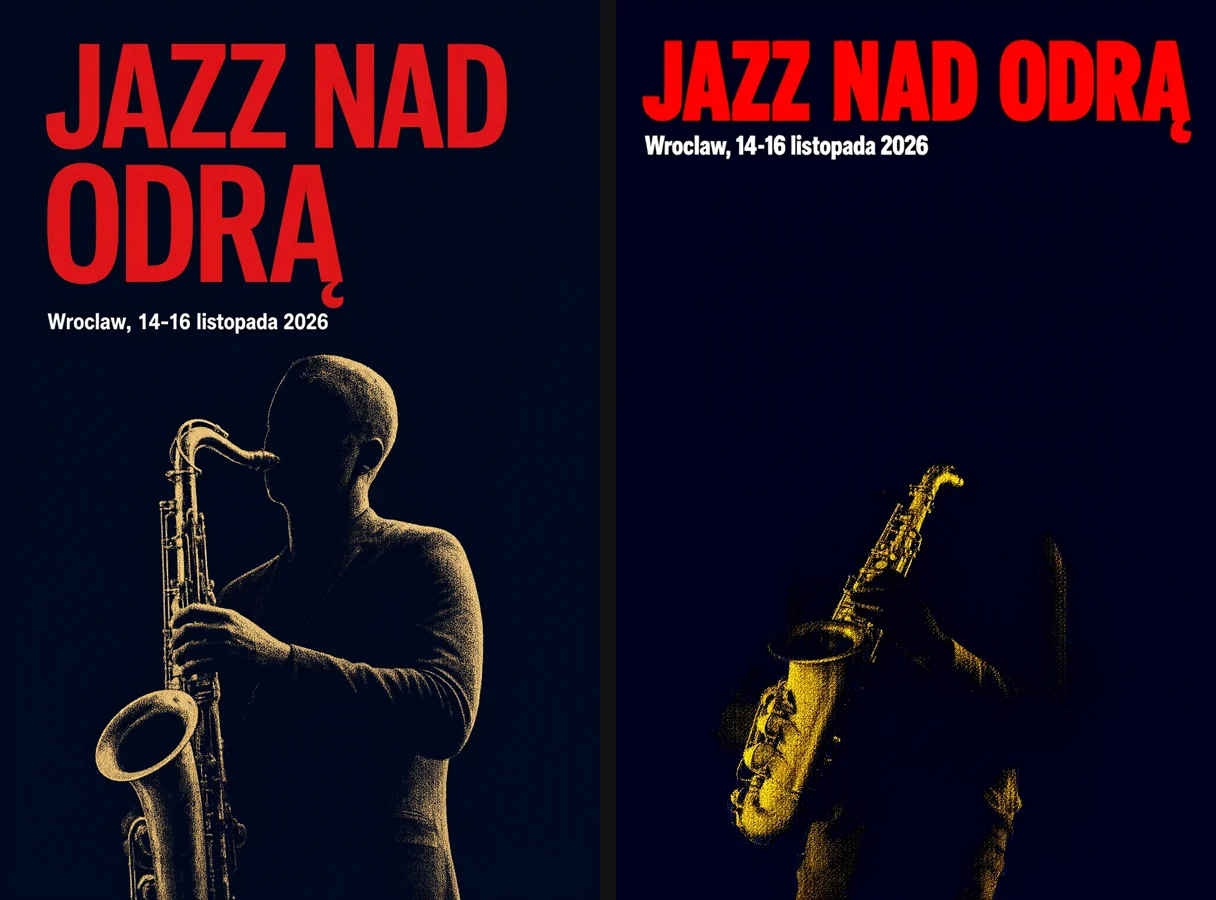
Polecenie prosiło o czerwony nagłówek „JAZZ NAD ODRĄ” i podpis „Wrocław, 14-16 listopada 2026”. Oba modele napisały „ODRĄ” poprawnie, z ogonkiem. Oba za to zgubiły „ł” we „Wrocławiu” i wyszło „Wroclaw”. Turbo dało większy nagłówek i pełną sylwetkę saksofonisty, a 2.1 zostawiło dużo pustego granatu.
Sklep z lat 80. i cena na kartce
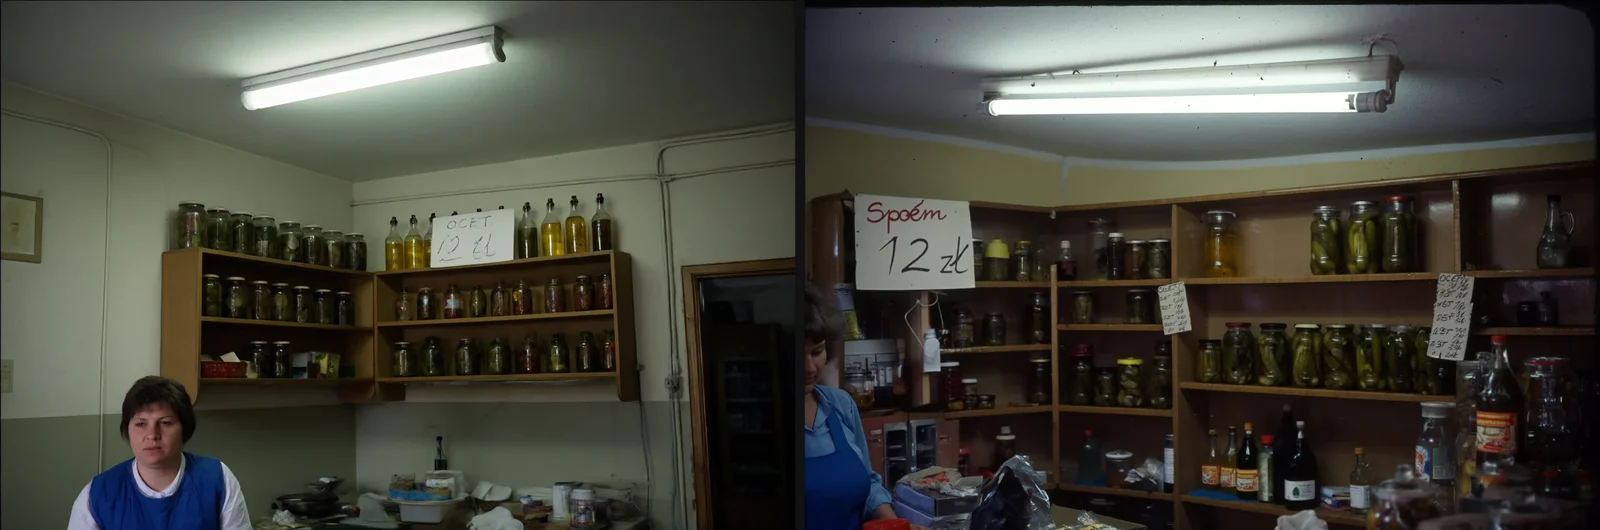
Tu chodziło o szyld „Społem” i kartkę „OCET 12 zł”. Turbo napisało kartkę bezbłędnie, ale szyld pominęło. Zwykły 2.1 dał „Spoém” zamiast „Społem”, a kartka wyszła jako „12 zł” bez słowa „OCET”. Klimat PRL-owskiego sklepu wyszedł w obu, ale bogatsze półki ma zwykły 2.1.
Portret i zdjęcie produktu
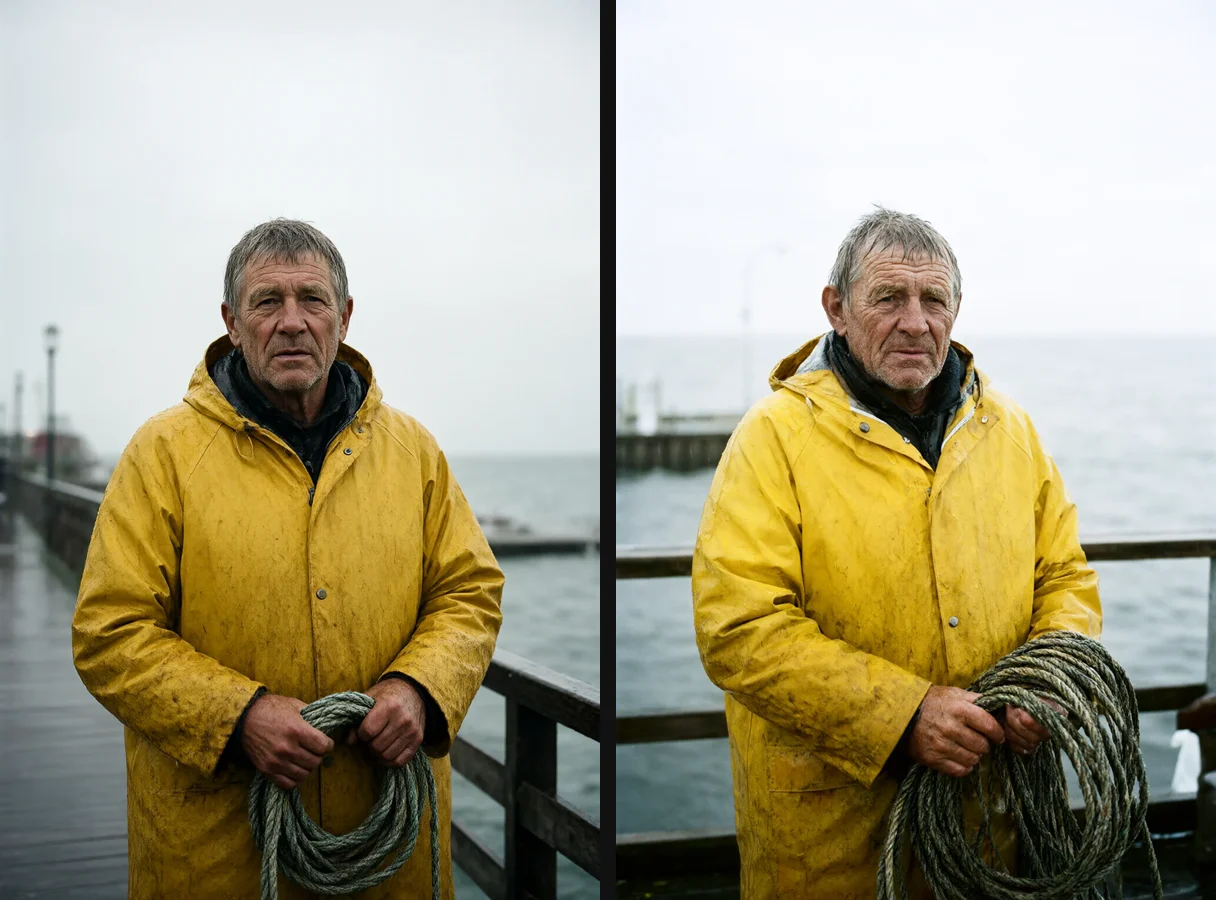
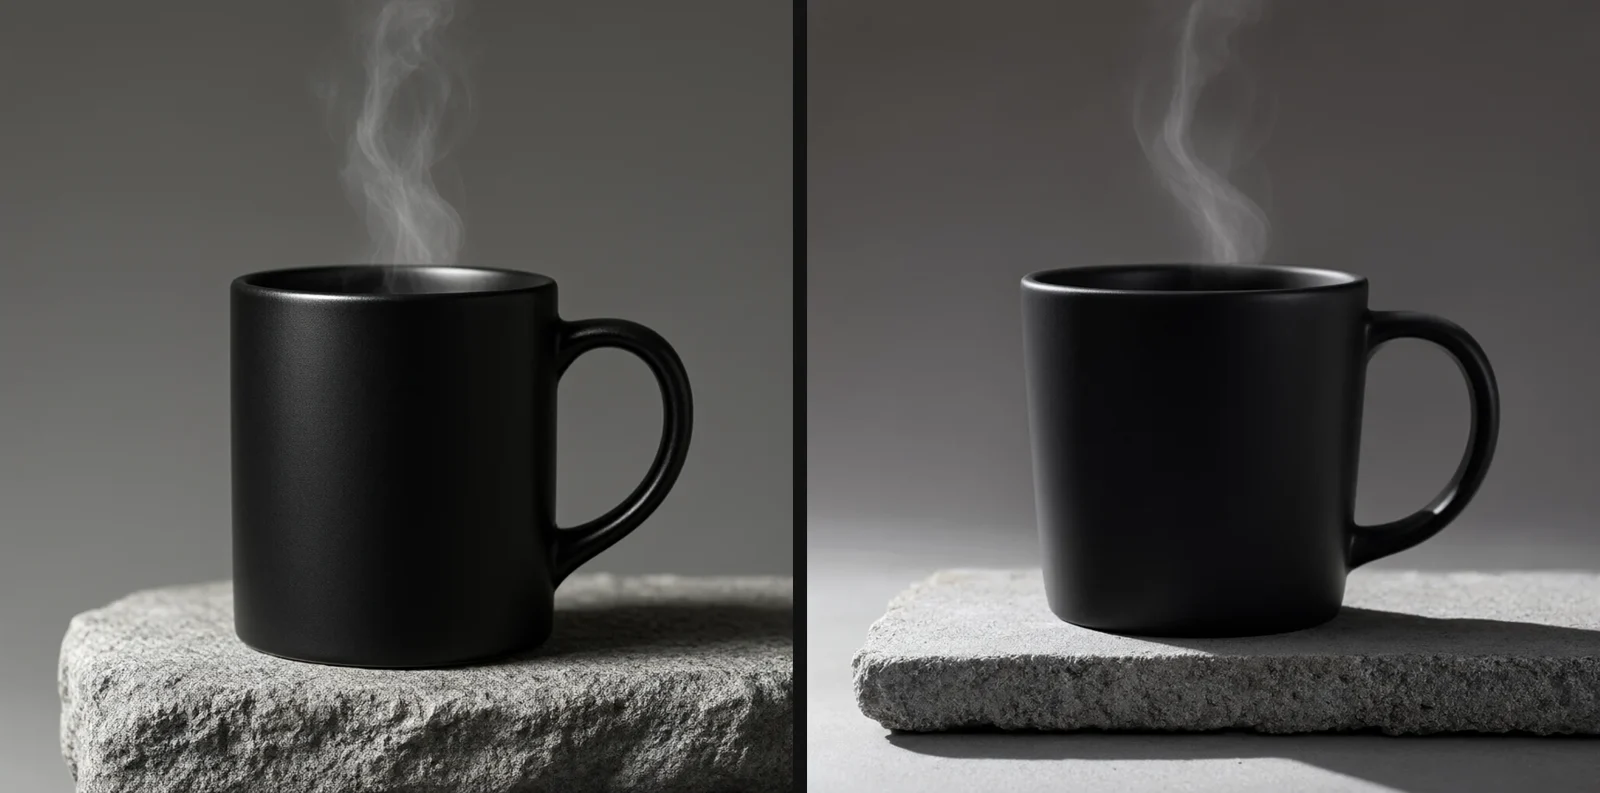
Portret rybaka na molo wygląda w obu wersjach jak zdjęcie z filmu: zmarszczki, mokra kurtka, szare światło. Turbo ma odrobinę mocniejszy kontrast i bardziej „reklamowy” wygląd. Bez zestawienia obok siebie nie poznałbym, który obraz jest z 8, a który z 25 kroków.
Jak uruchomić Turbo w ComfyUI
- Zaktualizuj ComfyUI do wersji 0.41 lub nowszej. Na starszej 0.37 szablonu Turbo nie ma.
- Pobierz z repozytorium Comfy-Org/Qwen-Image-2.1 plik
diffusion_models/qwen_image_2.1_turbo_int8_convrot.safetensors(7,26 GB) doComfyUI/models/diffusion_models. - Jeśli nie masz zwykłego 2.1, dociągnij też enkoder
qwen3vl_8b_int8_convrot.safetensors(9,35 GB, dotext_encoders) i VAEqwen_image_2.1_vae_bf16.safetensors(0,68 GB, dovae). - W ComfyUI otwórz Workflow, potem Browse Templates i wybierz szablon „Qwen Image 2.1 Turbo”.
- Szablon ma wyłączony domyślnie rozszerzacz poleceń (osobny model Qwen 3.5 9B, 9,5 GB). Bez niego pisz od razu pełny opis sceny po angielsku. Krótkie polecenie typu „kot na kanapie” da poprawny, ale nudny obraz.
Ogólny poradnik instalacji ComfyUI na Windowsie mam w tekście ComfyUI od zera, a całą listę modeli, które działają u mnie lokalnie, w przewodniku Lokalne AI.
Licencja: do czego wolno używać
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Turbo ma tę samą licencję co Qwen-Image 2.1, czyli Qwen Research. Model można uruchamiać, testować i badać, ale do użycia zarobkowego (okładki dla klientów, reklamy, produkty) trzeba osobnej zgody Alibaby. Jeśli potrzebujesz lokalnego modelu do pracy komercyjnej, popatrz na Z-Image Turbo na licencji Apache 2.0, który robi obraz w podobnym czasie.
Dla kogo jest Turbo
- Do szybkiego szukania pomysłu: 4 sekundy na obraz to tempo, w którym zmieniasz polecenie i od razu widzisz efekt. Zwykły 2.1 każe czekać pięć razy dłużej.
- Do serii: 100 obrazów 1024×1536 to ok. 7 minut zamiast 33.
- Zwykły 2.1 zostaw do pojedynczych, dopracowanych kadrów z gęstą sceną i dużą liczbą szczegółów w tle.
Najprościej: Hangar
Turbo jest w katalogu Hangara, mojego darmowego menedżera lokalnych modeli na Windows (bez konta i abonamentu, silnik ComfyUI). Wariant int8 to razem 17,3 GB: model Turbo 7,26 GB oraz ten sam enkoder Qwen3-VL-8B int8 (9,35 GB) i VAE (0,68 GB) co w zwykłym 2.1. Licencja jest ta sama co w 2.1: Qwen Research, bez użycia komercyjnego. Zwykły 2.1 przeszedł już test w Hangarze (52 s na obraz z ładowaniem), ustawień Turbo jeszcze nie przetestowałem.
- Pobierz instalator (14 MB) ze strony Hangara. Nie jest jeszcze podpisany cyfrowo, więc Windows SmartScreen pokaże ostrzeżenie: kliknij „Więcej informacji”, a potem „Uruchom mimo to”.
- Hangar wykrywa kartę (Nvidia z CUDA, od 8 GB VRAM, najlepiej 12 GB i więcej) i pokazuje, czy model się zmieści.
- Znajdź Qwen Image 2.1 Turbo w katalogu: zobaczysz rozmiar plików, licencję i to, czy model wolno używać w UE.
- Generuj na razie w ComfyUI według instrukcji wyżej. Hangar postawi ComfyUI portable od zera (u mnie trwało to 231 s) albo podepnie ComfyUI, które już masz.
Hangar ma model w katalogu, ale generowanie przez Hangar jeszcze nie działa (stan na 17 października 2026) - na razie ComfyUI, opis wyżej. Opis narzędzia: Hangar.
Najczęstsze pytania
Ile VRAM potrzebuje Qwen-Image 2.1 Turbo?
U mnie szczyt zajętości całej karty wyniósł 16,8-18,6 GB w wersji int8. Na kartach 16 GB ComfyUI przerzuci część wag do RAM i będzie wolniej. Wersja bf16 (14,2 GB samego modelu) to pomysł tylko na 24 GB i więcej.
Czy Turbo pisze po polsku?
Częściowo. „ODRĄ” i „12 zł” wyszły poprawnie, „Wrocław” stracił „ł”, a szyld „Społem” zniknął. To lepiej niż zwykły 2.1 w tym samym teście, ale dłuższych polskich napisów nie zostawiłbym bez sprawdzenia.
Czy Turbo edytuje zdjęcia?
ComfyUI ma osobny szablon „Qwen Image 2.1 Turbo Image Edit”. Edycji jeszcze nie testowałem, w tym teście mierzyłem tylko generowanie z tekstu.
Czy da się to odpalić bez ComfyUI?
Tak, przez bibliotekę Diffusers albo przez nakładki, które pakują model w zwykły program. Od 14 października jest np. Kokon, otwarty edytor na stable-diffusion.cpp. ComfyUI jest jednak najprostszy, jeśli masz już kartę NVIDIA i chcesz od razu mieć gotowy szablon.
Turbo czy Z-Image Turbo?
W moim wcześniejszym teście Z-Image Turbo robił obraz w 4,2 s. Qwen Turbo jest w tym samym tempie, a w polskich napisach i w sensie sceny wypada lepiej. Z-Image wygrywa licencją Apache 2.0, która pozwala na zarabianie.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła
- Qwen/Qwen-Image-2.1-Turbo na Hugging Face (karta modelu i licencja, sprawdzone 17.10.2026)
- Comfy-Org/Qwen-Image-2.1 (pliki do ComfyUI)
- Lista zmian ComfyUI (Turbo dodane 13.10.2026)
- Pomiary własne na RTX 4090, 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym