Qwen-Image-2.1 kontra zamknięte modele: 4 testy na RTX 4090
Ładne obrazy w 6 sekund za grosze prądu, ale w polskich napisach, układzie i edycjach pod rząd zamknięte modele są wyraźnie lepsze.
👁 122 przeczytań
- Qwen-Image-2.1 uruchomiony lokalnie na RTX 4090 poprawnie odtworzył tylko 6 z 13 polskich napisów, podczas gdy GPT Image 2.5 i Nano Banana Pro zaliczyły wszystkie 13.
- Model generuje obraz 1024x1024 w ok. 6 sekund za ułamek grosza prądu, ale po 10 kolejnych edycjach SSIM spada do 0,11, co oznacza kolorowy szum na całym obrazie.
- Do projektów wymagających dokładnego układu elementów Qwen-Image-2.1 uzyskał IoU zaledwie 0,17 przy 2/16 obiektach na miejscu, podczas gdy FLUX 3 z ramkami JSON osiągnął 0,89 i 16/16.
Qwen-Image-2.1 jest dziś najlepszym otwartym modelem obrazowym w rankingu Artificial Analysis, więc przepuściłem go przez te same cztery testy, które zrobiłem dla Ideogram 4.5 i FLUX 3. Działał lokalnie na moim RTX 4090, a rywale przez API. Wynik jest dwojaki. Pojedynczy obraz wygląda świetnie i powstaje w 6-20 sekund za grosze prądu. W polskich napisach, w trzymaniu się zadanego układu i w edycjach pod rząd zamknięte modele są jednak wyraźnie lepsze.
Ranking Artificial Analysis powstaje z głosów ludzi, którzy wybierają ładniejszy z dwóch obrazów. To dobra miara estetyki, ale nie mówi, czy model napisze poprawnie „Źdźbło”, postawi kubek w rogu kadru albo przeżyje dziesiątą poprawkę. Dlatego mierzę to osobno, tymi samymi skryptami i tymi samymi poleceniami co u konkurencji.
Jak testowałem
- Sprzęt: RTX 4090 (24 GB), ComfyUI, Qwen-Image-2.1 w wariancie int8 (16,6 GB plików), 25 kroków, sampler euler, cfg 1,0 - ustawienia z oficjalnego szablonu.
- Rywale: te same zadania przez API fal.ai, opisane w testach Ideogram 4.5 i FLUX 3 z 1 października 2026.
- Jedna próba na zadanie, stałe ziarno, bez wybierania najlepszych wyników.
- Data: 2 października 2026.
Wyniki w skrócie
| Test | Qwen-Image-2.1 (lokalnie) | Najlepszy wynik w stawce |
|---|---|---|
| Polskie napisy (13 do odtworzenia) | 6/13 | 13/13 - GPT Image 2.5, Nano Banana Pro, Nano Banana 2, Grok |
| Obiekty w zadanych miejscach (16) | 2/16, IoU 0,17 | 16/16, IoU 0,89 - FLUX 3 z ramkami JSON |
| Detal w dużym kadrze | 2752 × 1536, efektywnie 3,1 Mpx | 16,8 Mpx - FLUX 3 w 4k |
| Drobne szyldy czytelne (8) | 2/8 | 8/8 - GPT Image 2.5, Grok, Seedream |
| 10 edycji pod rząd (SSIM po 10. kroku) | 0,11 | 0,95 - Ideogram 4.5 |
| Czas jednego obrazu 1024 × 1024 | ok. 6 s | rywale przez API: 20-60 s |
| Koszt obrazu | prąd, ułamek grosza | 0,024-0,22 USD przez API |
Test 1: polskie napisy
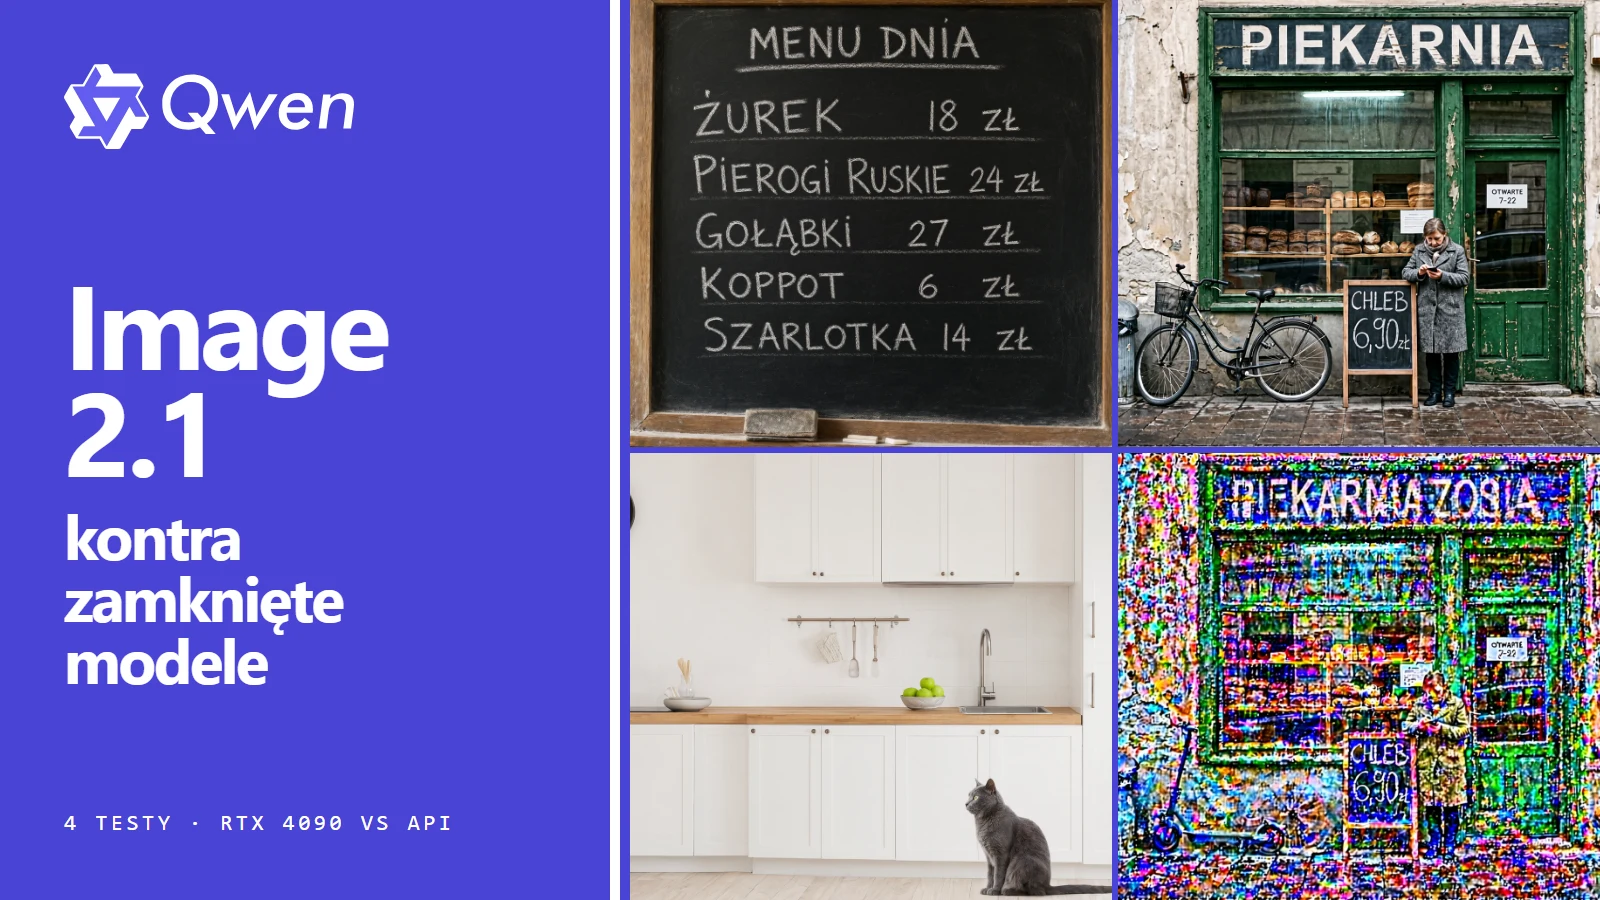
Cztery zadania: plakat wyprzedaży, menu baru mlecznego, okładka książki „Źdźbło i żółć” i pudełko pierogów. Razem 13 napisów do odtworzenia litera w literę. Automatyczny odczyt sprawdziłem na każdym obrazie sam. W menu poprawiłem jeden fałszywy błąd odczytu („MENU DNIA” jest napisane dobrze).
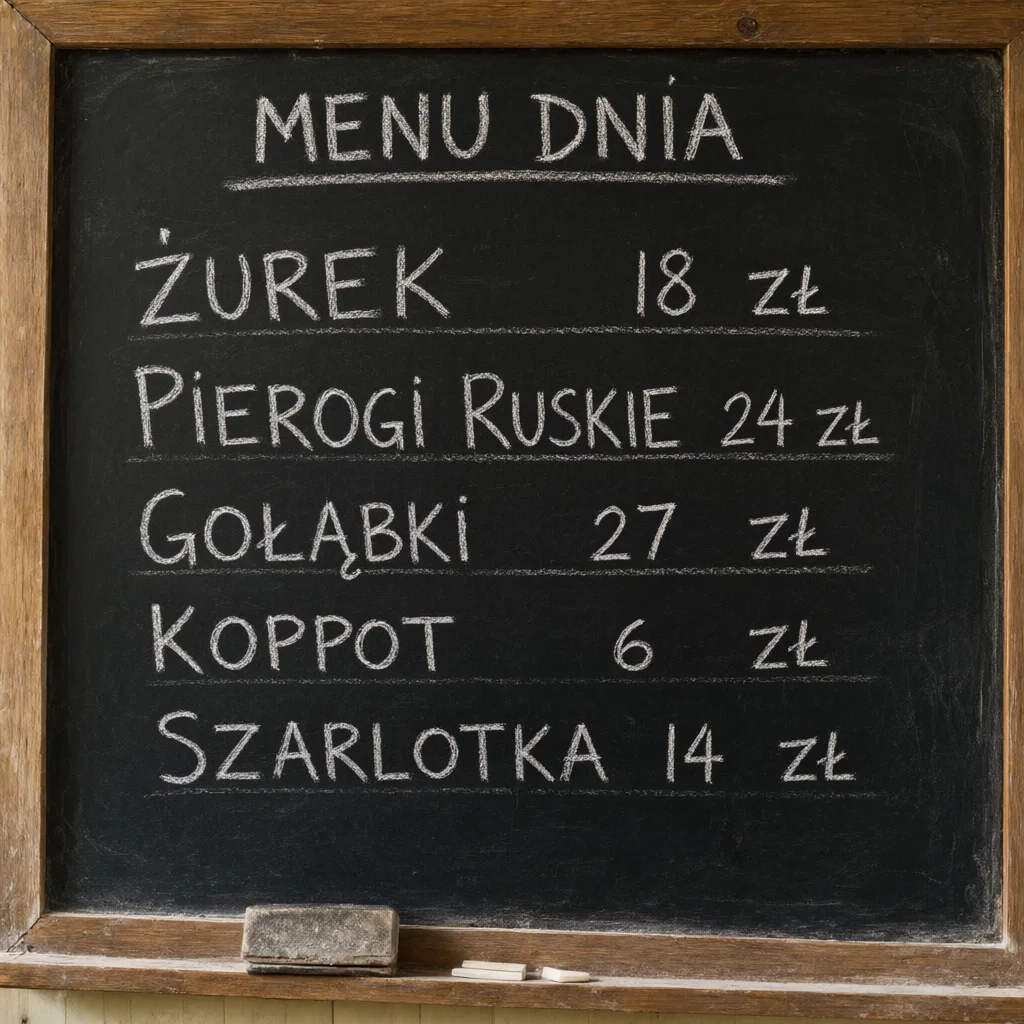
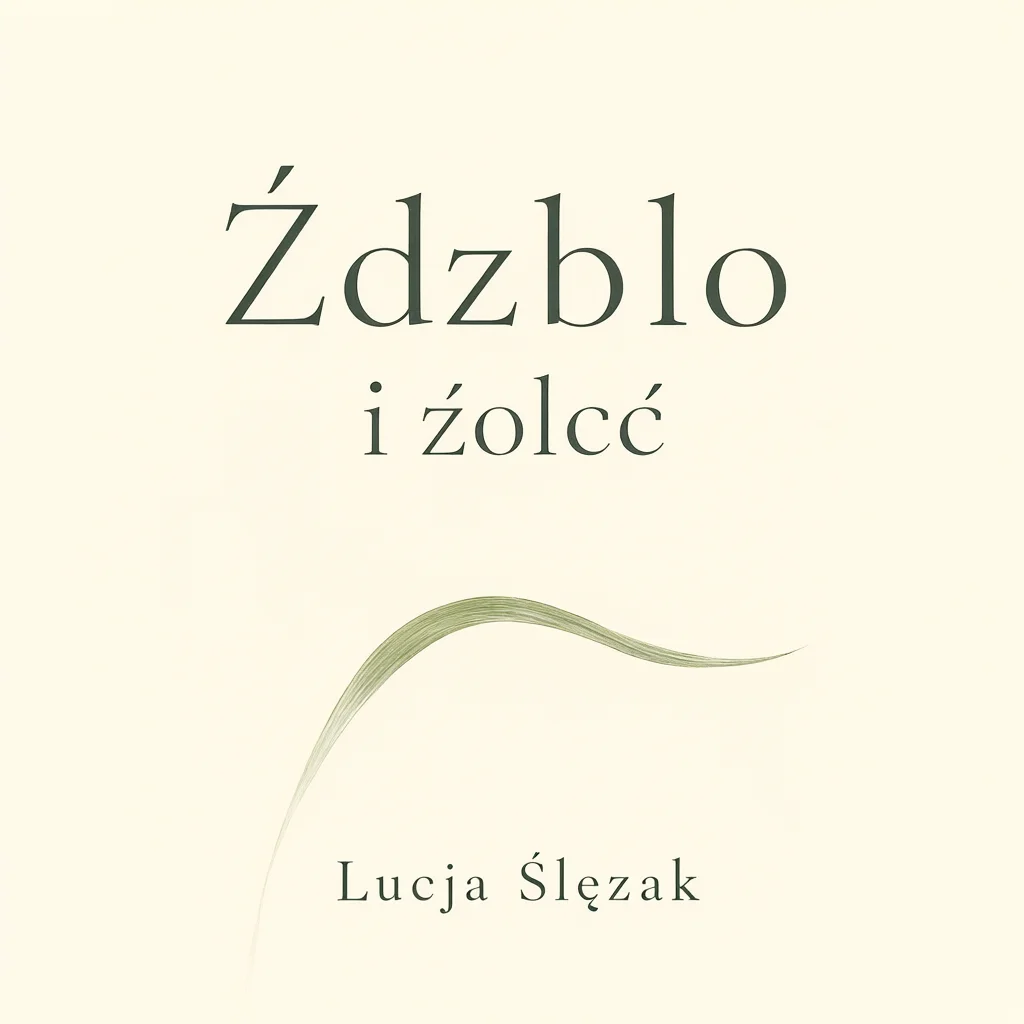
Duże, wyraźne słowa z ogonkami wychodzą dobrze: „ŻUREK”, „GOŁĄBKI”, „WYPRZEDAŻ”. Problem zaczyna się w trudniejszych zbitkach i w drobnym druku. Na pudełku pierogów wyszło „z rapustą” i „Ręclonde lepione”, a na plakacie „JESIEÐIXINNA”. Do grafik z polskim tekstem ten model się nie nadaje bez ręcznej poprawki.
Test 2: obiekty w zadanych miejscach
Cztery sceny po cztery obiekty, każdy z dokładnie opisanym miejscem w procentach szerokości i wysokości kadru. Qwen-Image-2.1 nie ma formatu z ramkami, więc dostał ten sam opis słowami co Nano Banana Pro, GPT Image 2.5 i Seedream. Model wizyjny zaznaczył, gdzie obiekty wylądowały, a ja policzyłem pokrycie z zadaną ramką (IoU).
| Model | Średnie IoU | Obiekty na miejscu |
|---|---|---|
| FLUX 3 Image (ramki JSON) | 0,89 | 16/16 |
| Seedream 5.0 Pro | 0,79 | 15/16 |
| GPT Image 2.5 Sunburst | 0,54 | 11/16 |
| Nano Banana Pro | 0,48 | 7/16 |
| Ideogram 4.5 | 0,37 | 7/16 |
| Qwen Image 3 (API) | 0,35 | 6/16 |
| Qwen-Image-2.1 (lokalnie) | 0,17 | 2/16 |
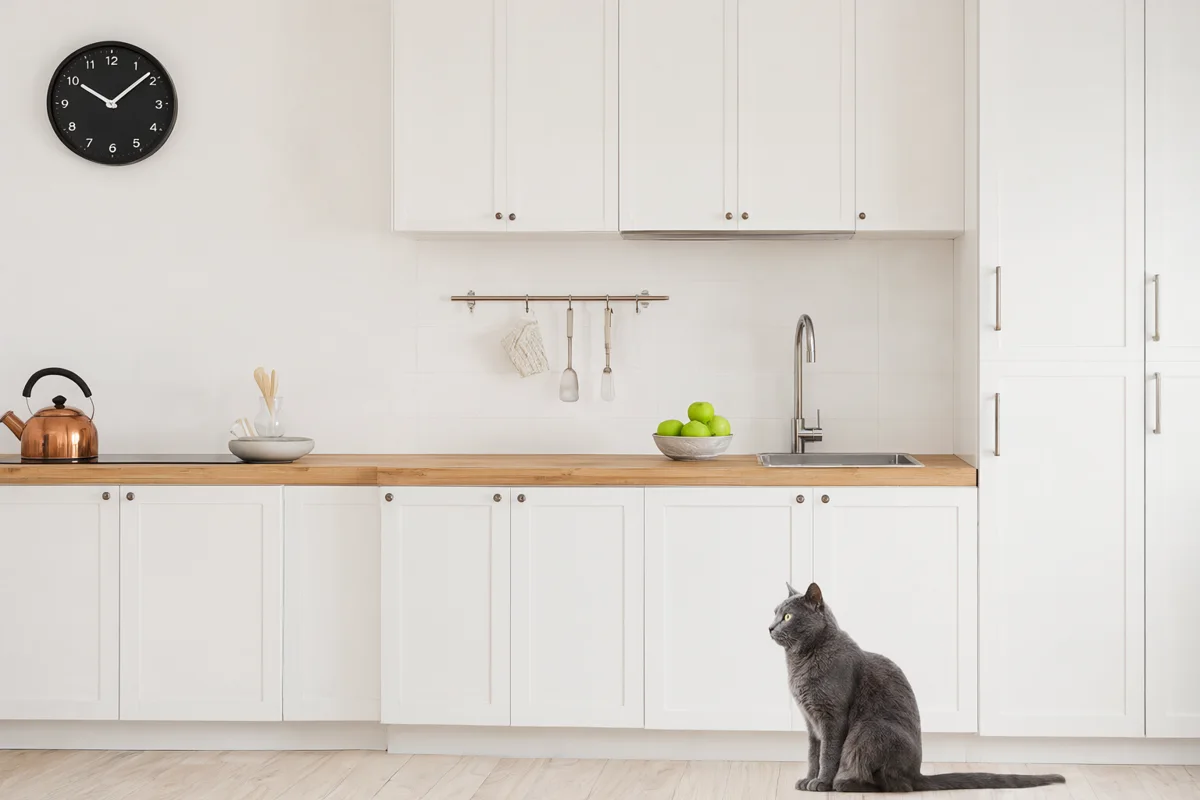
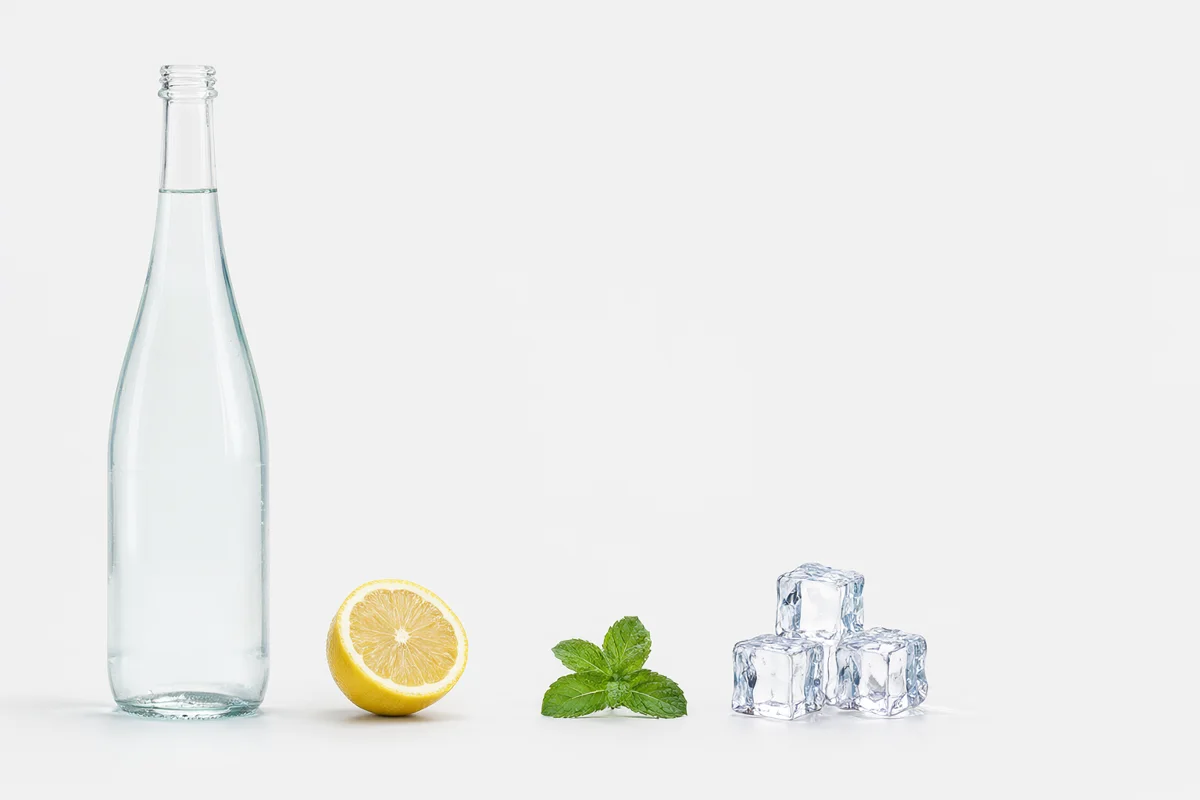
Obrazy są ładne i mają wszystko, o co prosiłem. Model po prostu układa scenę po swojemu, a opisane procenty traktuje jako luźną sugestię. Jeśli projekt wymaga miejsca na logo albo tekst, lepiej wziąć FLUX 3 z ramkami albo Seedream.
Test 3: detal w dużym kadrze
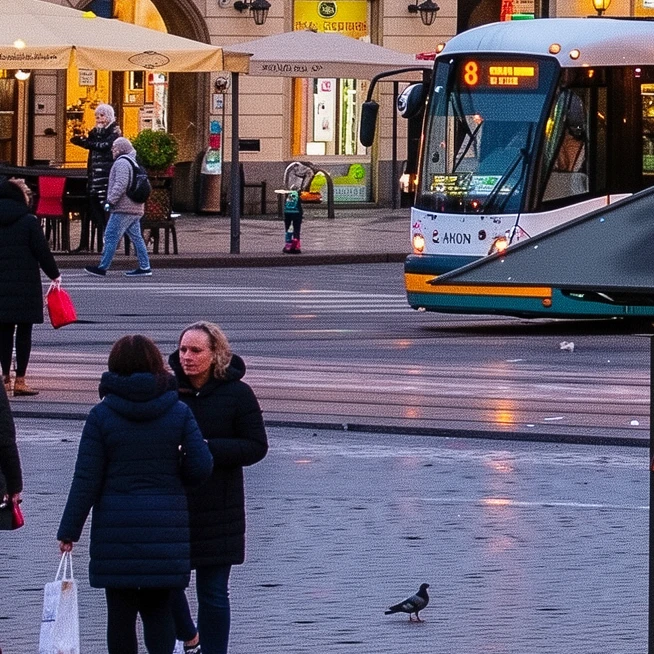
Ten sam kadr Rynku w Krakowie z sześcioma szyldami, kioskiem i tramwajem. Qwen-Image-2.1 wygenerował go w największym obsługiwanym formacie 16:9, czyli 2752 × 1536 px, w 49 sekund. Efektywnie to około 3,1 Mpx prawdziwego detalu, mniej więcej tyle co Grok Imagine 2 (3,3 Mpx). Czytelne są tylko 2 z 8 napisów: „KWIATY” i nagłówek „MIASTO BEZ KORKÓW?” w kiosku. Szyldy zrobiły się tak małe, że zlały się w plamki.
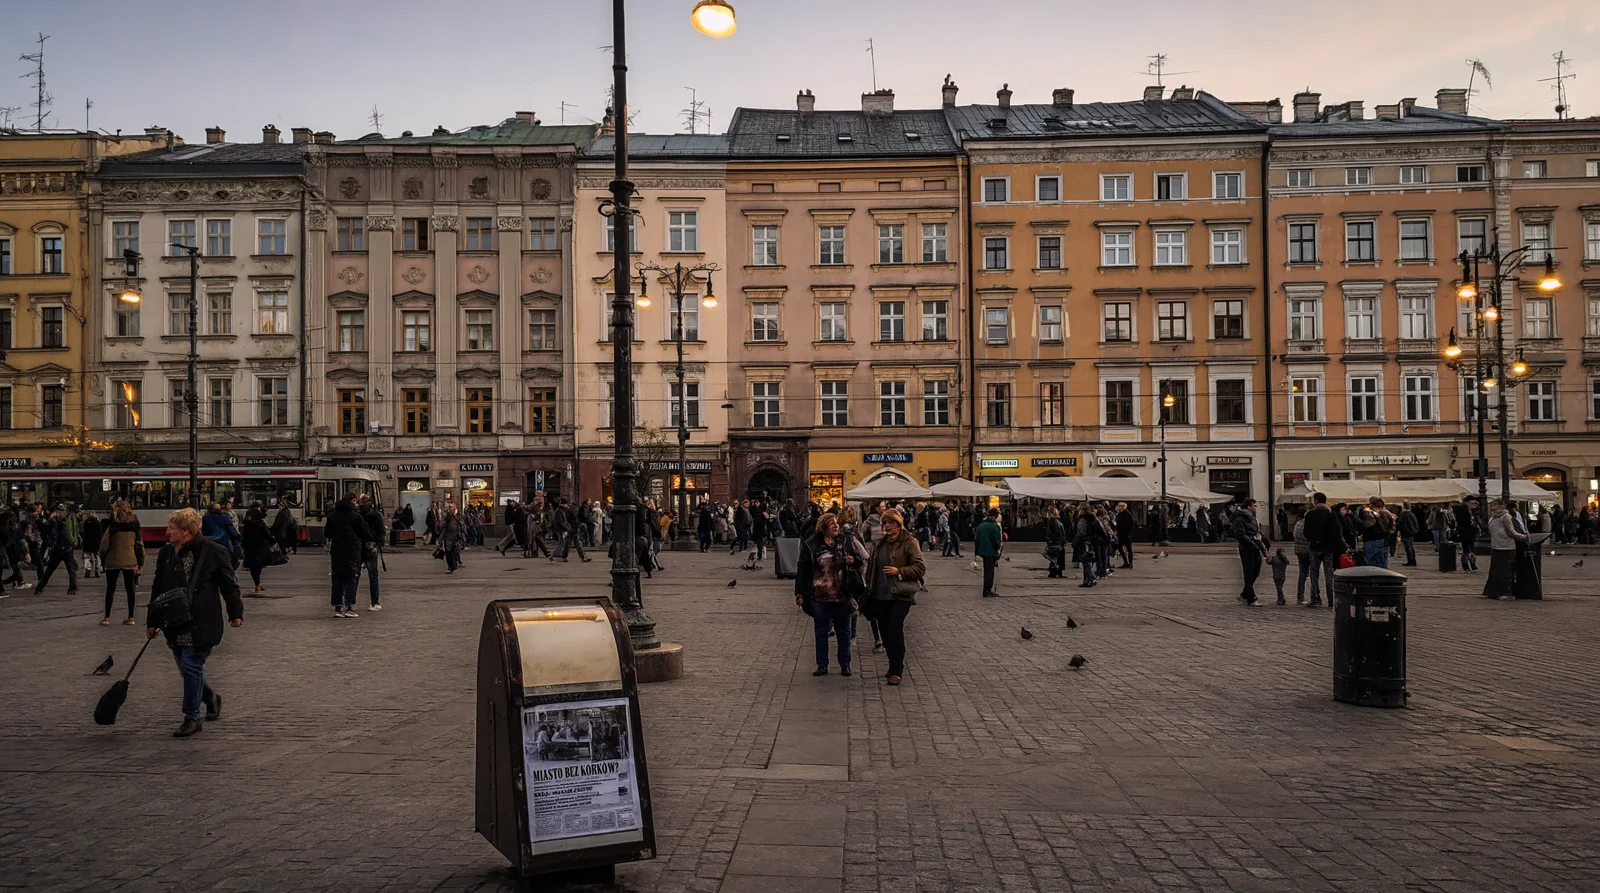
Test 4: 10 edycji pod rząd
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Zdjęcie piekarni i 10 poprawek po kolei: drzwi, naklejka, hulajnoga zamiast roweru, bez auta, nowy szyld, lawenda, płaszcz, kot, cena, bez kosza. Każda kolejna edycja zaczyna od wyniku poprzedniej. Mierzyłem, ile zostało z fragmentów, których nic nie miało ruszyć (SSIM, 1 = bez zmian).
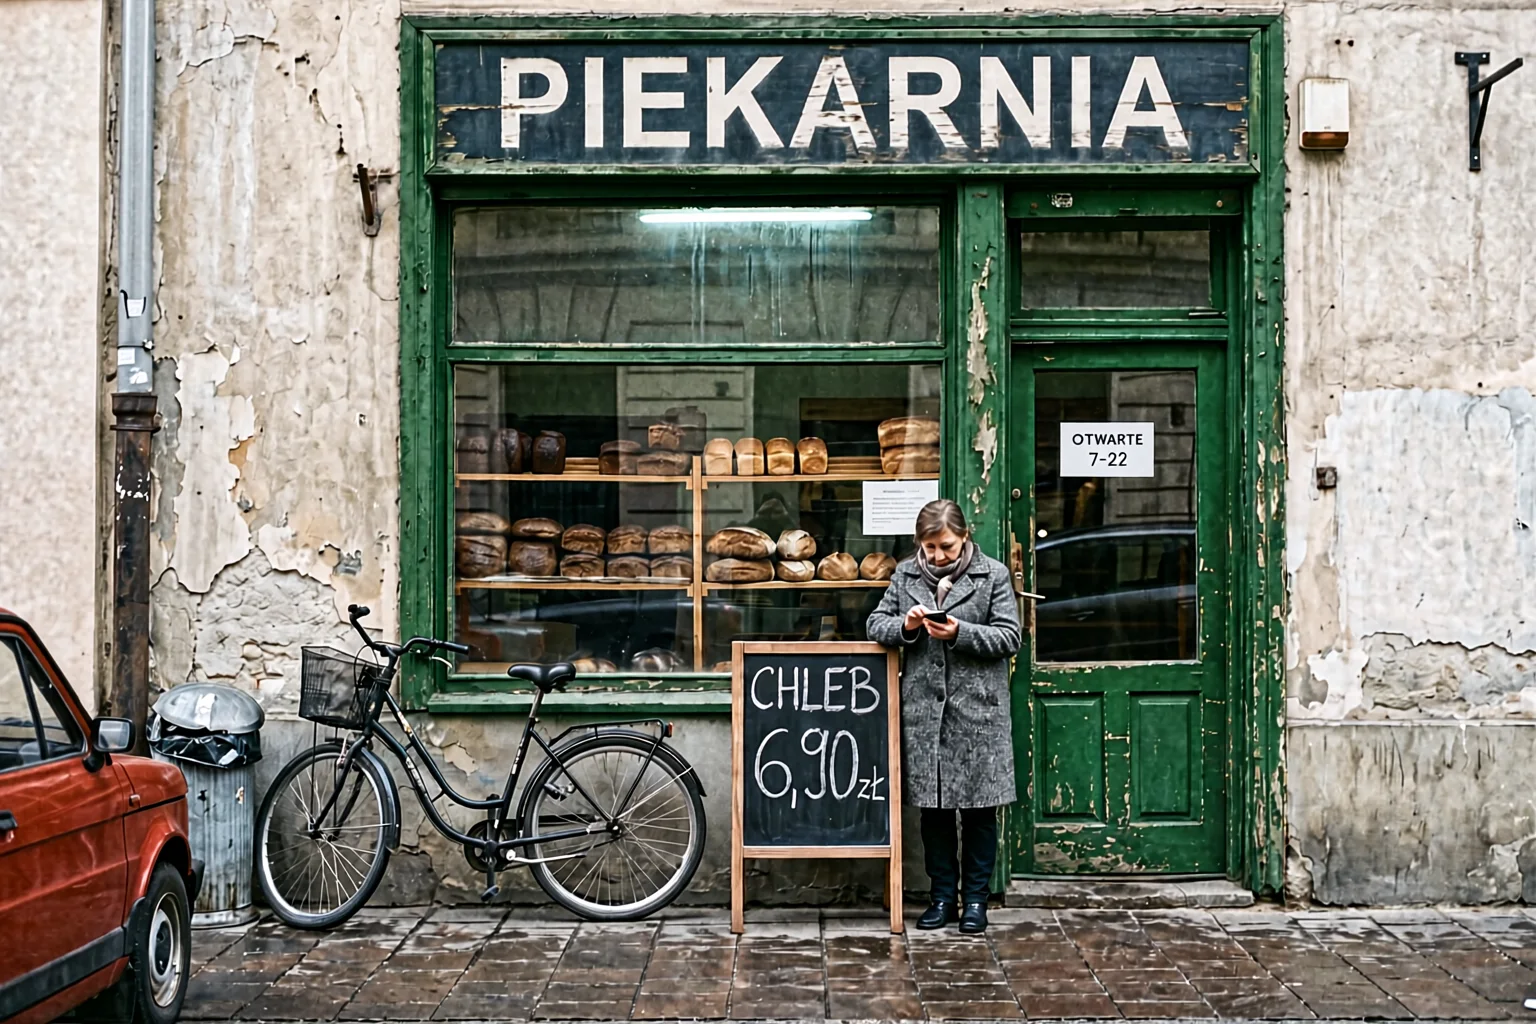
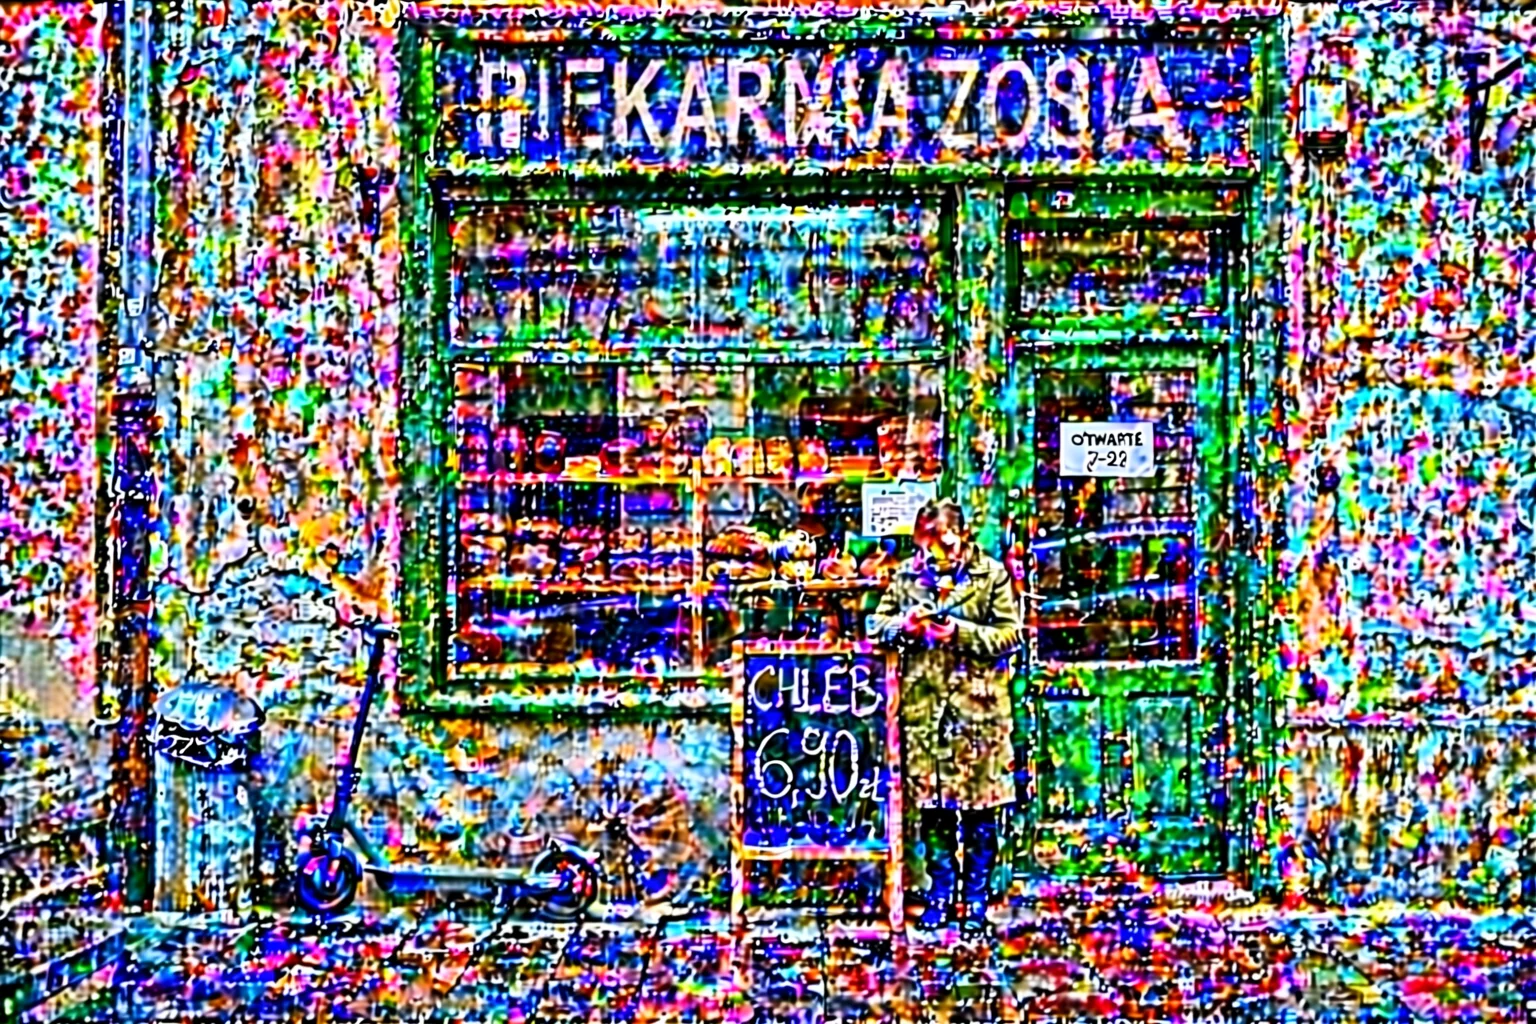
Same polecenia Qwen-Image-2.1 wykonuje dobrze: drzwi zrobiły się zielone, rower zamienił się w hulajnogę, auto zniknęło, a na szyldzie pojawiło się „PIEKARNIA ZOSIA”. Każde kolejne przejście dokłada jednak ziarna i przesyca kolory. Po trzeciej edycji artefakty są widoczne, a po szóstej obraz nadaje się tylko do kosza. Pojedyncza edycja wygląda dobrze, co zgadza się z wysokim, 18. miejscem modelu w rankingu edycji Artificial Analysis. Ten ranking ocenia jednak jeden krok, a nie dziesięć.
Uczciwe zastrzeżenie: testowałem wariant int8 w ComfyUI. Przy pierwszym podejściu ustawiłem rozdzielczość obrazu referencyjnego na 1024 przy wyjściu 2048 i szum rósł jeszcze szybciej (SSIM 0,08). Po wyrównaniu obu rozdzielczości było lepiej, ale problem nie zniknął. Możliwe, że pełna wersja bf16 albo inne ustawienia samplera dadzą czystszy wynik. Tego nie sprawdziłem, bo bf16 nie mieści się w 24 GB razem z enkoderem tekstu.
Praktyczna rada: przy kilku poprawkach z rzędu zawsze edytuj oryginał z dopisanymi wszystkimi zmianami w jednym poleceniu, zamiast poprawiać poprawki.
Co z tego wynika
- Do szybkich, ładnych obrazów bez tekstu Qwen-Image-2.1 jest świetny: 6 sekund na obraz 1K, zero opłat za API i wysoka ocena w ślepych głosowaniach.
- Do grafik z polskim tekstem wybierz GPT Image 2.5 albo Nano Banana Pro.
- Do projektów z dokładnym układem wybierz FLUX 3 z ramkami JSON.
- Do serii poprawek na jednym zdjęciu wybierz Ideogram 4.5 albo FLUX 3.
- Pamiętaj o licencji. Qwen Research pozwala tylko na badania i ocenę. Do zarabiania potrzebna jest osobna umowa z Alibabą - szczegóły w tekście o licencji.
Pełne zestawienie otwartych modeli jest w rankingu otwartych modeli do obrazów, a o miejscu Qwen-Image-2.1 w rankingu Artificial Analysis piszę w osobnym newsie.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Najczęstsze pytania
Czy Qwen-Image-2.1 jest lepszy od Nano Banana Pro?
W ślepych głosowaniach Artificial Analysis nie: Nano Banana Pro ma 1101 punktów, a Qwen-Image-2.1 1034. W moich testach Nano Banana Pro wyraźnie wygrał w polskich napisach (13 do 6) i w trzymaniu układu. Qwen wygrywa ceną i tym, że działa bez internetu.
Ile trwa jeden obraz na RTX 4090?
W moich pomiarach około 6 sekund przy 1024 × 1024, 10 sekund przy 1536 × 1024, 44 sekundy przy 2048 × 2048 i 49 sekund przy 2752 × 1536. Edycja 1536 × 1024 trwała około 20 sekund. Pierwsze uruchomienie po załadowaniu modelu jest kilka razy wolniejsze.
Dlaczego edycje pod rząd psują obraz?
Każda edycja koduje i dekoduje cały obraz od nowa, a drobne zniekształcenia się sumują. Ideogram 4.5 i FLUX 3 mają tryby, które przywracają niezmienione piksele z oryginału. Qwen-Image-2.1 w ComfyUI takiego trybu nie ma.
Czy mogę używać Qwen-Image-2.1 w firmie?
Nie bez osobnej licencji. Qwen Research dopuszcza tylko badania i ocenę modelu.
- Artificial Analysis - ranking tekst na obraz
- Artificial Analysis - ranking edycji obrazu
- Hugging Face - Qwen-Image-2.1
- Moje testy z 1-2.10.2026: skrypty, obrazy i pomiary (OCR, IoU, SSIM, efektywna rozdzielczość)
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Czy Qwen-Image-2.1 radzi sobie z polskim tekstem na obrazach?
Nie - model poprawnie odtworzył tylko 6 z 13 polskich napisów, podczas gdy GPT Image 2.5 i Nano Banana Pro zaliczyły wszystkie 13. Błędy pojawiają się w trudniejszych zbitkach liter i drobnym druku, np. zamiast 'KOMPOT' wyszło 'KOPPOT', a zamiast 'Źdźbło i żółć' - 'Źdzblo i źolcć'.
Ile trwa generowanie obrazu na RTX 4090 z Qwen-Image-2.1?
Przy rozdzielczości 1024x1024 trwa to ok. 6 sekund, przy 1536x1024 ok. 10 sekund, a przy 2752x1536 ok. 49 sekund. Pierwsze uruchomienie po załadowaniu modelu jest kilka razy wolniejsze.
Dlaczego Qwen-Image-2.1 psuje obraz po wielu edycjach pod rząd?
Każda edycja koduje i dekoduje cały obraz od nowa, a drobne zniekształcenia się sumują - po 10 krokach SSIM wynosi tylko 0,11. Ideogram 4.5 i FLUX 3 mają tryby przywracające niezmienione piksele z oryginału, których Qwen-Image-2.1 w ComfyUI nie posiada.
Czy Qwen-Image-2.1 można używać komercyjnie w firmie?
Nie, licencja Qwen Research dopuszcza tylko badania i ocenę modelu. Do zastosowań komercyjnych potrzebna jest osobna umowa z Alibabą.
Podobne tematy na Promptowym