Bielik i PLLuM: czy Polsce potrzebny jest własny model językowy
Polskie modele przegrały w teście z Gemini, a ich twórcy odpowiedzieli, że porównano F-16 z furgonetką. Liczę, ile państwo wydało na PLLuM, zestawiam to z własnym testem Bielika i z Europą, i pytam, dlaczego nikt nie publikuje, jak dobrze polski model działa w mObywatelu.
👁 117 przeczytań
- Bielik i PLLuM przegrały z Gemini (8,13/10) i GPT (7,66/10) w teście Oxido z marca 2026, uzyskując odpowiednio 6,38 i 5,95 punktu na 10.
- PLLuM pochłonął około 39,5 mln zł dotacji Ministra Cyfryzacji w trzech transzach na lata 2024-2026, podczas gdy Bielik nadal powstaje pro bono dzięki mecenasom.
- Milion tokenów z Bielika na karcie RTX 4090 kosztuje około 1,26 zł za prąd, co jest kilkanaście razy taniej niż ten sam milion tokenów z Claude Haiku przez API.
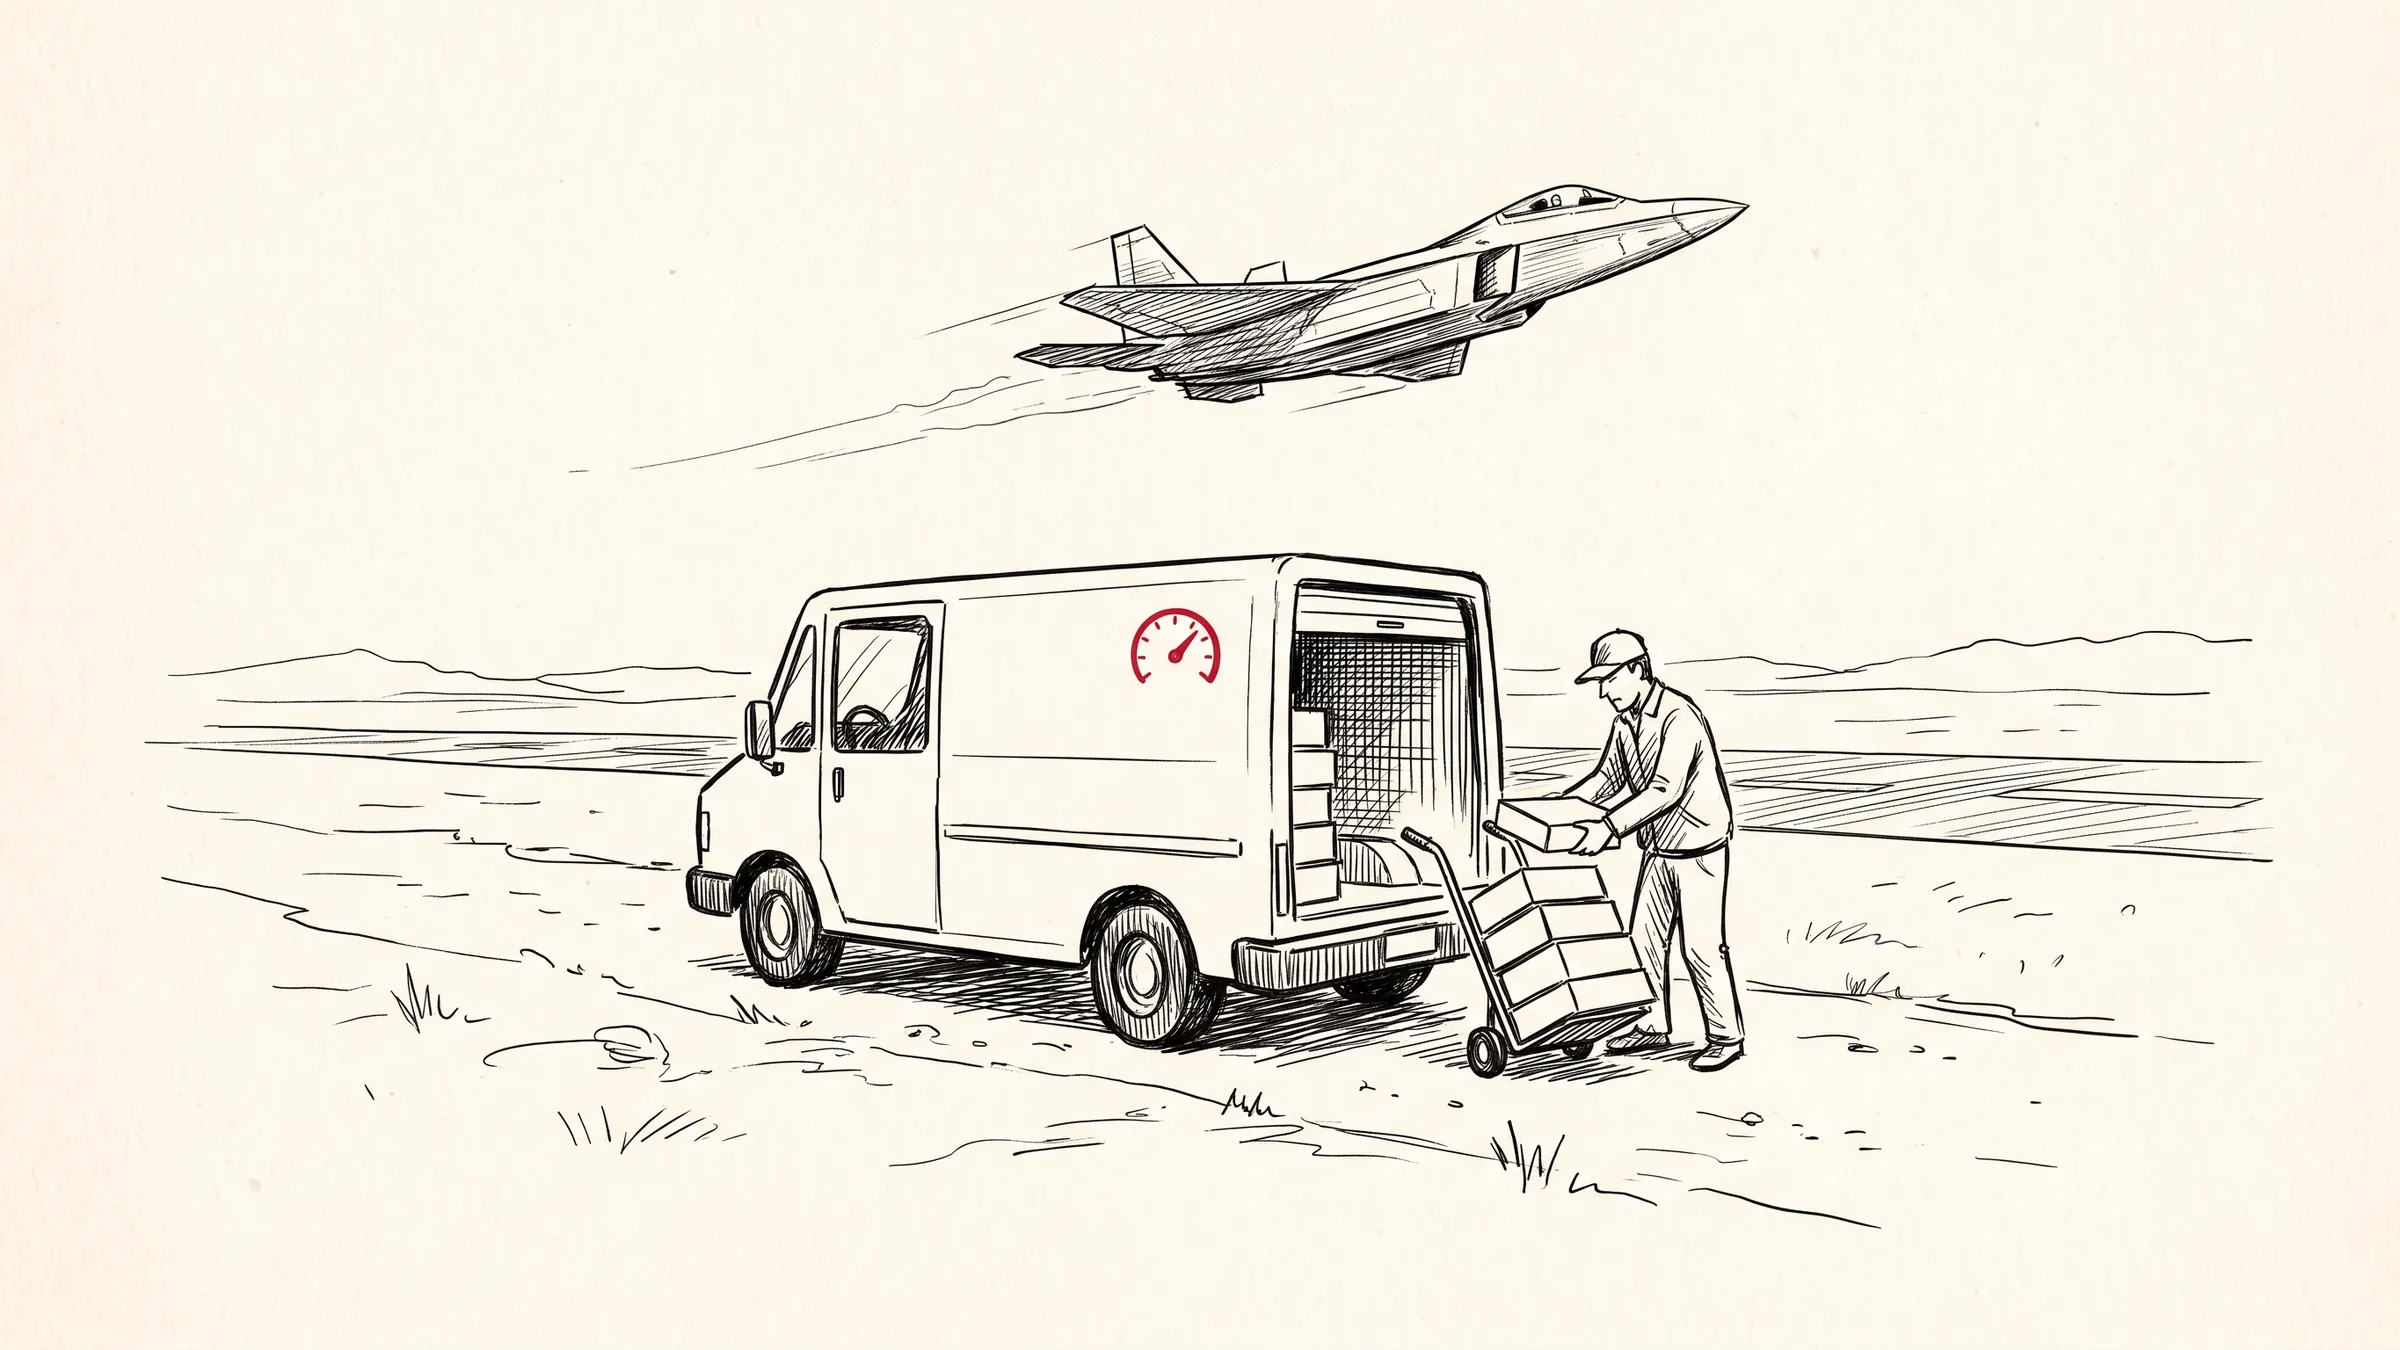
W marcu polskie modele językowe przegrały w teście z Gemini, GPT i resztą światowej czołówki, a ich twórcy odpowiedzieli, że porównano F-16 z furgonetką. Od tego czasu spór toczy się o to, czy Bielik i PLLuM są dość dobre. Uważam, że to złe pytanie. Furgonetka jest Polsce potrzebna. Tylko nikt nie mierzy, czy dowozi, a państwo płaci nie za to, co powinno.
W 1807 roku Samuel Bogumił Linde zaczął wydawać „Słownik języka polskiego”. Sześć tomów, około 60 tysięcy haseł, nakład 1200 egzemplarzy. Linde był autorem i wydawcą jednocześnie, a pieniądze zbierał u mecenasów: u księcia Adama Kazimierza Czartoryskiego, u Józefa Maksymiliana Ossolińskiego, u Stanisława Zamoyskiego, a nawet u cara Aleksandra I. Po dziesięciu latach wciąż miał w magazynie sto niesprzedanych kompletów. Słownik nie był bestsellerem. Był infrastrukturą. Na nim i na jego następcach uczyły się pokolenia, które pisały po polsku w czasach, gdy Polski na mapie nie było.
Przypominam Lindego, bo polska debata o modelach językowych kręci się wokół niewłaściwej metafory. Pytamy, czy mamy własny samochód wyścigowy. A powinniśmy pytać, czy mamy własny słownik: coś, co nie wygra z Gemini w pisaniu inwokacji, ale bez czego polszczyzna w epoce AI będzie językiem obsługiwanym przez cudzą uprzejmość.
Test, który rozpalił spór
17 marca 2026 roku „Rzeczpospolita” opisała test przygotowany przez firmę Oxido. Dwanaście modeli, dwadzieścia zadań w dziesięciu kategoriach, od napisania maila i porady biznesowej po korektę tekstu i wiedzę o historii Polski. Wygrało Gemini 3.1 Pro z oceną 8,13 na 10, drugi był GPT-5.2 z 7,66. Bielik 3.0 dostał 6,38, a PLLuM 5,95. Przy inwokacji „Pana Tadeusza”, jak cytował Bankier za PAP, Bielik był ósmy, a PLLuM trzeci od końca. W zadaniu z korekty Bielik miał najniższy wynik w zestawieniu. Prezes Oxido Marek Jeleśniański przekonywał, że gdyby zainteresować inwestorów i instytucje aktywniejszym finansowaniem, dystans dałoby się zmniejszyć.
Dwa dni później serwis XYZ opublikował odpowiedź Sebastiana Kondrackiego, współtwórcy Bielika. „To trochę tak, jakbyśmy porównywali dwa środki transportu. Przykładowo: F-16 i furgonetkę. I teraz można zadać pytanie: który ma lepsze przyspieszenie?” Kondracki twierdził, że test sprawdził „nie jakość modelu i polskiej sztucznej inteligencji, tylko jakość konfiguracji”, i dodał: „Podłączcie mu internet, tak jak innym modelom i wtedy testujcie”. Aleksandra Tomaszewska z Ministerstwa Cyfryzacji, współtwórczyni PLLuM, napisała, że zestawienie „nie ma sensu, wprowadza w błąd”.
Obie strony miały trochę racji. Test Oxido porównywał modele różnej wielkości, a PLLuM wystąpił w wersji 8x7B z lutego 2025 roku, choć w maju 2026 roku NASK wypuścił jedenaście nowych modeli tej rodziny. Pisałem na blogu, że rankingi modeli bywają fikcją, bo wynik zależy od konfiguracji. Ale Kondracki sam przyznał w tej samej rozmowie coś, co obrońcy polskich modeli rzadko mówią na głos: czasem „nie ma sensu odpalać Bielika, także biznesowo”, bo do skrócenia dziesięciu dokumentów łatwiej użyć narzędzi OpenAI czy Anthropic.
Co widzę na własnej karcie
Sam testowałem Bielika i mogę dorzucić do tego sporu kilka liczb z własnego komputera. W teście siedmiu modeli uruchamianych lokalnie na karcie RTX 4090, który zrobiłem 26 września, Bielik 11B v3 zajął trzecie miejsce na siedem. Miał najpoprawniejszą polszczyznę w całym teście, 8,5 na 10, i najlepiej znał Polskę: w łatwym quizie odpowiedział dobrze na 45 z 46 pytań, w trudnym na 42 z 48. W wiedzy o polskich realiach wypadł lepiej niż Claude Haiku 4.5, komercyjny model Anthropic. Najsłabiej ze wszystkich trzymał się jednak poleceń, z oceną 4,2. W mailu, w którym polecenie wprost zabraniało obiecywać czegokolwiek ponad treść, dopisał od siebie 30-dniową ważność kodu rabatowego.
To zastrzeżenie jest ważne, bo oceniali inne modele AI, a każde zadanie przeszło jedną próbę. Obraz pokrywa się jednak z tym, co mówi sam Kondracki. Bielik zna Polskę i pisze po polsku lepiej, niż wynikałoby z jego rozmiaru. Jako asystent do wszystkiego przegrywa z modelami, które kosztowały miliardy. W osobnym pomiarze policzyłem, że milion tokenów z Bielika na własnej karcie kosztuje około 1,26 zł za prąd, bez ceny sprzętu. To kilkanaście razy mniej niż ten sam milion z Claude Haiku przez API. Dla urzędu, który musi przetworzyć setki tysięcy pism i nie może ich wysyłać do Kalifornii, to nie jest drobiazg.
Dwa modele, dwa ustroje
W polskiej debacie Bielik i PLLuM występują zwykle w parze, jak bracia. W rzeczywistości to dwa zupełnie różne ustroje.
PLLuM jest modelem państwa. Powstał z dotacji celowych Ministra Cyfryzacji dla konsorcjum instytutów badawczych i uczelni pod kierunkiem NASK. Według dokumentów projektu na stronie pllum.org.pl były to trzy transze: 14 504 392 zł na rok 2024, 18 983 055 zł na projekt HIVE AI w 2025 i 5 999 102,67 zł na HIVE 2 w 2026 roku. Razem, według mojego sumowania, około 39,5 mln zł. Ten sam minister, Krzysztof Gawkowski, w marcu 2024 roku ostrzegał posłów, że „wydamy dużo pieniędzy”, a na koniec może się okazać, że zbudowaliśmy coś, co jest na rynku „całkowicie nie w pierwszej lidze, nawet nie w drugiej”. W lutym 2025 roku, na premierze modelu, mówił już: „Amerykańskie firmy i ich parametry to nie jest ziemia obiecana”.
Bielik jest modelem społecznym. Rozwija go fundacja SpeakLeash na mocy obliczeniowej superkomputerów Helios i Athena w krakowskim Cyfronecie AGH, na otwartej licencji Apache 2.0. W 2025 roku pracowało nad nim 10-15 osób. Kondracki mówił w styczniu portalowi WNP, że ministerstwo pewnie wsparłoby ich finansowo, „ale to my nie chcemy”, a model „dalej rozwijany jest pro bono”. W listopadzie 2025 roku mecenasami projektu zostały InPost, Beyond i EY, a czat z Bielikiem trafił do aplikacji InPostu. W lutym 2026 roku Dowództwo Komponentu Wojsk Obrony Cyberprzestrzeni podpisało porozumienie z SpeakLeash i Dellem w sprawie lokalnych modeli dla wojska. Kwot sponsoringu nikt nie ujawnił.
Linde by się uśmiechnął. Dwieście lat później najbardziej rozpoznawalny polski model językowy znów powstaje dzięki mecenasom i pracy ludzi, którzy robią to z przekonania. Prof. Piotr Sankowski z instytutu IDEAS skomentował spór w XYZ zdaniem, które powinno zawisnąć w ministerstwie: „Przykłady pokazują, że inicjatywy oddolne mogą osiągać lepsze rezultaty niż te realizowane przy wsparciu państwa”. Dodał, że chodzi nie tyle o zwiększanie wydatków, ile o ich lepszą organizację.
Różnicę widać też w tym, jak oba modele trafiają do ludzi. Bielika można ściągnąć z serwisu Hugging Face i uruchomić na własnym komputerze w kilka minut, co sam zrobiłem. Kondracki mówił w czerwcu agencji Newseria, że model ma 2,8 miliona pobrań i w ostatnim miesiącu wyprzedził w swojej kategorii modele Mistrala. To liczby podawane przez twórców, nikt ich niezależnie nie sprawdził, ale rząd wielkości mówi sam za siebie. PLLuM długo był dostępny głównie w wariantach do użytku niekomercyjnego. Dopiero w nowej rodzinie z 2026 roku mniejsze modele, 4B i 12B, dostały otwartą licencję Apache 2.0. Model społeczny od początku rozdawał się wszystkim. Model państwowy uczył się tego po drodze. Nie piszę tego z przekąsem, bo zmiana poszła w dobrą stronę. Piszę, bo to kolejny dowód, że o sukcesie takich projektów decyduje nie tyle budżet, ile to, czy ludzie mogą z nich swobodnie korzystać.
Polskie modele w liczbach
ok. 39,5 mln zł dotacji Ministra Cyfryzacji na PLLuM i projekty HIVE w latach 2024-2026 (pllum.org.pl, NASK, moje sumowanie).
730 tys. rozmów i 1,17 mln wiadomości przeprowadzili użytkownicy z asystentem AI w mObywatelu (NASK, sierpień 2026).
0 opublikowanych wskaźników jakości tych rozmów.
3 mld euro zebrał we wrześniu francuski Mistral przy wycenie ponad 21 mld euro (TechCrunch, 8.09.2026).
7 mln euro publicznych pieniędzy kosztował portugalski model Amália (ActuIA, lipiec 2026).
Furgonetka, która nie ma licznika
Najpoważniejszy argument za PLLuM nie pochodzi z benchmarków, tylko z telefonów. Od 31 grudnia 2025 roku w aplikacji mObywatel działa asystent AI oparty na tym modelu. Według NASK do sierpnia 2026 roku użytkownicy przeprowadzili z nim ponad 730 tysięcy rozmów i wysłali ponad 1,17 miliona wiadomości, najczęściej o samej aplikacji, dokumentach, paszportach i rejestracji pojazdów. Prof. Szymon Łukasik z NASK mówił CRN, że to „jedno z większych wdrożeń dużego modelu językowego w europejskiej administracji publicznej”. PLLuM trafia do Kancelarii Premiera, Kancelarii Senatu i Prokuratorii Generalnej, działa w urzędach Gdyni, Poznania i Łodzi. Wiceminister Dariusz Standerski twierdzi, że model „odnajduje się w polskim kontekście prawnym i kulturowym, precyzyjniej niż modele zagraniczne”.
Chętnie bym w to uwierzył, ale nie mam na czym się oprzeć. Asystent w mObywatelu pozwala ocenić każdą odpowiedź kciukiem w górę lub w dół i dopisać komentarz. Nigdzie nie znalazłem opublikowanego wyniku tych ocen. Nie wiem, jaki odsetek odpowiedzi użytkownicy uznali za pomocne, ile było błędnych, ile razy asystent odesłał do niewłaściwego formularza. Szymon Staniszkis, który budował zespół odpowiedzialny za tego chatbota, napisał na LinkedInie, że użytkownikowi jest w gruncie rzeczy obojętne, jaki model stoi za odpowiedzią, PLLuM, Bielik, GPT czy Gemini. Liczy się to, czy dostaje „jasną, aktualną i wiarygodną podpowiedź”. Zgadzam się z nim w całości. Tylko że właśnie tego, czy podpowiedź była jasna i wiarygodna, państwo nie pokazuje.
Suwerenność bez pomiaru jest deklaracją. Państwo, które wydało na model prawie 40 mln zł i wpuściło go do aplikacji milionów obywateli, powinno co kwartał publikować, jak często ten model się myli.
Piotr Olszewski, promptowy.com
Najbardziej uczciwy pomiar zrobił zresztą sam NASK, choć nie dotyczy on asystenta w mObywatelu, tylko rozumienia obrazów. 18 września na blogu PLLuM ukazał się opis PoVisLE, nazwanego „egzaminem z polskości dla AI”: 1117 obrazów i 2366 ręcznie przygotowanych par pytań i odpowiedzi o polskich realiach. Zwyciężył chiński Qwen3.5 z wynikiem 71,45 procent. Według pracy opublikowanej przez zespół NASK na arXiv wizyjna wersja Bielika była trzynasta z wynikiem 36,89 procent, a wizyjna wersja PLLuM zajęła ostatnie miejsce z 30,85 procent. Oba polskie modele wypadały lepiej, gdy pytano je po polsku, niż po przetłumaczeniu pytań. Szanuję ten wynik bardziej niż wszystkie komunikaty prasowe, bo zespół opublikował test, w którym jego własny model przegrał.
Ceny cudzych samolotów
Skalę warto mieć przed oczami, żeby nie wpaść ani w kompleksy, ani w megalomanię. Francuski Mistral we wrześniu 2026 roku zebrał 3 miliardy euro przy wycenie ponad 21 miliardów. Sama ta runda to kilkaset razy więcej, niż Polska wydała na PLLuM w trzy lata. Niemcy, które miały swoją nadzieję w postaci Aleph Alpha, w kwietniu 2026 roku patrzyły, jak firma przechodzi pod kontrolę kanadyjskiego Cohere. Hiszpania wydała na model ALIA około 10 milionów euro, a Portugalia na model Amália, oparty na europejskim EuroLLM, 7 milionów euro publicznych pieniędzy. Szwajcarzy z ETH i EPFL wypuścili w 2025 roku Apertusa, w pełni otwarty model z jawnymi danymi treningowymi.
Z tej mapy wynika coś prostego. Wyścigu na największy model Polska nie wygra i nie powinna próbować. W Europie próbuje tego właściwie tylko Mistral, a i on ściga się głównie o klientów biznesowych, nie o palmę pierwszeństwa. Średnie kraje robią to, co Portugalia: biorą otwartą bazę, douczają ją na własnym języku i własnych danych, i wpuszczają do administracji. Polska robi to samo, tylko dwa razy, równolegle, w dwóch ustrojach, i nie mówi publicznie, czy działa.
Adwokaci diabła
Co sam z tego zbudowałem
Osiem narzędzi, które powstały z problemów opisywanych na tym blogu - razem z tym, czego nie udało się dowieźć.
Zacznę od argumentów, które przemawiają przeciw mnie.
Po pierwsze, 39,5 mln zł to niewiele. Krakowska fabryka AI Gaia kosztuje około 300 mln zł, a rządowy Fundusz Sztucznej Inteligencji ma mieć miliard. Na tle tych kwot PLLuM jest drobną pozycją, a daje państwu coś, czego nie da się kupić za żadne pieniądze od Google’a: model, który można uruchomić we własnej serwerowni, bez wysyłania pism obywateli za ocean, i który działa, gdy zagraniczny dostawca zmieni regulamin albo zniknie. Wojsko nie podpisało porozumienia z SpeakLeash z sentymentu. Po drugie, pytanie o jakość jest źle postawione, bo do zadań urzędowych nie potrzeba modelu, który pisze sonety. Potrzeba takiego, który zna kodeks postępowania administracyjnego i nie wymyśla formularzy. Po trzecie, dublowanie się Bielika i PLLuM ma swoją zaletę: konkurencja i dwa niezależne zespoły to mniejsze ryzyko niż jeden państwowy monopol.
Przyjmuję wszystkie trzy. Właśnie dlatego uważam, że spór o to, czy polski model „przegrywa”, jest stratą czasu. Przegrywa w zadaniach, do których nie został zrobiony, i to jest normalne. Nienormalne jest to, że w zadaniach, do których został zrobiony, nie wiemy, jak wypada, bo nikt nie publikuje wyników.
Jest też argument, który słyszę rzadziej. Bielik miał w czerwcu dostać wersję 3.1 obsługującą 50 języków. Do końca września jej nie opublikowano. Nie traktuję tego jako zarzutu, bo projekt robiony pro bono ma prawo się spóźniać. Traktuję to jako przestrogę: model społeczny zależy od dobrej woli i czasu kilkunastu osób, a model państwowy od cyklu budżetowego. Oba są kruche, każdy na swój sposób.
Wreszcie argument najprostszy: po co w ogóle się męczyć, skoro Gemini i GPT mówią po polsku coraz lepiej? Odpowiedź daje wrześniowy test NASK. Najlepszy model w egzaminie z polskości był chiński, a amerykańskie zajęły kolejne miejsca. Cała czołówka przyszła z zewnątrz i wszystkie mogą jutro zmienić cenę, warunki albo zasady przetwarzania danych. Nie uważam, że to powód do paniki. Uważam, że to powód, by mieć w szufladzie coś własnego, co działa wystarczająco dobrze i czego nikt nam nie wyłączy.
Słownik, nie samolot
To moja opinia. Gdybym miał doradzać ministrowi, powiedziałbym cztery rzeczy.
Po pierwsze, publikujcie liczby. Co kwartał: ile rozmów w mObywatelu, jaki odsetek ocen pozytywnych, jakie typowe błędy, jak model wypada na zestawie pytań urzędowych w porównaniu z najlepszym modelem komercyjnym. Jeśli PLLuM jest lepszy w polskim kontekście prawnym, niech to będzie widać. Jeśli nie jest, lepiej wiedzieć teraz. Po drugie, płaćcie za dane, a nie tylko za model. Najcenniejszą rzeczą, jaką zrobił projekt PLLuM, może się okazać ogłoszona 18 września zbiórka tekstów na podstawie umów licencyjnych z wydawcami, z zasadą „nigdy nie wykorzystujemy tekstów bez Państwa zgody”. Licencjonowany korpus polszczyzny i otwarte testy to dzisiejszy odpowiednik słownika Lindego. Posłużą każdemu kolejnemu modelowi, także temu, który powstanie za pięć lat na zupełnie innej architekturze. Po trzecie, kupujcie wdrożenia, a nie modele. Urząd potrzebuje asystenta, który działa, a nie flagi. Jeśli do jakiegoś zadania lepiej nada się Bielik, niech go dostanie, a jeśli europejski model otwarty, niech dostanie europejski. Po czwarte, nie obiecujcie za dużo. Model lokalny do danych wrażliwych i na czas kryzysu to rozsądne ubezpieczenie. Model, który miałby zastąpić Polakom ChatGPT, to megalomania, której nikt poważny w branży nie proponuje.
Linde przez dziesięć lat nie sprzedał całego nakładu, a jego słownik przetrwał dwa wieki, bo nikt nie oczekiwał od niego, że będzie powieścią. Od Bielika i PLLuM oczekujemy, że wygrają z Gemini w pisaniu inwokacji, a potem się obrażamy, że nie wygrywają. Nie do tego zostały zbudowane. Polski model nie musi być F-16. Musi być furgonetką z licznikiem kilometrów, który każdy może sprawdzić, i z paką pełną porządnie zebranej polszczyzny. Bez licznika pozostanie symbolem. Z licznikiem może zostać infrastrukturą.
Źródła
Polska: Bankier.pl/PAP: test Oxido opisany przez „Rzeczpospolitą” (17.03.2026) · Spider’s Web: polskie modele w teście języka i kultury (17.03.2026) · XYZ: wywiad z Sebastianem Kondrackim i komentarze Aleksandry Tomaszewskiej i prof. Piotra Sankowskiego (19.03.2026) · WNP.pl: Kondracki o finansowaniu Bielika (7.01.2026) · PLLuM: projekty i dotacje · NASK: projekt HIVE AI · PAP Biznes: premiera PLLuM, wypowiedzi Gawkowskiego i Standerskiego (24.02.2025) · CyberDefence24: wątpliwości ministra wobec PLLuM (7.03.2024) · AI HUB Poland: nowe modele PLLuM (26.05.2026) · PLLuM: zbieramy dane do polskich modeli językowych (18.09.2026) · PLLuM: PoVisLE, egzamin z polskości dla AI (18.09.2026) · arXiv: praca zespołu NASK o benchmarku PoVisLE (7.08.2026) · ITwiz: asystent AI w mObywatelu, wpis Szymona Staniszkisa (5.01.2026) · CRN: PLLuM, dane o asystencie w mObywatelu (24.08.2026) · Prawo.pl: PLLuM ma pomagać urzędnikom (25.08.2026) · Wikipedia: Bielik (model językowy) · „Rzeczpospolita”: Bielik zyskuje sponsorów (listopad 2025) · MON: porozumienie DKWOC, Dell i SpeakLeash (18.02.2026) · Bankier.pl/Newseria: Bielik w 50 językach (28.06.2026) · Nauka w Polsce: Gaia AI Factory w Krakowie (12.05.2026) · ITwiz: Fundusz Sztucznej Inteligencji za 1 mld zł. Europa: TechCrunch: Mistral zbiera 3 mld euro (8.09.2026) · CIO: Aleph Alpha przechodzi pod Cohere (2026) · ActuIA: portugalski model Amália za 7 mln euro · ETH Zurich: Apertus (2.09.2025). Historia: Leksykografia UW: „Słownik języka polskiego” Lindego (1807-1814). Na blogu: 7 lokalnych modeli AI po polsku: mój test na RTX 4090 · Lokalny model czy API: ile kosztuje AI z własnej karty · Rankingi modeli AI są fikcją · Bielik AI · PLLuM · Polskie AI · Sebastian Kondracki · Obcy umysł: Jakub Pachocki. Sprawdzone 30 września 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Jak Bielik wypadł w teście modeli językowych w porównaniu z GPT i Gemini?
W teście firmy Oxido z marca 2026 roku Bielik 3.0 uzyskał 6,38 na 10, podczas gdy Gemini 3.1 Pro wygrał z wynikiem 8,13, a GPT-5.2 zajął drugie miejsce z oceną 7,66. W zadaniu z korekty tekstu Bielik miał najniższy wynik w całym zestawieniu.
Ile kosztowało stworzenie polskiego modelu językowego PLLuM?
PLLuM otrzymał łącznie około 39,5 mln zł dotacji Ministra Cyfryzacji w trzech transzach: 14 504 392 zł na rok 2024, 18 983 055 zł na projekt HIVE AI w 2025 i 5 999 102,67 zł na HIVE 2 w 2026 roku. Bielik powstawał równolegle bez ujawnionego budżetu państwowego, finansowany pro bono i przez mecenasów takich jak InPost, Beyond i EY.
Gdzie działa PLLuM w polskiej administracji publicznej?
Od 31 grudnia 2025 roku PLLuM działa jako asystent AI w aplikacji mObywatel, gdzie do sierpnia 2026 roku użytkownicy przeprowadzili ponad 730 tysięcy rozmów i wysłali ponad 1,17 miliona wiadomości. Model trafia także do Kancelarii Premiera, Kancelarii Senatu, Prokuratorii Generalnej oraz urzędów Gdyni, Poznania i Łodzi.
Ile pobrań ma Bielik i na jakiej licencji jest dostępny?
Według twórców z fundacji SpeakLeash Bielik miał 2,8 miliona pobrań, a w jednym z ostatnich miesięcy wyprzedził w swojej kategorii modele Mistrala. Model jest dostępny na otwartej licencji Apache 2.0 w serwisie Hugging Face i można go uruchomić lokalnie na własnym komputerze.
Podobne tematy na Promptowym